Différentielle de Fréchet en L3 de maths : cours et méthodes
Ce chapitre ouvre le calcul différentiel du second semestre. Il généralise la dérivée à des applications entre espaces vectoriels normés, de dimension finie ou non. Nous construisons pas à pas la différentielle de Fréchet, puis nous la relions aux dérivées partielles et à la matrice jacobienne.
Ce cours de différentielle Fréchet L3 traite les exemples fondamentaux : applications bilinéaires, normes, déterminant et inversion matricielle. Il démontre la règle de la chaîne et l’inégalité des accroissements finis, avec des contre-exemples qui montrent le rôle de chaque hypothèse.
Enfin, la différentielle seconde, le théorème de Schwarz et les formules de Taylor préparent l’inversion locale, les fonctions implicites et l’optimisation sous contrainte.
Ce que vous saurez faire
- Prouver qu’une application entre espaces normés est différentiable en un point, y compris en dimension infinie.
- Relier différentielle, dérivées directionnelles, dérivées partielles et matrice jacobienne.
- Différencier une composée, un produit, le déterminant, l’inversion matricielle et une norme.
- Majorer un accroissement \(\|f(b) – f(a)\|\) grâce à une borne sur la différentielle.
- Calculer une différentielle seconde, utiliser le théorème de Schwarz et repérer ses hypothèses.
- Écrire un développement de Taylor à l’ordre deux et contrôler son reste.
1. Construction de la différentielle de Fréchet
Dans tout le chapitre, \(E\) et \(F\) sont des espaces vectoriels normés réels, et \(U\) est un ouvert de \(E\). Le symbole \(\mathcal{L}_c(E,F)\) désigne l’ensemble des opérateurs linéaires bornés de \(E\) vers \(F\) ; on le norme par \(\|u\| = \sup_{\|x\| \leq 1}\|u(x)\|\). En dimension un, dériver revient à approcher une fonction par une droite. En dimension quelconque, on approche \(f\) au voisinage d’un point par une application affine continue.
L’application \(f : U \to F\) est différentiable en \(a \in U\) s’il existe \(L \in \mathcal{L}_c(E,F)\) telle que \[f(a+h) = f(a) + L(h) + \|h\|\,\varepsilon(h), \qquad \lim_{h \to 0} \varepsilon(h) = 0.\] L’application \(L\) se note \(df(a)\) et s’appelle la différentielle de Fréchet de \(f\) en \(a\).
Autrement dit, l’écart \(f(a+h) – f(a) – L(h)\) est négligeable devant \(\|h\|\). La continuité de \(L\) fait partie de la définition : en dimension infinie, une application linéaire peut ne pas être continue.
1.1 Unicité et continuité
Si \(f\) est différentiable en \(a\), sa différentielle est unique. De plus, \(f\) est continue en \(a\).
Supposons que \(L_1\) et \(L_2\) conviennent. Par différence, \(L_1(h) – L_2(h) = o(\|h\|)\). Fixons un vecteur \(v\) et remplaçons \(h\) par \(tv\), avec \(t > 0\) qui tend vers \(0\). En divisant par \(t\), on obtient \(L_1(v) – L_2(v) = \lim_{t \to 0^+} o(t)/t = 0\). Ainsi \(L_1 = L_2\).
Ensuite, \(\|f(a+h) – f(a)\| \leq \|L\|\,\|h\| + \|h\|\,\|\varepsilon(h)\|\). Ce majorant tend vers \(0\) avec \(h\). Par conséquent, \(f\) est continue en \(a\).
Remarque :
Deux normes équivalentes donnent les mêmes applications différentiables et les mêmes différentielles. En dimension finie, la notion ne dépend donc d’aucun choix de norme. En revanche, en dimension infinie, changer de norme peut détruire la différentiabilité.
1.2 Exemples fondamentaux
Applications linéaires. Si \(u \in \mathcal{L}_c(E,F)\), alors \(u(a+h) = u(a) + u(h)\) exactement. Donc \(du(a) = u\) en tout point : une application linéaire continue est sa propre différentielle.
Applications bilinéaires. Soit \(B : E_1 \times E_2 \to F\) bilinéaire avec \(\|B(x,y)\| \leq C\|x\|\,\|y\|\). Le développement \(B(a+h, b+k) = B(a,b) + B(a,k) + B(h,b) + B(h,k)\) donne \[dB(a,b)(h,k) = B(a,k) + B(h,b).\] En effet, le reste \(B(h,k)\) est majoré par \(C\|h\|\,\|k\|\), qui est négligeable devant \(\max(\|h\|,\|k\|)\).
Soit \(E\) un espace préhilbertien et \(Q(x) = \langle x, x \rangle\). On a \(Q(a+h) = Q(a) + 2\langle a, h\rangle + \|h\|^2\). Le dernier terme est un \(o(\|h\|)\), donc \(dQ(a)h = 2\langle a, h \rangle\).
Passons à la norme \(N = \sqrt{Q}\) en un point \(a \neq 0\). Par composition avec la racine carrée, dérivable en \(Q(a) > 0\), on trouve \[dN(a)h = \frac{\langle a, h\rangle}{\|a\|}.\] Nous justifierons ce calcul par la règle de la composée de la partie 3.
Aucune norme n’est différentiable en \(0\). En effet, pour \(v \neq 0\), la fonction \(t \mapsto N(tv) = |t|\,N(v)\) présente un coin en \(0\), avec une pente \(N(v)\) pour \(t > 0\) et une pente opposée pour \(t < 0\). Or nous verrons qu’une application différentiable a des dérivées dans toutes les directions.
1.3 Méthode générale
- Développer \(f(a+h) – f(a)\) et isoler la partie linéaire en \(h\), candidate pour \(df(a)\).
- Vérifier que ce candidat est linéaire et continu, en majorant \(\|L(h)\|\) par \(C\|h\|\).
- Majorer le reste par \(\|h\|\) multiplié par une quantité qui tend vers \(0\), souvent \(C\|h\|\).
- Conclure à la différentiabilité et écrire \(df(a)h\) explicitement.
Appliquons maintenant cette méthode en dimension infinie. Sur \(C([0,1])\) muni de \(\|\cdot\|_\infty\), posons \(J(f) = \int_0^1 e^{t} f(t)^2\,dt\). Dans ce cas, le développement donne \(J(f+h) – J(f) = \int_0^1 2e^t f h\,dt + \int_0^1 e^t h^2\,dt\). La partie linéaire est continue, car elle est majorée par \(2e\|f\|_\infty\|h\|_\infty\). De plus, le reste est majoré par \(e\|h\|_\infty^2\). Ainsi \(dJ(f)h = 2\int_0^1 e^t f(t) h(t)\,dt\).
2. Dérivées directionnelles et dérivées partielles
Soit \(v \in E\). La dérivée de \(f\) en \(a\) suivant \(v\) est, si elle existe, \[D_v f(a) = \lim_{t \to 0} \frac{f(a + tv) – f(a)}{t}.\] Lorsque \(E = \mathbb{R}^n\) et \(v = e_j\), on parle de dérivée partielle et on note \(\partial_j f(a)\).
Si \(f\) est différentiable en \(a\), elle admet une dérivée suivant tout vecteur \(v\), et \(D_v f(a) = df(a)v\). En particulier, sur \(\mathbb{R}^n\), \[df(a)h = \sum_{j=1}^{n} h_j\,\partial_j f(a).\]
On remplace \(h\) par \(tv\) dans la définition : \(f(a+tv) – f(a) = t\,df(a)v + |t|\,\|v\|\,\varepsilon(tv)\). On divise par \(t \neq 0\), puis on fait tendre \(t\) vers \(0\). Le second terme disparaît. Enfin, la formule avec les dérivées partielles découle de la linéarité de \(df(a)\) appliquée à \(h = \sum h_j e_j\).
Pour une fonction numérique sur \(\mathbb{R}^n\) muni du produit scalaire usuel, le vecteur \(\nabla f(a) = (\partial_1 f(a), \dots, \partial_n f(a))\) s’appelle le gradient. Il vérifie \(df(a)h = \langle \nabla f(a), h\rangle\). Par exemple, \(f(x,y) = x^2 + 3y^2 – xy\) a pour gradient \((2x – y,\ 6y – x)\). La figure montre que ce vecteur est orthogonal aux lignes de niveau et pointe vers les valeurs croissantes.
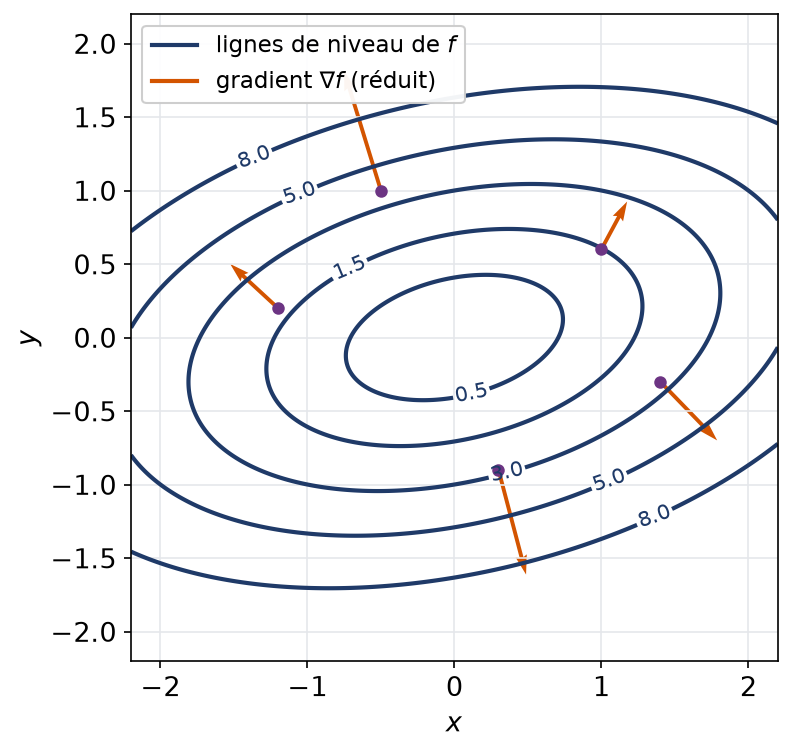
Cette propriété a une interprétation simple. Parmi les vecteurs unitaires \(u\), la dérivée \(D_u f(a) = \langle \nabla f(a), u\rangle\) est maximale lorsque \(u\) est colinéaire au gradient, de même sens, d’après l’inégalité de Cauchy-Schwarz. Le gradient indique donc la direction de plus forte pente. À l’inverse, la dérivée s’annule dans les directions orthogonales, qui sont tangentes à la ligne de niveau.
2.1 Une réciproque fausse
Piège à éviter :
La réciproque de la proposition est fausse. L’existence de toutes les dérivées directionnelles ne garantit ni la différentiabilité, ni même la continuité. Le contre-exemple suivant le montre de façon frappante.
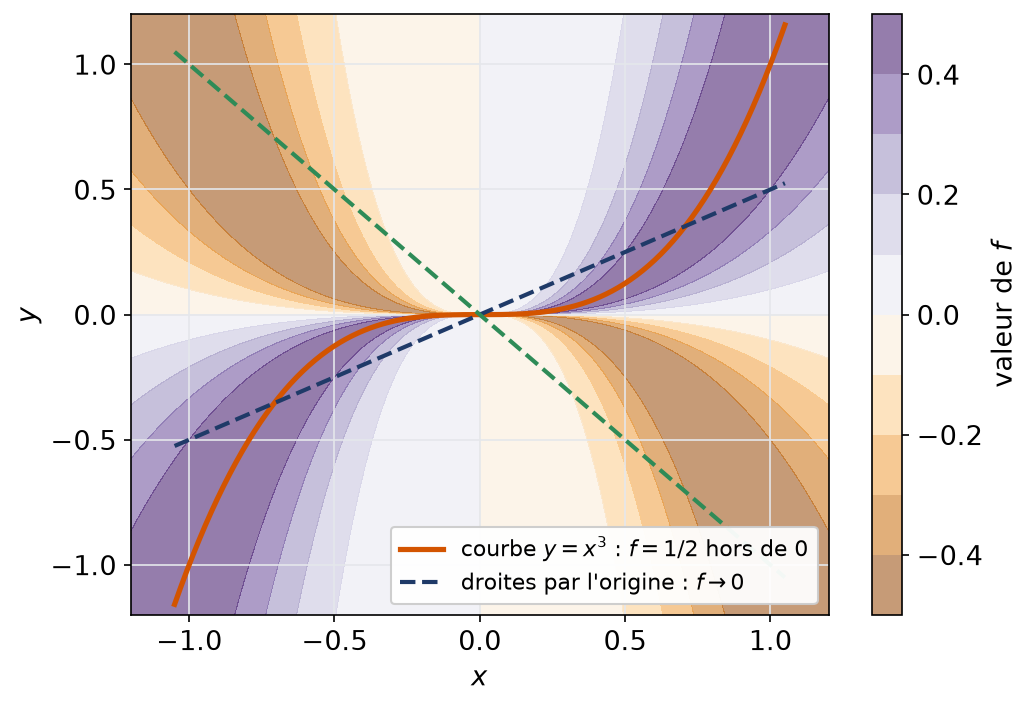
Posons \(f(x,y) = \frac{x^3 y}{x^6 + y^2}\) si \((x,y) \neq (0,0)\), et \(f(0,0) = 0\). Pour \(v = (p,q)\) avec \(q \neq 0\), on calcule \[\frac{f(tp,tq)}{t} = \frac{t\,p^3 q}{t^4 p^6 + q^2} \xrightarrow[t \to 0]{} 0.\] Si \(q = 0\), la fonction est nulle sur l’axe. Ainsi \(D_v f(0) = 0\) pour tout \(v\), et \(v \mapsto D_v f(0)\) est même linéaire.
Pourtant, sur la courbe \(y = x^3\), on trouve \(f(x, x^3) = \frac{x^6}{2x^6} = \frac{1}{2}\) pour \(x \neq 0\). La fonction n’est donc pas continue en \(0\), et a fortiori pas différentiable.
La figure colore les valeurs de \(f\). Sur chaque droite passant par l’origine, \(f\) tend vers \(0\) ; le long de la cubique, elle reste égale à \(\frac{1}{2}\).
3. Opérations sur les différentielles et composée
Heureusement, les différentielles se combinent comme les dérivées usuelles. D’abord, la linéarité est immédiate : si \(f\) et \(g\) sont différentiables en \(a\), alors \(d(\lambda f + g)(a) = \lambda\,df(a) + dg(a)\). Le résultat central est la règle de la chaîne.
Soient \(G\) un troisième espace normé, \(f : U \to F\) différentiable en \(a\), et \(g : V \to G\) différentiable en \(f(a)\), où \(V\) est un ouvert de \(F\) contenant \(f(U)\). Alors \(g \circ f\) est différentiable en \(a\) et \[d(g \circ f)(a) = dg(f(a)) \circ df(a).\]
Notons \(b = f(a)\), \(L = df(a)\) et \(M = dg(b)\). Posons \(k = f(a+h) – b = L(h) + \|h\|\,\varepsilon_1(h)\). D’abord, \(\|k\| \leq (\|L\| + \|\varepsilon_1(h)\|)\,\|h\|\) : ainsi \(k\) tend vers \(0\) et reste un \(O(\|h\|)\).
Ensuite, \(g(b + k) = g(b) + M(k) + \|k\|\,\varepsilon_2(k)\). En remplaçant \(k\), on obtient \[g(f(a+h)) = g(b) + M(L(h)) + \|h\|\,M(\varepsilon_1(h)) + \|k\|\,\varepsilon_2(k).\] Le troisième terme est un \(o(\|h\|)\) car \(M\) est continue. Le dernier aussi, car \(\|k\| = O(\|h\|)\) et \(\varepsilon_2(k) \to 0\). Par conséquent, \(M \circ L\) est la différentielle cherchée.
Si \(B\) est bilinéaire continue et si \(f\), \(g\) sont différentiables en \(a\), alors \(\varphi = B(f,g)\) est différentiable en \(a\) et \(d\varphi(a)h = B(df(a)h, g(a)) + B(f(a), dg(a)h)\).
- Écrire l’application comme une composée de briques connues : linéaires, bilinéaires, fonctions usuelles, normes, inversion.
- Vérifier, pour chaque brique, la différentiabilité au point considéré : ouvert de départ, valeur non nulle sous une racine, matrice inversible…
- Appliquer la règle de la chaîne de l’intérieur vers l’extérieur, en suivant le vecteur \(h\).
- Simplifier l’expression obtenue et contrôler un cas particulier simple.
3.1 Deux exemples matriciels fondamentaux
Nous munissons \(M_n(\mathbb{R})\) d’une norme sous-multiplicative, ce qui est toujours possible en dimension finie. Les deux applications suivantes reviennent sans cesse, en particulier dans les chapitres sur l’inversion locale et l’optimisation.
Inversion matricielle. L’ensemble \(GL_n(\mathbb{R})\) est ouvert dans \(M_n(\mathbb{R})\). Pour \(A\) inversible et \(H\) petit, on vérifie l’identité \[(A+H)^{-1} – A^{-1} + A^{-1} H A^{-1} = (A+H)^{-1} H A^{-1} H A^{-1}.\] Pour une norme sous-multiplicative, le membre de droite est majoré par \(\|(A+H)^{-1}\|\,\|A^{-1}\|^2\,\|H\|^2\). De plus, \((A+H)^{-1}\) reste borné près de \(A\). Ainsi \(d(\mathrm{inv})(A)H = -A^{-1} H A^{-1}\).
On retrouve la formule \((1/x)^{\prime} = -1/x^2\) lorsque \(n = 1\). Cependant, l’ordre des facteurs compte : en général, \(A^{-1}HA^{-1} \neq A^{-2}H\).
Déterminant. En développant \(\det(I_n + H)\), on obtient \(1 + \mathrm{tr}\,H\) plus des termes de degré au moins deux en les coefficients de \(H\). Donc \(d(\det)(I_n)H = \mathrm{tr}\,H\).
Pour \(A\) inversible, on écrit \(\det(A + H) = \det A \cdot \det(I_n + A^{-1}H)\). La règle de la chaîne donne alors \[d(\det)(A)H = \det(A)\,\mathrm{tr}(A^{-1}H) = \mathrm{tr}\left({}^t\mathrm{com}(A)\,H\right).\] Les deux membres extrêmes sont continus en \(A\). Par densité de \(GL_n(\mathbb{R})\), la formule vaut pour toute matrice.
4. Classe C^1 et matrice jacobienne
L’application \(f : U \to F\) est de classe \(C^1\) sur \(U\) si elle est différentiable en tout point et si l’application \(df : U \to \mathcal{L}_c(E,F)\) est continue.
En dimension finie, on dispose d’un critère commode, qui évite de revenir à la définition. Nous l’admettons ; sa preuve applique l’inégalité des accroissements finis de la partie 5 à chaque variable séparément.
Prenons \(U\) ouvert dans \(\mathbb{R}^n\) et \(f : U \to \mathbb{R}^p\). Appartenir à \(C^1(U)\) revient, pour \(f\), à posséder en tout point de \(U\) des dérivées partielles \(\partial_1 f, \dots, \partial_n f\) qui dépendent continûment du point.
Piège à éviter :
La continuité des dérivées partielles est essentielle. Leur simple existence ne suffit pas, même en un seul point. Par exemple, la fonction \(\frac{x^3y}{x^6+y^2}\) de la partie 2 admet en \(0\) deux dérivées partielles nulles, alors qu’elle n’y est même pas continue. En pratique, on vérifie donc la continuité des \(\partial_j f\) aux points délicats, souvent par une majoration en coordonnées polaires.
4.1 Jacobienne et changements de variables
Si \(f = (f_1, \dots, f_p)\) est différentiable en \(a\), la matrice jacobienne \(J_f(a)\) est la matrice de \(df(a)\) dans les bases canoniques. Son coefficient d’indices \((i,j)\) vaut \(\partial_j f_i(a)\). Lorsque \(p = n\), son déterminant est le jacobien.
Dans ce cadre, la règle de la chaîne devient un produit matriciel : \(J_{g \circ f}(a) = J_g(f(a))\,J_f(a)\). En pratique, c’est donc la forme la plus utilisée pour les changements de variables.
Considérons \(\Phi(s,t) = (s + t,\ st)\), qui associe à deux réels leur somme et leur produit. Sa jacobienne vaut \[J_\Phi(s,t) = \begin{pmatrix} 1 & 1 \\ t & s \end{pmatrix}, \qquad \det J_\Phi(s,t) = s – t.\] Ainsi le jacobien s’annule exactement sur la diagonale \(s = t\).
Composons avec \(f(x,y) = x^2 – 2y\). La règle de la chaîne donne \((2x,\ -2)\,J_\Phi(s,t) = (2x – 2t,\ 2x – 2s)\). Avec \(x = s + t\), on trouve \((2s,\ 2t)\). C’est cohérent, car \(f \circ \Phi(s,t) = s^2 + t^2\).
5. Inégalité des accroissements finis
Dès que l’espace d’arrivée dépasse la dimension un, le théorème de Rolle disparaît, et avec lui toute formule exacte du type « accroissement égal à dérivée fois longueur ». Il reste heureusement une majoration, qui suffit dans presque toutes les applications.
Prenons \(f : U \to F\) différentiable et deux points \(a, b\) dont tout le segment \([a,b]\) reste dans \(U\). Supposons la norme d’opérateur de \(df\) bornée par \(M\) le long de ce segment. Nous avons alors \[\|f(b) – f(a)\| \leq M\,\|b – a\|.\]
Posons \(\varphi(t) = f(a + t(b-a))\) pour \(t \in [0,1]\). Par la règle de la chaîne, \(\|\varphi^{\prime}(t)\| \leq M\,\|b – a\|\). Fixons \(\varepsilon > 0\) et notons \(I\) l’ensemble des \(t\) tels que \(\|\varphi(s) – \varphi(0)\| \leq (M + \varepsilon)\,s\,\|b – a\|\) pour tout \(s \in [0,t]\).
D’abord, \(I\) est un intervalle contenant \(0\), fermé par continuité de \(\varphi\). Notons \(c\) sa borne supérieure, qui appartient à \(I\). Supposons \(c < 1\). La dérivabilité en \(c\) donne, pour \(s > c\) assez proche, \(\|\varphi(s) – \varphi(c)\| \leq (M + \varepsilon)(s – c)\,\|b – a\|\). L’inégalité triangulaire montre alors que \(s \in I\), ce qui contredit la définition de \(c\). Donc \(c = 1\). Enfin, on fait tendre \(\varepsilon\) vers \(0\).
5.1 Conséquences et limites
Une application dont la différentielle s’annule partout sur un ouvert connexe ne prend qu’une seule valeur sur cet ouvert.
Pour le voir, on fixe un point \(x_0\) et l’on considère l’ensemble des points où \(f\) vaut \(f(x_0)\). Il est fermé par continuité. Il est aussi ouvert, car chaque point possède une boule convexe sur laquelle le théorème donne \(\|f(y) – f(x)\| \leq 0\). La connexité conclut.
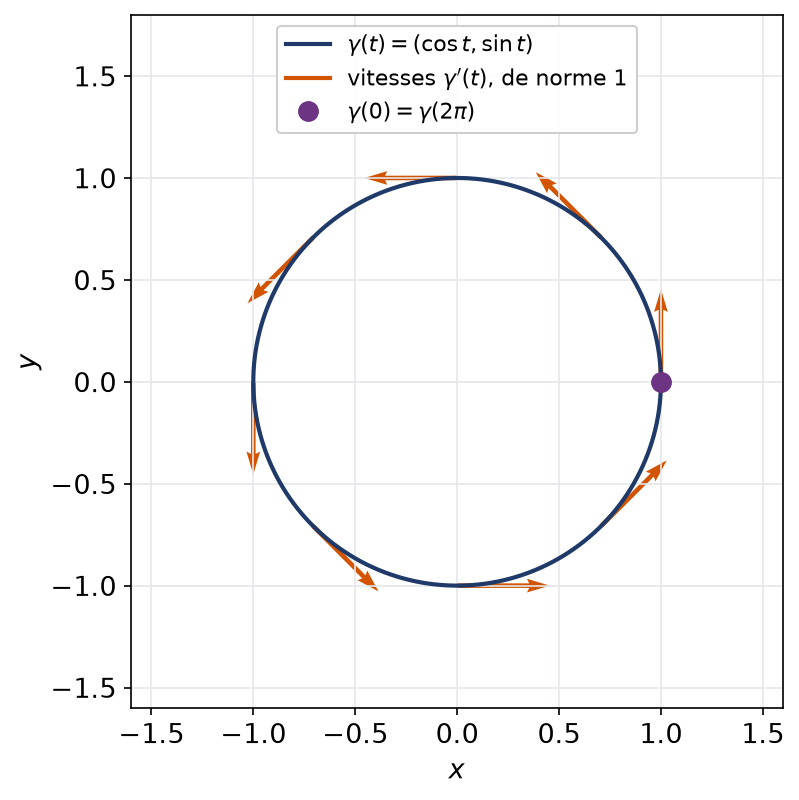
Posons \(\gamma(t) = (\cos t, \sin t)\) sur \([0, 2\pi]\). On a \(\gamma(2\pi) – \gamma(0) = 0\), alors que \(\gamma^{\prime}(t)\) est de norme euclidienne \(1\) pour tout \(t\). Ainsi, aucun \(c\) ne vérifie \(\gamma(2\pi) – \gamma(0) = 2\pi\,\gamma^{\prime}(c)\) : l’égalité des accroissements finis tombe en défaut.
La figure représente ce chemin fermé : les vitesses ne s’annulent jamais, et pourtant le point d’arrivée coïncide avec le point de départ.
Piège à éviter :
Le segment \([a,b]\) doit être contenu dans \(U\). Sur un ouvert non convexe, une borne sur \(\|df\|\) ne donne qu’une inégalité le long d’une ligne brisée. Par exemple, sur le plan privé d’une demi-droite, l’angle polaire a une différentielle bornée loin de l’origine, mais il saute de presque \(2\pi\) de part et d’autre de la coupure.
6. Différentielles d’ordre supérieur et formules de Taylor
6.1 Différentielle seconde
Lorsque \(df(x)\) existe en chaque point \(x\) de \(U\), l’application \(x \mapsto df(x)\) prend ses valeurs dans l’espace normé \(\mathcal{L}_c(E,F)\). Rien n’empêche alors de lui appliquer à nouveau la construction de la partie 1.
Lorsque l’application \(x \mapsto df(x)\) admet elle-même une différentielle au point \(a\), nous disons que \(f\) est deux fois différentiable en \(a\). On identifie alors \(d^2 f(a)\) à l’application bilinéaire continue \((h,k) \mapsto \big(d(df)(a)k\big)(h)\). La fonction \(f\) est de classe \(C^2\) si \(d^2 f\) existe et est continue sur \(U\).
En particulier, pour une fonction numérique sur \(\mathbb{R}^n\), la matrice de \(d^2 f(a)\) est la matrice hessienne, de coefficients \(\partial_i \partial_j f(a)\). On a alors \(d^2 f(a)(h,k) = {}^t h\,\mathrm{Hess}_f(a)\,k\).
(Schwarz) Si \(f\) est deux fois différentiable en \(a\), la forme bilinéaire \(d^2 f(a)\) est symétrique. En particulier, si \(f\) est de classe \(C^2\) sur un ouvert de \(\mathbb{R}^n\), alors \(\partial_i \partial_j f = \partial_j \partial_i f\) pour tous \(i, j\).
L’idée de la preuve consiste à étudier la différence seconde \(f(a+h+k) – f(a+h) – f(a+k) + f(a)\). Elle est symétrique en \(h\) et \(k\), et les accroissements finis montrent qu’elle vaut \(d^2 f(a)(h,k) + o\big((\|h\| + \|k\|)^2\big)\).
Posons \(f(x,y) = \frac{xy(x^2 – 4y^2)}{x^2 + y^2}\) hors de l’origine, et \(f(0,0) = 0\). Pour \(y \neq 0\), on a \(\partial_1 f(0,y) = \lim_{x \to 0} f(x,y)/x = -4y\). De même, \(\partial_2 f(x,0) = x\) pour \(x \neq 0\). Ces formules restent vraies en \(0\).
Par conséquent, \(\partial_2 \partial_1 f(0,0) = -4\) alors que \(\partial_1 \partial_2 f(0,0) = 1\). La fonction est \(C^1\), mais elle n’est pas \(C^2\) au voisinage de l’origine.
6.2 Formules de Taylor à l’ordre deux
Soit \(f : U \to \mathbb{R}\) de classe \(C^2\), et \(h\) tel que le segment \([a, a+h]\) soit inclus dans \(U\).
- (Taylor avec reste intégral) \(f(a+h) = f(a) + df(a)h + \int_0^1 (1-t)\,d^2 f(a+th)(h,h)\,dt\).
- (Taylor-Young) \(f(a+h) = f(a) + df(a)h + \frac{1}{2}d^2 f(a)(h,h) + o(\|h\|^2)\) quand \(h \to 0\).
Posons \(\varphi(t) = f(a + th)\). La règle de la chaîne donne \(\varphi^{\prime}(t) = df(a+th)h\), puis \(\varphi^{\prime\prime}(t) = d^2 f(a+th)(h,h)\). La formule de Taylor avec reste intégral pour \(\varphi\) entre \(0\) et \(1\) fournit le premier point.
Pour le second, on écrit \(\frac{1}{2}d^2 f(a)(h,h) = \int_0^1 (1-t)\,d^2 f(a)(h,h)\,dt\). La différence des deux intégrales est majorée par \(\frac{1}{2}\sup_{t} \|d^2 f(a+th) – d^2 f(a)\|\,\|h\|^2\). Ce sup tend vers \(0\) par continuité de \(d^2 f\).
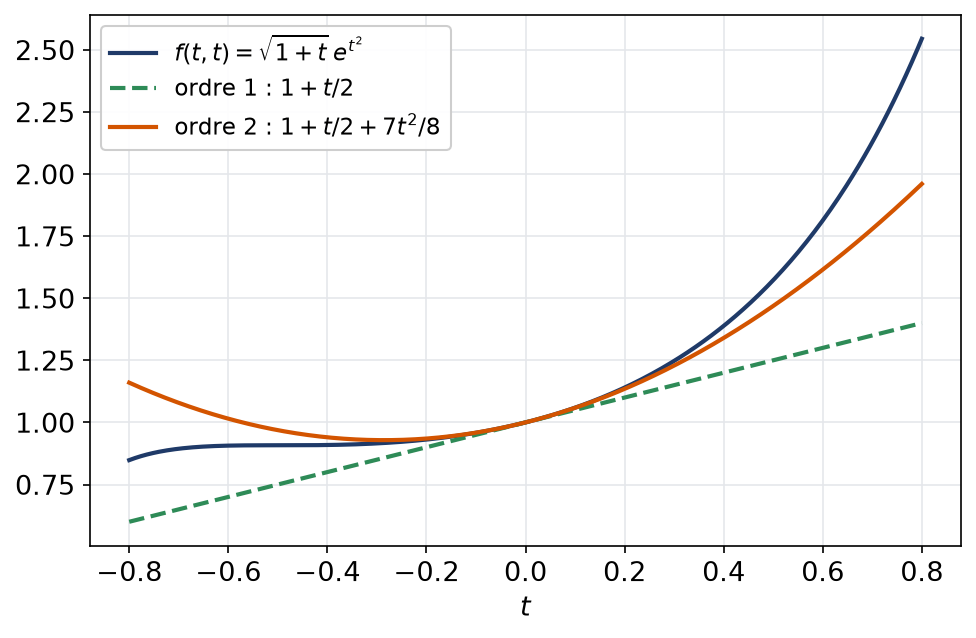
Développons \(f(x,y) = \sqrt{1+x}\,e^{xy}\) en \((0,0)\) à l’ordre deux. D’abord, \(\sqrt{1+x} = 1 + \frac{x}{2} – \frac{x^2}{8} + o(x^2)\). Ensuite, \(e^{xy} = 1 + xy + o(\|(x,y)\|^2)\). En multipliant et en gardant les termes de degré au plus deux, on obtient \[f(x,y) = 1 + \frac{x}{2} – \frac{x^2}{8} + xy + o(x^2 + y^2).\]
Par unicité du développement, \(\nabla f(0,0) = (\frac{1}{2}, 0)\). De plus, la hessienne en \(0\) vaut \(\begin{pmatrix} -1/4 & 1 \\ 1 & 0 \end{pmatrix}\), car \(\frac{1}{2}{}^t h\,\mathrm{Hess}\,h = -\frac{x^2}{8} + xy\).
La figure compare \(f\) et ses approximations le long de la diagonale \(x = y = t\). Sur cette droite, le développement devient \(1 + \frac{t}{2} + \frac{7t^2}{8}\), bien plus fidèle que l’approximation affine.
- Repérer les briques d’une variable : exponentielle, racine, logarithme, fonctions trigonométriques.
- Écrire leurs développements limités en ne gardant que les termes de degré total au plus deux en \((x,y)\).
- Multiplier ou composer, puis tronquer au degré deux ; le reste est un \(o(x^2 + y^2)\).
- Lire le gradient sur la partie linéaire et la hessienne sur la partie quadratique, sans oublier le facteur \(\frac{1}{2}\) devant les termes carrés.
Cette méthode évite de calculer cinq dérivées partielles successives. Elle repose sur l’unicité du développement de Taylor-Young, qui découle de l’unicité de \(df(a)\) et de la symétrie de \(d^2 f(a)\). En revanche, elle exige que \(f\) soit de classe \(C^2\) ; sinon, un développement d’ordre deux peut exister sans que la hessienne ait un sens.
Remarque :
Le même schéma définit \(d^k f\) pour tout entier \(k\), comme forme \(k\)-linéaire symétrique. La formule de Taylor-Young à l’ordre \(k\) s’écrit alors avec les termes \(\frac{1}{j!}d^j f(a)(h, \dots, h)\), pour \(j \leq k\).
Les erreurs fréquentes
- Conclure à la différentiabilité parce que toutes les dérivées directionnelles existent.
- Oublier de vérifier la continuité de la partie linéaire en dimension infinie.
- Écrire \(d(\mathrm{inv})(A)H = -A^{-2}H\) : les matrices ne commutent pas en général.
- Chercher un point intermédiaire \(c\) avec \(f(b) – f(a) = df(c)(b-a)\) quand \(f\) prend ses valeurs dans \(\mathbb{R}^p\), \(p \geq 2\).
- Appliquer les accroissements finis sur un ouvert non convexe sans vérifier que le segment est inclus dans le domaine.
- Permuter des dérivées partielles secondes sans s’assurer que la fonction est de classe \(C^2\).
Fiche mémo
- Différentiable en \(a\) : \(f(a+h) = f(a) + df(a)h + o(\|h\|)\), avec \(df(a)\) linéaire continue et unique.
- Différentiable implique continue et \(D_v f(a) = df(a)v\) ; les réciproques sont fausses.
- Sur \(\mathbb{R}^n\) : \(df(a)h = \sum_j h_j\,\partial_j f(a) = \langle \nabla f(a), h\rangle\).
- Composée : \(d(g \circ f)(a) = dg(f(a)) \circ df(a)\), soit \(J_{g\circ f} = J_g J_f\).
- Bilinéaire : \(dB(a,b)(h,k) = B(a,k) + B(h,b)\).
- Inverse : \(-A^{-1}HA^{-1}\). Déterminant : \(\mathrm{tr}({}^t\mathrm{com}(A)H)\), soit \(\mathrm{tr}\,H\) en \(I_n\).
- Norme préhilbertienne en \(a \neq 0\) : \(h \mapsto \langle a, h\rangle / \|a\|\) ; aucune norme n’est différentiable en \(0\).
- Accroissements finis : \(\|f(b) – f(a)\| \leq \sup_{[a,b]} \|df\|\,\|b – a\|\).
- Schwarz : \(d^2 f(a)\) est symétrique ; hessienne symétrique pour \(f\) de classe \(C^2\).
- Taylor-Young : \(f(a) + df(a)h + \frac{1}{2}d^2 f(a)(h,h) + o(\|h\|^2)\).
Questions fréquentes
Quelle différence entre différentiable et admettre des dérivées partielles ?
Être différentiable, c’est admettre un seul opérateur linéaire qui approche les accroissements uniformément autour du point, l’erreur restant petite devant la norme de h. Les dérivées partielles ne regardent que les axes. Une fonction peut avoir des dérivées partielles, et même des dérivées dans toutes les directions, sans être continue.
Comment montrer qu'une fonction de plusieurs variables est de classe C1 ?
En dimension finie, il suffit de montrer que ses dérivées partielles existent et sont continues sur l’ouvert considéré. Pour les fonctions usuelles, on invoque les opérations : sommes, produits, quotients et composées de fonctions de classe C1 restent de classe C1. Le retour à la définition n’est utile qu’aux points délicats.
Pourquoi n'a-t-on pas d'égalité des accroissements finis en dimension supérieure ?
Pour une fonction à valeurs vectorielles, chaque coordonnée a son propre point intermédiaire, et ces points n’ont aucune raison de coïncider. L’exemple du cercle parcouru à vitesse constante le montre : l’accroissement total est nul alors que la dérivée ne s’annule jamais. On garde en revanche une inégalité.
Le théorème de Schwarz est-il toujours vrai ?
Non, il demande une hypothèse de régularité, par exemple que la fonction soit de classe C2 au voisinage du point. Sans elle, les dérivées croisées peuvent différer, comme dans le contre-exemple du cours où elles valent -4 et 1 à l’origine.
Pour aller plus loin
- S’exercer : exercices corrigés de L3 de maths sur différentielle de Fréchet
- Bases utiles : Espaces de Banach et opérateurs linéaires continus
- Chapitre d’avant : Dunford, Jordan et endomorphismes nilpotents
- Chapitre d’après : Théorèmes d'inversion locale et des fonctions implicites
- Vérifier ses acquis : QCM de L3 de maths sur différentielle de Fréchet
- Contrôle corrigé en temps limité : Différentielles en dimension infinie : contrôle de maths en L3
- Un autre sujet noté sur 20 : Examen de calcul différentiel : contrôle de maths en L3
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «différentielle de Fréchet en L3 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.