Diagonaliser une matrice en L2 de maths : cours et méthodes
Ce chapitre explique comment diagonaliser L2 pas à pas, en partant de petites matrices 2×2 dont on voit agir les vecteurs propres sur une figure. Nous construisons ensuite les outils généraux : sous-espaces stables, spectre, polynôme caractéristique et multiplicités.
Au premier semestre de la deuxième année, cette réduction sert de pivot. En effet, elle prépare le théorème spectral, les formes quadratiques et l’étude des équations différentielles. Chaque critère est démontré, puis appliqué sur des exemples choisis pour montrer ce qui marche et ce qui échoue.
Enfin, deux applications concrètes ferment le chapitre : le calcul de puissances de matrices pour des suites récurrentes couplées, et la résolution des systèmes différentiels linéaires à coefficients constants.
Ce que vous saurez faire
- Reconnaître un sous-espace stable et en tirer une matrice triangulaire par blocs.
- Calculer les valeurs propres et les vecteurs propres d’une matrice carrée.
- Obtenir le polynôme caractéristique et lire les multiplicités de chaque valeur propre.
- Décider si une matrice est diagonalisable grâce aux critères de dimension.
- Calculer une puissance \(A^n\) et résoudre un système de suites récurrentes.
- Résoudre un système différentiel linéaire \(X^{\prime}=AX\) à coefficients constants.
1. Vecteurs propres et sous-espaces stables
Dans tout le chapitre, \(\mathbb{K}\) désigne \(\mathbb{R}\) ou \(\mathbb{C}\). On fixe un espace vectoriel \(E\) de dimension finie \(n\) et un endomorphisme \(u\) de \(E\). Nous partons d’une question simple : existe-t-il des directions que \(u\) se contente d’étirer ? Si oui, la matrice de \(u\) dans une base bien choisie devient beaucoup plus lisible.
1.1 Une première matrice 2×2
Prenons la matrice suivante et regardons son action sur trois vecteurs du plan.
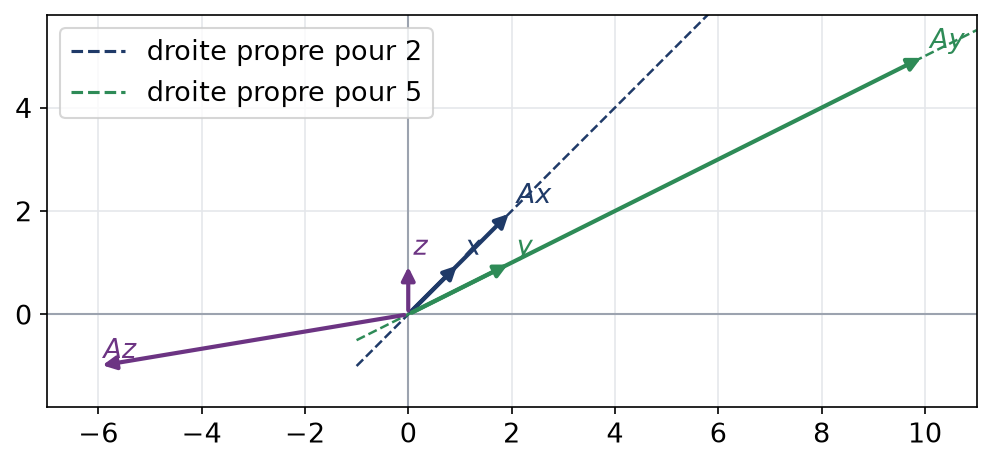
Soit \(A=\begin{pmatrix}8 & -6\\ 3 & -1\end{pmatrix}\). Pour \(x=(1,1)\), on trouve \(Ax=(2,2)=2x\). Pour \(y=(2,1)\), on trouve \(Ay=(10,5)=5y\). En revanche, pour \(z=(0,1)\), on obtient \(Az=(-6,-1)\), qui n’est pas colinéaire à \(z\).
Ainsi, les droites dirigées par \(x\) et \(y\) sont simplement étirées, d’un facteur 2 et d’un facteur 5. Dans la base \((x,y)\), l’endomorphisme associé a donc pour matrice \(\mathrm{diag}(2,5)\).
La figure montre ce phénomène : les flèches \(x\) et \(Ax\) restent sur la même droite, tout comme \(y\) et \(Ay\). Au contraire, \(z\) change de direction.
1.2 Valeurs propres, vecteurs propres, spectre
L’exemple conduit naturellement aux définitions suivantes.
On dit que \(\lambda\in\mathbb{K}\) est une valeur propre de \(u\) lorsque l’équation \(u(x)=\lambda x\) admet au moins une solution \(x\) non nulle. Ces solutions non nulles sont les vecteurs propres pour \(\lambda\). Elles forment, avec le vecteur nul, le sous-espace propre \(E_\lambda(u)=\ker(u-\lambda\,\mathrm{id})\). Enfin, on appelle spectre de \(u\), et l’on note \(\mathrm{Sp}(u)\), la collection de toutes ses valeurs propres.
Pour une matrice \(A\in\mathcal{M}_n(\mathbb{K})\), on applique les mêmes définitions à l’endomorphisme \(X\mapsto AX\) de \(\mathbb{K}^n\). Par conséquent, trouver une valeur propre revient à trouver un \(\lambda\) qui rend le noyau de \(A-\lambda I_n\) non trivial, autrement dit qui rend cette matrice singulière.
Piège à éviter :
Un vecteur propre n’est jamais nul, par définition. En revanche, une valeur propre peut très bien valoir 0 : cela signifie exactement que \(u\) n’est pas injectif.
1.3 Sous-espaces stables
Une droite dirigée par un vecteur propre est envoyée dans elle-même. Cette idée se généralise aux sous-espaces de toute dimension.
Un sous-espace \(F\) de \(E\) est stable par \(u\) lorsque \(u(F)\subset F\). L’application \(x\mapsto u(x)\) de \(F\) dans \(F\) est alors un endomorphisme de \(F\), appelé endomorphisme induit et noté \(u_F\).
Fixons une base \((e_1,\dots,e_p)\) de \(F\) et complétons-la en une base \(\mathcal{B}=(e_1,\dots,e_n)\) de \(E\). La stabilité de \(F\) équivaut à l’existence d’un bloc nul en bas à gauche : \(\mathrm{Mat}_{\mathcal{B}}(u)=\begin{pmatrix}A_1 & B_1\\ 0 & C_1\end{pmatrix}\), où \(A_1\) a \(p\) lignes et \(p\) colonnes. Le bloc \(A_1\) représente alors \(u_F\) dans la base \((e_1,\dots,e_p)\).
La \(j\)-ième colonne de la matrice contient les coordonnées de \(u(e_j)\). D’abord, si \(F\) est stable, alors \(u(e_j)\in F\) pour \(j\le p\). Les coordonnées de rang \(p+1\) à \(n\) sont donc nulles, d’où le bloc nul. Réciproquement, si ce bloc est nul, chaque \(u(e_j)\) avec \(j\le p\) appartient à \(F\). Par linéarité, \(u(F)\subset F\).
Deux familles de sous-espaces stables reviennent sans cesse. D’une part, une droite \(\mathbb{K}x\) est stable si et seulement si \(x\) est un vecteur propre. D’autre part, si \(v\) commute avec \(u\), alors le noyau et l’image de \(v\) sont stables par \(u\). En particulier, chaque sous-espace propre de \(u\) est stable par tout endomorphisme qui commute avec \(u\).
1.4 Les sous-espaces propres sont en somme directe
Le résultat suivant est la clé de toute la réduction. Il affirme que des vecteurs propres associés à des valeurs propres différentes ne peuvent jamais se « compenser ».
Prenons \(p\) valeurs propres \(\lambda_1,\dots,\lambda_p\) de \(u\), sans répétition. Alors les sous-espaces \(E_{\lambda_1},\dots,E_{\lambda_p}\) sont en somme directe. Par conséquent, si l’on choisit un vecteur propre \(x_k\) pour chaque \(\lambda_k\), la famille \((x_1,\dots,x_p)\) obtenue est libre.
Nous procédons par récurrence sur le nombre \(p\) de valeurs propres. Le cas \(p=1\) est évident. Supposons le résultat vrai au rang \(p-1\), et prenons \(x_k\in E_{\lambda_k}\) tels que \(x_1+\dots+x_p=0\).
D’abord, on applique \(u\) : on obtient \(\lambda_1x_1+\dots+\lambda_px_p=0\). Ensuite, on retranche \(\lambda_p\) fois la relation de départ. Le terme d’indice \(p\) disparaît : \(\sum_{k=1}^{p-1}(\lambda_k-\lambda_p)x_k=0\).
Dans cette nouvelle somme, le terme \((\lambda_k-\lambda_p)x_k\) reste dans \(E_{\lambda_k}\). L’hypothèse faite au rang \(p-1\) force alors chacun de ces termes à s’annuler. Comme les coefficients \(\lambda_k-\lambda_p\) ne s’annulent pas, on obtient \(x_1=\dots=x_{p-1}=0\). Il reste \(x_p=0\) d’après la relation initiale.
Une conséquence immédiate mérite d’être retenue : en dimension \(n\), un endomorphisme possède au plus \(n\) valeurs propres distinctes.
2. Le polynôme caractéristique
Chercher les \(\lambda\) pour lesquels \(A-\lambda I_n\) n’est pas inversible revient à annuler un déterminant. Ce déterminant dépend polynomialement de \(\lambda\), ce qui fournit un outil de calcul systématique.
2.1 Définition et premières propriétés
Le polynôme caractéristique de \(A\in\mathcal{M}_n(\mathbb{K})\) est \(\chi_A(X)=\det(XI_n-A)\). Son degré vaut \(n\), son coefficient dominant vaut 1, et ses racines dans \(\mathbb{K}\) sont exactement les valeurs propres de \(A\).
On a \(\chi_A(X)=X^n-\mathrm{tr}(A)X^{n-1}+\dots+(-1)^n\det(A)\). De plus, deux matrices semblables ont le même polynôme caractéristique. On peut donc parler du polynôme caractéristique \(\chi_u\) d’un endomorphisme, calculé dans n’importe quelle base.
L’invariance par similitude vient du calcul \(\det(XI_n-P^{-1}AP)=\det\big(P^{-1}(XI_n-A)P\big)=\det(XI_n-A)\). Par ailleurs, la réciproque est fausse : deux matrices peuvent partager le même polynôme caractéristique sans être semblables.
En taille 2, on a simplement \(\chi_A(X)=X^2-\mathrm{tr}(A)X+\det(A)\). Pour une matrice triangulaire, le polynôme caractéristique est le produit des \((X-a_{ii})\) : les valeurs propres se lisent sur la diagonale.
Revenons à la matrice \(A\) de la partie 1. Sa trace vaut 7 et son déterminant vaut \(-8+18=10\). Le trinôme \(X^2-7X+10\) a pour racines 2 et 5, ce qui confirme \(\mathrm{Sp}(A)=\{2,5\}\).
Considérons maintenant \(R=\begin{pmatrix}1 & -2\\ 1 & -1\end{pmatrix}\). Sa trace est nulle et son déterminant vaut \(-1+2=1\). Ainsi \(\chi_R=X^2+1\) n’a aucune racine réelle : \(R\) n’a pas de valeur propre dans \(\mathbb{R}\). Dans \(\mathbb{C}\), en revanche, son spectre est \(\{i,-i\}\).
Remarque :
Le spectre dépend donc du corps de travail. Sur \(\mathbb{C}\), tout polynôme non constant est scindé, si bien que toute matrice complexe possède au moins une valeur propre.
2.2 Multiplicité algébrique et multiplicité géométrique
Une valeur propre peut être racine multiple de \(\chi_A\). Il faut alors comparer deux nombres entiers.
La multiplicité algébrique \(m(\lambda)\) est l’ordre de \(\lambda\) comme racine de \(\chi_u\). La multiplicité géométrique est la dimension \(\dim E_\lambda(u)\), c’est-à-dire \(n-\mathrm{rg}(A-\lambda I_n)\).
Pour toute valeur propre \(\lambda\) de \(u\), on a \(1\le\dim E_\lambda(u)\le m(\lambda)\).
Posons \(d=\dim E_\lambda\). D’abord, \(d\ge 1\) car \(\lambda\) possède un vecteur propre. Ensuite, on complète une base de \(E_\lambda\) en une base de \(E\). Comme \(E_\lambda\) est stable, la matrice de \(u\) s’écrit \(\begin{pmatrix}\lambda I_d & B_1\\ 0 & C_1\end{pmatrix}\).
Pour une telle matrice, le déterminant se calcule bloc par bloc sur la diagonale. Par conséquent, \(\chi_u=(X-\lambda)^d\chi_{C_1}\). Le facteur \((X-\lambda)^d\) divise donc \(\chi_u\), ce qui donne \(d\le m(\lambda)\).
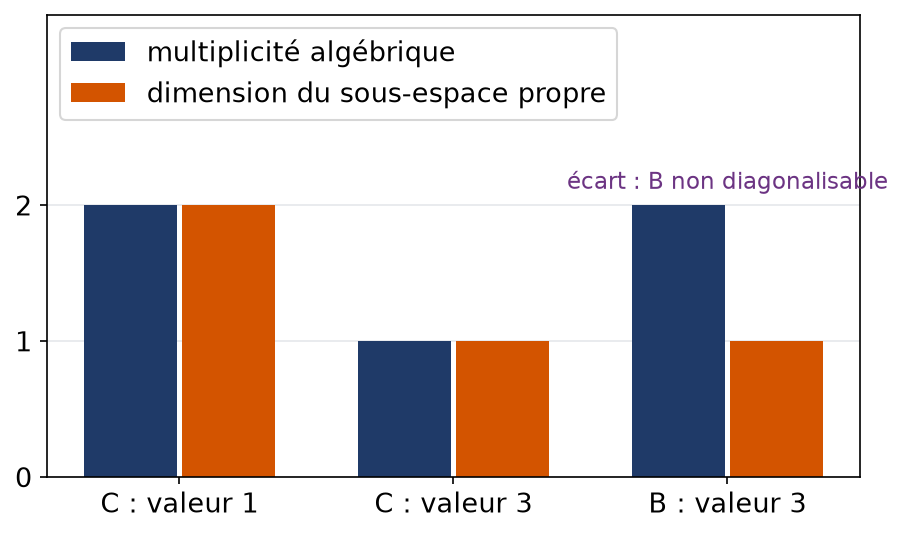
Soit \(B=\begin{pmatrix}5 & -1\\ 4 & 1\end{pmatrix}\). Sa trace vaut 6 et son déterminant \(5+4=9\), donc \(\chi_B=(X-3)^2\). Or \(B-3I_2=\begin{pmatrix}2 & -1\\ 4 & -2\end{pmatrix}\) est de rang 1. Ainsi \(\dim E_3=1\) alors que \(m(3)=2\).
Prenons ensuite la matrice triangulaire \(C=\begin{pmatrix}1 & 2 & -2\\ 0 & 3 & -2\\ 0 & 0 & 1\end{pmatrix}\). On lit \(\chi_C=(X-1)^2(X-3)\). La matrice \(C-I_3\) a deux lignes non nulles proportionnelles, \((0,2,-2)\) et \((0,2,-2)\), donc elle est de rang 1. Par suite, \(\dim E_1=2=m(1)\).
Le graphique compare les deux multiplicités pour \(B\) et \(C\). Seule la barre de \(B\) présente un défaut, et nous verrons que ce défaut interdit la diagonalisation.
3. Diagonaliser une matrice : les critères
Nous disposons maintenant de tous les ingrédients. Il reste à préciser ce que l’on cherche, puis à établir des critères faciles à vérifier.
3.1 Définition
On qualifie \(u\) de diagonalisable lorsque \(E\) admet une base entièrement composée de vecteurs propres de \(u\). Côté matrices, \(A\) carrée d’ordre \(n\) est diagonalisable quand on peut l’écrire \(A=PDP^{-1}\), avec \(P\) inversible et \(D\) diagonale.
Les deux points de vue coïncident. En effet, l’égalité \(AP=PD\) dit exactement que la \(k\)-ième colonne de \(P\) est un vecteur propre associé au \(k\)-ième coefficient de \(D\). De plus, \(P\) inversible signifie que ces colonnes forment une base.
3.2 Le critère des dimensions
Pour un endomorphisme \(u\) de \(E\), les quatre propriétés ci-dessous reviennent au même.
- \(u\) est diagonalisable.
- \(E=\bigoplus_{\lambda\in\mathrm{Sp}(u)}E_\lambda(u)\).
- \(\sum_{\lambda\in\mathrm{Sp}(u)}\dim E_\lambda(u)=n\).
- \(\chi_u\) est scindé sur \(\mathbb{K}\) et \(\dim E_\lambda(u)=m(\lambda)\) pour toute valeur propre \(\lambda\).
Nous savons déjà que la somme des sous-espaces propres est directe. Sa dimension vaut donc \(\sum\dim E_\lambda\). Cette somme est égale à \(E\) exactement quand sa dimension vaut \(n\), d’où l’équivalence de 2 et 3.
Ensuite, si \(u\) est diagonalisable, une base propre se répartit entre les \(E_\lambda\), donc la somme directe remplit \(E\). Inversement, en concaténant des bases des \(E_\lambda\), on obtient une base de \(E\) faite de vecteurs propres. Ainsi 1 équivaut à 2.
Enfin, les \(m(\lambda)\) ont une somme au plus égale à \(n\), avec égalité si et seulement si \(\chi_u\) est scindé. Comme \(\dim E_\lambda\le m(\lambda)\), on a \(\sum\dim E_\lambda\le\sum m(\lambda)\le n\). L’égalité totale impose donc les deux égalités de l’assertion 4, et réciproquement.
Supposons que \(\chi_u\) admette \(n\) racines distinctes dans \(\mathbb{K}\). Chacune fournit un sous-espace propre de dimension au moins 1, et la somme de ces \(n\) dimensions atteint \(n\). Ainsi \(u\) est diagonalisable, et tous ses sous-espaces propres sont des droites.
Piège à éviter :
Ce corollaire donne une condition suffisante, pas nécessaire. Par exemple, \(I_n\) est diagonale, donc diagonalisable, alors que sa seule valeur propre est 1. De même, la matrice \(C\) de la partie 2 est diagonalisable avec une valeur propre double.
La matrice \(B=\begin{pmatrix}5 & -1\\ 4 & 1\end{pmatrix}\) n’est pas diagonalisable sur \(\mathbb{R}\) ni sur \(\mathbb{C}\). En effet, \(\dim E_3=1<2\). D’ailleurs, si l’on avait \(B=PDP^{-1}\), la matrice \(D\) serait \(3I_2\) et donc \(B=P(3I_2)P^{-1}=3I_2\), ce qui est faux.
De même, \(R=\begin{pmatrix}1 & -2\\ 1 & -1\end{pmatrix}\) n’est pas diagonalisable sur \(\mathbb{R}\), faute de valeur propre réelle. Elle l’est cependant sur \(\mathbb{C}\), car ses deux valeurs propres \(i\) et \(-i\) sont distinctes.
3.3 La méthode complète
- Calculer \(\chi_A\) et le factoriser. S’il n’est pas scindé sur \(\mathbb{K}\), conclure : \(A\) n’est pas diagonalisable sur \(\mathbb{K}\).
- Si les racines sont toutes simples, conclure directement que \(A\) est diagonalisable.
- Sinon, pour chaque valeur propre multiple, calculer \(\mathrm{rg}(A-\lambda I_n)\) et comparer \(n-\mathrm{rg}\) avec \(m(\lambda)\).
- Si \(A\) est diagonalisable, résoudre chaque système \((A-\lambda I_n)X=0\) pour obtenir une base de \(E_\lambda\).
- Ranger ces vecteurs en colonnes dans \(P\), et les valeurs propres correspondantes, dans le même ordre, sur la diagonale de \(D\).
- Contrôler le résultat par le produit \(AP=PD\), qui évite de calculer \(P^{-1}\).
Diagonalisons \(C=\begin{pmatrix}1 & 2 & -2\\ 0 & 3 & -2\\ 0 & 0 & 1\end{pmatrix}\). Nous savons que \(\chi_C=(X-1)^2(X-3)\) et que \(\dim E_1=2\). Comme \(\dim E_3=1\), la somme des dimensions vaut 3 : \(C\) est diagonalisable.
Le sous-espace \(E_1\) est donné par l’unique équation \(2y-2z=0\), soit \(y=z\). Il admet pour base \((1,0,0)\) et \((0,1,1)\). Pour \(E_3\), le système \((C-3I_3)X=0\) donne \(z=0\) puis \(-2x+2y=0\). On retient donc \((1,1,0)\).
On pose alors \(P=\begin{pmatrix}1 & 0 & 1\\ 0 & 1 & 1\\ 0 & 1 & 0\end{pmatrix}\) et \(D=\mathrm{diag}(1,1,3)\). Le produit de contrôle donne \(CP=\begin{pmatrix}1 & 0 & 3\\ 0 & 1 & 3\\ 0 & 1 & 0\end{pmatrix}=PD\).
Dans l’exemple précédent, la matrice était triangulaire, si bien que le spectre se lisait sans calcul. Voyons maintenant un cas plein, où le déterminant demande un peu d’astuce et où la méthode s’arrête à l’étape 3.
Soit \(G=\begin{pmatrix}3 & 1 & -1\\ 2 & 2 & -1\\ 2 & 2 & 0\end{pmatrix}\). Dans \(\det(XI_3-G)\), on remplace d’abord la première ligne par sa différence avec la deuxième. Elle devient \((X-1,\,1-X,\,0)\), et l’on peut mettre \(X-1\) en facteur.
Ensuite, on ajoute la première colonne à la deuxième. Il reste un déterminant dont la première ligne vaut \((1,0,0)\), ce qui donne :
\[\chi_G=(X-1)\begin{vmatrix}X-4 & 1\\ -4 & X\end{vmatrix}=(X-1)(X^2-4X+4)=(X-1)(X-2)^2.\]
Puis on étudie la valeur double. La matrice \(G-2I_3\) a pour lignes \((1,1,-1)\), \((2,0,-1)\) et \((2,2,-2)\). La troisième vaut deux fois la première, mais les deux premières ne sont pas colinéaires. Le rang vaut donc 2, et \(\dim E_2=1<2\). Finalement, \(G\) n’est pas diagonalisable, et il est inutile de chercher \(P\).
Avant d’aller plus loin, on contrôle toujours le spectre trouvé. Lorsque \(\chi_A\) est scindé, la somme des valeurs propres, comptées avec multiplicité, vaut \(\mathrm{tr}(A)\). De même, leur produit vaut \(\det(A)\). Pour \(G\), on vérifie \(1+2+2=5=\mathrm{tr}(G)\) et \(1\times 2\times 2=4=\det(G)\). Ce test de dix secondes détecte la plupart des erreurs de signe.
Remarque :
Hors programme de ce chapitre, signalons un autre critère, très utilisé en troisième année. Une matrice est diagonalisable si et seulement si elle annule un polynôme scindé à racines simples. Par exemple, si l’on vérifie \((A-2I_3)(A+I_3)=0\), alors \(A\) est diagonalisable avec un spectre inclus dans \(\{2,-1\}\). Nous retrouverons cette idée dans les exercices, sous une forme élémentaire.
4. Puissances de matrices et suites récurrentes
La diagonalisation transforme un calcul de puissance, a priori long, en un calcul sur des nombres. C’est son application la plus directe.
4.1 Calcul de \(A^n\)
Si \(A=PDP^{-1}\) avec \(D=\mathrm{diag}(\lambda_1,\dots,\lambda_p)\), alors pour tout entier \(n\ge 0\), on a \(A^n=PD^nP^{-1}\) et \(D^n=\mathrm{diag}(\lambda_1^n,\dots,\lambda_p^n)\).
La preuve est une récurrence immédiate. En effet, dans le produit \((PDP^{-1})(PDP^{-1})\), les facteurs centraux \(P^{-1}P\) se simplifient. Si \(A\) est inversible, la formule reste vraie pour les exposants négatifs.
Pour la matrice \(A\) de la partie 1, on connaît les vecteurs propres \((1,1)\) pour 2 et \((2,1)\) pour 5. On pose donc \(P=\begin{pmatrix}1 & 2\\ 1 & 1\end{pmatrix}\). Son déterminant vaut \(-1\), d’où \(P^{-1}=\begin{pmatrix}-1 & 2\\ 1 & -1\end{pmatrix}\).
On en déduit, pour tout \(n\in\mathbb{N}\) :
\[A^n=\begin{pmatrix}2\cdot 5^n-2^n & 2^{n+1}-2\cdot 5^n\\ 5^n-2^n & 2^{n+1}-5^n\end{pmatrix}.\]
Pour vérifier, on prend \(n=1\) : on retrouve bien \(8\), \(-6\), \(3\) et \(-1\). Pour \(n=0\), on retrouve \(I_2\).
4.2 Systèmes de suites récurrentes linéaires
Considérons deux suites liées par \(u_{n+1}=au_n+bv_n\) et \(v_{n+1}=cu_n+dv_n\). En posant \(X_n=\begin{pmatrix}u_n\\ v_n\end{pmatrix}\), le système s’écrit \(X_{n+1}=AX_n\). Une récurrence donne alors \(X_n=A^nX_0\).
- Écrire la matrice \(A\) du système et la diagonaliser.
- Décomposer le vecteur initial dans la base propre : \(X_0=\alpha_1x_1+\dots+\alpha_px_p\).
- Appliquer \(A^n\) terme à terme : \(X_n=\alpha_1\lambda_1^nx_1+\dots+\alpha_p\lambda_p^nx_p\).
- Lire les composantes, puis contrôler sur \(n=0\) et \(n=1\).
Cette méthode évite complètement le calcul de \(P^{-1}\). De plus, elle montre d’un coup d’œil le comportement asymptotique : la valeur propre de plus grand module l’emporte, sauf si son coefficient \(\alpha_k\) est nul.
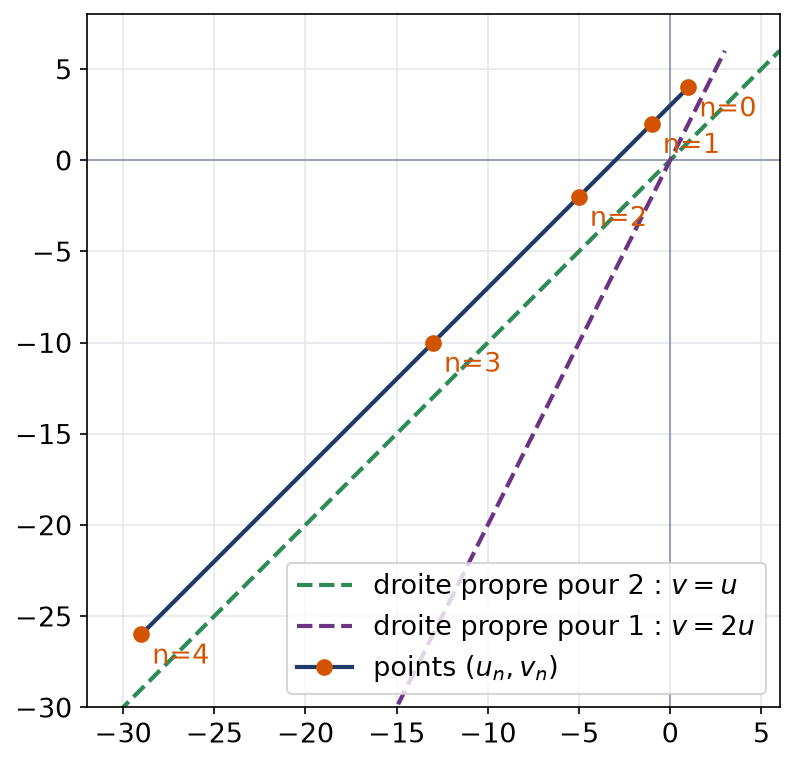
Soit \(u_0=1\), \(v_0=4\) et, pour tout \(n\), \(u_{n+1}=3u_n-v_n\), \(v_{n+1}=2u_n\). La matrice est \(A=\begin{pmatrix}3 & -1\\ 2 & 0\end{pmatrix}\), de trace 3 et de déterminant 2. Donc \(\chi_A=(X-1)(X-2)\).
Le vecteur \((1,2)\) engendre \(E_1\), et \((1,1)\) engendre \(E_2\). Ensuite, on résout \((1,4)=\alpha(1,2)+\beta(1,1)\). On obtient \(\alpha=3\) et \(\beta=-2\). Par conséquent :
\[u_n=3-2^{n+1},\qquad v_n=6-2^{n+1}.\]
Pour contrôler, on calcule \(u_1=3-4=-1\) et \(v_1=2\), conformément aux relations de départ.
La figure place les points \((u_n,v_n)\) dans le plan. Ils s’alignent vite le long de la droite propre associée à 2, car le terme en \(2^{n+1}\) écrase la constante.
Remarque :
Une récurrence d’ordre deux \(w_{n+2}=pw_{n+1}+qw_n\) se ramène au même cadre. Il suffit de poser \(X_n=(w_n,w_{n+1})\) et d’utiliser la matrice \(\begin{pmatrix}0 & 1\\ q & p\end{pmatrix}\). Son polynôme caractéristique \(X^2-pX-q\) est l’équation caractéristique bien connue.
5. Systèmes différentiels linéaires
La même stratégie s’applique aux équations différentielles. On cherche ici les fonctions dérivables \(X:\mathbb{R}\to\mathbb{K}^n\) telles que \(X^{\prime}(t)=AX(t)\), où \(A\) est une matrice constante.
5.1 Découplage par changement de base
Supposons \(A=PDP^{-1}\) avec \(D=\mathrm{diag}(\lambda_1,\dots,\lambda_n)\), et notons \(x_1,\dots,x_n\) les colonnes de \(P\). Alors les solutions de \(X^{\prime}=AX\) sont exactement les fonctions
\[X(t)=c_1e^{\lambda_1t}x_1+\dots+c_ne^{\lambda_nt}x_n,\qquad (c_1,\dots,c_n)\in\mathbb{K}^n.\]
Posons \(Y=P^{-1}X\). Comme \(P\) est constante, on a \(Y^{\prime}=P^{-1}X^{\prime}\). Ainsi, \(X^{\prime}=AX\) équivaut à \(Y^{\prime}=P^{-1}APY=DY\).
Ce dernier système est découplé : chaque composante vérifie \(y_k^{\prime}=\lambda_ky_k\). Donc \(y_k(t)=c_ke^{\lambda_kt}\) avec \(c_k\) constante. Enfin, on revient à \(X=PY\), ce qui donne la formule annoncée.
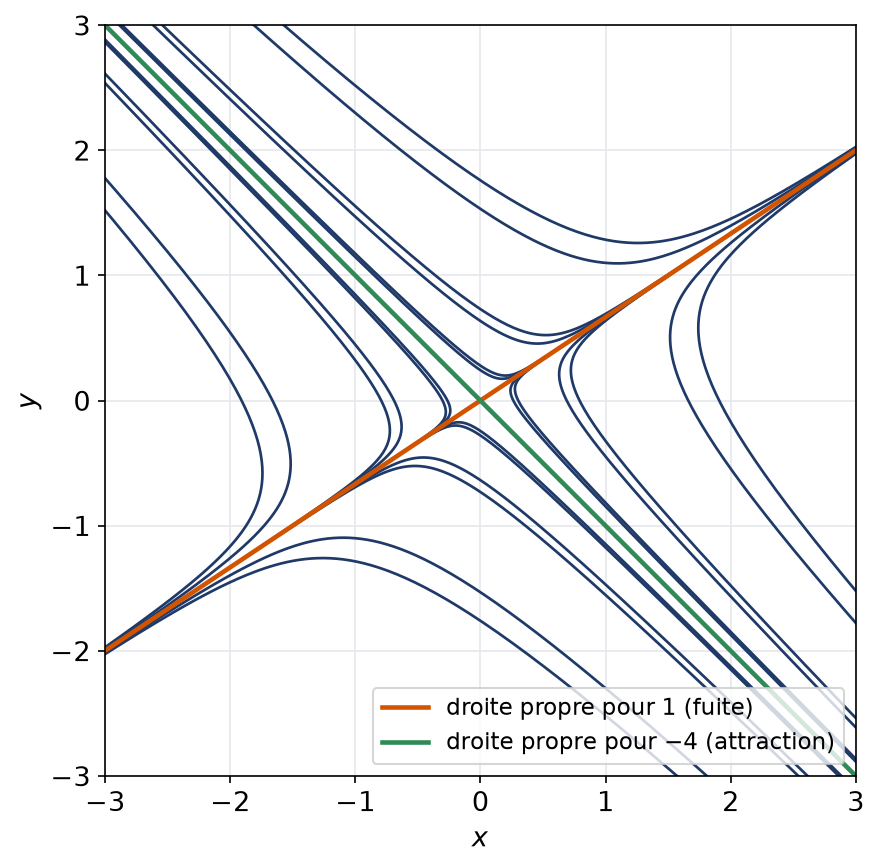
Résolvons \(x^{\prime}=-x+3y\), \(y^{\prime}=2x-2y\). La matrice \(S=\begin{pmatrix}-1 & 3\\ 2 & -2\end{pmatrix}\) a pour trace \(-3\) et pour déterminant \(2-6=-4\). Donc \(\chi_S=X^2+3X-4=(X-1)(X+4)\).
Ensuite, \(S-I_2\) a pour première ligne \((-2,3)\), d’où le vecteur propre \((3,2)\). De même, \(S+4I_2\) a pour première ligne \((3,3)\), d’où \((1,-1)\). Les solutions sont donc :
\[\begin{pmatrix}x(t)\\ y(t)\end{pmatrix}=c_1e^{t}\begin{pmatrix}3\\ 2\end{pmatrix}+c_2e^{-4t}\begin{pmatrix}1\\ -1\end{pmatrix}.\]
Le portrait de phase ci-dessous trace plusieurs trajectoires. Elles arrivent le long de la droite propre de \(-4\), puis repartent vers l’infini en longeant celle de 1. On parle de point selle.
Piège à éviter :
Les constantes \(c_k\) sont les coordonnées de \(X(0)\) dans la base propre, et non les composantes de \(X(0)\) elles-mêmes. Pour une condition initiale donnée, il faut donc résoudre un petit système linéaire.
5.2 Lecture qualitative
Le signe des valeurs propres réelles décrit le comportement en temps long. Si toutes sont strictement négatives, toutes les solutions tendent vers 0. Si l’une est strictement positive, une solution générique diverge. Enfin, une valeur propre nulle fournit des solutions constantes, c’est-à-dire des états d’équilibre.
- Écrire le système sous la forme \(X^{\prime}=AX\) en repérant soigneusement chaque coefficient.
- Diagonaliser \(A\) et noter, dans le même ordre, les valeurs propres \(\lambda_k\) et les vecteurs propres \(x_k\).
- Écrire la solution générale \(\sum c_ke^{\lambda_kt}x_k\).
- Si une condition initiale est imposée, résoudre \(\sum c_kx_k=X(0)\).
- Vérifier enfin une équation du système en dérivant la solution obtenue.
5.3 Et si les valeurs propres sont complexes ?
Une matrice réelle peut avoir des valeurs propres complexes conjuguées \(\alpha\pm i\beta\). Dans ce cas, on diagonalise sur \(\mathbb{C}\), puis on revient aux solutions réelles en prenant parties réelles et imaginaires. On obtient alors des termes en \(e^{\alpha t}\cos(\beta t)\) et \(e^{\alpha t}\sin(\beta t)\). Ainsi, le signe de \(\alpha\) décide de la convergence, tandis que \(\beta\) crée une rotation. Par exemple, la matrice \(R\) de la partie 2 donne des trajectoires fermées, car ses valeurs propres \(\pm i\) ont une partie réelle nulle.
Les erreurs fréquentes
- Conclure qu’une matrice n’est pas diagonalisable parce qu’elle a une valeur propre multiple : il faut d’abord calculer la dimension du sous-espace propre.
- Ranger les vecteurs propres dans \(P\) dans un ordre différent de celui des valeurs propres dans \(D\).
- Oublier que le spectre dépend du corps : une matrice réelle peut n’avoir aucune valeur propre réelle.
- Confondre \(\det(A-XI_n)\) et \(\det(XI_n-A)\) : ils diffèrent du signe \((-1)^n\), ce qui ne change pas les racines.
- Prendre pour constantes d’un système différentiel les composantes de \(X(0)\) au lieu de ses coordonnées dans la base propre.
Fiche mémo
- \(\lambda\in\mathrm{Sp}(A)\) exactement quand \(\det(A-\lambda I_n)=0\).
- Une droite \(\mathbb{K}x\) est stable si et seulement si \(x\) est un vecteur propre.
- Une famille de vecteurs propres pris pour des valeurs propres toutes différentes est libre.
- \(\chi_A=\det(XI_n-A)\), unitaire de degré \(n\) ; en taille 2, \(\chi_A=X^2-\mathrm{tr}(A)X+\det(A)\).
- Pour toute valeur propre : \(1\le\dim E_\lambda\le m(\lambda)\).
- Diagonalisable si et seulement si \(\sum\dim E_\lambda=n\), ou encore \(\chi_A\) scindé et \(\dim E_\lambda=m(\lambda)\) pour tout \(\lambda\).
- \(n\) valeurs propres distinctes suffisent pour être diagonalisable.
- \(A^n=PD^nP^{-1}\) ; pour une suite, \(X_n=\sum\alpha_k\lambda_k^nx_k\).
- Pour \(X^{\prime}=AX\) : \(X(t)=\sum c_ke^{\lambda_kt}x_k\).
Questions fréquentes
Comment savoir rapidement si une matrice est diagonalisable ?
On commence par le polynôme caractéristique. S’il possède n racines distinctes dans le corps, la matrice est diagonalisable sans autre calcul. Sinon, on calcule pour chaque valeur propre multiple le rang de A moins lambda fois l’identité, afin d’obtenir la dimension du sous-espace propre. La matrice est diagonalisable exactement quand chaque dimension égale la multiplicité.
Une matrice réelle sans valeur propre réelle peut-elle être diagonalisable ?
Pas dans R, car une matrice diagonalisable sur R possède au moins une valeur propre réelle. En revanche, elle peut l’être dans C. C’est le cas d’une matrice 2×2 réelle dont le polynôme caractéristique a deux racines complexes conjuguées distinctes.
Faut-il calculer l'inverse de P pour obtenir A puissance n ?
Oui dans la méthode directe, puisque A puissance n vaut P D puissance n P inverse. Cependant, pour une suite récurrente, il suffit souvent de décomposer le vecteur initial dans la base propre. Les coordonnées obtenues remplacent alors le calcul complet de l’inverse.
Pourquoi l'ordre des colonnes de P compte-t-il ?
La k-ième colonne de P doit être un vecteur propre associé au k-ième coefficient diagonal de D. Si l’on permute les colonnes de P sans permuter la diagonale de D, l’égalité devient fausse. On garde donc toujours le même ordre dans P et dans D.
Pour aller plus loin
- S’exercer : exercices corrigés de L2 de maths sur diagonaliser une matrice
- Chapitre d’avant : Intégrales impropres : critères de convergence
- Chapitre d’après : Polynômes annulateurs et trigonalisation
- Vérifier ses acquis : QCM de L2 de maths sur diagonaliser une matrice
- Contrôle corrigé en temps limité : Puissances de matrices et suites récurrentes : contrôle de maths en L2
- Un autre sujet noté sur 20 : Partiel d'algèbre du semestre 3 : contrôle de maths en L2
- Tous les chapitres : le sommaire de la L2 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «diagonaliser une matrice en L2 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.