Dunford et Jordan en L3 de maths : cours et méthodes
Ce cours Dunford Jordan L3 termine la réduction des endomorphismes en dimension finie. Nous partons du polynôme minimal et du lemme des noyaux, qui découpent l’espace en sous-espaces caractéristiques. Sur chacun d’eux, l’endomorphisme s’écrit comme une homothétie plus un nilpotent : c’est la décomposition de Dunford.
Ensuite, nous étudions les nilpotents à travers leurs noyaux itérés. Les sauts de dimension se rangent dans un tableau de Young, qui donne directement la réduite de Jordan. Tous les exemples fondamentaux sont traités en dimension 4. Nous en tirons un critère pratique pour décider si deux matrices sont semblables, puis nous présentons les invariants de similitude. Enfin, une partie de dualité (base duale, orthogonal, transposée) explique pourquoi une matrice et sa transposée ont toujours la même réduite.
Ce que vous saurez faire
- Trouver le polynôme minimal d’une matrice et découper l’espace grâce au lemme des noyaux.
- Calculer les projecteurs sur les sous-espaces caractéristiques par une relation de Bézout.
- Calculer une décomposition de Dunford et vérifier qu’elle en est bien une.
- Lire la réduite de Jordan d’un nilpotent sur les dimensions de ses noyaux itérés.
- Construire une base de Jordan en dimension 4, chaîne par chaîne.
- Décider si deux matrices sont semblables, ou exhiber un invariant qui les sépare.
- Calculer une base duale et utiliser la transposée pour relier noyaux et images.
1. Polynôme minimal et lemme des noyaux
Dans tout le chapitre, \(E\) désigne un espace vectoriel de dimension finie \(n \geq 1\) sur un corps \(\mathbb{K}\), et \(u\) un endomorphisme de \(E\). Pour un polynôme \(P = \sum a_k X^k\), on note \(P(u) = \sum a_k u^k\), avec \(u^0 = \mathrm{id}_E\). L’application \(P \mapsto P(u)\) est un morphisme d’algèbres. Par conséquent, deux polynômes en \(u\) commutent toujours. Ce fait banal servira sans cesse.
1.1 Polynômes annulateurs
L’espace \(\mathcal{L}(E)\) est de dimension \(n^2\). Ainsi, la famille \(\mathrm{id}_E, u, \ldots, u^{n^2}\) est liée, donc \(u\) possède un polynôme annulateur non nul. Le théorème de Cayley-Hamilton donne d’ailleurs mieux : le polynôme caractéristique \(\chi_u\) annule \(u\).
Les polynômes qui annulent \(u\) forment un idéal de \(\mathbb{K}[X]\), non réduit à zéro. Cet idéal est principal. On note \(\mu_u\) son générateur unitaire et on le nomme polynôme minimal de \(u\). Ainsi, un polynôme annule \(u\) exactement lorsqu’il est multiple de \(\mu_u\).
Les racines de \(\mu_u\) dans \(\mathbb{K}\) sont exactement les valeurs propres de \(u\). De plus, \(\mu_u\) divise \(\chi_u\), donc \(\deg \mu_u \leq n\).
Soit \(\lambda\) une valeur propre et \(x\) un vecteur propre associé. On a \(P(u)(x) = P(\lambda)x\) pour tout polynôme \(P\). En prenant \(P = \mu_u\), on obtient \(\mu_u(\lambda)x = 0\), donc \(\mu_u(\lambda) = 0\). Réciproquement, si \(\mu_u(\lambda) = 0\), on écrit \(\mu_u = (X – \lambda)Q\) avec \(\deg Q < \deg \mu_u\). Alors \(Q(u) \neq 0\) par minimalité. Or \((u – \lambda \, \mathrm{id})\circ Q(u) = 0\), donc l’image de \(Q(u)\), non nulle, est contenue dans \(\ker(u – \lambda \, \mathrm{id})\). Ainsi \(\lambda\) est valeur propre. La divisibilité découle enfin de Cayley-Hamilton.
1.2 Le lemme des noyaux
Le lemme des noyaux est l’outil de découpage de tout le chapitre. Il transforme une factorisation de polynômes en décomposition de l’espace.
On se donne \(r\) polynômes \(P_1, \ldots, P_r\), premiers entre eux pris deux à deux, et l’on note \(P\) leur produit. Le noyau de \(P(u)\) se découpe alors ainsi :
\[\ker P(u) = \ker P_1(u) \oplus \cdots \oplus \ker P_r(u).\]
En outre, chaque projection sur l’un des facteurs s’obtient en restreignant à \(\ker P(u)\) un polynôme en \(u\).
Nous traitons \(r = 2\) ; une récurrence donne le cas général. Par Bézout, il existe \(A\) et \(B\) avec \(AP_1 + BP_2 = 1\). D’abord, si \(x \in \ker P_1(u) \cap \ker P_2(u)\), alors \(x = A(u)P_1(u)x + B(u)P_2(u)x = 0\). Ensuite, soit \(x \in \ker P(u)\). On pose \(x_1 = B(u)P_2(u)x\) et \(x_2 = A(u)P_1(u)x\), de sorte que \(x = x_1 + x_2\). Or \(P_1(u)x_1 = B(u)P(u)x = 0\), donc \(x_1 \in \ker P_1(u)\). De même, \(x_2 \in \ker P_2(u)\). L’inclusion réciproque est immédiate, car \(P_1\) et \(P_2\) divisent \(P\). Enfin, les projections \(x \mapsto x_1\) et \(x \mapsto x_2\) sont bien des polynômes en \(u\).
Remarque :
Avec \(P = \mu_u\) ou \(P = \chi_u\), on a \(P(u) = 0\), donc \(\ker P(u) = E\). C’est ce cas qui sert presque toujours. Par exemple, si \(u^3 = 9u\), alors \(E = \ker u \oplus \ker(u – 3\,\mathrm{id}) \oplus \ker(u + 3\,\mathrm{id})\), et \(u\) est diagonalisable.
2. Sous-espaces caractéristiques
On suppose désormais \(\chi_u\) scindé : \(\chi_u = \prod_{i=1}^{s} (X – \lambda_i)^{m_i}\), avec des \(\lambda_i\) distincts. C’est automatique sur \(\mathbb{C}\). Les facteurs \((X – \lambda_i)^{m_i}\) sont premiers entre eux deux à deux. Le lemme des noyaux s’applique donc avec \(P = \chi_u\).
Le sous-espace caractéristique de \(u\) associé à \(\lambda_i\) est \(F_i = \ker (u – \lambda_i \, \mathrm{id})^{m_i}\), où \(m_i\) est la multiplicité de \(\lambda_i\) dans \(\chi_u\).
On a \(E = F_1 \oplus \cdots \oplus F_s\). Chaque \(F_i\) est stable par \(u\) et \(\dim F_i = m_i\). Sur \(F_i\), l’endomorphisme induit \(u_i – \lambda_i \, \mathrm{id}\) est nilpotent. Enfin, \(F_i = \ker(u – \lambda_i\,\mathrm{id})^{k_i}\), où \(k_i\) est la multiplicité de \(\lambda_i\) dans \(\mu_u\).
La somme directe vient du lemme des noyaux. Ensuite, l’endomorphisme \((u – \lambda_i\,\mathrm{id})^{m_i}\) commute avec \(u\), ce qui assure la stabilité de son noyau \(F_i\). Par construction, \((u_i – \lambda_i \,\mathrm{id})^{m_i} = 0\), donc \(u_i\) n’a que \(\lambda_i\) pour valeur propre. Ainsi \(\chi_{u_i} = (X – \lambda_i)^{\dim F_i}\). Or \(\chi_u\) est le produit des \(\chi_{u_i}\), et l’identification des exposants donne \(\dim F_i = m_i\). Le même raisonnement, mené avec \(\mu_u\) au lieu de \(\chi_u\), fournit la dernière égalité.
2.1 Un exemple en dimension 3
En pratique, le sous-espace caractéristique contient le sous-espace propre, souvent strictement. L’écart entre les deux mesure exactement le défaut de diagonalisabilité.
Prenons \(A = \begin{pmatrix} 3 & 1 & -1 \\ 3 & 2 & -3 \\ 4 & 1 & -2 \end{pmatrix}\). Un calcul direct donne \(\chi_A = (X – 2)^2(X + 1)\). D’abord, \(\ker(A + I_3)\) est la droite engendrée par \((0, 1, 1)\). Ensuite,
\[(A – 2I_3)^2 = \begin{pmatrix} 0 & 0 & 0 \\ -9 & 0 & 9 \\ -9 & 0 & 9 \end{pmatrix},\]
donc \(F_2 = \ker(A – 2I_3)^2\) est le plan d’équation \(x = z\). En revanche, \(\ker(A – 2I_3)\) est seulement la droite dirigée par \((1, 0, 1)\). Par conséquent, \(A\) n’est pas diagonalisable et \(\mu_A = (X – 2)^2(X + 1)\).
3. La décomposition de Dunford
Sur chaque sous-espace caractéristique, \(u\) est une homothétie perturbée par un nilpotent. Nous recollons maintenant ces morceaux en un énoncé global, qui ne demande aucun choix de base.
3.1 Existence et unicité de la décomposition de Dunford
On suppose \(\chi_u\) scindé. Il existe un unique couple \((d, n)\) d’endomorphismes de \(E\) tel que :
- \(u = d + n\) ;
- \(d\) est diagonalisable et \(n\) est nilpotent ;
- \(d \circ n = n \circ d\).
De plus, \(d\) et \(n\) sont des polynômes en \(u\).
Existence. Notons \(p_i\) le projecteur sur \(F_i\) parallèlement aux autres sous-espaces caractéristiques. D’après le lemme des noyaux, chaque \(p_i\) est un polynôme en \(u\). Posons \(d = \sum \lambda_i p_i\) et \(n = u – d\). Ainsi \(d\) vaut \(\lambda_i \,\mathrm{id}\) sur \(F_i\) : il est diagonalisable. Ensuite, \(n\) coïncide avec \(u – \lambda_i \,\mathrm{id}\) sur chaque \(F_i\), donc \(n^{m} = 0\) pour \(m = \max m_i\). Enfin, ces deux endomorphismes s’expriment polynomialement en \(u\), ce qui garantit leur commutation.
Unicité. Considérons un second couple \((d^{\prime}, n^{\prime})\) vérifiant les trois conditions. Comme \(d^{\prime}\) commute avec \(n^{\prime}\), il commute avec \(u\), donc avec tout polynôme en \(u\), en particulier avec \(d\) et \(n\). Or \(n^{\prime} – n\) est égal à \(d – d^{\prime}\). Le membre de gauche est diagonalisable, car \(d\) et \(d^{\prime}\) commutent et sont diagonalisables, donc codiagonalisables. Le membre de droite est nilpotent, par la formule du binôme. Un endomorphisme à la fois diagonalisable et nilpotent est nul, d’où \(d = d^{\prime}\) et \(n = n^{\prime}\).
3.2 Calcul pratique par Bézout
Pour calculer la décomposition de Dunford d’une matrice \(A\) :
- factoriser \(\chi_A\) (ou \(\mu_A\)) en facteurs \((X – \lambda_i)^{m_i}\) ;
- écrire une relation de Bézout entre ces facteurs, ce qui donne les projecteurs \(p_i\) comme polynômes en \(A\) ;
- poser \(D = \sum \lambda_i p_i\) et \(N = A – D\) ;
- contrôler que \(N\) est nilpotente et que \(DN = ND\).
Reprenons la matrice \(A\) de la partie 2, avec \(\chi_A = (X – 2)^2(X + 1)\). On cherche une relation de Bézout entre \((X – 2)^2\) et \(X + 1\). Le développement donne \((X – 2)^2 – (X + 1)(X – 5) = 9\). Par conséquent,
\[p_{-1} = \tfrac{1}{9}(A – 2I_3)^2, \qquad p_2 = I_3 – p_{-1}.\]
Le calcul fournit \(p_{-1} = \begin{pmatrix} 0 & 0 & 0 \\ -1 & 0 & 1 \\ -1 & 0 & 1 \end{pmatrix}\). Ensuite, \(D = 2p_2 – p_{-1} = 2I_3 – 3p_{-1}\), d’où
\[D = \begin{pmatrix} 2 & 0 & 0 \\ 3 & 2 & -3 \\ 3 & 0 & -1 \end{pmatrix}, \qquad N = A – D = \begin{pmatrix} 1 & 1 & -1 \\ 0 & 0 & 0 \\ 1 & 1 & -1 \end{pmatrix}.\]
On vérifie enfin que \(N^2 = 0\) et que \(DN = ND\). Ces deux contrôles sont indispensables.
3.3 Le piège du découpage triangulaire
Piège à éviter :
Une matrice triangulaire s’écrit toujours « diagonale plus strictement triangulaire ». Cependant, ce découpage n’est la décomposition de Dunford que si les deux morceaux commutent. Il faut donc vérifier la commutation avant de conclure.
Soit \(T = \begin{pmatrix} 1 & 5 \\ 0 & 3 \end{pmatrix}\). On a \(T = \Delta + U\) avec \(\Delta = \mathrm{diag}(1, 3)\) et \(U\) nilpotente. Pourtant \(\Delta U\) a pour coefficient \(5\) en haut à droite, alors que \(U\Delta\) a pour coefficient \(15\). En réalité, \(T\) a deux valeurs propres distinctes, donc elle est diagonalisable : sa décomposition de Dunford est \(D = T\) et \(N = 0\).
4. Endomorphismes nilpotents et noyaux itérés
La décomposition de Dunford ramène l’étude fine de \(u\) à celle de nilpotents. Nous étudions donc un nilpotent \(v\) pour lui-même. Toute l’information utile se lit sur la suite des noyaux \(\ker v^k\).
4.1 Indice de nilpotence
On dit que \(v\) est nilpotent lorsqu’une de ses puissances est l’endomorphisme nul. Dans ce cas, l’entier \(p = \min\{k \geq 1 : v^k = 0\}\) s’appelle l’indice de nilpotence de \(v\), et \(\mu_v = X^p\).
Soit \(v\) nilpotent d’indice \(p\). La suite \(d_k = \dim \ker v^k\) croît strictement de \(d_0 = 0\) à \(d_p = n\), puis elle reste constante. En particulier, \(p \leq n\).
Les inclusions \(\ker v^k \subset \ker v^{k+1}\) sont claires. Supposons que les noyaux d’ordre \(k\) et \(k + 1\) coïncident. Prenons \(x\) annulé par \(v^{k+2}\). Le vecteur \(v(x)\) est annulé par \(v^{k+1}\), donc aussi par \(v^k\), ce qui signifie \(v^{k+1}(x) = 0\). Ainsi, dès qu’un palier apparaît, la suite reste stationnaire. Or \(\ker v^p = E\) et \(\ker v^{p-1} \neq E\). Par conséquent, aucun palier n’existe avant le rang \(p\). Enfin, \(p\) sauts d’au moins 1 mènent de 0 à \(n\), donc \(p \leq n\).
4.2 Les sauts décroissent
Le résultat suivant est le cœur de la réduction de Jordan. Il affirme que les sauts de dimension ne peuvent jamais augmenter.
Posons \(\delta_k = d_k – d_{k-1}\) pour \(k \geq 1\). Alors \(\delta_1 \geq \delta_2 \geq \cdots \geq \delta_p \geq 1\).
Soit \(S\) un supplémentaire de \(\ker v^{k}\) dans \(\ker v^{k+1}\), donc \(\dim S = \delta_{k+1}\). L’application \(v\) envoie \(S\) dans \(\ker v^{k}\). De plus, \(v(S) \cap \ker v^{k-1} = \{0\}\) : en effet, si \(v(x) \in \ker v^{k-1}\) avec \(x \in S\), alors \(x \in \ker v^k \cap S = \{0\}\). Le même argument montre que \(v\) est injective sur \(S\). Ainsi \(v(S)\) est un sous-espace de dimension \(\delta_{k+1}\) dans \(\ker v^k\), en somme directe avec \(\ker v^{k-1}\). D’où \(\delta_{k+1} \leq \delta_k\).
Cette suite décroissante se dessine commodément. On empile \(\delta_1\) cases sur la première ligne, \(\delta_2\) cases sur la deuxième, et ainsi de suite, en alignant à gauche. On obtient un tableau de Young. Ses colonnes, lues de haut en bas, donneront les blocs de Jordan.
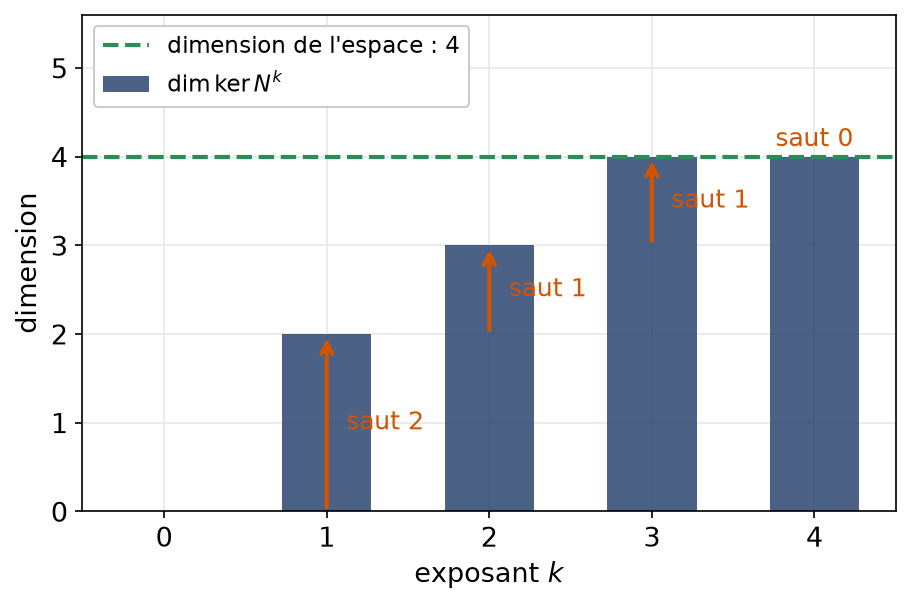
Considérons \(N = \begin{pmatrix} 0 & 1 & 0 & 0 \\ 0 & 0 & 1 & 0 \\ 0 & 0 & 0 & 0 \\ 0 & 1 & -1 & 0 \end{pmatrix}\). Pour \(x = (x_1, x_2, x_3, x_4)\), on trouve \(Nx = (x_2, x_3, 0, x_2 – x_3)\). Donc \(\ker N\) est défini par \(x_2 = x_3 = 0\) et \(d_1 = 2\). Ensuite, \(N^2\) n’a qu’une colonne non nulle, la troisième, égale à \((1, 0, 0, 1)\). Ainsi \(\ker N^2\) est l’hyperplan \(x_3 = 0\) et \(d_2 = 3\). Enfin, \(N^3 = 0\), d’où \(d_3 = 4\) et un indice égal à 3. Les sauts valent \(2, 1, 1\).
Le graphique ci-dessous résume cette suite de dimensions. On y voit la croissance stricte jusqu’à l’indice, puis le palier.
5. La réduction de Jordan
Nous notons \(J_q(\lambda)\) la matrice de taille \(q\) qui porte \(\lambda\) sur la diagonale, des 1 juste au-dessus et des 0 ailleurs. On l’appelle bloc de Jordan. En particulier, \(J_1(\lambda) = (\lambda)\) et \(J_q(0)\) est nilpotente d’indice \(q\).
5.1 Le cas nilpotent
Une chaîne est le moteur de la construction. Si \(v^{q-1}(x) \neq 0\) et \(v^q(x) = 0\), la famille \((v^{q-1}x, \ldots, vx, x)\) est libre. Dans cette famille, \(v\) envoie chaque vecteur sur le précédent et le premier sur 0. Sa matrice est donc exactement \(J_q(0)\).
Soit \(v\) nilpotent d’indice \(p\). On peut choisir une base de \(E\) où \(v\) est représenté par une juxtaposition diagonale de blocs \(J_{q}(0)\). Le nombre de blocs de taille au moins \(k\) vaut \(\delta_k = \dim \ker v^k – \dim \ker v^{k-1}\). Par conséquent, les tailles des blocs sont les hauteurs des colonnes du tableau de Young, et elles ne dépendent pas de la base choisie.
Nous construisons la base par couches, du haut vers le bas. D’abord, on choisit un supplémentaire \(S_p\) de \(\ker v^{p-1}\) dans \(\ker v^p = E\). Ensuite, le lemme de la partie 4 montre que \(v(S_p)\) est en somme directe avec \(\ker v^{p-2}\) dans \(\ker v^{p-1}\). On complète donc \(v(S_p)\) en un supplémentaire \(S_{p-1}\) de \(\ker v^{p-2}\) dans \(\ker v^{p-1}\). On recommence jusqu’à \(S_1\), supplémentaire de \(\{0\}\) dans \(\ker v\). À chaque étape, on ne garde comme nouveaux points de départ que les vecteurs ajoutés lors de la complétion. Chaque vecteur ajouté dans \(S_k\) engendre une chaîne de longueur \(k\). La réunion de toutes les chaînes est une base, car \(E = S_1 \oplus \cdots \oplus S_p\). Enfin, le nombre de chaînes de longueur au moins \(k\) est \(\dim S_k = \delta_k\).
5.2 Construire les chaînes sur un exemple
Revenons au nilpotent \(N\) de la partie 4. Ses sauts \(2, 1, 1\) donnent un tableau de Young à deux colonnes, de hauteurs 3 et 1.
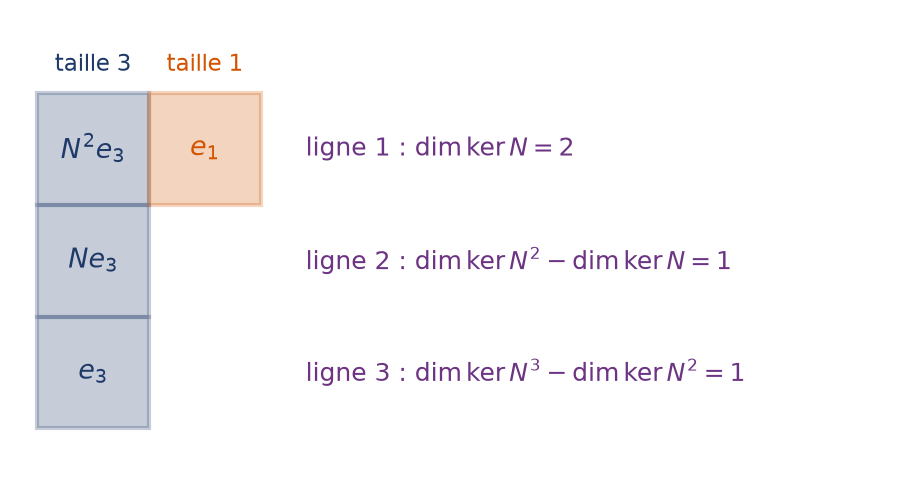
On part d’un vecteur hors de \(\ker N^2\), par exemple \(e_3\). Alors \(Ne_3 = (0, 1, 0, -1)\) et \(N^2 e_3 = (1, 0, 0, 1)\), puis \(N^3 e_3 = 0\). Ensuite, on complète \(N^2 e_3\) en une base de \(\ker N = \mathrm{Vect}(e_1, e_4)\) : le vecteur \(e_1\) convient. Dans la base \((N^2e_3, Ne_3, e_3, e_1)\), la matrice de \(N\) vaut donc \(J_3(0) \oplus J_1(0)\).
5.3 Le cas général
Supposons \(\chi_u\) scindé. Alors \(u\) admet une base adaptée où sa matrice juxtapose, le long de la diagonale, des blocs \(J_q(\lambda)\), avec \(\lambda\) valeur propre. Cette réduite de Jordan est unique à l’ordre des blocs près. Pour chaque \(\lambda\), le nombre de blocs \(J_q(\lambda)\) avec \(q \geq k\) vaut \(\dim \ker (u – \lambda\,\mathrm{id})^k – \dim \ker (u – \lambda\,\mathrm{id})^{k-1}\).
La preuve est directe. En effet, on applique le cas nilpotent à \(u – \lambda_i \,\mathrm{id}\) restreint à chaque sous-espace caractéristique \(F_i\). Ensuite, on recolle les bases obtenues.
Pour trouver la réduite de Jordan d’une matrice \(A\) et une base adaptée :
- factoriser \(\chi_A\) ;
- pour chaque valeur propre \(\lambda\), calculer les rangs de \((A – \lambda I)^k\) jusqu’à stabilisation, ce qui fixe les tailles des blocs ;
- pour chaque bloc de taille \(q\), choisir un vecteur de \(\ker(A – \lambda I)^q\) hors de \(\ker(A – \lambda I)^{q-1}\), sans dépendance avec les chaînes déjà construites ;
- écrire chaque chaîne de la fin vers le début dans la matrice de passage.
5.4 Une réduite de Jordan en dimension 4
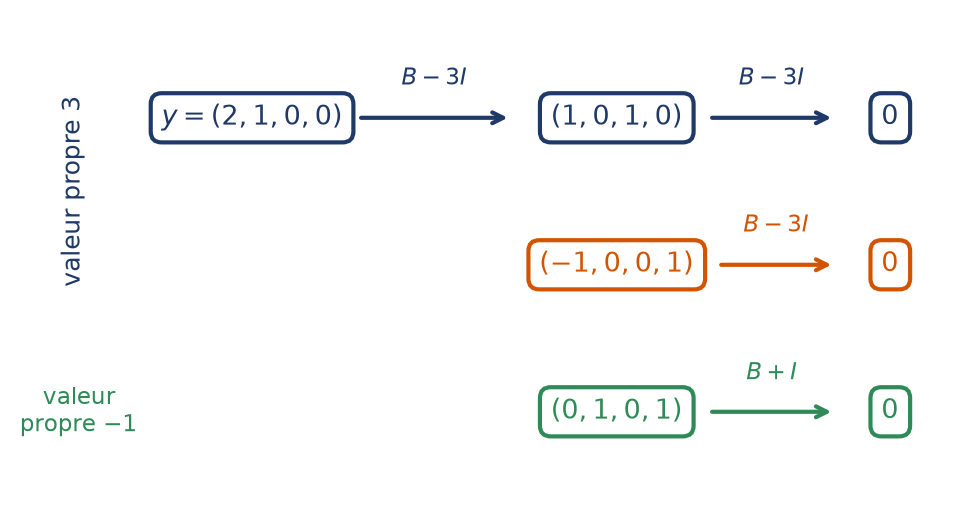
Soit \(B =\begin{pmatrix} 4 & -1 & -1 & 1 \\ 4 & -5 & -4 & 4 \\ 1 & -1 & 2 & 1 \\ 4 & -8 & -4 & 7 \end{pmatrix}\), dont le polynôme caractéristique est \((X – 3)^3(X + 1)\). La matrice \(B – 3I_4\) n’a que deux lignes distinctes, \((1, -1, -1, 1)\) et \((4, -8, -4, 4)\), qui sont indépendantes. Elle est donc de rang 2, et \(\dim \ker(B – 3I_4) = 2\). Ainsi la valeur propre 3 porte deux blocs, dont les tailles ont pour somme 3 : ce sont \(J_2(3)\) et \(J_1(3)\).
Pour la chaîne longue, on prend \(y = (2, 1, 0, 0)\), qui annule \((B – 3I_4)^2\) mais pas \(B – 3I_4\). On obtient \((B – 3I_4)y = (1, 0, 1, 0)\). Ensuite, \((-1, 0, 0, 1)\) complète \((1, 0, 1, 0)\) en une base de \(\ker(B – 3I_4)\). Enfin, \((0, 1, 0, 1)\) engendre \(\ker(B + I_4)\). Dans la base \(\big((1,0,1,0), y, (-1,0,0,1), (0,1,0,1)\big)\), la matrice devient \(J_2(3) \oplus J_1(3) \oplus J_1(-1)\).
Le schéma suivant montre les trois chaînes obtenues. Chaque flèche représente l’action de \(B – \lambda I_4\).
6. Similitude et invariants
Deux matrices sont semblables lorsqu’elles représentent le même endomorphisme dans deux bases. La réduite de Jordan fournit un représentant canonique de chaque classe. Nous en tirons un critère purement numérique.
6.1 Un critère par les rangs
Soient \(A\) et \(B\) dans \(\mathcal{M}_n(\mathbb{K})\), de polynômes caractéristiques scindés. Elles sont semblables si et seulement si elles ont les mêmes valeurs propres et si, pour chaque valeur propre \(\lambda\) et chaque \(k \in \{1, \ldots, n\}\), on a \(\mathrm{rg}(A – \lambda I_n)^k = \mathrm{rg}(B – \lambda I_n)^k\).
Si \(B = P^{-1}AP\), alors \((B – \lambda I_n)^k = P^{-1}(A – \lambda I_n)^k P\), donc les rangs coïncident. Réciproquement, les rangs donnent les dimensions des noyaux itérés, donc les sauts \(\delta_k\) pour chaque valeur propre. Par le théorème de Jordan, ces sauts déterminent la réduite. Ainsi \(A\) et \(B\) sont semblables à la même réduite, donc semblables entre elles.
Soient \(N_1 = J_2(0) \oplus J_2(0)\) et \(N_2 = J_2(0) \oplus J_1(0) \oplus J_1(0)\), de taille 4. Toutes deux vérifient \(\chi = X^4\) et \(\mu = X^2\). Pourtant \(\mathrm{rg}\, N_1 = 2\) et \(\mathrm{rg}\, N_2 = 1\). Par conséquent, elles ne sont pas semblables. Le couple formé du polynôme caractéristique et du polynôme minimal ne suffit donc pas à partir de la dimension 4.
Piège à éviter :
Trace, déterminant et polynôme caractéristique sont des invariants nécessaires, jamais suffisants. Ils servent à prouver qu’il n’y a pas similitude. En revanche, pour prouver une similitude, il faut comparer tous les rangs \(\mathrm{rg}(A – \lambda I_n)^k\), ou exhiber une matrice de passage.
6.2 Invariants de similitude
Lorsque \(\chi_u\) n’est pas scindé, la réduite de Jordan n’existe pas sur \(\mathbb{K}\). On utilise alors des matrices compagnons. Pour \(P = X^d + c_{d-1}X^{d-1} + \cdots + c_0\), la matrice compagnon \(C(P)\) porte des 1 sous la diagonale et la colonne \((-c_0, \ldots, -c_{d-1})\) à droite. Son polynôme caractéristique et son polynôme minimal valent \(P\).
On peut associer à \(u\) une liste \(P_1, \ldots, P_r\) de polynômes unitaires de degré au moins 1, chacun divisant le suivant, ainsi qu’une base où \(u\) a pour matrice \(C(P_1) \oplus \cdots \oplus C(P_r)\). Cette liste est déterminée par \(u\) seul : ce sont ses invariants de similitude. On a \(P_r = \mu_u\) et \(P_1 \cdots P_r = \chi_u\). Deux matrices sont semblables si et seulement si elles ont les mêmes invariants. Nous admettons ce théorème, dit de Frobenius.
Quand \(\chi_u\) est scindé, on passe de Jordan aux invariants ainsi. Pour chaque valeur propre, on range les tailles de blocs par ordre décroissant. Ensuite, \(P_r\) est le produit des \((X – \lambda)^{q}\) pour les plus grands blocs, \(P_{r-1}\) le produit pour les blocs suivants, et ainsi de suite. Par exemple, la réduite \(J_3(0) \oplus J_1(0) \oplus J_2(5)\) a pour invariants \(P_1 = X\) et \(P_2 = X^3(X – 5)^2\).
Remarque :
Les invariants de similitude se calculent par des opérations dans \(\mathbb{K}[X]\), sans agrandir le corps. Par conséquent, deux matrices réelles semblables sur \(\mathbb{C}\) sont déjà semblables sur \(\mathbb{R}\).
7. Dualité : base duale, orthogonal et transposée
La dualité termine le chapitre. Elle fournit un langage commode pour les coordonnées et elle explique un fait surprenant : toute matrice est semblable à sa transposée.
7.1 Base duale
On note \(E^*\) l’espace \(\mathcal{L}(E, \mathbb{K})\), appelé dual de \(E\) ; ses éléments sont les formes linéaires. Partons d’une base \((e_1, \ldots, e_n)\). Pour chaque indice \(i\), la forme \(e_i^*\) lit la \(i\)-ème coordonnée : elle vaut 1 en \(e_i\) et 0 en chaque autre \(e_j\). La famille \((e_1^*, \ldots, e_n^*)\) engendre \(E^*\) et elle est libre ; on la nomme base duale. Ainsi \(x = \sum e_i^*(x)\, e_i\).
En pratique, on range les vecteurs \(v_j\) en colonnes dans une matrice \(P\). Alors les formes \(v_i^*\) sont données par les lignes de \(P^{-1}\), puisque \(P^{-1}P = I_n\).
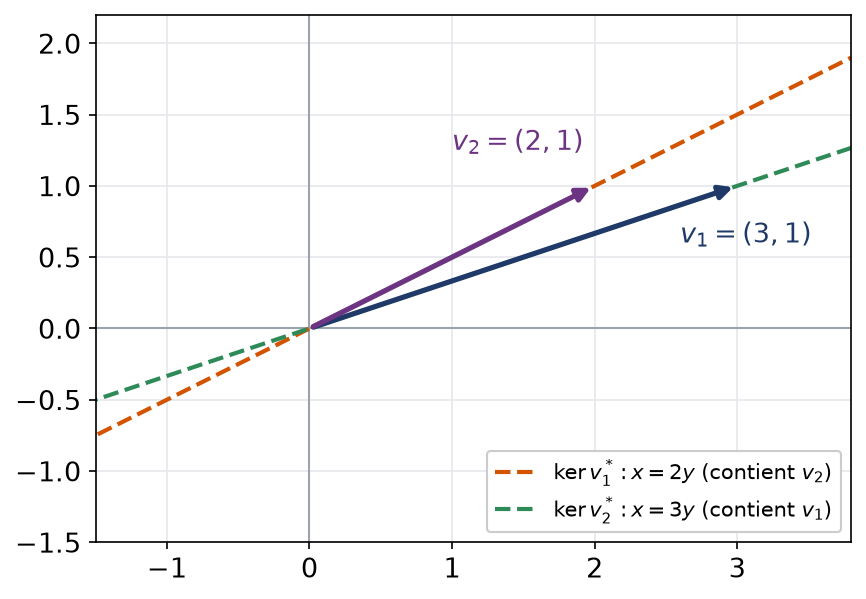
Dans \(\mathbb{R}^2\), prenons \(v_1 = (3, 1)\) et \(v_2 = (2, 1)\). La matrice des deux vecteurs est \(\begin{pmatrix} 3 & 2 \\ 1 & 1 \end{pmatrix}\), de déterminant 1, et son inverse vaut \(\begin{pmatrix} 1 & -2 \\ -1 & 3 \end{pmatrix}\). Donc \(v_1^*(x, y) = x – 2y\) et \(v_2^*(x, y) = -x + 3y\). On vérifie : \(v_1^*(v_2) = 2 – 2 = 0\) et \(v_2^*(v_1) = -3 + 3 = 0\). Ainsi le noyau de \(v_1^*\) est la droite portée par \(v_2\), et réciproquement.
La figure montre ce fait géométrique. Chaque forme de la base duale s’annule sur la droite engendrée par l’autre vecteur.
Dans \(\mathbb{R}^3\), la méthode est identique. Par exemple, pour \(v_1 = (1, 1, 0)\), \(v_2 = (0, 1, 2)\) et \(v_3 = (1, 1, 1)\), les lignes de \(P^{-1}\) donnent \(v_1^* = -x + 2y – z\), \(v_2^* = -x + y\) et \(v_3^* = 2x – 2y + z\).
7.2 Orthogonal d’une partie
L’orthogonal d’un sous-espace \(F\) de \(E\) est \(F^{\circ} = \{\varphi \in E^* : \varphi(x) = 0 \text{ pour tout } x \in F\}\). C’est un sous-espace de \(E^*\).
On a \(\dim F^{\circ} = n – \dim F\).
Prenons une base \((e_1, \ldots, e_m)\) de \(F\), prolongée en une base \((e_1, \ldots, e_n)\) de \(E\). Décomposons \(\varphi = \sum c_i e_i^*\). Comme \(c_i = \varphi(e_i)\), la forme \(\varphi\) est nulle sur \(F\) exactement lorsque \(c_1 = \cdots = c_m = 0\). Ainsi \(F^{\circ} = \mathrm{Vect}(e_{m+1}^*, \ldots, e_n^*)\), de dimension \(n – m\).
7.3 Transposée d’un endomorphisme
La transposée de \(u\) est l’endomorphisme \({}^t u\) de \(E^*\) défini par \({}^t u(\varphi) = \varphi \circ u\).
Si \(A\) est la matrice de \(u\) dans une base \(\mathcal{B}\), la matrice de \({}^t u\) dans la base duale \(\mathcal{B}^*\) est \(A^{T}\). De plus, \(\ker {}^t u = (\mathrm{Im}\, u)^{\circ}\), et \(u\) a le même rang que sa transposée.
Le coefficient \((i, j)\) de la matrice de \({}^t u\) vaut \({}^t u(e_j^*)(e_i) = e_j^*(u(e_i)) = a_{ji}\). C’est bien le coefficient de \(A^T\). Ensuite, \(\varphi \circ u = 0\) signifie exactement que \(\varphi\) s’annule sur \(\mathrm{Im}\, u\). Enfin, la proposition précédente donne \(\dim \ker {}^t u = n – \mathrm{rg}\, u\), puis le théorème du rang conclut.
Toute matrice \(A \in \mathcal{M}_n(\mathbb{C})\) est semblable à sa transposée.
Pour tout \(\lambda\) et tout \(k\), on a \((A^T – \lambda I_n)^k = \big((A – \lambda I_n)^k\big)^T\). Or une matrice et sa transposée ont le même rang. Le critère de la partie 6 s’applique donc directement.
Les erreurs fréquentes
- Prendre « diagonale plus strictement triangulaire » pour la décomposition de Dunford sans vérifier que les deux morceaux commutent.
- Confondre sous-espace propre et sous-espace caractéristique : le second est en général plus grand.
- Croire que \(\chi\) et \(\mu\) suffisent à décider de la similitude en dimension 4 ou plus.
- Démarrer une chaîne de Jordan avec un vecteur pris au hasard dans le noyau, au lieu d’un vecteur hors du noyau précédent.
- Lire la base duale sur les colonnes de \(P^{-1}\) au lieu de ses lignes.
Fiche mémo
- \(P(u) = 0\) si et seulement si \(\mu_u\) divise \(P\) ; les racines de \(\mu_u\) sont les valeurs propres.
- Lemme des noyaux : si \(P = P_1 \cdots P_r\) avec des \(P_i\) premiers entre eux deux à deux, \(\ker P(u)\) est la somme directe des \(\ker P_i(u)\).
- Sous-espace caractéristique : \(F_\lambda = \ker(u – \lambda\,\mathrm{id})^{m}\), de dimension la multiplicité \(m\) de \(\lambda\) dans \(\chi_u\).
- Dunford : \(u = d + n\), \(d\) diagonalisable, \(n\) nilpotent, \(dn = nd\), avec \(d = \sum \lambda_i p_i\).
- Nilpotent d’indice \(p\) : \(\mu = X^p\) et \(p \leq n\) ; les sauts \(\delta_k\) des noyaux itérés décroissent.
- Nombre de blocs de taille au moins \(k\) : \(\delta_k = \dim \ker v^k – \dim \ker v^{k-1}\).
- Similitude : mêmes valeurs propres et mêmes rangs de \((A – \lambda I)^k\) ; à défaut de scindage, mêmes invariants de similitude.
- Base duale : lignes de \(P^{-1}\) ; \(\dim F^{\circ} = n – \dim F\) ; \(\ker {}^t u = (\mathrm{Im}\, u)^{\circ}\).
- Toute matrice complexe est semblable à sa transposée.
Questions fréquentes
Faut-il connaître la réduite de Jordan pour calculer une décomposition de Dunford ?
Non. Les projecteurs sur les sous-espaces caractéristiques s’obtiennent par une relation de Bézout, sans chercher aucune base. On écrit alors la partie diagonalisable comme combinaison de ces projecteurs. La réduite de Jordan donne la même décomposition, mais elle demande plus de calculs.
Une matrice triangulaire s'écrit diagonale plus nilpotente : est-ce sa décomposition de Dunford ?
Pas en général. Les deux morceaux doivent commuter, et la diagonale ne commute avec la partie strictement triangulaire que dans des cas particuliers. Lorsque toutes les valeurs propres sont égales, en revanche, la diagonale est une homothétie et le découpage convient.
Le polynôme caractéristique et le polynôme minimal suffisent-ils à décider de la similitude ?
Oui jusqu’à la dimension 3, mais plus à partir de la dimension 4. Deux nilpotents de taille 4 dont les blocs ont pour tailles 2, 2 et 2, 1, 1 ont le même polynôme caractéristique et le même polynôme minimal. Pourtant leurs noyaux ont des dimensions différentes, donc ils ne sont pas semblables.
Que se passe-t-il si le polynôme caractéristique n'est pas scindé ?
La réduite de Jordan n’existe plus sur le corps de départ. Vous pouvez alors travailler dans un corps plus grand où il est scindé, par exemple les complexes pour une matrice réelle. Les invariants de similitude, eux, restent définis sur le corps de départ et décident de la similitude dans tous les cas.
Pour aller plus loin
- S’exercer : exercices corrigés de L3 de maths sur dunford et Jordan
- Chapitre d’avant : Extensions algébriques et corps finis
- Chapitre d’après : Différentielle de Fréchet et formules de Taylor
- Vérifier ses acquis : QCM de L3 de maths sur dunford et Jordan
- Contrôle corrigé en temps limité : Réduites de Jordan et similitude : contrôle de maths en L3
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «dunford et Jordan en L3 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.