Couples et loi des grands nombres en L2 de maths : cours et méthodes
Ce chapitre réunit tout ce qu’il faut pour étudier plusieurs variables aléatoires à la fois. Nous partons de la loi conjointe d’un couple, nous en tirons les lois marginales et conditionnelles, puis nous mesurons le lien entre deux variables par la covariance. Ensuite, la fonction génératrice donne un outil très efficace pour obtenir la loi d’une somme.
Le point d’arrivée est la loi des grands nombres L2 au programme, sous sa forme faible : la moyenne de nombreuses observations indépendantes se rapproche de l’espérance. Nous la démontrons pas à pas avec l’inégalité de Bienaymé-Tchebychev. Ce chapitre prolonge celui sur les lois discrètes et l’espérance. Il prépare aussi les lois à densité, les statistiques du semestre suivant et, plus tard, le théorème central limite.
Ce que vous saurez faire
- Écrire la loi conjointe d’un couple de variables discrètes sous forme de tableau ou de formule.
- Calculer des lois marginales et des lois conditionnelles à partir de la loi conjointe.
- Prouver ou réfuter l’indépendance de deux variables aléatoires.
- Calculer une covariance, un coefficient de corrélation et la variance d’une somme.
- Utiliser une fonction génératrice pour trouver la loi d’une somme, son espérance et sa variance.
- Appliquer la loi faible des grands nombres pour choisir une taille d’échantillon.
1. Couples de variables et loi conjointe
Dans tout le chapitre, on travaille sur un espace probabilisé \((\Omega, \mathcal{A}, P)\). Les variables aléatoires sont discrètes : elles prennent un nombre fini ou dénombrable de valeurs. Jusqu’ici, nous avons étudié une variable à la fois. Cependant, beaucoup de questions concernent deux grandeurs observées ensemble, comme la taille et le poids d’une même personne. C’est pourquoi on introduit le couple.
Soient \(X\) et \(Y\) deux variables aléatoires discrètes à valeurs dans \(E\) et \(F\). Le couple \(Z = (X, Y)\) est la variable à valeurs dans \(E \times F\) définie par \(Z(\omega) = (X(\omega), Y(\omega))\). Sa loi conjointe est la donnée des nombres
\[ p_{x,y} = P(X = x, Y = y), \qquad (x, y) \in X(\Omega) \times Y(\Omega). \]
Ces nombres sont positifs et leur somme vaut 1.
Autrement dit, la loi conjointe dit avec quelle probabilité chaque paire de valeurs apparaît. Ainsi, quand les valeurs sont en nombre fini, on la range dans un tableau à double entrée. Les lignes portent les valeurs de l’une des variables, les colonnes celles de l’autre.
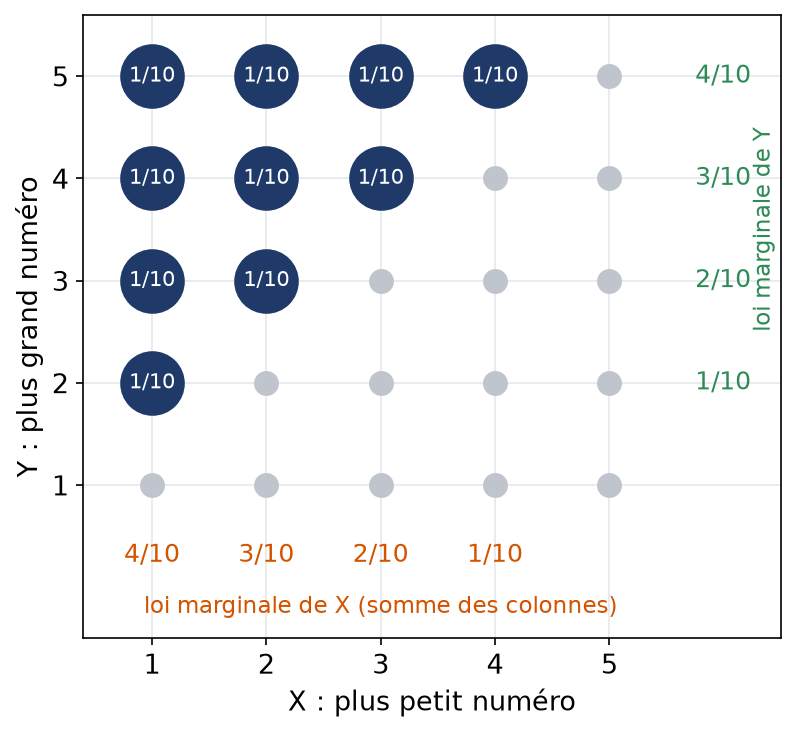
Une boîte contient cinq jetons numérotés de 1 à 5. On en tire deux simultanément. On note \(X\) le plus petit numéro et \(Y\) le plus grand. D’abord, les tirages équiprobables sont les \(\binom{5}{2} = 10\) paires. Ensuite, chaque paire \(\{i, j\}\) avec \(i < j\) donne exactement \(X = i\) et \(Y = j\). Par conséquent :
\[ P(X = i, Y = j) = \begin{cases} \dfrac{1}{10} & \text{si } 1 \leq i < j \leq 5, \\ 0 & \text{sinon.} \end{cases} \]
On vérifie enfin que les dix cases non nulles totalisent bien 1.
La figure suivante représente cette loi conjointe. Chaque gros disque porte une probabilité de 1/10, et les marges indiquent déjà les lois de \(X\) et de \(Y\).
1.1 Lois marginales
Le couple contient toute l’information. En particulier, il permet de retrouver la loi de chaque composante. On appelle ces lois les lois marginales, car on les écrit souvent dans la marge du tableau.
Pour tout \(x \in X(\Omega)\) et tout \(y \in Y(\Omega)\) :
\[ P(X = x) = \sum_{y \in Y(\Omega)} P(X = x, Y = y), \qquad P(Y = y) = \sum_{x \in X(\Omega)} P(X = x, Y = y). \]
Les événements \((Y = y)\), pour \(y\) parcourant \(Y(\Omega)\), sont deux à deux incompatibles et leur réunion est \(\Omega\). Ils forment donc un système complet d’événements. Ensuite, la formule des probabilités totales donne \(P(X = x) = \sum_y P\big((X = x) \cap (Y = y)\big)\). La somme converge, car c’est une série à termes positifs majorée par 1. Enfin, la seconde formule s’obtient en échangeant les rôles.
Pour calculer des lois marginales :
- Écrire la loi conjointe dans un tableau, ou sous forme d’une formule en \((i, j)\).
- Pour la loi de \(X\), sommer sur toutes les valeurs de \(Y\) à \(X\) fixé ; dans un tableau, c’est la somme d’une colonne.
- Dans le cas d’une formule, repérer les bornes de la somme : la condition \(i < j\) limite souvent l’indice.
- Contrôler que chaque loi marginale totalise 1.
Reprenons les jetons. À \(i\) fixé, l’indice \(j\) varie de \(i + 1\) à 5, soit \(5 – i\) valeurs. Donc \(P(X = i) = (5 – i)/10\) pour \(1 \leq i \leq 4\). De même, à \(j\) fixé, il y a \(j – 1\) valeurs de \(i\). Par conséquent, \(P(Y = j) = (j – 1)/10\) pour \(2 \leq j \leq 5\).
Piège à éviter :
Les lois marginales ne suffisent pas à reconstituer la loi conjointe. En effet, deux couples très différents peuvent avoir les mêmes marges. Le contre-exemple ci-dessous le montre.
Soit \(U\) une variable de Bernoulli de paramètre \(1/2\). Le couple \((U, U)\) et le couple \((U, 1 – U)\) ont les mêmes lois marginales : toutes sont de Bernoulli de paramètre \(1/2\). Pourtant, \(P(U = 1, U = 1) = 1/2\) alors que \(P(U = 1, 1 – U = 1) = 0\). Les deux lois conjointes diffèrent donc.
1.2 Lois conditionnelles
On veut parfois connaître la loi de \(Y\) quand la valeur de \(X\) est déjà connue. Par exemple, on peut se demander quel est le plus grand jeton sachant que le plus petit vaut 2.
On fixe une valeur \(x\) de probabilité \(P(X = x)\) non nulle. On appelle loi conditionnelle de \(Y\) sachant \((X = x)\) la famille des nombres
\[ P_{(X = x)}(Y = y) = \frac{P(X = x, Y = y)}{P(X = x)}, \qquad y \in Y(\Omega). \]
Pour \(x\) fixé, ces nombres sont positifs et leur somme vaut 1. Il s’agit donc bien d’une loi de probabilité. De plus, la formule se retourne : \(P(X = x, Y = y) = P(X = x) \, P_{(X = x)}(Y = y)\). Cette écriture sert beaucoup dans les expériences en deux temps.
Avec les jetons, on a \(P(X = 2) = 3/10\). Ainsi, pour \(j \in \{3, 4, 5\}\) :
\[ P_{(X = 2)}(Y = j) = \frac{1/10}{3/10} = \frac{1}{3}. \]
Sachant que le plus petit numéro est 2, le plus grand est donc uniforme sur \(\{3, 4, 5\}\). C’est intuitif : l’autre jeton est l’un des trois numéros supérieurs à 2, tous également probables.
2. Indépendance de variables aléatoires
Deux variables sont indépendantes quand la connaissance de l’une ne modifie pas la loi de l’autre. Concrètement, toutes les lois conditionnelles de \(Y\) sachant \((X = x)\) coïncident alors avec la loi de \(Y\). La définition suivante traduit cette idée sans division.
Les variables \(X\) et \(Y\) sont indépendantes si, pour tout \(x \in X(\Omega)\) et tout \(y \in Y(\Omega)\) :
\[ P(X = x, Y = y) = P(X = x) \, P(Y = y). \]
Plus généralement, \(X_1, \dots, X_n\) sont mutuellement indépendantes si \(P(X_1 = x_1, \dots, X_n = x_n) = \prod_{k=1}^{n} P(X_k = x_k)\) pour toutes les valeurs \(x_1, \dots, x_n\).
Dans un tableau, l’indépendance signifie que chaque case est le produit de sa marge de ligne et de sa marge de colonne. Par conséquent, une seule case nulle suffit souvent à conclure, dès que les deux marges correspondantes sont non nulles.
Les jetons donnent-ils des variables indépendantes ? Regardons la case \((4, 2)\). D’une part, \(P(X = 4, Y = 2) = 0\), car le plus petit numéro ne dépasse jamais le plus grand. D’autre part, \(P(X = 4) \, P(Y = 2) = \frac{1}{10} \times \frac{1}{10} = \frac{1}{100}\). Les deux nombres diffèrent. Donc \(X\) et \(Y\) ne sont pas indépendantes.
2.1 Fonctions de variables indépendantes
L’indépendance se transmet aux transformations. Ainsi, si le résultat d’un dé ne dépend pas d’un autre, son carré n’en dépend pas non plus.
Si \(X\) et \(Y\) sont indépendantes, alors pour toutes fonctions \(f\) et \(g\), les variables \(f(X)\) et \(g(Y)\) sont indépendantes. Plus généralement, des fonctions de paquets disjoints de variables mutuellement indépendantes restent indépendantes (lemme des coalitions).
Fixons \(a\) et \(b\). L’événement \((f(X) = a)\) est la réunion disjointe des \((X = x)\) pour \(x\) dans \(f^{-1}(\{a\})\). De même pour \((g(Y) = b)\). En sommant la relation d’indépendance sur ces deux ensembles d’indices, on obtient
\[ P(f(X) = a, g(Y) = b) = \sum_{f(x) = a} \sum_{g(y) = b} P(X = x) P(Y = y) = P(f(X) = a) \, P(g(Y) = b). \]
Le lemme des coalitions se démontre de la même façon, en regroupant les variables par paquets.
2.2 Espérance d’une fonction du couple
Pour calculer l’espérance de \(XY\), de \(X + Y\) ou de \(\max(X, Y)\), on n’a pas besoin de la loi de la nouvelle variable. En effet, le théorème de transfert s’étend aux couples.
Transfert pour un couple. Soit \(g\) une fonction réelle définie sur \(X(\Omega) \times Y(\Omega)\). La variable \(g(X, Y)\) possède une espérance exactement lorsque la famille \(\big(g(x, y) \, P(X = x, Y = y)\big)\) est sommable ; on a alors
\[ E\big(g(X, Y)\big) = \sum_{(x, y)} g(x, y) \, P(X = x, Y = y). \]
On en déduit un résultat central pour la suite. Si \(X\) et \(Y\) sont indépendantes et admettent une espérance, alors \(XY\) admet une espérance et \(E(XY) = E(X) \, E(Y)\). En effet, la famille \(xy \, P(X = x) P(Y = y)\) est un produit de deux familles sommables. Elle est donc sommable, et sa somme se factorise.
Piège à éviter :
L’égalité \(E(XY) = E(X) E(Y)\) n’est pas automatique. Par exemple, pour les jetons, nous verrons plus bas que \(E(XY) = 8{,}5\) alors que \(E(X) E(Y) = 8\). On vérifie donc toujours l’indépendance avant de factoriser une espérance.
3. Covariance et variance d’une somme
L’indépendance est une propriété tout ou rien. Cependant, on souhaite aussi mesurer à quel point deux variables varient ensemble. La covariance répond à ce besoin. Dans cette partie, toutes les variables admettent un moment d’ordre 2.
La covariance de \(X\) et \(Y\) est
\[ \operatorname{Cov}(X, Y) = E\Big( \big(X – E(X)\big) \big(Y – E(Y)\big) \Big). \]
Si \(V(X) > 0\) et \(V(Y) > 0\), le coefficient de corrélation est \(\rho(X, Y) = \dfrac{\operatorname{Cov}(X, Y)}{\sigma(X) \, \sigma(Y)}\).
La covariance existe bien. En effet, l’inégalité \(|ab| \leq \frac{1}{2}(a^2 + b^2)\) montre que le produit de deux variables ayant un moment d’ordre 2 admet une espérance.
- Formule de König-Huygens : \(\operatorname{Cov}(X, Y) = E(XY) – E(X) E(Y)\).
- La covariance est symétrique et bilinéaire, et \(\operatorname{Cov}(X, X) = V(X)\).
- Pour toute constante \(c\), \(\operatorname{Cov}(X, c) = 0\) ; ainsi, translater une variable ne change pas la covariance.
- Si \(X\) et \(Y\) sont indépendantes, alors \(\operatorname{Cov}(X, Y) = 0\).
- Inégalité de Cauchy-Schwarz : \(|\operatorname{Cov}(X, Y)| \leq \sigma(X) \sigma(Y)\), donc \(\rho(X, Y) \in [-1, 1]\).
Le point 1 vient du développement de \((X – E(X))(Y – E(Y))\) et de la linéarité de l’espérance. Les points 2 et 3 en découlent directement. Le point 4 résulte de \(E(XY) = E(X) E(Y)\). Pour le point 5, posons \(\tilde{X} = X – E(X)\) et \(\tilde{Y} = Y – E(Y)\). Pour tout réel \(\lambda\), on a \(E\big((\tilde{X} + \lambda \tilde{Y})^2\big) \geq 0\), c’est-à-dire
\[ V(Y) \lambda^2 + 2 \operatorname{Cov}(X, Y) \lambda + V(X) \geq 0. \]
Supposons d’abord \(V(Y) > 0\). Ce polynôme du second degré en \(\lambda\) ne prend aucune valeur strictement négative. Il a donc au plus une racine réelle, et son discriminant réduit \(\operatorname{Cov}(X, Y)^2 – V(X) V(Y)\) est négatif ou nul. Dans le cas où \(V(Y) = 0\), au contraire, \(\tilde{Y}\) est nulle presque sûrement et la covariance vaut 0.
La réciproque du point 4 est fausse. Prenons \(X\) uniforme sur \(\{-2, -1, 1, 2\}\) et \(Y = |X|\). D’abord, \(E(X) = 0\) par symétrie. Ensuite, \(XY = X|X|\) prend les valeurs \(-4, -1, 1, 4\) avec probabilité \(1/4\) chacune, donc \(E(XY) = 0\). Ainsi \(\operatorname{Cov}(X, Y) = 0\). Pourtant, \(P(X = 1, Y = 2) = 0\) alors que \(P(X = 1) P(Y = 2) = \frac{1}{4} \times \frac{1}{2} = \frac{1}{8}\). Les variables sont donc dépendantes ; en fait, \(Y\) est même une fonction de \(X\).
3.1 Variance d’une somme
La covariance apparaît dès qu’on calcule la variance d’une somme. C’est d’ailleurs sa principale utilité pratique.
Pour deux variables admettant un moment d’ordre 2 :
\[ V(X + Y) = V(X) + V(Y) + 2 \operatorname{Cov}(X, Y). \]
Plus généralement, pour \(X_1, \dots, X_n\) :
\[ V\Big( \sum_{k=1}^{n} X_k \Big) = \sum_{k=1}^{n} V(X_k) + 2 \sum_{1 \leq i < j \leq n} \operatorname{Cov}(X_i, X_j). \]
Ainsi, pour des \(X_k\) deux à deux indépendantes, toutes les covariances disparaissent : il reste \(V(X_1 + \dots + X_n) = V(X_1) + \dots + V(X_n)\).
On écrit \(V(S) = \operatorname{Cov}(S, S)\) avec \(S = \sum_k X_k\). Ensuite, la bilinéarité développe cette covariance en \(\sum_{i, j} \operatorname{Cov}(X_i, X_j)\). Les termes diagonaux donnent les variances. Enfin, les termes \(i \neq j\) se regroupent par paires grâce à la symétrie, d’où le facteur 2.
Pour calculer une covariance :
- Calculer \(E(X)\) et \(E(Y)\) à l’aide des lois marginales.
- Calculer \(E(XY)\) par le théorème de transfert, en sommant \(xy \, P(X = x, Y = y)\) sur les cases non nulles.
- Conclure par König-Huygens : \(\operatorname{Cov}(X, Y) = E(XY) – E(X) E(Y)\).
- Si la variable étudiée est une somme d’indicatrices, utiliser plutôt \(\operatorname{Cov}(\mathbf{1}_A, \mathbf{1}_B) = P(A \cap B) – P(A) P(B)\).
Calculons la covariance des jetons. D’abord, avec les lois marginales :
\[ E(X) = \frac{1 \cdot 4 + 2 \cdot 3 + 3 \cdot 2 + 4 \cdot 1}{10} = 2, \qquad E(Y) = \frac{2 \cdot 1 + 3 \cdot 2 + 4 \cdot 3 + 5 \cdot 4}{10} = 4. \]
Ensuite, \(E(XY)\) est la moyenne des produits \(ij\) sur les dix paires. Or \(\sum_{i < j} ij = \frac{1}{2}\big( 15^2 – 55 \big) = 85\), car \(1 + \dots + 5 = 15\) et \(1^2 + \dots + 5^2 = 55\). Donc \(E(XY) = 8{,}5\) et \(\operatorname{Cov}(X, Y) = 8{,}5 – 8 = 0{,}5\).
De la même façon, \(E(X^2) = 5\) et \(E(Y^2) = 17\), donc \(V(X) = V(Y) = 1\). Par conséquent, \(\rho(X, Y) = 0{,}5\) et \(V(X + Y) = 1 + 1 + 2 \times 0{,}5 = 3\). La covariance positive traduit un fait simple : quand le plus petit numéro est grand, le plus grand l’est aussi.
Remarque :
Pour une différence, le signe change devant la covariance mais pas devant les variances : \(V(X – Y) = V(X) + V(Y) – 2 \operatorname{Cov}(X, Y)\). Avec les jetons, on trouve ainsi \(V(Y – X) = 1\). Autrement dit, l’écart entre les deux numéros fluctue beaucoup moins que leur somme.
4. Fonction génératrice et loi d’une somme
Connaître l’espérance et la variance d’une somme ne suffit pas toujours. On veut parfois sa loi complète. Dans cette partie, les variables sont à valeurs dans \(\mathbb{N}\).
4.1 Loi d’une somme par convolution
On suppose \(X\) et \(Y\) indépendantes, toutes deux à valeurs entières positives. Pour chaque entier \(n \geq 0\), on a alors
\[ P(X + Y = n) = \sum_{k=0}^{n} P(X = k) \, P(Y = n – k). \]
En effet, l’événement \((X + Y = n)\) est la réunion disjointe des \((X = k, Y = n – k)\) pour \(0 \leq k \leq n\). Il reste alors à appliquer l’indépendance à chaque terme.
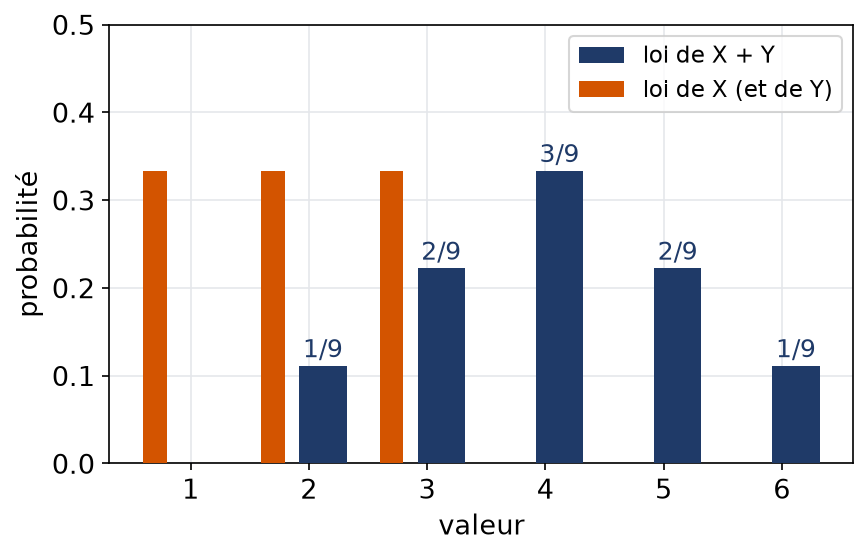
Soient \(X\) et \(Y\) indépendantes et uniformes sur \(\{1, 2, 3\}\). La somme varie de 2 à 6. Par exemple, \(P(X + Y = 4)\) compte les couples \((1, 3)\), \((2, 2)\) et \((3, 1)\), soit \(3/9\). De même, on obtient les probabilités \(1/9\), \(2/9\), \(3/9\), \(2/9\), \(1/9\) pour les valeurs 2 à 6. La loi de la somme est donc triangulaire, et non plus uniforme.
La figure compare la loi d’une variable à la loi de la somme. On voit que l’addition « lisse » les valeurs extrêmes, qui deviennent rares.
4.2 Fonction génératrice
La convolution devient lourde quand on additionne beaucoup de variables. C’est pourquoi on code la loi par une série entière : le produit de deux séries réalise alors exactement la convolution.
Soit \(X\) à valeurs dans \(\mathbb{N}\). Sa fonction génératrice est
\[ G_X(t) = E\big(t^X\big) = \sum_{n=0}^{+\infty} P(X = n) \, t^n. \]
Comme \(\sum P(X = n) = 1\), cette série entière a un rayon de convergence au moins égal à 1, et elle converge normalement sur \([-1, 1]\). De plus, \(G_X(1) = 1\).
- Bernoulli \(\mathcal{B}(p)\) : \(G(t) = 1 – p + pt\), et binomiale \(\mathcal{B}(n, p)\) : \(G(t) = (1 – p + pt)^n\).
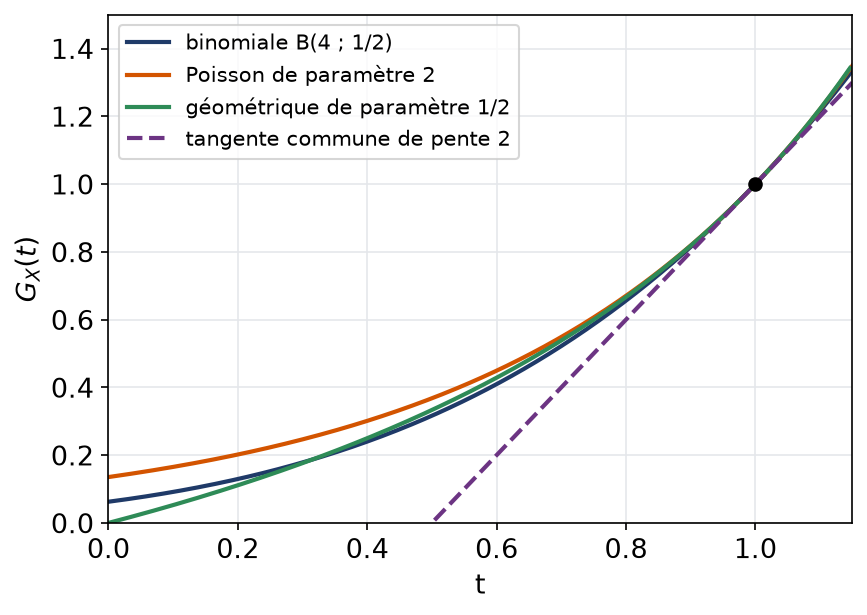
- Poisson \(\mathcal{P}(\lambda)\) : \(G(t) = e^{\lambda(t – 1)}\), pour tout réel \(t\).
- Géométrique \(\mathcal{G}(p)\) sur \(\mathbb{N}^*\), avec \(q = 1 – p\) : \(G(t) = \dfrac{pt}{1 – qt}\) pour \(|t| < 1/q\).
- La fonction génératrice caractérise la loi : \(P(X = n) = \dfrac{G_X^{(n)}(0)}{n!}\). Deux variables de même fonction génératrice ont donc la même loi.
- Moments : si le rayon de convergence est strictement supérieur à 1, alors \(X\) admet des moments de tout ordre, \(E(X) = G_X^{\prime}(1)\) et \(V(X) = G_X^{\prime\prime}(1) + G_X^{\prime}(1) – G_X^{\prime}(1)^2\).
- Somme : si \(X\) et \(Y\) sont indépendantes, alors \(G_{X+Y} = G_X \, G_Y\) sur \([-1, 1]\).
Le point 1 est l’unicité des coefficients d’une série entière. Pour le point 2, on dérive terme à terme à l’intérieur du disque de convergence, qui contient alors 1 : \(G_X^{\prime}(1) = \sum n P(X = n) = E(X)\) et \(G_X^{\prime\prime}(1) = E\big(X(X – 1)\big)\). La formule de König-Huygens donne ensuite la variance. Pour le point 3, fixons \(t \in [-1, 1]\). Les variables \(t^X\) et \(t^Y\) sont indépendantes, comme fonctions de variables indépendantes, et bornées. Par conséquent, \(E(t^{X+Y}) = E(t^X) \, E(t^Y)\).
Remarque :
Le point 2 reste vrai quand le rayon vaut exactement 1, avec des dérivées à gauche en 1 : l’existence de \(E(X)\) équivaut alors à la dérivabilité à gauche de \(G_X\) au point 1. Cette version plus fine est hors programme ici.
La figure montre trois fonctions génératrices de lois différentes ayant toutes une espérance égale à 2. Elles passent toutes par le point \((1, 1)\) avec la même pente 2, ce qui illustre la formule \(E(X) = G_X^{\prime}(1)\).
Pour trouver la loi d’une somme de variables indépendantes :
- Écrire la fonction génératrice de chaque terme.
- Faire le produit, en citant l’indépendance.
- Reconnaître une fonction génératrice connue, ou développer le produit en série entière autour de 0.
- Lire la loi sur les coefficients : le coefficient de \(t^n\) vaut \(P(X + Y = n)\).
Soient \(X\) et \(Y\) indépendantes de loi géométrique \(\mathcal{G}(p)\), avec \(q = 1 – p\). Pour \(|t| < 1/q\), on a d’abord \(G_{X+Y}(t) = \dfrac{p^2 t^2}{(1 – qt)^2}\). Ensuite, le développement \(\dfrac{1}{(1 – u)^2} = \sum_{m \geq 0} (m + 1) u^m\) donne
\[ G_{X+Y}(t) = \sum_{m=0}^{+\infty} (m + 1) p^2 q^m t^{m+2} = \sum_{n=2}^{+\infty} (n – 1) p^2 q^{n-2} t^n. \]
Par conséquent, \(P(X + Y = n) = (n – 1) p^2 q^{n-2}\) pour \(n \geq 2\). Cette loi est celle du rang du deuxième succès dans une suite d’épreuves de Bernoulli, ce qui est cohérent.
Stabilité de deux lois usuelles. Si \(X \sim \mathcal{B}(m, p)\) et \(Y \sim \mathcal{B}(n, p)\) sont indépendantes, alors \(X + Y \sim \mathcal{B}(m + n, p)\). Si \(X \sim \mathcal{P}(\lambda)\) et \(Y \sim \mathcal{P}(\mu)\) sont indépendantes, alors \(X + Y \sim \mathcal{P}(\lambda + \mu)\).
Il suffit de multiplier les fonctions génératrices. D’une part, \((1 – p + pt)^m (1 – p + pt)^n = (1 – p + pt)^{m+n}\). D’autre part, \(e^{\lambda(t – 1)} e^{\mu(t – 1)} = e^{(\lambda + \mu)(t – 1)}\). On conclut grâce au caractère caractérisant de la fonction génératrice.
Piège à éviter :
La stabilité de la loi binomiale exige le même paramètre \(p\). Ainsi, la somme de deux variables de Bernoulli indépendantes de paramètres \(1/2\) et \(1/3\) n’est pas binomiale. De même, la somme de deux variables indépendantes de même loi uniforme sur au moins deux points n’est jamais uniforme, comme le montre la loi triangulaire ci-dessus.
5. Loi faible des grands nombres
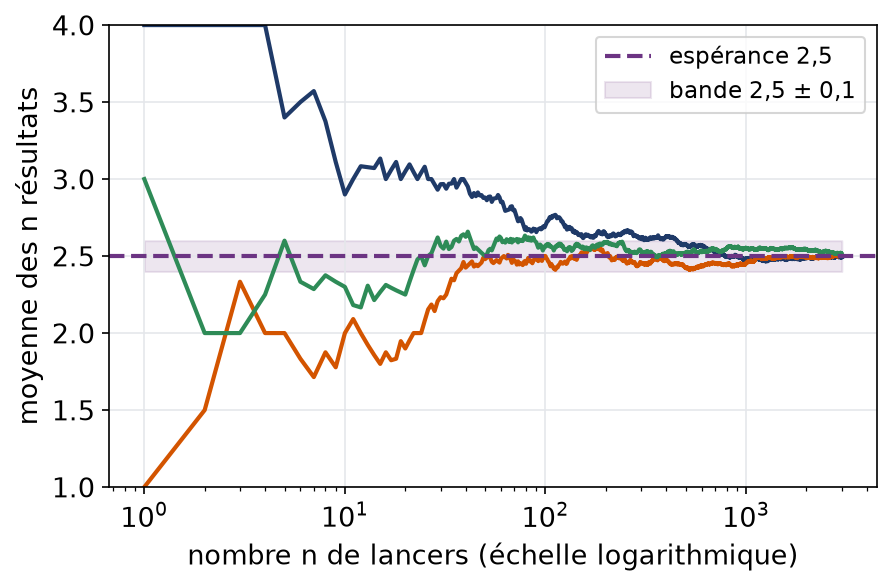
Lançons un dé tétraédrique un grand nombre de fois et calculons la moyenne des résultats. L’expérience montre que cette moyenne se stabilise près de 2,5, l’espérance d’un lancer. La loi faible des grands nombres transforme cette observation en théorème. Sa preuve repose sur une inégalité très simple.
5.1 Deux inégalités de concentration
- Markov. Pour une variable \(X\) positive possédant une espérance et pour un réel \(a > 0\) : \(P(X \geq a) \leq \dfrac{E(X)}{a}\).
- Bienaymé-Tchebychev. Pour une variable \(X\) possédant une variance et pour un réel \(\varepsilon > 0\) : \(P\big(|X – E(X)| \geq \varepsilon\big) \leq \dfrac{V(X)}{\varepsilon^2}\).
Pour Markov, on part de l’inégalité \(a \mathbf{1}_{(X \geq a)} \leq X\), vraie point par point car \(X\) est positive. La croissance de l’espérance donne \(a P(X \geq a) \leq E(X)\). Ensuite, pour Bienaymé-Tchebychev, on applique Markov à la variable positive \(\big(X – E(X)\big)^2\) avec \(a = \varepsilon^2\). En effet, les événements \(\big(|X – E(X)| \geq \varepsilon\big)\) et \(\big((X – E(X))^2 \geq \varepsilon^2\big)\) sont égaux.
Cette inégalité est grossière : elle ne donne qu’une majoration. Cependant, elle s’applique à toute variable de variance finie, sans connaître sa loi. C’est précisément ce qui la rend utile.
5.2 La loi des grands nombres sous forme faible : énoncé et preuve
Version faible. On considère des variables \(X_1, X_2, \dots\) deux à deux indépendantes, ayant toutes la même espérance \(m\) et la même variance \(\sigma^2\). On pose \(S_n = X_1 + \dots + X_n\) et \(M_n = S_n / n\). Alors, pour tout \(\varepsilon > 0\) :
\[ P\big( |M_n – m| \geq \varepsilon \big) \leq \frac{\sigma^2}{n \varepsilon^2} \xrightarrow[n \to +\infty]{} 0. \]
On dit que \(M_n\) converge en probabilité vers \(m\).
Étape 1 : l’espérance. Par linéarité, \(E(S_n) = nm\), donc \(E(M_n) = m\). La moyenne empirique est donc centrée sur la bonne valeur.
Étape 2 : la variance. Les \(X_k\) sont deux à deux indépendantes, donc leurs covariances sont nulles. Ainsi \(V(S_n) = n \sigma^2\), puis \(V(M_n) = \dfrac{n \sigma^2}{n^2} = \dfrac{\sigma^2}{n}\). C’est le cœur de la preuve : la dispersion de la moyenne décroît comme \(1/n\).
Étape 3 : la concentration. Enfin, Bienaymé-Tchebychev appliquée à \(M_n\) donne la majoration annoncée, qui tend vers 0 à \(\varepsilon\) fixé.
La preuve montre que l’hypothèse vraiment utilisée est la nullité des covariances. Par conséquent, le résultat reste vrai pour des variables seulement non corrélées. En revanche, sans contrôle des covariances, la moyenne peut ne pas se stabiliser. Par exemple, si \(X_k = X_1\) pour tout \(k\), alors \(M_n = X_1\) ne se rapproche d’aucune constante.
La figure suivante simule trois suites de lancers d’un dé tétraédrique équilibré. Les trois moyennes empiriques finissent dans la bande \(2{,}5 \pm 0{,}1\), comme le prévoit le théorème.
5.3 Application aux fréquences
Le cas le plus courant concerne la fréquence d’un événement. Soit \(A\) un événement de probabilité \(p\) inconnue, observé lors de \(n\) répétitions indépendantes. On note \(F_n\) la fréquence de réalisation de \(A\). Alors \(F_n\) est la moyenne de \(n\) variables de Bernoulli indépendantes de paramètre \(p\), de variance \(p(1 – p) \leq 1/4\).
Combien de répétitions garantissent \(P(|F_n – p| \geq 0{,}04) \leq 0{,}05\), quelle que soit la valeur de \(p\) ? D’après la loi faible, on a
\[ P(|F_n – p| \geq 0{,}04) \leq \frac{p(1 – p)}{n \times 0{,}04^2} \leq \frac{1}{4 n \times 0{,}0016} = \frac{156{,}25}{n}. \]
Il suffit donc que \(156{,}25 / n \leq 0{,}05\), c’est-à-dire \(n \geq 3125\). Ainsi, 3125 répétitions suffisent. On obtient une borne sûre, mais souvent pessimiste : le théorème central limite, vu plus tard, donnera une valeur bien plus petite.
Remarque :
La loi forte des grands nombres affirme une convergence presque sûre de \(M_n\) vers \(m\). Elle est hors programme de ce chapitre et demande des outils de théorie de la mesure.
Les erreurs fréquentes
- Déduire l’indépendance d’une covariance nulle : il faut revenir à la définition avec les probabilités conjointes.
- Écrire \(V(X – Y) = V(X) – V(Y)\) : les variances s’ajoutent toujours, seul le terme de covariance change de signe.
- Additionner les variances sans justifier l’indépendance, ou au moins la nullité des covariances.
- Oublier les bornes dans une loi marginale, par exemple sommer sur toutes les valeurs de \(j\) alors que seule la zone \(j > i\) compte.
- Multiplier des fonctions génératrices de variables dépendantes.
- Lire Bienaymé-Tchebychev comme une valeur exacte, alors que c’est seulement une majoration.
Fiche mémo
- Loi conjointe : \(p_{x,y} = P(X = x, Y = y)\), de somme 1.
- Marginales : \(P(X = x) = \sum_y p_{x,y}\) et \(P(Y = y) = \sum_x p_{x,y}\).
- Loi conditionnelle : \(P_{(X = x)}(Y = y) = p_{x,y} / P(X = x)\).
- Indépendance : \(p_{x,y} = P(X = x) P(Y = y)\) pour toutes les valeurs.
- Covariance : \(\operatorname{Cov}(X, Y) = E(XY) – E(X) E(Y)\), nulle si indépendance, et \(|\rho| \leq 1\).
- Variance d’une somme : \(V(X + Y) = V(X) + V(Y) + 2 \operatorname{Cov}(X, Y)\).
- Fonction génératrice : \(G_X(t) = E(t^X)\), \(E(X) = G_X^{\prime}(1)\), et \(G_{X+Y} = G_X G_Y\) si indépendance.
- Stabilité : binomiales de même \(p\), et lois de Poisson, avec ajout des paramètres.
- Bienaymé-Tchebychev : \(P(|X – E(X)| \geq \varepsilon) \leq V(X) / \varepsilon^2\).
- Loi faible : \(P(|M_n – m| \geq \varepsilon) \leq \sigma^2 / (n \varepsilon^2)\).
Questions fréquentes
Une covariance nulle prouve-t-elle que deux variables sont indépendantes ?
Non, seul le sens « indépendance donne covariance nulle » est vrai. Un exemple simple le montre : prenez X uniforme sur {-2, -1, 1, 2} et Y = |X|, la covariance vaut 0 alors que Y est une fonction de X. Pour prouver l’indépendance, il faut revenir aux probabilités P(X = x, Y = y).
Faut-il connaître la loi conjointe pour calculer la variance d'une somme ?
Pas toujours. La formule V(X + Y) = V(X) + V(Y) + 2 Cov(X, Y) ne demande que les variances et la covariance. Or la covariance se calcule souvent par E(XY), parfois sans écrire tout le tableau. Si les variables sont indépendantes, la covariance est nulle et les variances s’ajoutent.
À quoi sert la fonction génératrice en pratique ?
Elle transforme une somme de variables indépendantes en un produit de fonctions. Vous identifiez alors la loi de la somme en reconnaissant une fonction génératrice connue. De plus, ses dérivées en 1 donnent l’espérance et la variance sans calculer de série.
Quelle est la différence entre loi faible et loi forte des grands nombres ?
La loi faible affirme que la probabilité d’un écart supérieur à ε entre la moyenne empirique et l’espérance tend vers 0. La loi forte, hors programme de L2, affirme que la moyenne converge presque sûrement. Ce cours démontre la forme faible, qui suffit pour les estimations de taille d’échantillon.
Pour aller plus loin
- S’exercer : exercices corrigés de L2 de maths sur couples et loi des grands nombres
- Bases utiles : Lois discrètes, espérance et variance
- Chapitre d’avant : Lois discrètes, espérance et variance
- Chapitre d’après : Convergence uniforme et normale des fonctions
- Vérifier ses acquis : QCM de L2 de maths sur couples et loi des grands nombres
- Contrôle corrigé en temps limité : Covariance et fonctions génératrices : contrôle de maths en L2
- Un autre sujet noté sur 20 : Partiel de probabilités discrètes : contrôle de maths en L2
- Le même thème en maths spé (MP) : Loi faible des grands nombres et séries génératrices
- Tous les chapitres : le sommaire de la L2 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «couples et loi des grands nombres en L2 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.