Polynômes annulateurs en L2 de maths : cours et méthodes
Ce chapitre prolonge la réduction des endomorphismes. Au lieu de chercher des vecteurs propres un par un, nous faisons agir des polynômes sur un endomorphisme. Les polynômes annulateurs L2 deviennent alors un outil de calcul et de preuve : puissances, inverses, critère de diagonalisabilité.
Nous construisons d’abord le polynôme minimal, puis nous démontrons en détail le lemme des noyaux et le théorème de Cayley-Hamilton. Ensuite, nous traitons la trigonalisation, les sous-espaces caractéristiques et les endomorphismes nilpotents. Chaque résultat est accompagné d’exemples numériques originaux et de contre-exemples qui montrent pourquoi les hypothèses comptent.
Ce chapitre se place au premier semestre de L2, juste après les valeurs propres. Il prépare la réduction de Jordan, les systèmes différentiels linéaires et l’exponentielle de matrice.
Ce que vous saurez faire
- Calculer les puissances et l’inverse d’une matrice à partir d’un polynôme qui l’annule.
- Déterminer le polynôme minimal d’un endomorphisme et en déduire son spectre.
- Décomposer l’espace grâce au lemme des noyaux et écrire les projecteurs associés.
- Appliquer le théorème de Cayley-Hamilton et en connaître une preuve correcte.
- Décider si une matrice est diagonalisable sans chercher tous ses vecteurs propres.
- Trigonaliser une matrice de taille trois et la réduire par blocs.
- Reconnaître et manipuler un endomorphisme nilpotent.
1. Polynômes d’un endomorphisme
Le corps de base \(\mathbb{K}\) vaut \(\mathbb{R}\) ou \(\mathbb{C}\), et l’espace \(E\) est pris sur ce corps. Nous le supposons de dimension finie \(n \geqslant 1\), sauf indication explicite. Un endomorphisme se compose avec lui-même, et on peut donc l’élever à une puissance. Ensuite, on combine ces puissances linéairement. C’est exactement ce que fait un polynôme.
Soit \(u \in \mathcal{L}(E)\) et \(P = \sum_{k=0}^{d} a_k X^k \in \mathbb{K}[X]\). On pose \(u^0 = \mathrm{id}_E\), \(u^{k+1} = u \circ u^k\), puis
\[P(u) = \sum_{k=0}^{d} a_k u^k = a_0\,\mathrm{id}_E + a_1 u + \cdots + a_d u^d.\]
Pour une matrice \(A \in \mathcal{M}_n(\mathbb{K})\), on définit de même \(P(A)\) en remplaçant \(\mathrm{id}_E\) par \(I_n\).
Le terme constant \(a_0\) devient \(a_0\,\mathrm{id}_E\), et non le scalaire \(a_0\). Cette convention garantit que \(P(u)\) est bien un endomorphisme.
L’application \(P \mapsto P(u)\) est un morphisme d’algèbres de \(\mathbb{K}[X]\) dans \(\mathcal{L}(E)\) : pour tous \(P, Q\) et tout scalaire \(\lambda\),
\[(\lambda P + Q)(u) = \lambda P(u) + Q(u), \qquad (PQ)(u) = P(u) \circ Q(u).\]
En particulier, \(P(u)\) et \(Q(u)\) commutent toujours. De plus, \(\ker P(u)\) et \(\mathrm{Im}\, P(u)\) sont stables par \(u\).
La linéarité vient de la définition. Pour le produit, il suffit de traiter deux monômes, car tout se prolonge ensuite par bilinéarité. Or \(X^j X^k = X^{j+k}\) et \(u^j \circ u^k = u^{j+k}\). Comme \(PQ = QP\), on obtient aussi \(P(u) \circ Q(u) = Q(u) \circ P(u)\).
Prenons enfin \(x \in \ker P(u)\). Puisque \(u = X(u)\) commute avec \(P(u)\), on a \(P(u)(u(x)) = u(P(u)(x)) = u(0) = 0\). Ainsi \(u(x) \in \ker P(u)\). Le cas de l’image se traite de la même façon.
Piège à éviter :
L’égalité \((PQ)(u) = P(u) \circ Q(u)\) concerne un seul endomorphisme. Pour deux endomorphismes \(u\) et \(v\) qui ne commutent pas, \((u+v)^2\) vaut \(u^2 + u \circ v + v \circ u + v^2\). Par conséquent, la formule du binôme exige que \(u\) et \(v\) commutent.
1.1 Calculer avec un polynôme qui annule
Supposons que \(P(A) = 0\) pour un certain polynôme non nul \(P\). Alors toute puissance de \(A\) se ramène à une combinaison de \(I_n, A, \dots, A^{d-1}\), où \(d = \deg P\). En effet, la division euclidienne \(X^m = Q P + R\) donne \(A^m = Q(A) P(A) + R(A) = R(A)\).
Soit \(A = \begin{pmatrix} 0 & -3 \\ 1 & 4 \end{pmatrix}\). Un calcul direct donne \(A^2 = \begin{pmatrix} -3 & -12 \\ 4 & 13 \end{pmatrix} = 4A – 3I_2\). Le polynôme \(P = X^2 – 4X + 3 = (X-1)(X-3)\) annule donc \(A\).
D’abord, l’inverse. On écrit \(A(4I_2 – A) = 3I_2\), donc \(A\) est inversible et \(A^{-1} = \frac{1}{3}(4I_2 – A)\).
Ensuite, les puissances. On divise \(X^m\) par \(P\) : \(X^m = Q_m P + a_m X + b_m\). En évaluant en \(1\) puis en \(3\), on obtient \(a_m + b_m = 1\) et \(3a_m + b_m = 3^m\). Par conséquent,
\[A^m = \frac{3^m – 1}{2}\, A + \frac{3 – 3^m}{2}\, I_2 \qquad (m \in \mathbb{N}).\]
Pour \(m = 2\), on retrouve bien \(4A – 3I_2\).
2. Polynômes annulateurs et polynôme minimal
Nous étudions maintenant l’ensemble de tous les polynômes qui annulent un endomorphisme. Sa structure d’idéal fournit un générateur privilégié : le polynôme minimal.
Un polynôme \(P\) est un polynôme annulateur de \(u\) lorsque \(P(u) = 0\). L’ensemble \(I_u\) de ces polynômes est le noyau du morphisme \(P \mapsto P(u)\). C’est donc un idéal de \(\mathbb{K}[X]\).
En dimension finie, l’idéal \(I_u\) n’est pas réduit à \(\{0\}\). Il possède un générateur unitaire \(\pi_u\), et ce générateur est unique : \(I_u = \pi_u\, \mathbb{K}[X]\). Ce polynôme \(\pi_u\) porte le nom de polynôme minimal. Parmi les annulateurs unitaires, il a le plus petit degré, et chaque annulateur en est un multiple.
Existence d’un annulateur. Dans \(\mathcal{L}(E)\), de dimension \(n^2\), toute famille de \(n^2 + 1\) vecteurs est liée. C’est le cas de \((u^0, u^1, \dots, u^{n^2})\). Une relation de dépendance non triviale fournit un polynôme non nul qui annule \(u\).
Générateur. Parmi les annulateurs non nuls, on choisit \(\pi_u\) unitaire de degré minimal. Soit \(P \in I_u\). On effectue la division \(P = Q\pi_u + R\) avec \(\deg R < \deg \pi_u\). Alors \(R(u) = P(u) – Q(u)\pi_u(u) = 0\). Par minimalité du degré, \(R = 0\), donc \(\pi_u\) divise \(P\).
Unicité. Deux tels polynômes unitaires se divisent l’un l’autre. Ils sont donc égaux.
Remarque :
Le théorème de Cayley-Hamilton (partie 4) améliore la borne : on verra que \(\deg \pi_u \leqslant n\), et non seulement \(n^2\).
2.1 Annulateurs et valeurs propres
Un annulateur renseigne sur le spectre, mais seulement dans un sens. Nous précisons ici ce qu’il dit et ce qu’il ne dit pas.
Soit \(x\) un vecteur propre de \(u\) pour la valeur propre \(\lambda\). Pour tout polynôme \(P\), on a \(P(u)(x) = P(\lambda)\, x\). Par conséquent :
- si \(P(u) = 0\), chaque valeur propre \(\lambda\) de \(u\) vérifie \(P(\lambda) = 0\) ;
- l’ensemble des racines de \(\pi_u\) dans \(\mathbb{K}\) coïncide avec le spectre de \(u\).
Par récurrence, \(u^k(x) = \lambda^k x\) pour tout \(k\). Par linéarité, \(P(u)(x) = P(\lambda) x\). Si \(P(u) = 0\), alors \(P(\lambda) x = 0\) avec \(x \neq 0\), donc \(P(\lambda) = 0\).
Dans l’autre sens, partons d’un scalaire \(\mu\) qui annule \(\pi_u\). La factorisation \(\pi_u = (X – \mu) Q\) fournit un polynôme \(Q\) de degré trop petit pour annuler \(u\), d’où \(Q(u) \neq 0\). Prenons \(y\) tel que \(z = Q(u)(y) \neq 0\). On obtient \((u – \mu\,\mathrm{id})(z) = \pi_u(u)(y) = 0\). Ainsi \(\mu\) est valeur propre, de vecteur propre \(z\).
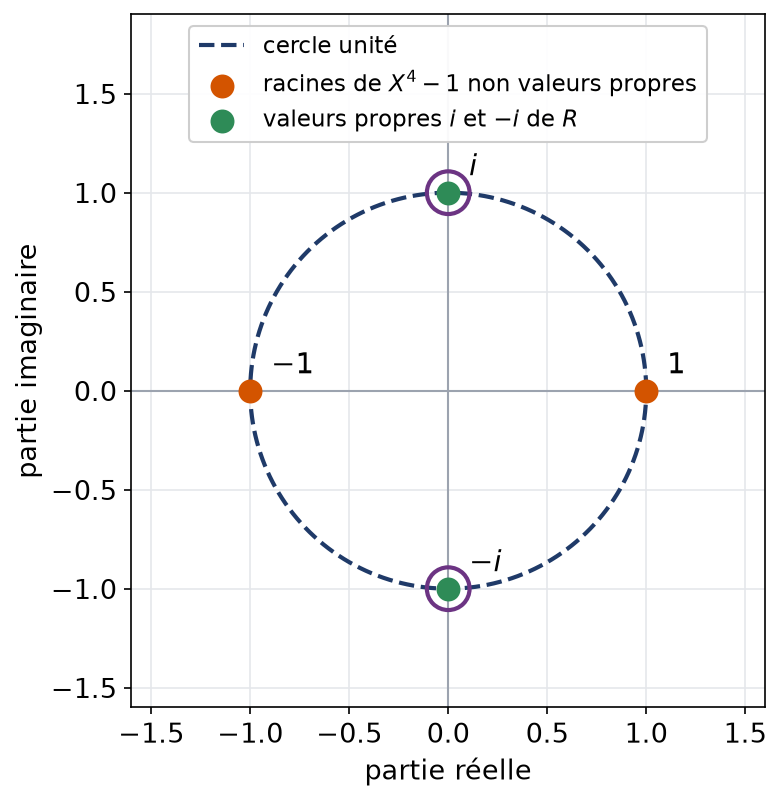
La matrice \(R = \begin{pmatrix} 0 & -1 \\ 1 & 0 \end{pmatrix}\) vérifie \(R^2 = -I_2\), donc \(R^4 = I_2\). Le polynôme \(X^4 – 1\) l’annule, et ses racines complexes sont \(1, -1, i, -i\). Cependant, \(R\) n’a que deux valeurs propres complexes : \(i\) et \(-i\).
En effet, \(\pi_R\) divise \(X^4 – 1\), il est unitaire et n’est pas de degré \(1\) puisque \(R\) n’est pas scalaire. Or \(X^2 + 1\) annule \(R\). Donc \(\pi_R = X^2 + 1\), et ses racines donnent exactement le spectre complexe. Sur \(\mathbb{R}\), en revanche, \(R\) n’a aucune valeur propre.
La figure suivante place les racines de l’annulateur et les valeurs propres de \(R\) dans le plan complexe. Les deux points supplémentaires sont des racines « inutiles ».
Piège à éviter :
Une racine d’un annulateur n’est pas forcément une valeur propre. Par exemple, \(X^3 – X\) annule tout projecteur \(p\), puisque \(p^3 = p\). Pourtant \(-1\) n’est jamais valeur propre d’un projecteur. Seul le polynôme minimal donne le spectre exact.
Pour déterminer le polynôme minimal d’une matrice \(A\) :
- calculer \(\chi_A\) et le factoriser ; on sait (partie 4) que \(\pi_A\) le divise et possède les mêmes racines ;
- lister les diviseurs unitaires de \(\chi_A\) où figure au moins une fois chaque facteur \(X – \lambda\), puis les essayer par degrés croissants ;
- le premier diviseur \(D\) tel que \(D(A) = 0\) est \(\pi_A\).
Pour une petite matrice, on peut aussi chercher directement une relation \(A^2 = \alpha A + \beta I_n\).
En dimension infinie, un endomorphisme n’a pas toujours d’annulateur non nul. Prenons la dérivation \(D : P \mapsto P^{\prime}\) sur \(\mathbb{K}[X]\). Supposons \(Q = \sum_{k=r}^{d} c_k X^k\) annulateur, avec \(c_r \neq 0\). Alors \(Q(D)(X^r) = c_r\, r! \neq 0\), car \(D^k(X^r) = 0\) pour \(k > r\). C’est absurde : seul le polynôme nul annule \(D\).
3. Le lemme des noyaux et la diagonalisabilité
Le lemme des noyaux transforme une factorisation de polynôme en décomposition de l’espace. C’est le résultat central du chapitre, et sa preuve repose sur une seule idée : l’identité de Bézout.
Lemme des noyaux. On se donne \(r\) polynômes \(P_1, \dots, P_r\) sans facteur commun pris deux à deux, et l’on note \(P\) leur produit. Dans ces conditions,
\[\ker P(u) = \ker P_1(u) \oplus \ker P_2(u) \oplus \cdots \oplus \ker P_r(u).\]
Si de plus \(P\) annule \(u\), on obtient \(E = \ker P_1(u) \oplus \cdots \oplus \ker P_r(u)\).
Nous traitons d’abord deux facteurs \(P_1\) et \(P_2\). Comme ils sont premiers entre eux, Bézout fournit \(U_1, U_2\) tels que \(U_1 P_1 + U_2 P_2 = 1\). On évalue en \(u\) :
\[U_1(u) \circ P_1(u) + U_2(u) \circ P_2(u) = \mathrm{id}_E.\]
Somme directe. Soit \(x \in \ker P_1(u) \cap \ker P_2(u)\). L’identité précédente donne \(x = U_1(u)(P_1(u)x) + U_2(u)(P_2(u)x) = 0\).
Inclusion facile. Si \(P_1(u)x = 0\), alors \(P(u)x = P_2(u)(P_1(u)x) = 0\). De même pour \(\ker P_2(u)\).
Décomposition. Soit \(x \in \ker P(u)\). On pose \(x_1 = U_2(u) P_2(u)\, x\) et \(x_2 = U_1(u) P_1(u)\, x\). L’identité donne \(x = x_1 + x_2\). De plus, \(P_1(u)x_1 = U_2(u)\, P(u)\, x = 0\), car tous ces polynômes en \(u\) commutent. Ainsi \(x_1 \in \ker P_1(u)\), et de même \(x_2 \in \ker P_2(u)\).
Cas général. Une récurrence sur le nombre de facteurs conclut. Le point clé : \(P_r\), sans facteur commun avec chacun des \(P_i\), n’en a pas non plus avec leur produit.
La preuve donne plus que l’énoncé. Les endomorphismes \(U_2(u)P_2(u)\) et \(U_1(u)P_1(u)\) sont les projecteurs associés à la décomposition. Ce sont donc des polynômes en \(u\), ce qui les rend faciles à calculer.
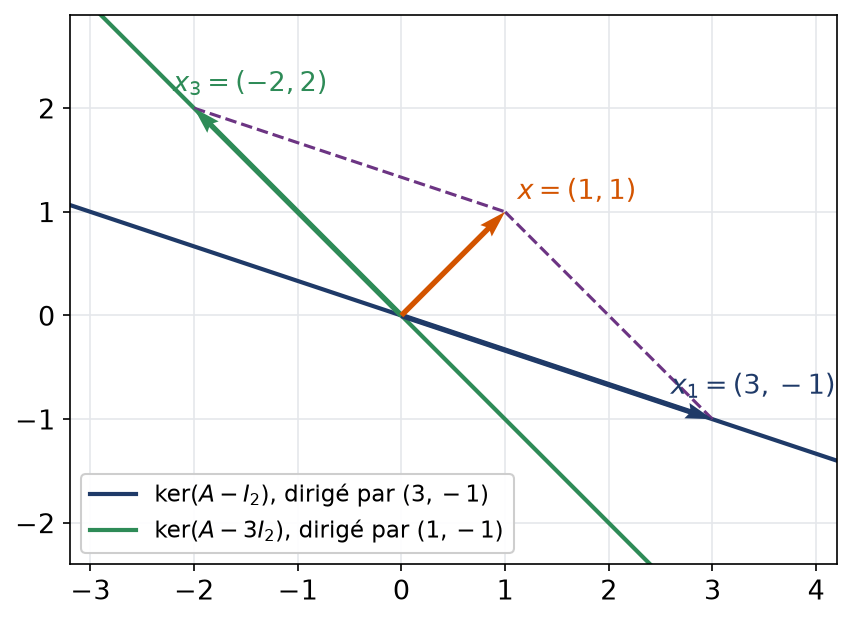
Reprenons \(A = \begin{pmatrix} 0 & -3 \\ 1 & 4 \end{pmatrix}\), annulée par \((X-1)(X-3)\). Ici \(-\frac{1}{2}(X – 3) + \frac{1}{2}(X – 1) = 1\). Les projecteurs sont donc
\[p_1 = -\tfrac{1}{2}(A – 3I_2), \qquad p_3 = \tfrac{1}{2}(A – I_2).\]
Le noyau de \(A – I_2\) est la droite dirigée par \((3, -1)\), celui de \(A – 3I_2\) la droite dirigée par \((1, -1)\). Par exemple, le vecteur \(x = (1, 1)\) se décompose en \((3, -1) + (-2, 2)\).
3.1 Diagonalisabilité et racines simples
Nous arrivons au critère le plus utilisé en pratique. Il évite de calculer les dimensions de tous les sous-espaces propres.
Pour \(u \in \mathcal{L}(E)\), trois propriétés reviennent au même :
- une base de \(E\) est formée de vecteurs propres de \(u\) ;
- un produit \(\prod_i (X – \mu_i)\), avec des \(\mu_i \in \mathbb{K}\) distincts, annule \(u\) ;
- le polynôme minimal \(\pi_u\) est lui-même un tel produit.
(1) implique (3). Notons \(\lambda_1, \dots, \lambda_r\) les valeurs propres distinctes et \(P = \prod_{i}(X – \lambda_i)\). Sur une base propre, chaque vecteur \(e\) associé à \(\lambda_i\) vérifie \(P(u)(e) = P(\lambda_i)e = 0\). Donc \(P\) annule \(u\), et \(\pi_u\) divise \(P\). Ainsi \(\pi_u\) est scindé à racines simples.
(3) implique (2) : il suffit de prendre \(\pi_u\).
(2) implique (1). Soit \(P = \prod_{i}(X – \mu_i)\) annulateur, avec des \(\mu_i\) distincts. Les facteurs \(X – \mu_i\) sont premiers entre eux deux à deux. Le lemme des noyaux découpe alors \(E\) en \(\bigoplus_i \ker(u – \mu_i\,\mathrm{id})\). Une base de chaque morceau, puis la concaténation de ces bases, fournit la base propre cherchée.
Soit \(F\) un sous-espace que \(u\) laisse stable, et \(u_F\) l’endomorphisme induit. Lorsque \(u\) se diagonalise, \(u_F\) se diagonalise aussi. La raison tient en une ligne : \(\pi_u(u_F)\) est la restriction à \(F\) de \(\pi_u(u) = 0\).
Prenons \(B \in \mathcal{M}_4(\mathbb{R})\) vérifiant \(B^2 = 5B – 6I_4\). Le trinôme \(X^2 – 5X + 6\) se factorise en \((X – 2)(X – 3)\), avec deux racines réelles distinctes. Le critère s’applique : \(B\) se diagonalise, et ses valeurs propres sont à chercher parmi \(2\) et \(3\).
Supposons de plus \(\mathrm{tr}\, B = 10\). Si \(2\) apparaît \(k\) fois sur la diagonale, alors \(2k + 3(4 – k) = 10\), d’où \(k = 2\). Par conséquent, \(B\) est semblable à \(\mathrm{diag}(2, 2, 3, 3)\) et \(\det B = 36\).
Piège à éviter :
Le corps compte. La matrice \(R\) de la partie 2 est annulée par \(X^2 + 1\), qui est à racines simples dans \(\mathbb{C}\) mais n’est pas scindé dans \(\mathbb{R}\). Ainsi \(R\) est diagonalisable sur \(\mathbb{C}\), mais pas sur \(\mathbb{R}\).
La matrice \(N = \begin{pmatrix} 0 & 1 \\ 0 & 0 \end{pmatrix}\) est annulée par \(X^2\), qui est scindé mais possède une racine double. De plus \(N \neq 0\), donc \(\pi_N = X^2\). Le critère montre alors que \(N\) n’est pas diagonalisable. On le vérifie directement : sa seule valeur propre est \(0\), et une matrice diagonalisable de spectre \(\{0\}\) serait nulle.
4. Le théorème de Cayley-Hamilton
Nous disposons d’un annulateur théorique de degré au plus \(n^2\). Le théorème suivant en fournit un explicite, de degré \(n\) : le polynôme caractéristique. On note ici \(\chi_A = \det(XI_n – A)\), qui est unitaire.
Cayley-Hamilton. Pour toute matrice \(A \in \mathcal{M}_n(\mathbb{K})\), on a \(\chi_A(A) = 0\). De même, \(\chi_u(u) = 0\) pour tout \(u \in \mathcal{L}(E)\). Par conséquent, \(\pi_u\) divise \(\chi_u\) et \(\deg \pi_u \leqslant n\).
Piège à éviter :
La « preuve » qui remplace \(X\) par \(A\) dans \(\det(XI_n – A)\) est fausse. D’une part, \(\det(A \cdot I_n – A)\) serait un scalaire, alors que \(\chi_A(A)\) est une matrice. D’autre part, une matrice dont les coefficients sont des matrices n’a pas de déterminant au sens usuel.
Nous utilisons la comatrice. Posons \(M(X) = XI_n – A\), à coefficients dans \(\mathbb{K}[X]\). La formule de la comatrice reste valable sur cet anneau commutatif :
\[M(X)\, {}^{t}\mathrm{Com}\big(M(X)\big) = \chi_A(X)\, I_n.\]
Les coefficients de \({}^{t}\mathrm{Com}(M(X))\) sont des cofacteurs de taille \(n-1\), donc des polynômes de degré au plus \(n-1\). On regroupe selon les puissances de \(X\) : \({}^{t}\mathrm{Com}(M(X)) = \sum_{k=0}^{n-1} X^k B_k\), avec des \(B_k\) dans \(\mathcal{M}_n(\mathbb{K})\).
Écrivons \(\chi_A = \sum_{k=0}^{n} c_k X^k\), avec \(c_n = 1\). On développe \((XI_n – A)\sum_k X^k B_k\) et on identifie les coefficients de chaque \(X^k\) :
\[-AB_0 = c_0 I_n, \qquad B_{k-1} – AB_k = c_k I_n \ (1 \leqslant k \leqslant n-1), \qquad B_{n-1} = I_n.\]
On multiplie l’égalité d’indice \(k\) à gauche par \(A^k\), puis on additionne. Le membre de droite vaut \(\chi_A(A)\). À gauche, le terme \(A^k B_{k-1}\) issu de la ligne \(k\) compense le terme \(-A^{k}B_{k-1}\) issu de la ligne \(k-1\), et la somme vaut \(0\). Donc \(\chi_A(A) = 0\).
Pour un endomorphisme, il suffit d’appliquer ce résultat à sa matrice dans une base quelconque.
Le point délicat de cette preuve est l’identification. Elle est légitime car on compare deux polynômes à coefficients matriciels, coefficient par coefficient, sans jamais « remplacer » \(X\) par une matrice dans un déterminant.
4.1 Applications du théorème
Le théorème sert surtout à trois choses : inverser, réduire les puissances et borner le polynôme minimal.
Soit \(A = \begin{pmatrix} 5 & -2 & -3 \\ 0 & 2 & 0 \\ 6 & -5 & -4 \end{pmatrix}\). En développant \(\det(XI_3 – A)\) selon la deuxième ligne, on trouve
\[\chi_A = (X – 2)\big[(X – 5)(X + 4) + 18\big] = (X – 2)(X^2 – X – 2) = (X – 2)^2 (X + 1).\]
Ainsi \(\chi_A = X^3 – 3X^2 + 4\), et Cayley-Hamilton donne \(A^3 – 3A^2 + 4I_3 = 0\). On en tire \(A(3A – A^2) = 4I_3\). Donc \(A\) est inversible et
\[A^{-1} = \frac{1}{4}\big(3A – A^2\big), \qquad A^2 = \begin{pmatrix} 7 & 1 & -3 \\ 0 & 4 & 0 \\ 6 & -2 & -2 \end{pmatrix}.\]
Le calcul donne \(A^{-1} = \frac{1}{4}\begin{pmatrix} 8 & -7 & -6 \\ 0 & 2 & 0 \\ 12 & -13 & -10 \end{pmatrix}\). On contrôle enfin une colonne de \(AA^{-1}\) pour éviter une faute de signe.
Pour inverser \(A\) avec Cayley-Hamilton :
- calculer \(\chi_A = X^n + c_{n-1}X^{n-1} + \cdots + c_1 X + c_0\) ;
- vérifier que \(c_0 = (-1)^n \det A\) est non nul ;
- écrire \(A\,(A^{n-1} + c_{n-1}A^{n-2} + \cdots + c_1 I_n) = -c_0 I_n\) ;
- conclure que \(A^{-1}\) est un polynôme en \(A\) de degré au plus \(n-1\).
Revenons au polynôme minimal de cette matrice. Il divise \((X-2)^2(X+1)\) et contient les racines \(2\) et \(-1\). Il reste donc deux candidats. Or le produit \((A – 2I_3)(A + I_3)\) vaut \(\begin{pmatrix} 0 & 3 & 0 \\ 0 & 0 & 0 \\ 0 & 3 & 0 \end{pmatrix} \neq 0\). Par conséquent, \(\pi_A = (X – 2)^2 (X + 1)\), et \(A\) n’est pas diagonalisable.
5. Trigonalisation
Quand la diagonalisation échoue, on cherche une forme presque aussi utile : une matrice triangulaire supérieure. Les valeurs propres apparaissent alors sur la diagonale.
On dit que \(u\) est trigonalisable lorsqu’au moins une base de \(E\) lui associe une matrice triangulaire supérieure. Pour une matrice carrée \(A\), cela revient à écrire \(A = PTP^{-1}\), où \(P\) est inversible et \(T\) triangulaire supérieure.
Pour \(u \in \mathcal{L}(E)\), on a les équivalences suivantes : \(u\) se trigonalise ; \(\chi_u\) se factorise en facteurs de degré \(1\) sur \(\mathbb{K}\) ; un polynôme ainsi factorisé annule \(u\). Toute matrice complexe se trigonalise donc.
Si la matrice de \(u\) est triangulaire de diagonale \(t_{11}, \dots, t_{nn}\), alors \(\chi_u = \prod_i (X – t_{ii})\) est scindé. Ensuite, Cayley-Hamilton montre qu’un \(\chi_u\) scindé est un annulateur scindé.
Supposons enfin qu’un polynôme scindé \(P\) annule \(u\). Nous raisonnons par récurrence sur \(n\). Le cas \(n = 1\) est clair. Comme \(\pi_u\) divise \(P\), il est scindé. Une de ses racines est alors une valeur propre \(\lambda\), de vecteur propre \(e_1\). On complète \(e_1\) en une base \(\mathcal{B}\) de \(E\). La matrice de \(u\) s’écrit alors par blocs \(\begin{pmatrix} \lambda & L \\ 0 & A_1 \end{pmatrix}\), avec \(A_1\) de taille \(n – 1\).
Un calcul par blocs donne \(P(A_1) = 0\), puisque le bloc diagonal de \(P(\mathrm{Mat}_{\mathcal{B}}(u))\) vaut \(P(A_1)\). L’hypothèse de récurrence, appliquée en taille \(n – 1\), fournit \(Q\) inversible et \(T_1\) triangulaire telles que \(A_1 = Q T_1 Q^{-1}\). Le changement de base de matrice \(\begin{pmatrix} 1 & 0 \\ 0 & Q \end{pmatrix}\) trigonalise alors \(u\).
Supposons \(\chi_A = \prod_{i=1}^{n}(X – \lambda_i)\), chaque racine étant répétée autant de fois que sa multiplicité. Dans ce cas, \(\mathrm{tr}\, A = \sum_i \lambda_i\) et \(\det A = \prod_i \lambda_i\). De plus, pour tout polynôme \(P\), les valeurs propres de \(P(A)\) sont les \(P(\lambda_i)\).
Pour trigonaliser une matrice \(A\) de taille trois dont \(\chi_A = (X – \alpha)^2 (X – \beta)\), avec \(\alpha \neq \beta\) et \(\dim \ker(A – \alpha I_3) = 1\) :
- choisir \(v_1\) dirigeant \(\ker(A – \alpha I_3)\) et \(v_3\) dirigeant \(\ker(A – \beta I_3)\) ;
- choisir \(v_2\) dans \(\ker(A – \alpha I_3)^2\) mais hors de \(\ker(A – \alpha I_3)\) ;
- calculer \((A – \alpha I_3)v_2\) : ce vecteur est colinéaire à \(v_1\), et on ajuste \(v_2\) pour qu’il soit égal à \(v_1\) ;
- dans la base \((v_1, v_2, v_3)\), la matrice vaut \(\begin{pmatrix} \alpha & 1 & 0 \\ 0 & \alpha & 0 \\ 0 & 0 & \beta \end{pmatrix}\).
Reprenons \(A = \begin{pmatrix} 5 & -2 & -3 \\ 0 & 2 & 0 \\ 6 & -5 & -4 \end{pmatrix}\), de polynôme caractéristique \((X-2)^2(X+1)\). D’abord, \(\ker(A – 2I_3)\) est la droite dirigée par \(v_1 = (1, 0, 1)\). Ensuite, \(\ker(A + I_3)\) est dirigé par \(v_3 = (1, 0, 2)\).
Puis on calcule \((A – 2I_3)^2 = \begin{pmatrix} -9 & 9 & 9 \\ 0 & 0 & 0 \\ -18 & 18 & 18 \end{pmatrix}\). Son noyau est le plan d’équation \(x = y + z\). On y choisit \(v_2 = (1, 1, 0)\), qui n’est pas propre. Or \(Av_2 = (3, 2, 1) = 2v_2 + v_1\). Donc, avec \(P = \begin{pmatrix} 1 & 1 & 1 \\ 0 & 1 & 0 \\ 1 & 0 & 2 \end{pmatrix}\), on obtient
\[P^{-1} A P = T = \begin{pmatrix} 2 & 1 & 0 \\ 0 & 2 & 0 \\ 0 & 0 & -1 \end{pmatrix}.\]
Pour vérifier sans inverser \(P\), on contrôle \(AP = PT\) colonne par colonne.
6. Sous-espaces caractéristiques et nilpotents
L’exemple précédent a une structure par blocs. Nous la généralisons : chaque valeur propre possède un sous-espace stable, sur lequel \(u\) est la somme d’une homothétie et d’un nilpotent.
On qualifie \(v\) de nilpotent quand l’une de ses puissances \(v^p\), avec \(p \geqslant 1\), est l’application nulle. L’exposant \(p\) minimal s’appelle l’indice de nilpotence.
Soit \(v \in \mathcal{L}(E)\) nilpotent d’indice \(p\). Alors \(\pi_v = X^p\), \(p \leqslant n\) et \(\chi_v = X^n\). De plus, \(v\) est trigonalisable avec une diagonale nulle, et \(\mathrm{tr}(v^k) = 0\) pour tout \(k \geqslant 1\).
Le polynôme \(X^p\) annule \(v\), donc \(\pi_v\) le divise : \(\pi_v = X^q\) avec \(q \leqslant p\). Comme \(v^{q} = 0\), la minimalité de \(p\) impose \(q = p\). Ensuite, \(\pi_v\) divise \(\chi_v\), de degré \(n\), donc \(p \leqslant n\).
L’annulateur \(X^p\) est scindé, donc \(v\) est trigonalisable. Sa seule valeur propre possible est \(0\), qui figure donc seule sur la diagonale. D’où \(\chi_v = X^n\). Enfin, \(v^k\) est triangulaire de diagonale nulle, donc de trace nulle.
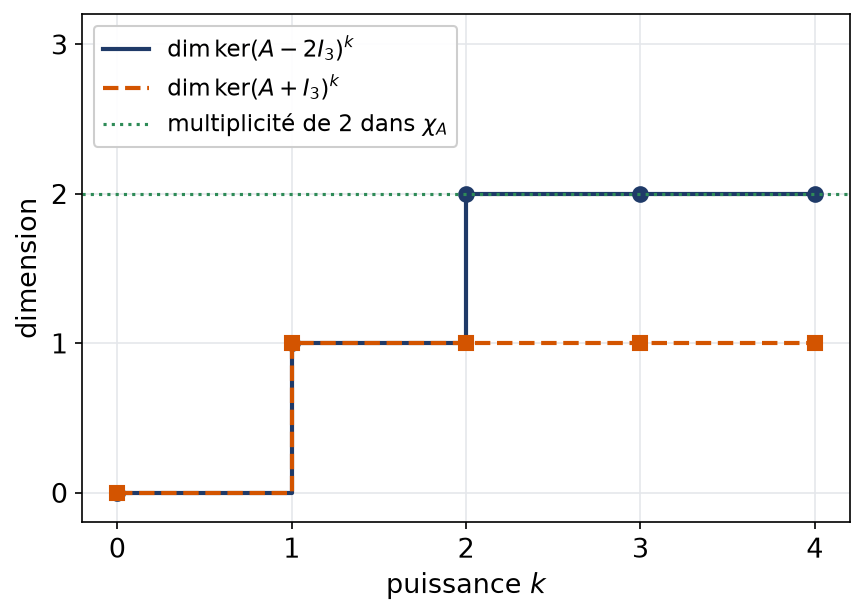
La suite des noyaux itérés \(\ker v \subset \ker v^2 \subset \cdots\) croît strictement puis se stabilise à \(E\). La figure ci-dessous montre cette croissance pour la matrice \(A – 2I_3\) de l’exemple guidé : les dimensions valent \(1\), puis \(2\), puis restent égales à \(2\).
Écrivons \(\chi_u = \prod_{i=1}^{r} (X – \lambda_i)^{m_i}\), où les \(\lambda_i\) sont deux à deux différents. Pour chaque indice \(i\), on pose \(F_i = \ker (u – \lambda_i\,\mathrm{id})^{m_i}\) : c’est le sous-espace caractéristique de la valeur propre \(\lambda_i\).
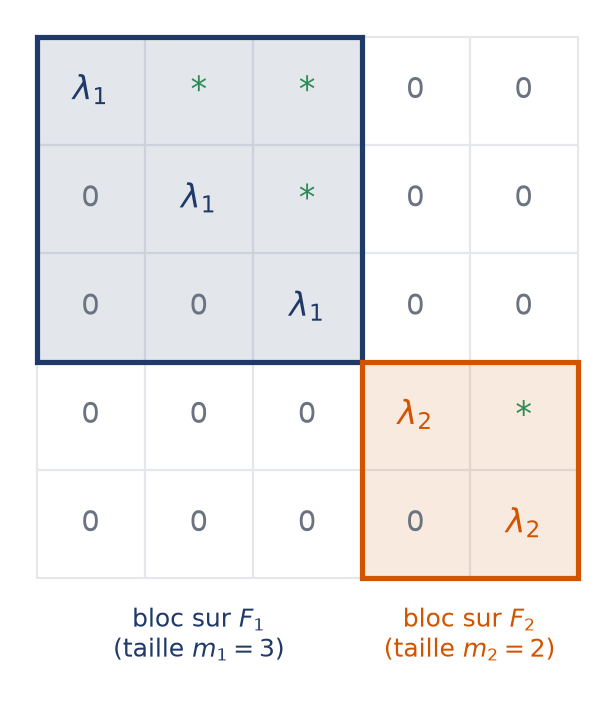
Avec ces notations, \(E = F_1 \oplus \cdots \oplus F_r\). Chaque \(F_i\) est stable par \(u\) et \(\dim F_i = m_i\). Enfin, sur \(F_i\), l’endomorphisme induit s’écrit \(\lambda_i\,\mathrm{id} + n_i\), avec \(n_i\) nilpotent.
Deux facteurs \((X – \lambda_i)^{m_i}\) distincts n’ont aucune racine commune, et leur produit \(\chi_u\) annule \(u\) d’après Cayley-Hamilton. La somme directe découle alors du lemme des noyaux. Chaque \(F_i\) est le noyau d’un polynôme en \(u\), donc il est stable.
Notons \(u_i\) l’endomorphisme induit sur \(F_i\) et \(d_i = \dim F_i\). Par construction, \(n_i = u_i – \lambda_i\,\mathrm{id}\) vérifie \(n_i^{m_i} = 0\). Ainsi \(\chi_{u_i} = (X – \lambda_i)^{d_i}\). Or \(\chi_u\) est le produit des \(\chi_{u_i}\), car la matrice de \(u\) est diagonale par blocs dans une base adaptée. En identifiant les exposants, on obtient \(d_i = m_i\).
Prenons maintenant, dans chaque \(F_i\), une base où \(n_i\) devient triangulaire. La matrice de \(u\) se présente alors en blocs posés le long de la diagonale. Chacun d’eux porte, sur sa propre diagonale, une valeur propre unique répétée \(m_i\) fois. La figure suivante schématise cette réduction pour deux valeurs propres.
Remarque :
Les projecteurs sur les \(F_i\) sont des polynômes en \(u\), comme dans la preuve du lemme des noyaux. Ils permettent de calculer \(u^m\) bloc par bloc. Les problèmes de la fiche d’exercices exploitent cette idée.
Les erreurs fréquentes
- Croire que toute racine d’un annulateur est une valeur propre : seul le polynôme minimal donne le spectre exact.
- Démontrer Cayley-Hamilton en substituant \(A\) à \(X\) dans le déterminant.
- Conclure à la diagonalisabilité avec un annulateur à racines simples mais non scindé sur le corps de travail.
- Oublier que \(P(A)\) contient \(a_0 I_n\) et non le scalaire \(a_0\).
- Prendre pour sous-espace caractéristique le sous-espace propre, alors qu’il faut la puissance \(m_i\).
Fiche mémo
- \(P \mapsto P(u)\) est un morphisme d’algèbres ; deux polynômes en \(u\) commutent.
- Les annulateurs de \(u\) forment l’idéal \(\pi_u\,\mathbb{K}[X]\).
- Spectre de \(u\) inclus dans les racines d’un annulateur, et égal à l’ensemble des racines de \(\pi_u\).
- Lemme des noyaux : facteurs premiers entre eux, noyaux en somme directe, projecteurs polynomiaux en \(u\).
- Diagonalisable si et seulement si un annulateur est scindé à racines simples.
- Cayley-Hamilton : \(\chi_u(u) = 0\), donc \(\pi_u\) divise \(\chi_u\).
- Trigonalisable si et seulement si \(\chi_u\) est scindé ; toujours vrai sur \(\mathbb{C}\).
- Nilpotent d’indice \(p\) : \(\pi = X^p\), \(p \leqslant n\), \(\chi = X^n\).
- Sous-espaces caractéristiques : \(E = \bigoplus_i \ker(u – \lambda_i\,\mathrm{id})^{m_i}\), avec \(\dim = m_i\).
Questions fréquentes
Quelle différence entre polynôme annulateur et polynôme minimal ?
Un endomorphisme possède une infinité de polynômes annulateurs : tous les multiples de l’un d’eux en sont encore. Le polynôme minimal est le seul annulateur unitaire de plus petit degré. Il divise tous les autres, ce qui en fait l’annulateur le plus précis.
Pourquoi l'argument « on pose X = A dans le déterminant » ne prouve-t-il pas Cayley-Hamilton ?
Parce que ce raisonnement mélange deux objets. Le déterminant det(XI – A) est un polynôme scalaire, alors que l’on veut une égalité entre matrices. La preuve correcte passe par la comatrice de XI – A, ou bien par la trigonalisation sur les complexes.
Comment savoir vite si une matrice est diagonalisable avec un polynôme annulateur ?
Il suffit de trouver un polynôme annulateur scindé à racines simples. Si vous en connaissez un, la matrice est diagonalisable et ses valeurs propres font partie de ses racines. Si le polynôme minimal possède une racine multiple, la matrice ne l’est pas.
Toute matrice est-elle trigonalisable ?
Sur les complexes, oui, car tout polynôme caractéristique y est scindé. Sur les réels, une matrice est trigonalisable exactement quand son polynôme caractéristique est scindé sur R. Une rotation d’angle non multiple de pi n’est donc pas trigonalisable dans R.
Pour aller plus loin
- S’exercer : exercices corrigés de L2 de maths sur polynômes annulateurs
- Bases utiles : Diagonaliser une matrice et applications
- Chapitre d’avant : Diagonaliser une matrice et applications
- Chapitre d’après : Anneaux, idéaux, Z/nZ et chiffrement RSA
- Vérifier ses acquis : QCM de L2 de maths sur polynômes annulateurs
- Contrôle corrigé en temps limité : Lemme des noyaux et trigonalisation : contrôle de maths en L2
- Un autre sujet noté sur 20 : Partiel d'algèbre du semestre 3 : contrôle de maths en L2
- Tous les chapitres : le sommaire de la L2 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «polynômes annulateurs en L2 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.