Lois discrètes et espérance en L2 de maths : cours et méthodes
Ce chapitre installe les lois discrètes L2 sur des bases solides. Après l’univers dénombrable et la formule de Bayes, nous passons des événements aux variables aléatoires. Chaque loi usuelle naît ici d’un modèle concret : tirages avec ou sans remise, attente d’un premier succès, comptage d’événements rares.
Vous y trouverez la fonction de répartition, les lois binomiale, hypergéométrique, géométrique et de Poisson, puis l’espérance définie par une série absolument convergente. La formule de transfert et la linéarité donnent des calculs rapides, souvent grâce aux indicatrices. Viennent ensuite la variance et le moment factoriel.
Enfin, les inégalités de Markov et de Bienaymé-Tchebychev préparent la loi faible des grands nombres, traitée avec les couples au chapitre suivant.
Ce que vous saurez faire
- Décrire une variable aléatoire discrète par sa loi et par sa fonction de répartition.
- Reconnaître, à partir d’une expérience, une loi uniforme, de Bernoulli, binomiale, hypergéométrique, géométrique ou de Poisson.
- Justifier l’existence d’une espérance, puis la calculer par la formule de transfert.
- Exploiter la linéarité de l’espérance, en particulier avec des indicatrices.
- Calculer une variance par la formule de König-Huygens ou par un moment factoriel.
- Majorer une probabilité grâce aux inégalités de Markov et de Bienaymé-Tchebychev.
1. Variable aléatoire discrète et loi
Nous travaillons sur un espace probabilisé \((\Omega,\mathcal{A},P)\), construit au chapitre précédent. Une variable aléatoire sert à résumer une expérience par un nombre. Ainsi, on ne garde du lancer de trois pièces que le nombre de piles. On perd de l’information, mais on gagne un objet que l’on sait calculer.
Une variable aléatoire discrète est une application \(X:\Omega\to\mathbb{R}\) dont l’image \(X(\Omega)\) est finie ou dénombrable, et telle que \(\{X=x\}\in\mathcal{A}\) pour tout \(x\in X(\Omega)\). Sa loi est la donnée de la famille \(\big(P(X=x)\big)_{x\in X(\Omega)}\).
Les événements \(\{X=x\}\), pour \(x\) parcourant \(X(\Omega)\), forment un système complet. Par conséquent, la famille des \(P(X=x)\) est positive et de somme \(1\). Réciproquement, toute famille positive de somme \(1\), indexée par une partie dénombrable de \(\mathbb{R}\), est la loi d’au moins une variable. On peut donc définir une variable « par sa loi » sans décrire \(\Omega\).
Pour toute partie \(A\) de \(\mathbb{R}\), on a \(P(X\in A)=\displaystyle\sum_{x\in X(\Omega)\cap A}P(X=x)\). La somme est finie ou celle d’une série à termes positifs, donc son ordre ne compte pas.
1.1 Fonction de répartition
La loi est une liste de nombres. Cependant, il est souvent commode de la coder par une seule fonction de \(\mathbb{R}\) dans \([0,1]\).
On appelle fonction de répartition de \(X\) l’application \(F_X\) qui associe à chaque réel \(x\) le nombre \(P(X\leq x)\), élément de \([0,1]\).
Quatre faits décrivent \(F_X\). D’abord, elle ne décroît jamais. Ensuite, elle est continue en chaque point lorsqu’on s’en approche par la droite. De plus, elle tend vers \(0\) quand \(x\to-\infty\), vers \(1\) quand \(x\to+\infty\). Enfin, en chaque réel \(a\), l’écart entre \(F_X(a)\) et la limite à gauche \(F_X(a^-)\) mesure exactement \(P(X=a)\).
D’abord, si \(x\leq y\), l’inclusion \(\{X\leq x\}\subset\{X\leq y\}\) donne la croissance. Ensuite, pour \(x_n\) décroissant vers \(x\), les événements \(\{X\leq x_n\}\) décroissent et leur intersection est \(\{X\leq x\}\). La continuité décroissante de \(P\) donne alors la continuité à droite. Les limites en \(\pm\infty\) se traitent de la même façon. Enfin, pour \(t_n\) croissant strictement vers \(x\), la réunion des \(\{X\leq t_n\}\) vaut \(\{X<x\}\). On en déduit \(\lim F_X(t_n)=P(X<x)\), puis le saut \(P(X\leq x)-P(X<x)=P(X=x)\).
1.2 Lire une loi sur un escalier
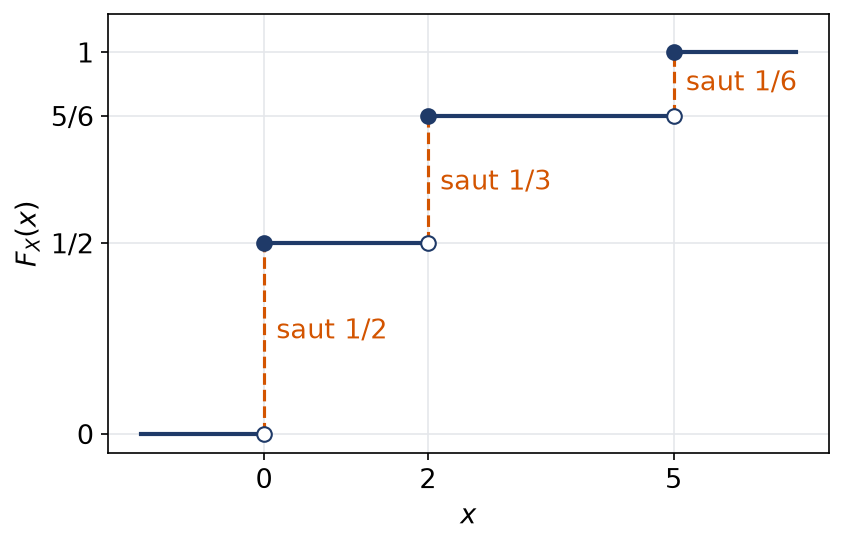
Une roue de loterie est partagée en trois secteurs d’angles \(180^\circ\), \(120^\circ\) et \(60^\circ\), qui rapportent respectivement \(0\), \(2\) et \(5\) points. Soit \(X\) le gain d’un lancer. La roue est équilibrée, donc la probabilité d’un secteur est proportionnelle à son angle. Ainsi \(P(X=0)=\frac12\), \(P(X=2)=\frac13\) et \(P(X=5)=\frac16\). On obtient une fonction en escalier : \(F_X(x)=0\) pour \(x<0\), puis \(\frac12\) sur \([0,2[\), puis \(\frac56\) sur \([2,5[\), enfin \(1\) pour \(x\geq 5\).
La figure suivante montre cet escalier. Chaque marche commence par un point plein, ce qui traduit la continuité à droite.
Piège à éviter :
On lit \(P(X=x)\) sur la hauteur du saut, et non sur la valeur \(F_X(x)\). Par exemple, \(F_X(2)=\frac56\) alors que \(P(X=2)=\frac13\). De même, \(P(X<2)\) vaut \(\frac12\) et non \(\frac56\).
2. Lois discrètes finies construites à partir de modèles
Une loi usuelle n’est pas une formule à apprendre par cœur. C’est d’abord un modèle d’expérience. Nous construisons donc chaque loi à partir de la situation qui la fait naître. Les paramètres apparaissent alors naturellement.
2.1 Lois uniforme et de Bernoulli
Soit \(E\) un ensemble fini non vide. La variable \(X\) suit la loi uniforme sur \(E\) si \(P(X=x)=\frac{1}{\operatorname{card}E}\) pour tout \(x\in E\). Soit ensuite \(p\in[0,1]\). La variable \(X\) suit la loi de Bernoulli \(\mathcal{B}(p)\) si \(X(\Omega)\subset\{0,1\}\) et \(P(X=1)=p\).
La loi uniforme modélise un tirage « au hasard » sans préférence. La loi de Bernoulli code un succès par \(1\) et un échec par \(0\). En particulier, pour tout événement \(A\), l’indicatrice \(\mathbf{1}_A\) suit la loi \(\mathcal{B}(P(A))\). Cette remarque, banale en apparence, servira sans cesse pour l’espérance.
2.2 Loi binomiale : tirages avec remise
On répète \(n\) fois, de façon indépendante, une épreuve de Bernoulli de paramètre \(p\). Le nombre \(X\) de succès suit la loi binomiale \(\mathcal{B}(n,p)\) : pour tout \(k\in[\![0,n]\!]\),
\[P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}.\]
Fixons \(k\). Une issue réalisant \(\{X=k\}\) est décrite par la liste des rangs des \(k\) succès. Il y a \(\binom{n}{k}\) telles listes, et les événements correspondants sont deux à deux incompatibles. Par indépendance, chacun a pour probabilité \(p^k(1-p)^{n-k}\). On somme, ce qui donne la formule. Enfin, la formule du binôme confirme que la somme des probabilités vaut \((p+1-p)^n=1\).
2.3 Loi hypergéométrique : tirages sans remise
Supposons maintenant que l’on tire simultanément \(n\) objets dans une population de \(N\) objets, dont \(K\) sont marqués. Les tirages ne sont plus indépendants. En effet, chaque objet marqué tiré rend le suivant moins probable.
Soient \(N\geq 1\), \(K\in[\![0,N]\!]\) et \(n\in[\![0,N]\!]\). Le nombre \(X\) d’objets marqués dans un tirage simultané de \(n\) objets suit la loi hypergéométrique \(\mathcal{H}(n,K,N)\) :
\[P(X=k)=\frac{\binom{K}{k}\binom{N-K}{n-k}}{\binom{N}{n}}.\]
Ici \(k\) varie entre \(\max(0,n-N+K)\) et \(\min(n,K)\), et l’on convient que \(\binom{a}{b}=0\) hors de \([\![0,a]\!]\). La preuve est un simple dénombrement : on choisit \(k\) objets parmi les marqués et \(n-k\) parmi les autres, sous l’hypothèse d’équiprobabilité des \(\binom{N}{n}\) tirages.
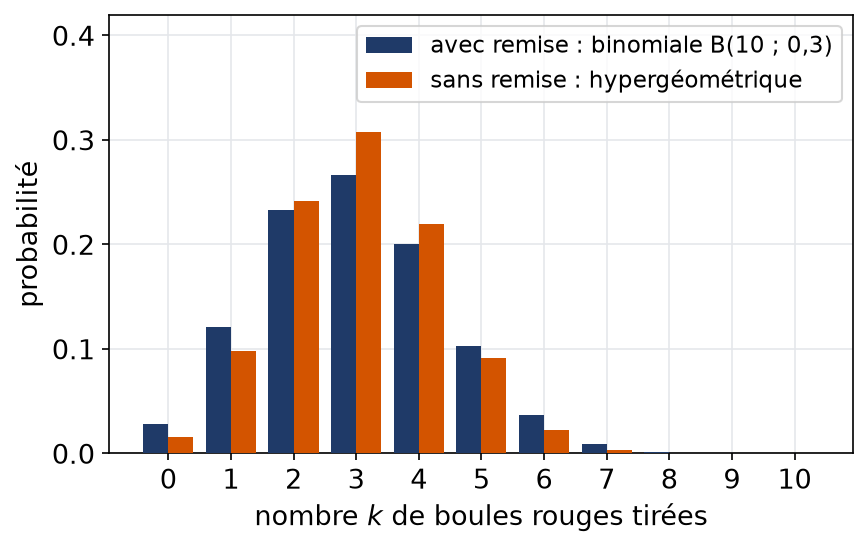
Une urne contient \(40\) boules dont \(12\) rouges. On en extrait \(10\). Avec remise, le nombre de rouges suit \(\mathcal{B}(10\,;\,0{,}3)\). Sans remise, il suit \(\mathcal{H}(10,12,40)\). Les deux lois ont la même moyenne \(3\), mais la seconde est plus resserrée autour de \(3\). Intuitivement, le tirage sans remise « corrige » les écarts : après plusieurs rouges, il en reste moins dans l’urne.
La figure compare les deux diagrammes en bâtons. On y voit nettement que la loi sans remise charge davantage les valeurs centrales.
Pour identifier une loi finie, on répond à trois questions dans l’ordre.
- Que compte-t-on ? Une seule épreuve à deux issues mène à Bernoulli ; un résultat « au hasard » parmi des valeurs équiprobables mène à la loi uniforme.
- Compte-t-on des succès sur un nombre fixé d’épreuves ? Si les épreuves sont indépendantes et de même paramètre, la loi est binomiale.
- Les tirages se font-ils sans remise dans une population finie ? Dans ce cas, la loi est hypergéométrique.
Enfin, on précise toujours les paramètres et l’ensemble des valeurs.
3. Lois géométrique et de Poisson
Les deux lois de cette partie prennent une infinité de valeurs. Leur étude repose donc sur les séries, en particulier la série géométrique et la série exponentielle.
3.1 Rang du premier succès
On répète indéfiniment, de façon indépendante, une épreuve de Bernoulli de paramètre \(p\in\,]0,1[\), et l’on pose \(q=1-p\). Le rang \(X\) du premier succès suit la loi géométrique \(\mathcal{G}(p)\) : pour tout \(k\in\mathbb{N}^*\), \(P(X=k)=q^{k-1}p\). De plus, \(P(X>k)=q^k\).
L’événement \(\{X=k\}\) signifie : échecs aux \(k-1\) premières épreuves, puis succès à la \(k\)-ième. Par indépendance, sa probabilité vaut \(q^{k-1}p\). De même, \(\{X>k\}\) signifie « \(k\) échecs d’abord », d’où \(q^k\). Notons enfin que \(\sum_{k\geq1}q^{k-1}p=\frac{p}{1-q}=1\). Ainsi, la probabilité de n’obtenir jamais de succès est nulle.
La loi géométrique possède une propriété remarquable. Pour tous entiers \(n,m\geq 0\), on a
\[P(X>n+m\mid X>n)=\frac{q^{n+m}}{q^n}=q^m=P(X>m).\]
Autrement dit, avoir attendu \(n\) épreuves sans succès ne rapproche pas du succès. On parle d’absence de mémoire. Un exercice montre que cette propriété caractérise les lois géométriques parmi les lois sur \(\mathbb{N}^*\).
Remarque :
Une autre convention compte le nombre d’échecs avant le premier succès, à valeurs dans \(\mathbb{N}\). Il s’agit alors de \(X-1\). Dans un énoncé, on vérifie donc toujours si la valeur \(0\) est possible.
3.2 Loi de Poisson, loi des événements rares
Fixons un réel \(\lambda>0\). Une variable \(X\) à valeurs entières naturelles obéit à la loi de Poisson \(\mathcal{P}(\lambda)\) lorsque \(P(X=k)=e^{-\lambda}\dfrac{\lambda^k}{k!}\) pour tout \(k\in\mathbb{N}\).
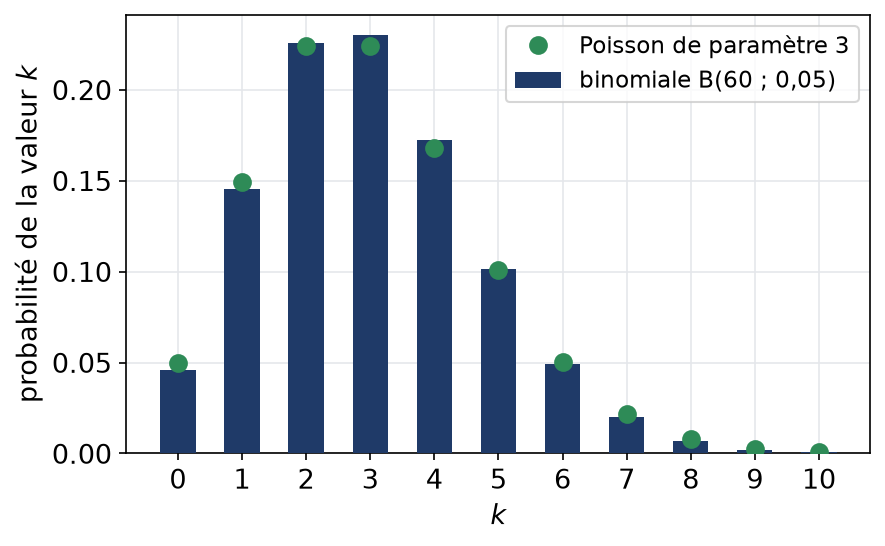
La somme vaut bien \(e^{-\lambda}e^{\lambda}=1\). D’où vient cette loi ? Elle décrit le nombre d’occurrences d’un phénomène rare parmi un très grand nombre d’essais. Le théorème suivant rend cette idée précise.
Soit \((p_n)\) une suite de \(]0,1[\) telle que \(np_n\to\lambda>0\). Si \(X_n\) suit \(\mathcal{B}(n,p_n)\), alors pour tout \(k\in\mathbb{N}\), \(P(X_n=k)\to e^{-\lambda}\dfrac{\lambda^k}{k!}\).
Fixons \(k\) et prenons \(n\geq k\). On écrit
\[P(X_n=k)=\frac{n(n-1)\cdots(n-k+1)}{n^k}\cdot\frac{(np_n)^k}{k!}\cdot(1-p_n)^{n-k}.\]
D’abord, la première fraction regroupe \(k\) quotients \(\frac{n-i}{n}\), chacun de limite \(1\). Ensuite, le deuxième tend vers \(\frac{\lambda^k}{k!}\). Enfin, \(p_n\to0\), donc \(n\ln(1-p_n)\sim -np_n\to-\lambda\), et \((1-p_n)^{-k}\to1\). Par conséquent, le troisième facteur tend vers \(e^{-\lambda}\).
Concrètement, beaucoup d’essais et un succès rare autorisent à substituer \(\mathcal{P}(np)\) à \(\mathcal{B}(n,p)\). Le graphique ci-dessous traite le cas \(n=60\), \(p=0{,}05\) : les points de la loi de Poisson de paramètre \(3\) touchent presque le haut des bâtons.
4. Espérance d’une variable discrète
L’espérance est la moyenne des valeurs de \(X\), pondérées par leurs probabilités. Pour une variable finie, c’est une somme finie. En revanche, pour une variable à valeurs dans un ensemble infini, c’est une série, et elle peut diverger. De plus, une série semi-convergente dépend de l’ordre de sommation. C’est pourquoi la définition exige la convergence absolue.
Lorsque \(\sum_{x}|x|\,P(X=x)\) est finie, la variable \(X\) possède une espérance, à savoir le nombre
\[E(X)=\sum_{x\in X(\Omega)}x\,P(X=x).\]
Si \(X\) est positive, la somme a toujours un sens dans \([0,+\infty]\).
Soit \(X\) à valeurs dans \(\mathbb{N}^*\) avec \(P(X=k)=\frac{1}{k(k+1)}\). Ces nombres sont positifs et la somme télescopique \(\sum\big(\frac1k-\frac{1}{k+1}\big)\) vaut \(1\). C’est donc bien une loi. Pourtant, \(k\,P(X=k)=\frac{1}{k+1}\) est le terme d’une série divergente. Ainsi, \(X\) prend des valeurs finies mais n’admet pas d’espérance.
4.1 Calculs d’espérance commentés
Pour les lois finies, les calculs sont directs. Par exemple, la loi uniforme sur \([\![1,n]\!]\) a pour espérance \(\frac{n+1}{2}\), et \(\mathcal{B}(p)\) a pour espérance \(p\). Les lois infinies demandent un peu plus de soin.
Soit \(X\) de loi \(\mathcal{G}(p)\). La série entière \(\sum kx^{k-1}\) a pour rayon \(1\) et pour somme \(\frac{1}{(1-x)^2}\) sur \(]-1,1[\). Comme \(q\in\,]0,1[\), la série positive \(\sum kq^{k-1}p\) converge, donc \(X\) admet une espérance, et
\[E(X)=p\sum_{k=1}^{+\infty}kq^{k-1}=\frac{p}{(1-q)^2}=\frac1p.\]
Ce résultat est intuitif : si un succès a une chance sur huit, on l’attend en moyenne au huitième essai.
Pour la loi de Poisson, on décale l’indice. En effet, \(k\,\frac{\lambda^k}{k!}=\lambda\,\frac{\lambda^{k-1}}{(k-1)!}\) pour \(k\geq1\), donc \(E(X)=\lambda\). Le paramètre de la loi de Poisson est donc sa moyenne.
4.2 Formule de transfert
On veut souvent l’espérance de \(f(X)\), par exemple de \(X^2\) ou de \(\frac{1}{X+1}\). Il serait pénible de chercher d’abord la loi de \(f(X)\). Heureusement, le théorème suivant l’évite.
Formule de transfert. Prenons une fonction réelle \(f\) définie sur \(X(\Omega)\). Pour que \(f(X)\) ait une espérance, il faut et il suffit que \(\sum_x|f(x)|\,P(X=x)\) soit finie. On calcule alors directement
\[E\big(f(X)\big)=\sum_{x\in X(\Omega)}f(x)\,P(X=x).\]
Posons \(Y=f(X)\). Pour \(y\in Y(\Omega)\), l’événement \(\{Y=y\}\) est la réunion disjointe des \(\{X=x\}\) pour \(x\) tel que \(f(x)=y\). On regroupe donc les termes \(f(x)P(X=x)\) selon la valeur \(y=f(x)\). Le théorème de sommation par paquets, valable pour une famille positive ou sommable, donne exactement \(\sum_y y\,P(Y=y)\). On l’applique d’abord à \(|f|\) pour la sommabilité, puis à \(f\).
Pour calculer \(E(f(X))\) par transfert :
- écrire la série \(\sum f(k)P(X=k)\) ;
- prouver la convergence absolue, souvent par comparaison ou en reconnaissant une série connue ;
- reconnaître une série géométrique, exponentielle ou une de leurs dérivées, puis conclure.
Soit \(X\) de loi \(\mathcal{P}(\lambda)\). Calculons \(E(2^X)\). La série \(\sum 2^ke^{-\lambda}\frac{\lambda^k}{k!}\) est positive et vaut \(e^{-\lambda}e^{2\lambda}\). Donc \(2^X\) admet une espérance et \(E(2^X)=e^{\lambda}\). On remarque que \(E(2^X)\) diffère de \(2^{E(X)}=2^\lambda\). En effet, \(e^\lambda>2^\lambda\) dès que \(\lambda>0\).
4.3 Linéarité et positivité
L’ensemble des variables discrètes admettant une espérance est un espace vectoriel, et \(E\) y est linéaire. De plus, \(E\) est positive : si \(X\geq0\), alors \(E(X)\geq0\). Elle est donc croissante : si \(X\leq Y\), alors \(E(X)\leq E(Y)\).
Nous admettons ici la linéarité pour deux variables quelconques, dont la preuve utilise le couple \((X,Y)\), étudié au chapitre suivant. Le cas \(E(aX+b)=aE(X)+b\) découle, lui, directement du transfert. La linéarité est un outil redoutable avec les indicatrices. Par exemple, si \(X=\mathbf{1}_{A_1}+\cdots+\mathbf{1}_{A_n}\), alors \(E(X)=P(A_1)+\cdots+P(A_n)\), même si les événements sont dépendants.
Reprenons \(X\) de loi \(\mathcal{H}(n,K,N)\). Numérotons les objets marqués de \(1\) à \(K\), et notons \(A_i\) l’événement « l’objet marqué \(i\) est tiré ». Par symétrie, \(P(A_i)=\frac{n}{N}\). Comme \(X=\sum_{i=1}^K\mathbf{1}_{A_i}\), on obtient \(E(X)=\frac{nK}{N}\) sans aucun calcul de somme. On retrouve la moyenne \(np\) de la binomiale, avec \(p=\frac KN\).
De la même manière, une variable de loi \(\mathcal{B}(n,p)\) compte les succès de \(n\) épreuves. C’est donc une somme de \(n\) indicatrices de paramètre \(p\), et son espérance vaut \(np\).
5. Variance et écart type
Deux variables peuvent avoir la même moyenne et des comportements très différents. Par exemple, gagner \(0\) ou \(100\) avec probabilité \(\frac12\) n’a rien à voir avec gagner \(50\) à coup sûr. La variance mesure cette dispersion autour de la moyenne.
On dit que \(X\) admet un moment d’ordre 2 si \(X^2\) admet une espérance. Dans ce cas, \(X\) admet une espérance, et l’on définit la variance et l’écart type :
\[V(X)=E\big((X-E(X))^2\big),\qquad \sigma(X)=\sqrt{V(X)}.\]
L’existence de \(E(X)\) vient de l’inégalité \(|x|\leq\frac{1+x^2}{2}\). Ensuite, l’écart type a l’avantage d’avoir la même unité que \(X\). Ainsi, si \(X\) est une durée en minutes, \(\sigma(X)\) s’exprime aussi en minutes.
Si \(X\) admet un moment d’ordre 2, alors :
- formule de König-Huygens : \(V(X)=E(X^2)-E(X)^2\) ;
- pour tous réels \(a,b\), \(V(aX+b)=a^2V(X)\) ;
- \(V(X)=0\) si et seulement si \(X\) est presque sûrement constante.
Notons \(m=E(X)\). On développe \((X-m)^2=X^2-2mX+m^2\), puis on applique la linéarité : \(V(X)=E(X^2)-2m^2+m^2\). Ensuite, \(aX+b-E(aX+b)=a(X-m)\), d’où le facteur \(a^2\). Enfin, si \(V(X)=0\), la série positive \(\sum(x-m)^2P(X=x)\) est nulle. Chaque terme est donc nul, et \(P(X=x)=0\) pour tout \(x\neq m\).
Piège à éviter :
La constante \(b\) disparaît et le coefficient \(a\) sort au carré. Ainsi \(V(-3X+7)=9V(X)\), et non \(-3V(X)+7\). Une variance négative signale toujours une erreur de calcul.
5.1 Le moment factoriel, raccourci pour les lois infinies
Pour les lois géométrique et de Poisson, \(E(X^2)\) se calcule mal directement. En revanche, \(E\big(X(X-1)\big)\) fait apparaître une dérivée seconde ou un décalage d’indice. On écrit ensuite \(E(X^2)=E\big(X(X-1)\big)+E(X)\).
Soit \(X\) de loi \(\mathcal{P}(\lambda)\). Par transfert, avec \(k(k-1)\frac{\lambda^k}{k!}=\lambda^2\frac{\lambda^{k-2}}{(k-2)!}\) pour \(k\geq2\), on trouve \(E\big(X(X-1)\big)=\lambda^2\). Donc \(E(X^2)=\lambda^2+\lambda\), et finalement
\[V(X)=\lambda^2+\lambda-\lambda^2=\lambda.\]
Pour une loi de Poisson, moyenne et variance coïncident. C’est un test simple pour juger si des données de comptage sont compatibles avec ce modèle.
Pour \(\mathcal{G}(p)\), la dérivée seconde \(\sum k(k-1)x^{k-2}=\frac{2}{(1-x)^3}\) donne \(E\big(X(X-1)\big)=\frac{2q}{p^2}\). Par conséquent, \(V(X)=\frac{2q}{p^2}+\frac1p-\frac1{p^2}=\frac{q}{p^2}\).
Tableau des lois usuelles, avec \(q=1-p\) :
- uniforme sur \([\![1,n]\!]\) : \(E=\frac{n+1}{2}\), \(V=\frac{n^2-1}{12}\) ;
- \(\mathcal{B}(p)\) : \(E=p\), \(V=pq\) ;
- \(\mathcal{B}(n,p)\) : \(E=np\), \(V=npq\) ;
- \(\mathcal{H}(n,K,N)\) avec \(p=\frac KN\) : \(E=np\), \(V=npq\,\frac{N-n}{N-1}\) ;
- \(\mathcal{G}(p)\) : \(E=\frac1p\), \(V=\frac{q}{p^2}\) ;
- \(\mathcal{P}(\lambda)\) : \(E=V=\lambda\).
La variance de la binomiale se retrouve par le moment factoriel : \(E\big(X(X-1)\big)=n(n-1)p^2\), d’où \(V(X)=n(n-1)p^2+np-n^2p^2=npq\). Le facteur \(\frac{N-n}{N-1}\) de la loi hypergéométrique est inférieur à \(1\). Il confirme la concentration observée sur la deuxième figure.
6. Majorer une probabilité : Markov et Bienaymé-Tchebychev
Connaître la loi exacte n’est pas toujours possible. Souvent, on ne dispose que de la moyenne, voire de la variance. Les deux inégalités suivantes suffisent pourtant à contrôler les grandes valeurs.
6.1 Les deux inégalités et leurs preuves
Inégalité de Markov. Si \(X\) est positive et admet une espérance, alors pour tout \(a>0\),
\[P(X\geq a)\leq\frac{E(X)}{a}.\]
On compare deux variables : \(a\,\mathbf{1}_{\{X\geq a\}}\leq X\). Sur l’événement \(\{X\geq a\}\), l’indicatrice vaut \(1\) et l’on compare \(a\) à \(X\). Ailleurs, elle est nulle, et \(X\) reste positive. La croissance de l’espérance donne \(a\,P(X\geq a)\leq E(X)\).
Inégalité de Bienaymé-Tchebychev. Supposons que \(X^2\) soit d’espérance finie. Pour chaque réel \(t>0\), on dispose alors de la majoration
\[P\big(|X-E(X)|\geq t\big)\leq\frac{V(X)}{t^2}.\]
Les événements \(\{|X-E(X)|\geq t\}\) et \(\{(X-E(X))^2\geq t^2\}\) sont égaux. On applique alors Markov à la variable positive \((X-E(X))^2\), dont l’espérance est \(V(X)\), avec \(a=t^2\).
6.2 Majorer une probabilité en pratique
Le nombre \(X\) de colis reçus par heure dans un dépôt a pour moyenne \(40\) et pour écart type \(5\). Majorons la probabilité de recevoir au moins \(60\) colis. Avec Markov, \(P(X\geq60)\leq\frac{40}{60}=\frac23\), ce qui est peu informatif. Avec Tchebychev, \(\{X\geq60\}\subset\{|X-40|\geq20\}\), donc \(P(X\geq60)\leq\frac{25}{400}=\frac{1}{16}\). L’information sur la variance améliore nettement la borne.
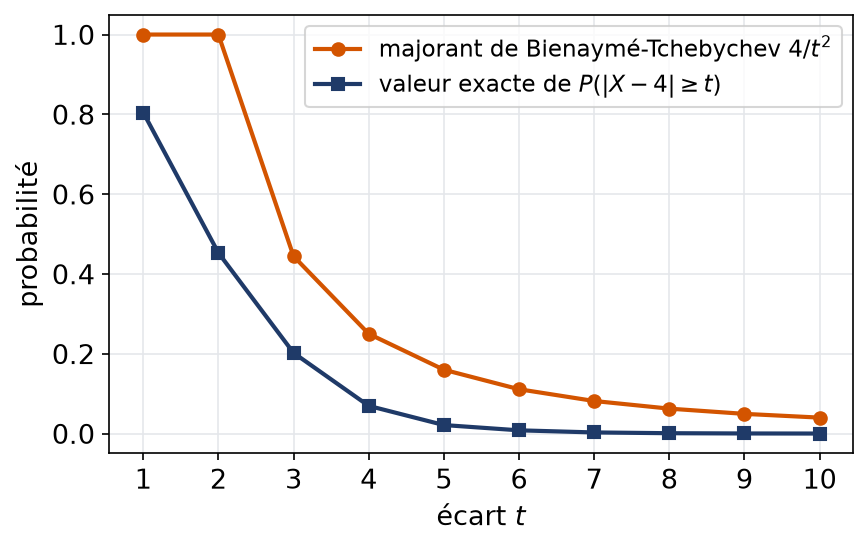
Ces bornes sont universelles, donc souvent larges. La figure compare, pour \(X\) de loi \(\mathcal{P}(4)\), la probabilité exacte d’un écart d’au moins \(t\) et le majorant \(\frac{4}{t^2}\).
Remarque :
On ne peut cependant pas améliorer ces inégalités sans hypothèse supplémentaire. Un exercice exhibe des variables pour lesquelles il y a égalité.
Les erreurs fréquentes
- Lire \(P(X=x)\) sur la valeur \(F_X(x)\) au lieu de la hauteur du saut.
- Choisir la loi binomiale pour des tirages sans remise : la loi correcte est hypergéométrique.
- Calculer une espérance infinie sans justifier la convergence absolue de la série.
- Écrire \(E(f(X))=f(E(X))\), qui est faux dès que \(f\) n’est pas affine.
- Oublier le carré dans \(V(aX+b)=a^2V(X)\), ou garder la constante \(b\).
- Appliquer Markov à une variable qui n’est pas positive.
Fiche mémo
- La loi de \(X\) est la famille des \(P(X=x)\), positive et de somme \(1\).
- \(F_X\) est croissante, continue à droite, et ses sauts donnent la loi.
- Avec remise : loi binomiale ; sans remise : loi hypergéométrique.
- Premier succès : \(\mathcal{G}(p)\), avec \(P(X>k)=q^k\) et absence de mémoire.
- Événements rares : \(\mathcal{B}(n,p)\) proche de \(\mathcal{P}(np)\).
- Espérance : série absolument convergente ; transfert \(E(f(X))=\sum f(x)P(X=x)\).
- Linéarité : on décompose une variable de comptage en indicatrices.
- \(V(X)=E(X^2)-E(X)^2\), et \(E(X^2)=E(X(X-1))+E(X)\).
- Markov : \(P(X\geq a)\leq\frac{E(X)}{a}\) pour \(X\geq0\).
- Tchebychev : \(P(|X-E(X)|\geq t)\leq\frac{V(X)}{t^2}\).
Questions fréquentes
Comment savoir si une variable suit une loi binomiale ou hypergéométrique ?
Tout dépend du mode de tirage. Si les épreuves sont indépendantes et de même probabilité de succès, par exemple des tirages avec remise, la loi est binomiale. Si l’on tire sans remise dans une population finie, les tirages s’influencent et la loi est hypergéométrique. Les deux lois ont la même espérance, mais la variance hypergéométrique est plus petite.
Pourquoi exige-t-on la convergence absolue pour définir l'espérance ?
Une variable discrète peut prendre une infinité de valeurs sans ordre naturel. Avec une série seulement semi-convergente, la somme dépendrait de l’ordre choisi, ce qui n’a pas de sens. La convergence absolue garantit une valeur indépendante de l’ordre. Pour une variable positive, on peut toujours parler d’espérance, éventuellement infinie.
Quand faut-il utiliser Markov plutôt que Bienaymé-Tchebychev ?
L’inégalité de Markov ne demande que la positivité et l’espérance. Celle de Bienaymé-Tchebychev demande la variance, mais donne en général une borne bien meilleure pour les écarts à la moyenne. Si l’énoncé fournit la variance, on essaie donc d’abord Tchebychev.
La loi de Poisson remplace-t-elle toujours la loi binomiale ?
Non, il s’agit seulement d’une approximation. Elle devient fiable avec beaucoup d’essais, chacun rarement réussi, et une moyenne np de quelques unités. Sinon, on conserve la loi binomiale exacte, que l’on sait toujours calculer.
Pour aller plus loin
- S’exercer : exercices corrigés de L2 de maths sur lois discrètes et espérance
- Bases utiles : Probabilités sur un univers dénombrable, Séries positives : Riemann, Bertrand et comparaison
- Chapitre d’avant : Probabilités sur un univers dénombrable
- Chapitre d’après : Couples de variables, indépendance et grands nombres
- Vérifier ses acquis : QCM de L2 de maths sur lois discrètes et espérance
- Contrôle corrigé en temps limité : Lois usuelles et calculs d'espérance : contrôle de maths en L2
- Un autre sujet noté sur 20 : Partiel de probabilités discrètes : contrôle de maths en L2
- Le même thème en maths spé (MP) : Espérance, variance et covariance d'une variable discrète
- Le même thème en maths sup (MPSI) : Variables aléatoires finies, espérance et variance
- Tous les chapitres : le sommaire de la L2 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «lois discrètes et espérance en L2 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.