Espérance, variance et covariance en maths spé (MP) : cours et méthodes

Ce chapitre de probabilités du second semestre étudie les moments d’une variable aléatoire discrète. Ce cours d’espérance variance MP commence par les variables positives, dont l’espérance vit dans [0, +∞], et par la formule des queues. Il passe ensuite aux variables d’espérance finie et à la formule de transfert.
Nous établissons l’inégalité de Cauchy-Schwarz, puis la variance et l’écart type, avec les moments des lois géométrique et de Poisson. La dernière partie traite la covariance et la variance d’une somme de variables dépendantes, outil central des exercices de comptage. Un fil rouge parcourt tout le chapitre : les justifications d’existence que les correcteurs exigent. Le chapitre suivant s’appuiera sur ces moments pour établir l’inégalité de Bienaymé-Tchebychev et la loi faible.
Ce que vous saurez faire
- Justifier proprement l’existence d’une espérance, comme l’exigent les correcteurs.
- Calculer l’espérance d’une variable entière par la formule des queues.
- Utiliser la formule de transfert pour obtenir l’espérance de \(f(X)\) sans chercher la loi de \(f(X)\).
- Retrouver en quelques lignes les deux premiers moments des lois géométrique et de Poisson.
- Calculer une covariance, puis la variance d’une somme de variables dépendantes.
- Exploiter l’inégalité de Cauchy-Schwarz pour borner une covariance ou une probabilité.
Nous travaillons sur un espace probabilisé \((\Omega,\mathcal{A},P)\) fixé. Toutes les variables considérées sont discrètes : chacune prend un nombre fini ou dénombrable de valeurs, rassemblées dans \(X(\Omega)\).
1. Espérance d’une variable positive, à valeurs dans [0, +∞]
On commence par les variables positives. Pour elles, l’espérance existe toujours, quitte à valoir \(+\infty\). C’est le cadre le plus confortable, car toutes les sommes portent sur des termes positifs.
Pour une variable discrète \(X\) qui prend ses valeurs dans \([0,+\infty]\), on définit l’espérance \(E(X)\) comme la somme, éventuellement infinie, des nombres positifs \(x\,P(X=x)\), où \(x\) parcourt \(X(\Omega)\). On adopte la convention \(0\times(+\infty)=0\) et \(+\infty\times P(X=+\infty)=+\infty\) si cette probabilité est non nulle.
Comme la famille est positive, l’ordre de sommation ne compte pas. De plus, on peut regrouper les termes par paquets comme on le souhaite. Ces deux libertés rendent les calculs souples.
1.1 La formule des queues
Soit \(X\) une variable dont les valeurs sont des entiers naturels, ou éventuellement \(+\infty\). On a alors, dans \([0,+\infty]\) :
\[E(X)=\sum_{k\geq 1}P(X\geq k).\]
Traitons d’abord le cas où \(X\) est presque sûrement finie. Chaque queue se décompose en \(P(X\geq k)=\sum_{j=k}^{+\infty}P(X=j)\). On obtient une somme double de termes positifs, que l’on peut donc réorganiser librement. Or le terme \(P(X=j)\) intervient pour \(k=1,\dots,j\), c’est-à-dire exactement \(j\) fois. La somme vaut donc \(\sum_j j\,P(X=j)\), qui est \(E(X)\). Si au contraire \(P(X=+\infty)=c>0\), alors \(P(X\geq n)\geq c\) pour tout \(n\). Les deux membres valent alors \(+\infty\).
Géométriquement, \(E(X)\) est l’aire d’un escalier dont la marche numéro \(n\) a pour hauteur \(P(X\geq n)\).
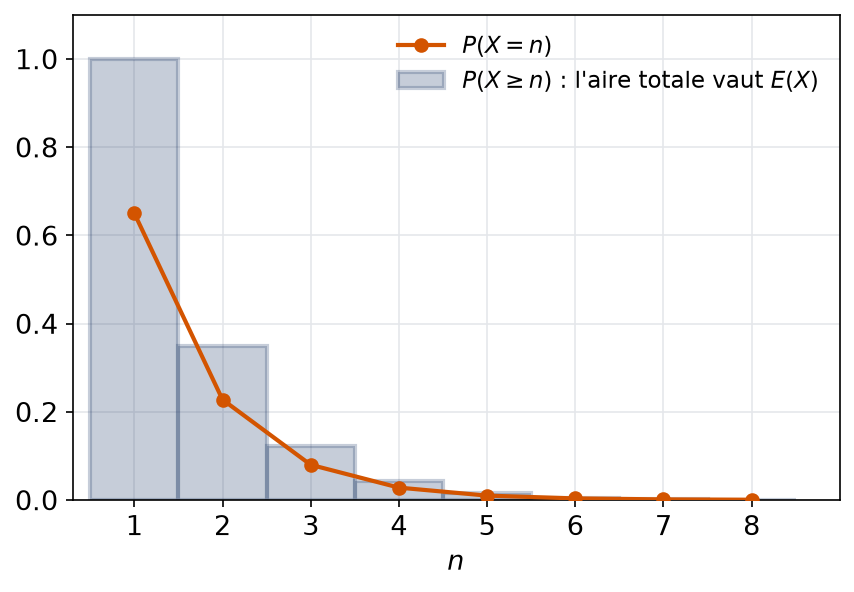
Soit \(U\) et \(V\) indépendantes, de lois géométriques de paramètres \(0{,}3\) et \(0{,}5\). On cherche l’espérance de \(X=\min(U,V)\).
- Pour \(n\geq 1\), l’événement \((X\geq n)\) est l’intersection de \((U\geq n)\) et \((V\geq n)\).
- Par indépendance, \(P(X\geq n)=0{,}7^{\,n-1}\times 0{,}5^{\,n-1}=0{,}35^{\,n-1}\).
- La formule des queues donne alors une série géométrique : \(E(X)=\sum_{n\geq 1}0{,}35^{\,n-1}=\frac{1}{0{,}65}=\frac{20}{13}\).
Piège à éviter :
La somme commence à \(n=1\), pas à \(n=0\). En effet, le terme \(P(X\geq 0)\) vaut \(1\) et fausserait le résultat d’une unité. Par ailleurs, la formule ne s’applique qu’aux variables à valeurs entières positives.
1.2 Règles de calcul dans [0, +∞]
Les variables positives se manipulent sans précaution particulière, car aucune compensation de signe ne peut se produire. Retenons les trois règles suivantes.
Soit \(X\) et \(Y\) deux variables discrètes positives et \(\alpha\geq 0\). D’abord, \(E(X+\alpha Y)=E(X)+\alpha E(Y)\) dans \([0,+\infty]\). Ensuite, si \(X\leq Y\), alors \(E(X)\leq E(Y)\). Enfin, \(E(X)=0\) si et seulement si \(X\) est nulle presque sûrement.
La dernière règle mérite une justification. Si \(E(X)=0\), chaque terme \(x\,P(X=x)\) est nul, car c’est un terme positif d’une somme nulle. Ainsi \(P(X=x)=0\) dès que \(x>0\), ce qui signifie \(P(X=0)=1\). Cette remarque servira pour la variance : une variance nulle caractérise les variables presque sûrement constantes.
2. Variables d’espérance finie et formule de transfert
Pour une variable de signe quelconque, ou complexe, il faut cette fois une hypothèse de convergence. Sans elle, la somme pourrait dépendre de l’ordre des termes.
Une variable discrète \(X\), réelle ou complexe, est d’espérance finie si la famille \(\big(x\,P(X=x)\big)_{x\in X(\Omega)}\) est sommable, autrement dit si \(E(|X|)<+\infty\). Son espérance est alors la somme \(E(X)=\sum_{x}x\,P(X=x)\).
Formule de transfert. Soit \(f\) une fonction définie sur \(X(\Omega)\). Pour que \(f(X)\) admette une espérance, il faut et il suffit que la famille \(\big(f(x)\,P(X=x)\big)_x\) soit sommable. On a alors :
\[E\big(f(X)\big)=\sum_{x\in X(\Omega)}f(x)\,P(X=x).\]
Cette formule évite de déterminer la loi de \(f(X)\), souvent pénible. Elle s’étend aux couples : pour \(g(X,Y)\), on somme \(g(x,y)\,P(X=x,Y=y)\) sur toutes les valeurs du couple.
Sur les variables d’espérance finie, l’espérance est linéaire. Elle est aussi positive : si \(X\geq 0\), alors \(E(X)\geq 0\). Elle est enfin croissante : si \(X\leq Y\), alors \(E(X)\leq E(Y)\). De plus, si \(|X|\leq Y\) avec \(Y\) d’espérance finie, alors \(X\) est d’espérance finie.
2.1 Justifier l’existence d’une espérance
Le cas des variables positives est simple : on calcule, puis on constate que le résultat est fini. Pour une variable de signe quelconque, il faut au contraire établir la sommabilité avant tout calcul.
- On écrit la famille à sommer, \(|x|\,P(X=x)\) ou \(|f(x)|\,P(X=x)\), avec ses valeurs explicites.
- On étudie sa convergence comme une série à termes positifs : équivalent, comparaison à une série de Riemann, règle de d’Alembert.
- Si \(X\) est bornée, on conclut directement : une variable bornée est d’espérance finie.
- Sinon, on cherche une domination \(|X|\leq Y\) par une variable dont on connaît l’espérance.
- On rédige la conclusion avant tout calcul : « la famille est sommable, donc \(X\) admet une espérance ».
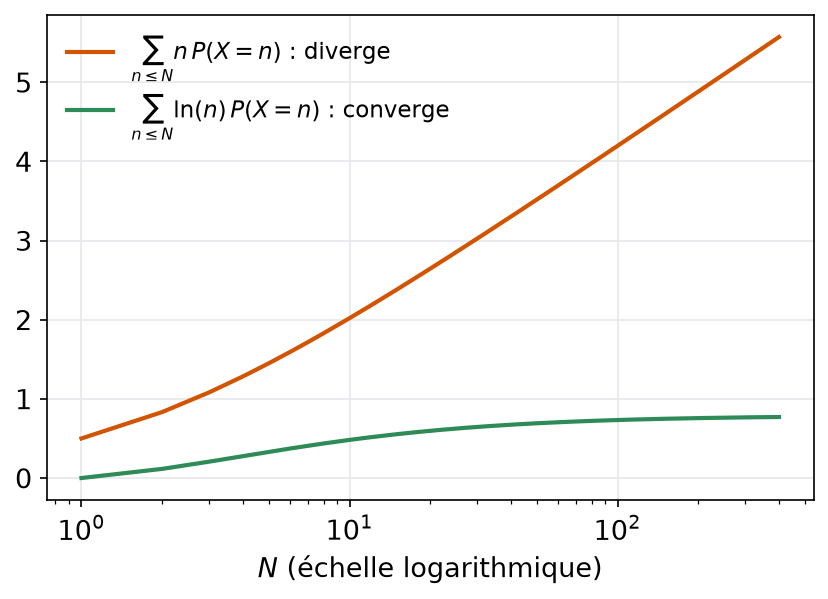
Soit \(X\) à valeurs dans \(\mathbb{N}^{*}\), avec \(P(X=n)=\frac{1}{n(n+1)}\). On vérifie d’abord que c’est une loi : le nombre \(\frac{1}{n}-\frac{1}{n+1}\) vaut exactement \(P(X=n)\), et la somme télescopique vaut \(1\).
- Ensuite, \(n\,P(X=n)=\frac{1}{n+1}\) est le terme d’une série divergente. Donc \(E(X)=+\infty\) : la variable positive \(X\) n’est pas d’espérance finie.
- En revanche, \(\ln(n)\,P(X=n)\leq\frac{\ln n}{n^2}\), et \(\frac{\ln n}{n^2}=o\big(n^{-3/2}\big)\). Par comparaison à une série de Riemann convergente, \(\ln X\) est d’espérance finie.
Soit \(X\) de loi géométrique \(\mathcal{G}(p)\), avec \(0<p<1\) et \(q=1-p\). On cherche l’espérance de \(\frac{1}{X}\).
- Existence : la variable \(\frac{1}{X}\) est à valeurs dans \(]0,1]\), donc bornée. Elle admet ainsi une espérance, sans aucun calcul.
- Transfert : \(E\big(\frac{1}{X}\big)=\sum_{k\geq 1}\frac{1}{k}\,pq^{k-1}=\frac{p}{q}\sum_{k\geq 1}\frac{q^k}{k}\).
- Série connue : pour \(|x|<1\), \(\sum_{k\geq 1}\frac{x^k}{k}=-\ln(1-x)\). Avec \(x=q\), on obtient \(E\big(\frac{1}{X}\big)=-\frac{p\ln p}{q}\).
Pour \(p=\frac{1}{2}\), on trouve \(\ln 2\approx 0{,}69\). Ce nombre diffère nettement de \(\frac{1}{E(X)}=\frac{1}{2}\) : en général, \(E\big(\frac{1}{X}\big)\neq\frac{1}{E(X)}\).
3. Produits de variables et inégalité de Cauchy-Schwarz
3.1 Produit de deux variables indépendantes
Soit \(X\) et \(Y\) deux variables indépendantes, chacune d’espérance finie. Leur produit \(XY\) admet alors une espérance, égale au produit \(E(X)\,E(Y)\).
Par transfert appliqué au couple, on examine la famille \(\big(xy\,P(X=x,Y=y)\big)\). L’indépendance la réécrit \(\big(x\,P(X=x)\big)\big(y\,P(Y=y)\big)\). C’est le produit de deux familles sommables, donc elle est sommable. Sa somme vaut alors le produit des deux sommes, c’est-à-dire \(E(X)E(Y)\).
Piège à éviter :
Sans indépendance, l’égalité \(E(XY)=E(X)E(Y)\) est fausse en général. Ainsi, pour \(X\) qui vaut \(\pm 1\) avec probabilité \(\frac{1}{2}\), on a \(E(X\cdot X)=1\), alors que \(E(X)^2=0\).
3.2 L’inégalité de Cauchy-Schwarz
On note d’abord une majoration élémentaire, conséquence de \((|X|-|Y|)^2\geq 0\) : \(2|XY|\leq X^2+Y^2\). Par conséquent, si \(X^2\) et \(Y^2\) sont d’espérance finie, \(XY\) l’est aussi. En particulier, avec \(Y=1\), une variable qui admet un moment d’ordre \(2\) admet une espérance.
Si \(X^2\) et \(Y^2\) sont d’espérance finie, alors :
\[E(|XY|)^2\leq E(X^2)\,E(Y^2).\]
Pour tout réel \(t\), la variable \((|X|+t|Y|)^2\) est positive, donc son espérance aussi. On développe par linéarité : \(E(X^2)+2t\,E(|XY|)+t^2E(Y^2)\geq 0\). Lorsque \(E(Y^2)>0\), un polynôme du second degré qui ne prend que des valeurs positives a un discriminant négatif ou nul. On obtient \(4E(|XY|)^2-4E(X^2)E(Y^2)\leq 0\). Si enfin \(E(Y^2)=0\), alors \(Y=0\) presque sûrement, et les deux membres sont nuls.
Remarque :
Avec \(Y=1\), l’inégalité donne \(E(|X|)^2\leq E(X^2)\). On retrouve ainsi la positivité de la variance, puisque \(E(X)^2\leq E(|X|)^2\). De plus, l’inégalité reste vraie sans valeur absolue, car \(|E(XY)|\leq E(|XY|)\). C’est sous cette forme qu’elle sert pour la covariance.
4. Variance, écart type et variable centrée réduite
Si \(X^2\) est d’espérance finie, la variance de \(X\) est \(V(X)=E\big((X-E(X))^2\big)\), et son écart type est \(\sigma(X)=\sqrt{V(X)}\). Lorsque \(\sigma(X)>0\), la variable \(X^{*}=\frac{X-E(X)}{\sigma(X)}\) est la variable centrée réduite associée à \(X\).
La formule de Koenig-Huygens donne \(V(X)=E(X^2)-E(X)^2\). Pour des réels \(a\) et \(b\), on a \(V(aX+b)=a^2V(X)\). Enfin, \(V(X)=0\) si et seulement si \(X\) est presque sûrement constante. La variable \(X^{*}\) vérifie \(E(X^{*})=0\) et \(V(X^{*})=1\).
La variance mesure la dispersion autour de la moyenne. Elle s’exprime dans l’unité de \(X\) au carré : c’est pourquoi on revient à l’écart type pour comparer avec les valeurs prises.
Soit \(X\) uniforme sur \(\{1,\dots,n\}\). Nous calculons sa variance par Koenig-Huygens.
- Espérance : \(E(X)=\frac{1}{n}\cdot\frac{n(n+1)}{2}=\frac{n+1}{2}\).
- Moment d’ordre \(2\) : \(E(X^2)=\frac{1}{n}\cdot\frac{n(n+1)(2n+1)}{6}=\frac{(n+1)(2n+1)}{6}\).
- Différence : \(V(X)=\frac{(n+1)(2n+1)}{6}-\frac{(n+1)^2}{4}=\frac{(n+1)\big(2(2n+1)-3(n+1)\big)}{12}\), donc \(V(X)=\frac{n^2-1}{12}\).
Pour un dé à six faces, on obtient ainsi \(V(X)=\frac{35}{12}\) et un écart type voisin de \(1{,}71\).
5. Moments des lois géométrique et de Poisson
Pour ces deux lois, la variance se calcule le plus vite par le moment factoriel \(E\big(X(X-1)\big)\). En effet, ce moment fait apparaître une dérivée seconde de série entière connue. On en déduit ensuite \(V(X)=E\big(X(X-1)\big)+E(X)-E(X)^2\).
Si \(X\) suit la loi géométrique \(\mathcal{G}(p)\), avec \(q=1-p\), alors \(E(X)=\frac{1}{p}\) et \(V(X)=\frac{q}{p^2}\). Si \(X\) suit la loi de Poisson \(\mathcal{P}(\lambda)\), alors \(E(X)=V(X)=\lambda\).
Pour la loi géométrique, on part de \(\sum_{k\geq 0}x^k=\frac{1}{1-x}\) sur \(]-1,1[\). En dérivant terme à terme, \(\sum_{k\geq 1}kx^{k-1}=\frac{1}{(1-x)^2}\) et \(\sum_{k\geq 2}k(k-1)x^{k-2}=\frac{2}{(1-x)^3}\). Ainsi \(E(X)=p\sum_k kq^{k-1}=\frac{p}{p^2}=\frac{1}{p}\), puis \(E\big(X(X-1)\big)=pq\cdot\frac{2}{p^3}=\frac{2q}{p^2}\). On obtient \(V(X)=\frac{2q}{p^2}+\frac{1}{p}-\frac{1}{p^2}=\frac{2q+p-1}{p^2}=\frac{q}{p^2}\).
Pour la loi de Poisson, on décale l’indice : \(E(X)=\sum_{k\geq 1}k\,\mathrm{e}^{-\lambda}\frac{\lambda^k}{k!}=\lambda\,\mathrm{e}^{-\lambda}\sum_{j\geq 0}\frac{\lambda^j}{j!}=\lambda\). De même, en décalant l’indice de deux crans, \(E\big(X(X-1)\big)=\lambda^2\). Donc \(V(X)=\lambda^2+\lambda-\lambda^2\), qui se simplifie en \(\lambda\).
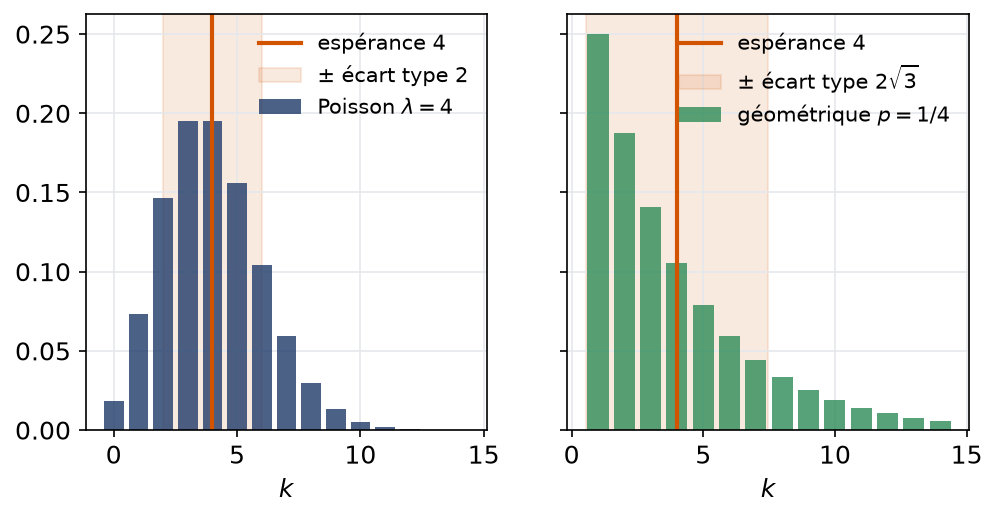
La figure compare une loi de Poisson et une loi géométrique de même espérance \(4\). La seconde est nettement plus dispersée, avec un écart type \(2\sqrt{3}\approx 3{,}46\) contre \(2\).
5.1 Méthode des moments factoriels
Les moments factoriels \(E\big(X(X-1)\cdots(X-r+1)\big)\) se calculent souvent plus facilement que les moments ordinaires. On retrouve ensuite ces derniers par des combinaisons simples.
- On justifie l’existence de \(E(X^2)\), par exemple avec la règle de d’Alembert sur \(k^2P(X=k)\).
- On calcule \(E\big(X(X-1)\big)\) par transfert, en reconnaissant une série entière dérivée deux fois ou une série exponentielle décalée.
- On conclut avec \(V(X)=E\big(X(X-1)\big)+E(X)-E(X)^2\).
Soit \(X\) de loi \(\mathcal{P}(\lambda)\). Nous montrons que \(X^3\) est d’espérance finie, puis nous la calculons.
- Existence : la variable \(X^3\) est positive. Le quotient de deux termes consécutifs de la série \(\sum k^3\mathrm{e}^{-\lambda}\frac{\lambda^k}{k!}\) vaut \(\big(\frac{k+1}{k}\big)^3\frac{\lambda}{k+1}\), qui tend vers \(0\). Par la règle de d’Alembert, la série converge.
- Moment factoriel : en décalant l’indice de trois crans, \(E\big(X(X-1)(X-2)\big)=\lambda^3\).
- Décomposition : on vérifie que \(X^3=X(X-1)(X-2)+3X(X-1)+X\). Par linéarité, \(E(X^3)=\lambda^3+3\lambda^2+\lambda\).
Remarque :
Les moments éclairent l’approximation d’une loi binomiale par une loi de Poisson. Une variable de loi \(\mathcal{B}(n,\frac{\lambda}{n})\) a pour espérance \(\lambda\) et pour variance \(\lambda\big(1-\frac{\lambda}{n}\big)\). Quand \(n\) grandit, ces deux nombres tendent vers \(\lambda\), c’est-à-dire vers les moments de \(\mathcal{P}(\lambda)\). Ce n’est pas une preuve de convergence des lois, mais c’est un contrôle de cohérence utile.
6. Covariance et variance d’une somme
6.1 Covariance et coefficient de corrélation
Soit \(X\) et \(Y\) deux variables réelles admettant un moment d’ordre \(2\). Leur covariance est \(\mathrm{Cov}(X,Y)=E\big((X-E(X))(Y-E(Y))\big)\). Lorsque les écarts types sont non nuls, le coefficient de corrélation est \(\rho(X,Y)=\frac{\mathrm{Cov}(X,Y)}{\sigma(X)\sigma(Y)}\).
On a \(\mathrm{Cov}(X,Y)=E(XY)-E(X)E(Y)\) et \(\mathrm{Cov}(X,X)=V(X)\). La covariance est symétrique et bilinéaire. Par Cauchy-Schwarz appliquée aux variables centrées, \(|\mathrm{Cov}(X,Y)|\leq\sigma(X)\sigma(Y)\), donc \(|\rho(X,Y)|\leq 1\). Si \(X\) et \(Y\) sont indépendantes, leur covariance est nulle.
Piège à éviter :
La covariance n’est pas invariante par changement d’échelle : \(\mathrm{Cov}(2X,3Y)=6\,\mathrm{Cov}(X,Y)\). Pour juger de la force d’un lien, on regarde donc le coefficient \(\rho\), sans unité et compris entre \(-1\) et \(1\). En revanche, ajouter une constante à \(X\) ou à \(Y\) ne change ni la covariance ni la corrélation.
6.2 Variance d’une somme
Si \(X_1,\dots,X_n\) admettent un moment d’ordre \(2\), alors :
\[V\Big(\sum_{i=1}^{n}X_i\Big)=\sum_{i=1}^{n}V(X_i)+2\sum_{1\leq i<j\leq n}\mathrm{Cov}(X_i,X_j).\]
En particulier, la variance d’une somme de variables deux à deux indépendantes est la somme des variances.
On note \(S\) la somme. Par bilinéarité, \(V(S)=\mathrm{Cov}(S,S)=\sum_{i}\sum_{j}\mathrm{Cov}(X_i,X_j)\). Les termes diagonaux donnent les variances. Ensuite, chaque paire \(\{i,j\}\) avec \(i\neq j\) apparaît deux fois, par symétrie de la covariance.
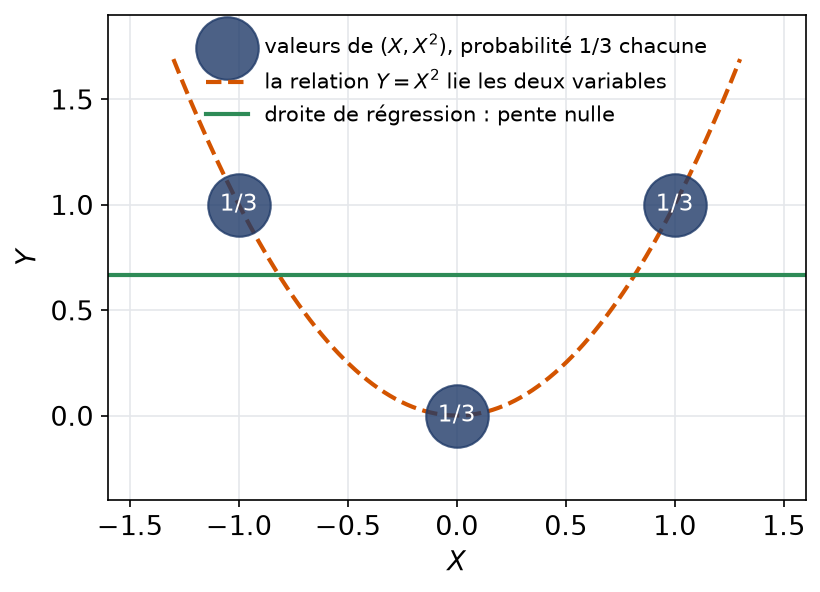
Une covariance nulle n’entraîne pas l’indépendance. Soit \(X\) uniforme sur \(\{-1,0,1\}\) et \(Y=X^2\). On a \(E(X)=0\) et \(E(XY)=E(X^3)=0\), donc \(\mathrm{Cov}(X,Y)=0\). Pourtant, \(P(X=0,Y=1)=0\), alors que \(P(X=0)P(Y=1)=\frac{1}{3}\times\frac{2}{3}\neq 0\).
On lance \(n\geq 2\) fois une pièce équilibrée. Soit \(N\) le nombre d’indices \(i\in\{1,\dots,n-1\}\) tels que les lancers \(i\) et \(i+1\) donnent tous deux pile. On note \(I_i\) l’indicatrice de cet événement, de sorte que \(N=\sum_{i=1}^{n-1}I_i\).
- Espérance : \(E(I_i)=\frac{1}{4}\), donc \(E(N)=\frac{n-1}{4}\) par linéarité.
- Variances : \(V(I_i)=\frac{1}{4}-\frac{1}{16}=\frac{3}{16}\).
- Covariances voisines : \(I_iI_{i+1}\) vaut \(1\) quand trois piles se suivent, d’où \(\mathrm{Cov}(I_i,I_{i+1})=\frac{1}{8}-\frac{1}{16}=\frac{1}{16}\).
- Covariances éloignées : si \(|i-j|\geq 2\), les indicatrices dépendent de lancers distincts, donc elles sont indépendantes et leur covariance est nulle.
- Bilan : il y a \(n-2\) paires voisines, donc \(V(N)=\frac{3(n-1)}{16}+\frac{2(n-2)}{16}=\frac{5n-7}{16}\).
Remarque :
Ce schéma revient sans cesse aux concours : on décompose un comptage en somme d’indicatrices, on calcule l’espérance par linéarité, puis la variance en ne gardant que les paires réellement dépendantes.
- On écrit la variable étudiée comme une somme \(\sum_i I_i\) de variables simples, souvent des indicatrices.
- On calcule \(E(I_i)\) et \(V(I_i)\) ; pour une indicatrice de probabilité \(p\), la variance vaut \(p(1-p)\).
- On repère les paires \((i,j)\) indépendantes, par exemple parce qu’elles portent sur des épreuves disjointes : leur covariance est nulle.
- Pour les autres paires, on calcule \(E(I_iI_j)\), qui est la probabilité que les deux événements aient lieu.
- On compte soigneusement les paires de chaque type, puis on assemble la formule de la variance d’une somme.
6.3 Interprétation : la meilleure approximation affine
Le coefficient de corrélation mesure la qualité d’une approximation de \(Y\) par une fonction affine de \(X\). Cette lecture explique pourquoi \(\rho=\pm 1\) correspond à une relation affine exacte.
On suppose \(V(X)>0\). La quantité \(E\big((Y-aX-b)^2\big)\) est minimale pour \(a=\frac{\mathrm{Cov}(X,Y)}{V(X)}\) et \(b=E(Y)-aE(X)\). Sa valeur minimale est \(V(Y)\big(1-\rho(X,Y)^2\big)\).
Pour \(a\) fixé, on pose \(Z=Y-aX\). Alors \(E\big((Z-b)^2\big)=V(Z)+\big(E(Z)-b\big)^2\), qui est minimal pour \(b=E(Z)\). Il reste à minimiser \(V(Y-aX)=V(Y)-2a\,\mathrm{Cov}(X,Y)+a^2V(X)\). Ce trinôme en \(a\) atteint son minimum en \(a=\frac{\mathrm{Cov}(X,Y)}{V(X)}\). La valeur minimale vaut alors \(V(Y)-\frac{\mathrm{Cov}(X,Y)^2}{V(X)}\), c’est-à-dire \(V(Y)(1-\rho^2)\).
Ainsi, plus \(|\rho|\) est proche de \(1\), plus l’erreur quadratique est faible. À l’inverse, une corrélation nulle signifie seulement qu’aucune fonction affine de \(X\) n’améliore la constante \(E(Y)\). Dans le contre-exemple ci-dessus, la meilleure droite est horizontale, alors que \(Y\) est une fonction exacte de \(X\).
7. Espérance, variance et covariance : ce que les correcteurs exigent
Les rapports de jury insistent toujours sur le même point : un calcul d’espérance sans justification d’existence perd une grande partie des points. Voici donc les réflexes à adopter.
- Pour une variable positive, l’espérance existe dans \([0,+\infty]\) : on peut calculer d’abord, puis constater que le résultat est fini.
- Pour une variable de signe quelconque, on prouve d’abord la sommabilité de \(|x|P(X=x)\), puis on calcule.
- Une variable bornée, ou dominée par une variable d’espérance finie, est d’espérance finie.
- Avant d’écrire une variance, on vérifie l’existence du moment d’ordre \(2\).
- Avant d’écrire \(E(XY)=E(X)E(Y)\), on cite l’indépendance.
Prenons un exemple de rédaction. Pour \(X\) de loi \(\mathcal{G}(p)\), la phrase « \(E(X^2)=\sum k^2pq^{k-1}\) » seule est incomplète. En revanche, la rédaction suivante est attendue : « la variable \(X^2\) est positive ; de plus, \(k^2pq^{k-1}=o\big(\frac{1}{k^2}\big)\) par croissances comparées, donc la série converge et \(X\) admet un moment d’ordre \(2\) ». Cette ligne supplémentaire coûte quelques secondes, mais elle rapporte des points sur chaque question.
Pour une variable entière, comparez les deux routes : la formule de transfert et la formule des queues. Quand \(P(X\geq n)\) a une forme simple, comme pour un minimum de variables indépendantes, la seconde route est presque toujours plus courte.
Les erreurs fréquentes
- Calculer \(E(X)\) sans avoir justifié que la famille \(x\,P(X=x)\) est sommable.
- Commencer la formule des queues à \(n=0\) et trouver une unité de trop.
- Écrire \(V(X+Y)=V(X)+V(Y)\) sans indépendance, ou sans vérifier que la covariance est nulle.
- Déduire l’indépendance d’une covariance nulle.
- Oublier le carré dans \(V(aX+b)=a^2V(X)\), en particulier pour \(a=-1\).
- Confondre \(E(X^2)\) et \(E(X)^2\) dans la formule de Koenig-Huygens.
Fiche mémo
- Variable positive : \(E(X)=\sum x\,P(X=x)\in[0,+\infty]\), toujours défini.
- Variable entière : \(E(X)\) est la somme des queues \(P(X\geq k)\), pour \(k\geq 1\).
- Transfert : \(E(f(X))=\sum f(x)P(X=x)\), sous réserve de sommabilité.
- Linéarité, positivité, croissance ; domination \(|X|\leq Y\) suffit pour l’existence.
- Indépendance : \(E(XY)=E(X)E(Y)\).
- Cauchy-Schwarz : \(E(|XY|)^2\leq E(X^2)E(Y^2)\) et \(|\rho|\leq 1\).
- Koenig-Huygens : \(V(X)=E(X^2)-E(X)^2\) ; \(V(aX+b)=a^2V(X)\).
- \(\mathcal{G}(p)\) : espérance \(1/p\), variance \(q/p^2\). \(\mathcal{P}(\lambda)\) : espérance et variance \(\lambda\).
- \(\mathrm{Cov}(X,Y)=E(XY)-E(X)E(Y)\), nulle si indépendance, réciproque fausse.
- Variance d’une somme : somme des variances plus deux fois la somme des covariances.
Questions fréquentes
Comment justifier qu'une variable admet une espérance ?
On montre que la famille des |x| P(X = x) est sommable, souvent par comparaison à une série de Riemann ou par la règle de d’Alembert. Une variable bornée, ou dominée en valeur absolue par une variable d’espérance finie, convient aussi. Pour une variable positive, l’espérance existe toujours dans [0, +∞] et il suffit de constater qu’elle est finie.
Quand utiliser la formule des queues ?
Elle s’applique aux variables à valeurs dans N, éventuellement complété par +∞. Elle est particulièrement efficace quand P(X ≥ n) est plus simple que P(X = n), par exemple pour un minimum de variables indépendantes ou pour un temps d’attente.
Une covariance nulle implique-t-elle l'indépendance ?
Non, seul le sens direct est vrai : deux variables indépendantes ont une covariance nulle, mais une covariance nulle n’assure pas l’indépendance. L’exemple classique est X uniforme sur {-1, 0, 1} et Y = X² : leur covariance est nulle alors que Y est une fonction de X.
Pourquoi passer par E(X(X-1)) pour calculer une variance ?
Pour les lois géométrique et de Poisson, ce moment factoriel se calcule directement par une dérivée seconde de série entière ou par un décalage d’indice. On retrouve ensuite la variance par V(X) = E(X(X-1)) + E(X) – E(X)². C’est souvent plus rapide que de calculer E(X²) de front.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur espérance, variance et covariance
- Bases utiles : Lois discrètes usuelles : géométrique et Poisson
- Chapitre d’avant : Lois discrètes usuelles : géométrique et Poisson
- Chapitre d’après : Loi faible des grands nombres et séries génératrices
- Vérifier ses acquis : QCM de maths spé (MP) sur espérance, variance et covariance
- Contrôle corrigé en temps limité : Formule des queues et covariance : contrôle de maths en MP
- Un autre sujet noté sur 20 : Problème de probabilités discrètes : contrôle de maths en MP
- Le même thème en L2 de maths : Lois discrètes, espérance et variance
- Le même thème en maths sup (MPSI) : Variables aléatoires finies, espérance et variance
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «espérance, variance et covariance en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir Matrices orthogonales et rotations en maths spé (MP)
- Polynôme minimal et lemme des noyaux en maths spé (MP)
- Convergence dominée et paramètre en maths spé (MP)
- Ouverts, fermés et adhérence en maths spé (MP)
- Différentielle et règle de la chaîne en maths spé (MP)
- Intégrabilité sur un intervalle en maths spé (MP)

Exercices corrigés
Tout voir
Contrôles
Tout voir
QCM
Tout voir