Corrigé des exercices : Convergence en loi et TCL en L3 de maths
Ce corrigé TCL L3 suit l’ordre des 21 exercices. Chaque solution s’ouvre sur une idée clé, puis la rédaction détaille les hypothèses, les théorèmes invoqués et les calculs intermédiaires. Nous précisons toujours le mode de convergence obtenu, car c’est le point que les correcteurs vérifient en premier.
Plusieurs pièges reviennent d’un exercice à l’autre. D’abord, le second lemme de Borel-Cantelli exige l’indépendance. Ensuite, le théorème de Lévy demande la convergence de la fonction caractéristique en tout point. De plus, une approximation par le théorème central limite reste une approximation : nous donnons les valeurs de la fonction de répartition gaussienne utilisées. Enfin, les contre-exemples sont construits explicitement, sur un espace probabilisé précis.
Pour démarrer
Corrigé de l’exercice 1 – Fonctions caractéristiques discrètes
Idée clé : pour une loi discrète, l’espérance est une somme ; pour une somme indépendante, on multiplie les fonctions caractéristiques.
- Pour \(B\) de loi de Bernoulli, \(\varphi_B(t) = (1 – p)e^{0} + pe^{it} = 1 – p + pe^{it}\). Une variable binomiale \(\mathcal{B}(n, p)\) a la loi d’une somme de \(n\) variables de Bernoulli indépendantes. Par conséquent, sa fonction caractéristique vaut \((1 – p + pe^{it})^n\).
- On somme la série exponentielle :
\[\varphi_X(t) = \sum_{k \geq 0} e^{-\lambda}\frac{\lambda^k}{k!}e^{itk} = e^{-\lambda}\sum_{k \geq 0}\frac{(\lambda e^{it})^k}{k!} = e^{\lambda(e^{it} – 1)}.\]
Ainsi, \(\varphi_X(t) = \exp(\lambda(e^{it} – 1))\). - Par indépendance, \(\varphi_{X+Y}(t) = e^{\lambda(e^{it} – 1)}e^{\mu(e^{it} – 1)} = e^{(\lambda + \mu)(e^{it} – 1)}\). On reconnaît la fonction caractéristique d’une loi de Poisson. Par le théorème d’unicité, \(X + Y\) suit la loi de Poisson de paramètre \(\lambda + \mu\).
Corrigé de l’exercice 2 – Loi uniforme et somme de deux uniformes
Idée clé : on intègre l’exponentielle complexe contre la densité, puis on compare les variances lues sur les développements limités.
- Pour \(t \neq 0\), on calcule
\[\varphi_U(t) = \frac{1}{4}\int_{-2}^{2} e^{itx}\,dx = \frac{1}{4}\cdot\frac{e^{2it} – e^{-2it}}{it} = \frac{1}{4}\cdot\frac{2i\sin(2t)}{it}.\]
On obtient bien \(\varphi_U(t) = \sin(2t)/(2t)\). - Le même calcul donne \(\varphi_{U_1}(t) = \sin t/t\). Par indépendance, \(\varphi_V(t) = \left(\dfrac{\sin t}{t}\right)^2\) pour \(t \neq 0\), et \(\varphi_V(0) = 1\).
- Au voisinage de \(0\), on a \(\varphi_U(t) = 1 – \frac{(2t)^2}{6} + o(t^2) = 1 – \frac{2t^2}{3} + o(t^2)\). De même, \(\varphi_V(t) = \left(1 – \frac{t^2}{6}\right)^2 + o(t^2) = 1 – \frac{t^2}{3} + o(t^2)\). Par identification avec \(1 – \frac{t^2}{2}\mathbb{E}[X^2]\), on obtient \(\mathbb{E}[U^2] = 4/3\) et \(\mathbb{E}[V^2] = 2/3\). Les moments d’ordre \(2\) diffèrent, donc \(U\) et \(V\) n’ont pas la même loi.
Corrigé de l’exercice 3 – Moments lus sur la fonction caractéristique
Idée clé : on utilise \(\varphi^{(k)}(0) = i^k\mathbb{E}[X^k]\), soit par dérivation, soit en identifiant un développement limité.
- On dérive : \(\varphi_X^{\prime}(t) = -3(1 – 2it)^{-4}(-2i) = 6i(1 – 2it)^{-4}\). Ainsi, \(\varphi_X^{\prime}(0) = 6i = i\,\mathbb{E}[X]\), donc \(\mathbb{E}[X] = 6\). Ensuite, \(\varphi_X^{\prime\prime}(t) = 6i \cdot (-4)(1 – 2it)^{-5}(-2i) = -48(1 – 2it)^{-5}\). Donc \(\varphi_X^{\prime\prime}(0) = -48 = -\mathbb{E}[X^2]\), d’où \(\mathbb{E}[X^2] = 48\). On obtient \(\mathbb{E}[X] = 6\) et \(\operatorname{Var}(X) = 48 – 36 = 12\).
- On a \(e^{-\sigma^2t^2/2} = 1 – \frac{\sigma^2t^2}{2} + \frac{\sigma^4t^4}{8} + o(t^4)\). Or le coefficient de \(t^4\) dans le développement de Taylor vaut \(\varphi_Y^{(4)}(0)/4! = i^4\,\mathbb{E}[Y^4]/24\). Ainsi, \(\mathbb{E}[Y^4]/24 = \sigma^4/8\). Par conséquent, \(\mathbb{E}[Y^4] = 3\sigma^4\).
Corrigé de l’exercice 4 – Trois convergences vers zéro
Idée clé : la suite est construite à partir d’une seule variable, ce qui rend chaque mode de convergence directement calculable.
- La variable \(E\) prend des valeurs finies. Donc, pour tout \(\omega\), \(E(\omega)/n \to 0\). La convergence a lieu partout, donc presque sûrement.
- Pour la loi exponentielle de paramètre \(1\), \(\mathbb{E}[E^2] = \operatorname{Var}(E) + \mathbb{E}[E]^2 = 2\). Ainsi, \(\mathbb{E}[X_n^2] = 2/n^2\). Cette quantité tend vers \(0\), donc \(X_n \to 0\) dans \(L^2\).
- On a \(\mathbb{P}(X_n > \varepsilon) = \mathbb{P}(E > n\varepsilon) = e^{-n\varepsilon}\). Cette probabilité tend vers \(0\), ce qui donne la convergence en probabilité. On retrouve ainsi les implications du cours.
Corrigé de l’exercice 5 – Borel-Cantelli et convergence presque sûre
Idée clé : le premier lemme ne demande aucune indépendance ; le second l’exige, et il fournit ici le contre-exemple.
- Soit \(A_n = \{Y_n \neq 0\}\). On a \(\sum \mathbb{P}(A_n) = \sum 1/n^2 < +\infty\). Le premier lemme de Borel-Cantelli montre que, presque sûrement, seuls un nombre fini de \(A_n\) se réalisent. Ainsi, presque sûrement, \(Y_n = 0\) à partir d’un certain rang, donc \(Y_n \to 0\).
- On calcule \(\mathbb{E}[|Y_n – 0|] = n^2 \times \frac{1}{n^2} = 1\). Cette quantité ne tend pas vers \(0\) : pas de convergence dans \(L^1\).
- D’une part, \(\mathbb{P}(|Z_n| > \varepsilon) \leq 1/\sqrt{n} \to 0\), donc \(Z_n \to 0\) en probabilité. D’autre part, les événements \(\{Z_n = 1\}\) sont indépendants et \(\sum 1/\sqrt{n} = +\infty\). Le second lemme montre que \(Z_n = 1\) pour une infinité de \(n\), presque sûrement. Par conséquent, \(Z_n\) converge en probabilité vers \(0\), mais presque sûrement ne converge pas vers \(0\).
Corrigé de l’exercice 6 – Bienaymé-Tchebychev et taille d’échantillon
Idée clé : on majore la variance indépendamment de \(p\), puis on résout une inégalité en \(n\).
- La fréquence \(F_n\) est la moyenne de \(n\) variables de Bernoulli indépendantes de paramètre \(p\). Ainsi, \(\operatorname{Var}(F_n) = p(1 – p)/n\). Or \(p(1 – p) = \frac{1}{4} – \left(p – \frac{1}{2}\right)^2 \leq \frac{1}{4}\). Donc \(\operatorname{Var}(F_n) \leq 1/(4n)\).
- L’inégalité de Bienaymé-Tchebychev donne \(\mathbb{P}(|F_n – p| \geq 0{,}04) \leq \dfrac{1}{4n \times 0{,}0016} = \dfrac{1}{0{,}0064\,n}\). Ce majorant est inférieur à \(0{,}05\) dès que \(n \geq \frac{1}{0{,}0064 \times 0{,}05} = 3\,125\). Il suffit de \(n = 3\,125\) lancers. Cette taille est très prudente : le théorème central limite donnerait une valeur bien plus faible.
Corrigé de l’exercice 7 – Uniforme discrète vers uniforme continue
Idée clé : la fonction de répartition de \(X_n\) est une fonction en escalier qui reste à distance au plus \(1/n\) de la fonction identité sur \([0, 1]\).
- Pour \(x < 0\), on a \(F_n(x) = 0\), et pour \(x \geq 1\), \(F_n(x) = 1\). Pour \(0 \leq x < 1\), les valeurs \(k/n \leq x\) sont celles pour lesquelles \(1 \leq k \leq \lfloor nx \rfloor\). Donc \(F_n(x) = \lfloor nx \rfloor/n\) sur \([0, 1[\).
- Sur \([0, 1[\), on a \(x – \frac{1}{n} < \frac{\lfloor nx \rfloor}{n} \leq x\). Ainsi, \(F_n(x) \to x\), qui est la fonction de répartition de la loi uniforme sur \([0, 1]\). Hors de \([0, 1[\), les deux fonctions coïncident. La convergence a lieu en tout point, donc \(X_n\) converge en loi vers la loi uniforme.
- Pour \(f\) continue bornée, \(\mathbb{E}[f(X_n)] = \frac{1}{n}\sum_{k=1}^{n} f(k/n)\). C’est une somme de Riemann de \(f\) sur \([0, 1]\), où \(f\) est continue. Elle tend vers \(\int_0^1 f(x)\,dx = \mathbb{E}[f(U)]\), ce qui redonne la convergence en loi.
Pour s’entraîner
Corrigé de l’exercice 8 – Décorréler un couple gaussien
Idée clé : toute image linéaire d’un vecteur gaussien est gaussienne, et pour un vecteur gaussien, covariance nulle équivaut à indépendance.
- On a \(\Gamma = \begin{pmatrix} 4 & 1 \\ 1 & 1 \end{pmatrix}\), de déterminant \(4 – 1 = 3 \neq 0\). La matrice est inversible, donc \((X, Y)\) admet une densité gaussienne.
- La variable \(X – 2Y\) est une combinaison linéaire des composantes, donc elle est gaussienne et centrée. Sa variance vaut \(\operatorname{Var}(X) + 4\operatorname{Var}(Y) – 4\operatorname{Cov}(X, Y) = 4 + 4 – 4 = 4\). Ainsi, \(X – 2Y \sim \mathcal{N}(0, 4)\).
- Le couple \((X – aY, Y)\) est l’image de \((X, Y)\) par une application linéaire, donc il est gaussien. Ses composantes sont indépendantes si et seulement si \(\operatorname{Cov}(X – aY, Y) = 1 – a = 0\). Donc \(a = 1\). Ensuite, \(\operatorname{Var}(X – Y) = 4 + 1 – 2 = 3\). On obtient \(Z = X – Y \sim \mathcal{N}(0, 3)\), indépendante de \(Y\).
- D’abord, \(\mathbb{P}(X > Y) = \mathbb{P}(Z > 0) = 1/2\), par symétrie de la loi \(\mathcal{N}(0, 3)\). Ensuite, \(X = Y + Z\) avec \(Z\) indépendante de \(Y\) et centrée. Donc \(\mathbb{P}(X > Y) = 1/2\) et \(\mathbb{E}[X \mid Y] = Y + \mathbb{E}[Z] = Y\).
Corrigé de l’exercice 9 – Deux gaussiennes non corrélées mais dépendantes
Idée clé : la symétrie de la loi normale donne la loi de \(Y\) ; le théorème des valeurs intermédiaires annule la covariance ; une gaussienne non constante n’est jamais bornée.
- Soit \(f\) mesurable bornée. On écrit \(f(Y) = f(X)\mathbf{1}_{\{|X| \leq c\}} + f(-X)\mathbf{1}_{\{|X| > c\}}\). Comme \(-X\) a la même loi que \(X\) et que \(|-X| = |X|\), on a \(\mathbb{E}[f(-X)\mathbf{1}_{\{|X| > c\}}] = \mathbb{E}[f(X)\mathbf{1}_{\{|X| > c\}}]\). En sommant, on obtient \(\mathbb{E}[f(Y)] = \mathbb{E}[f(X)]\). Donc \(Y \sim \mathcal{N}(0, 1)\).
- Les deux variables sont centrées. Ainsi, \(\operatorname{Cov}(X, Y) = \mathbb{E}[X^2\mathbf{1}_{\{|X| \leq c\}}] – \mathbb{E}[X^2\mathbf{1}_{\{|X| > c\}}] = h(c) – (1 – h(c)) = 2h(c) – 1\). La fonction \(h\) est continue par convergence dominée, tend vers \(0\) en \(0^{+}\) et vers \(\mathbb{E}[X^2] = 1\) en \(+\infty\). Par le théorème des valeurs intermédiaires, il existe \(c > 0\) tel que \(h(c) = 1/2\), c’est-à-dire \(\operatorname{Cov}(X, Y) = 0\).
- On a \(X + Y = 2X\mathbf{1}_{\{|X| \leq c\}}\), donc \(|X + Y| \leq 2c\). De plus, \(\mathbb{P}(X + Y = 0) = \mathbb{P}(|X| > c)\) est strictement compris entre \(0\) et \(1\), donc \(X + Y\) n’est pas constante. Or une gaussienne non constante charge tout intervalle, donc elle n’est pas bornée. Ainsi, \(X + Y\) n’est pas gaussienne, et \((X, Y)\) n’est pas un vecteur gaussien. Enfin, si \(X\) et \(Y\) étaient indépendantes, la fonction caractéristique du couple serait le produit \(e^{-u_1^2/2}e^{-u_2^2/2}\), et le couple serait gaussien. Par conséquent, \(X\) et \(Y\) sont non corrélées mais dépendantes.
Corrigé de l’exercice 10 – Moyenne de variables de Cauchy
Idée clé : la fonction caractéristique de la moyenne se calcule exactement et ne dépend pas de \(n\).
- On a \(\frac{|x|}{\pi(1 + x^2)} \sim \frac{1}{\pi|x|}\) en \(\pm\infty\), qui n’est pas intégrable. Donc \(\mathbb{E}[|X_1|] = +\infty\).
- Par indépendance, \(\varphi_{\bar{X}_n}(t) = \varphi_{X_1}(t/n)^n = \left(e^{-|t|/n}\right)^n = e^{-|t|}\). Par unicité, \(\bar{X}_n\) suit la même loi de Cauchy que \(X_1\).
- Si \(\bar{X}_n\) convergeait en probabilité vers une constante \(c\), elle convergerait en loi vers \(c\). La suite de lois étant constante, la loi de Cauchy serait la masse de Dirac en \(c\). C’est faux, car \(|e^{ict}| = 1\) alors que \(e^{-|t|} < 1\) pour \(t \neq 0\). La loi des grands nombres est donc en défaut, faute d’intégrabilité.
- On a \(\varphi_{S_n/n^2}(t) = \varphi_{X_1}(t/n^2)^n = e^{-|t|/n} \to 1\). C’est la fonction caractéristique de la constante \(0\). Par le théorème de Lévy, \(S_n/n^2 \to 0\) en loi. La limite est constante, donc la convergence a aussi lieu en probabilité (exercice 13).
Corrigé de l’exercice 11 – Loi géométrique renormalisée
Idée clé : on somme une série géométrique, puis on fait un développement limité de \(e^{it/n}\) au dénominateur.
- On a \(\mathbb{P}(X_n = k) = p_n(1 – p_n)^{k-1}\) pour \(k \geq 1\). Comme \(|(1 – p_n)e^{it}| < 1\), on somme :
\[\varphi_{X_n}(t) = p_ne^{it}\sum_{j \geq 0}\left((1 – p_n)e^{it}\right)^j = \frac{p_ne^{it}}{1 – (1 – p_n)e^{it}}.\]
C’est la formule demandée. - On a \(\varphi_{X_n/n}(t) = \varphi_{X_n}(t/n)\). En multipliant numérateur et dénominateur par \(n\), on obtient
\[\varphi_{X_n/n}(t) = \frac{\lambda e^{it/n}}{n\left(1 – e^{it/n}\right) + \lambda e^{it/n}}.\]
Or \(n(1 – e^{it/n}) \to -it\) et \(e^{it/n} \to 1\). Ainsi, \(\varphi_{X_n/n}(t) \to \frac{\lambda}{\lambda – it}\), qui est la fonction caractéristique de la loi exponentielle de paramètre \(\lambda\). Le théorème de Lévy donne la convergence en loi de \(X_n/n\) vers cette loi. - On répète une épreuve dont la probabilité de succès \(\lambda/n\) est faible. Le rang du premier succès, mesuré en blocs de \(n\) épreuves, suit approximativement une loi exponentielle : c’est le passage du temps discret au temps continu.
Corrigé de l’exercice 12 – La bosse glissante
Idée clé : la bosse rétrécit, ce qui donne la convergence en probabilité, mais elle repasse sur chaque point à chaque génération, ce qui empêche la convergence ponctuelle.
- Pour \(0 < \varepsilon < 1\), on a \(\mathbb{P}(|X_n| > \varepsilon) = \mathbb{P}(X_n = 1) = 2^{-k}\), et \(\mathbb{E}[|X_n|^p] = 2^{-k}\). Or \(k = \lfloor \log_2 n \rfloor\) tend vers l’infini avec \(n\). Donc \(X_n \to 0\) en probabilité et dans tout \(L^p\).
- Fixons \(\omega\) et \(k \geq 1\). Les intervalles \([j2^{-k}, (j+1)2^{-k}[\), pour \(0 \leq j < 2^k\), forment une partition de \([0, 1[\). Il existe donc exactement un indice \(n\) entre \(2^k\) et \(2^{k+1} – 1\) tel que \(X_n(\omega) = 1\), et les autres valent \(0\). Chaque bloc d’indices contient un \(1\) et, dès que \(k \geq 1\), au moins un \(0\) : la suite oscille sans fin et ne converge pour aucun \(\omega\).
- On prend \(n_k = 2^k\), c’est-à-dire \(j = 0\). Alors \(X_{n_k} = \mathbf{1}_{[0, 2^{-k}[}\). Pour tout \(\omega > 0\), on a \(X_{n_k}(\omega) = 0\) dès que \(2^{-k} \leq \omega\). La sous-suite converge vers \(0\) en dehors de \(\{0\}\), donc presque sûrement.
- On a encore \(\mathbb{P}(Y_n \neq 0) = 2^{-k} \to 0\), d’où la convergence en probabilité. En revanche, \(\mathbb{E}[Y_n] = 2^k \times 2^{-k} = 1\). La suite \((Y_n)\) ne converge pas vers \(0\) dans \(L^1\).
Corrigé de l’exercice 13 – Convergence en loi vers une constante
Idée clé : la fonction de répartition d’une constante n’est discontinue qu’en un point, ce qui laisse toute liberté de part et d’autre.
- La fonction de répartition de la constante \(c\) vaut \(0\) sur \(]-\infty, c[\) et \(1\) sur \([c, +\infty[\). Elle est continue en tout \(x \neq c\). Pour \(\varepsilon > 0\), on écrit
\[\mathbb{P}(|X_n – c| > \varepsilon) \leq F_{X_n}(c – \varepsilon) + 1 – F_{X_n}(c + \varepsilon).\]
Le majorant tend vers \(0 + 1 – 1 = 0\). Donc \(X_n \to c\) en probabilité. - La variable \(1 – X\) suit encore la loi de Bernoulli de paramètre \(1/2\). Toutes les \(X_n\) ont donc la loi de \(X\), d’où la convergence en loi. Cependant, \(|X_n – X| = |1 – 2X| = 1\) partout. Ainsi, \(\mathbb{P}(|X_n – X| > 1/2) = 1\) : pas de convergence en probabilité.
- On a \(\varphi_{X_n}(t) = e^{it – t^2/(2n)} \to e^{it}\), qui est la fonction caractéristique de la constante \(1\). Le théorème de Lévy donne la convergence en loi vers \(1\). Par la question 1, \(X_n \to 1\) en probabilité.
Corrigé de l’exercice 14 – Somme de 400 variables uniformes
Idée clé : on centre et on réduit \(S\), puis on remplace la loi exacte par la loi normale centrée réduite.
- Une variable uniforme sur \([0, 1]\) a pour espérance \(1/2\) et pour variance \(1/12\). Par linéarité et par indépendance, \(\mathbb{E}[S] = 200\) et \(\operatorname{Var}(S) = 400/12 = 100/3\), soit un écart type \(10/\sqrt{3} \approx 5{,}774\).
- On écrit \(\mathbb{P}(S \geq 210) = \mathbb{P}\left(\frac{S – 200}{10/\sqrt{3}} \geq \sqrt{3}\right)\), avec \(\sqrt{3} \approx 1{,}73\). Le théorème central limite donne l’approximation \(1 – \Phi(1{,}73) \approx 1 – 0{,}958\). On obtient \(\mathbb{P}(S \geq 210) \approx 0{,}042\).
- Bienaymé-Tchebychev donne \(\mathbb{P}(|S – 200| \geq 10) \leq \frac{100/3}{100} = \frac{1}{3}\). Par symétrie, le théorème central limite donne plutôt \(2 \times 0{,}042 \approx 0{,}084\). La majoration de Tchebychev est vraie mais environ quatre fois trop large.
- On cherche \(s\) tel que \(\frac{s – 200}{5{,}774} \approx 1{,}645\). On obtient \(s \approx 200 + 1{,}645 \times 5{,}774 \approx 209{,}5\).
Corrigé de l’exercice 15 – Intervalle de confiance pour une proportion
Idée clé : la variance inconnue \(p(1 – p)\) est majorée par \(1/4\), ce qui fournit un intervalle prudent ne dépendant que de \(n\).
- On suppose \(0 < p < 1\). Le théorème central limite donne la convergence en loi de \(T_n = \sqrt{n}\,(F_n – p)/\sqrt{p(1 – p)}\) vers \(\mathcal{N}(0, 1)\). La fonction \(\Phi\) est continue, donc \(\mathbb{P}(|T_n| \leq 1{,}96) \to 2\Phi(1{,}96) – 1 \approx 0{,}95\). Or \(1{,}96\sqrt{p(1 – p)} \leq 1{,}96 \times \frac{1}{2} = 0{,}98\). Ainsi, l’événement \(\{|T_n| \leq 1{,}96\}\) est inclus dans \(\left\{|F_n – p| \leq 0{,}98/\sqrt{n}\right\}\). La probabilité que l’intervalle contienne \(p\) est donc asymptotiquement au moins \(0{,}95\).
- On a \(F_n = 752/1\,600 = 0{,}47\) et \(0{,}98/\sqrt{1\,600} = 0{,}98/40 = 0{,}0245\). L’intervalle de confiance est \([0{,}4455\,;\,0{,}4945]\).
- On veut \(0{,}98/\sqrt{n} \leq 0{,}01\), soit \(\sqrt{n} \geq 98\). Il faut interroger au moins \(9\,604\) personnes.
Corrigé de l’exercice 16 – Records d’une suite exponentielle
Idée clé : la queue exponentielle transforme \(\mathbb{P}(X_n > c\ln n)\) en une série de Riemann, convergente ou divergente selon la position de \(c\) par rapport à \(1\).
- On a \(\mathbb{P}(X_n > c\ln n) = e^{-c\ln n} = n^{-c}\).
- Pour \(c > 1\), la série \(\sum n^{-c}\) converge. Le premier lemme de Borel-Cantelli montre que l’événement \(\{X_n > c\ln n\}\) ne se produit qu’un nombre fini de fois, presque sûrement. Ainsi, presque sûrement, \(X_n \leq c\ln n\) à partir d’un certain rang.
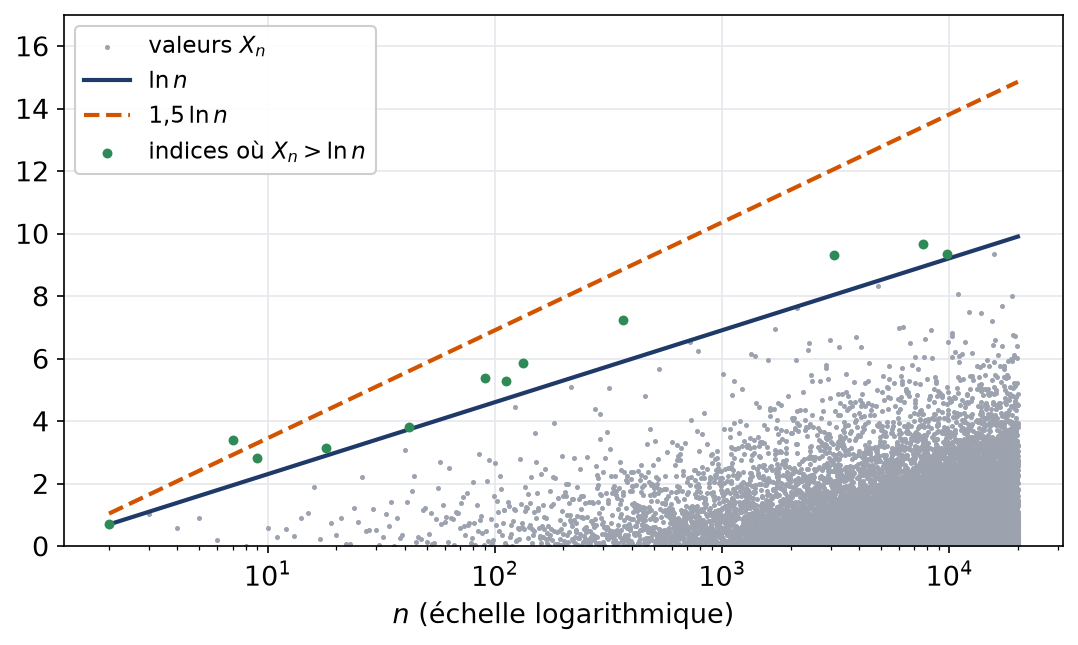
- Pour \(c = 1\), la série \(\sum 1/n\) diverge, et les événements \(\{X_n > \ln n\}\) sont indépendants, car les \(X_n\) le sont. Le second lemme donne \(X_n > \ln n\) pour une infinité de \(n\), presque sûrement.
- La question 3 donne \(\limsup X_n/\ln n \geq 1\) presque sûrement. Ensuite, pour chaque entier \(q \geq 1\), la question 2 avec \(c = 1 + 1/q\) donne \(\limsup X_n/\ln n \leq 1 + 1/q\) en dehors d’un ensemble négligeable \(N_q\). La réunion des \(N_q\) est encore négligeable. Par conséquent, \(\limsup X_n/\ln n = 1\) presque sûrement.
La simulation ci-dessous montre que les dépassements de \(\ln n\) continuent de se produire, de plus en plus rarement, tandis que la droite \(1{,}5\ln n\) n’est plus franchie.
Corrigé de l’exercice 17 – Fréquence d’un chiffre dans un réel au hasard
Idée clé : fixer les \(k\) premiers chiffres revient à placer \(U\) dans un intervalle de longueur \(10^{-k}\), ce qui donne l’indépendance ; la loi forte fait le reste.
- Posons \(N = \sum_{i=1}^{k} d_i10^{k-i}\). L’événement \(\{D_1 = d_1, \dots, D_k = d_k\}\) équivaut à \(\lfloor 10^kU \rfloor = N\), c’est-à-dire \(U \in [N10^{-k}, (N + 1)10^{-k}[\). Sa probabilité vaut donc \(10^{-k}\). En sommant sur \(d_1, \dots, d_{k-1}\), on obtient \(\mathbb{P}(D_k = d) = 10^{k-1} \times 10^{-k} = 1/10\). La loi jointe est le produit des lois marginales uniformes : les \(D_k\) sont i.i.d. uniformes sur \(\{0, \dots, 9\}\).
- On a \(N_n = \sum_{k=1}^{n}\mathbf{1}_{\{D_k = 7\}}\), somme de variables de Bernoulli i.i.d. de paramètre \(1/10\), donc intégrables. La loi forte des grands nombres donne \(N_n/n \to 1/10\) presque sûrement.
- La variable \(N_{10\,000}\) a pour espérance \(1\,000\) et pour variance \(10\,000 \times 0{,}1 \times 0{,}9 = 900\), soit un écart type de \(30\). Ainsi, \(\mathbb{P}(N_{10\,000} \geq 1\,060) = \mathbb{P}\left(\frac{N_{10\,000} – 1\,000}{30} \geq 2\right)\). Le théorème central limite donne une valeur approchée de \(1 – \Phi(2) \approx 0{,}023\).
Pour approfondir
Corrigé de l’exercice 18 – Lemme de Slutsky et TCL autonormalisé
Idée clé : l’écart entre les deux fonctions caractéristiques se contrôle par \(Y_n – c\), qui est petit avec grande probabilité.
- On a \(|e^{it(X_n + Y_n)} – e^{it(X_n + c)}| = |e^{it(Y_n – c)} – 1|\), car \(|e^{itX_n}| = 1\). Or \(|e^{iu} – 1| \leq \min(2, |u|)\) pour tout réel \(u\). En prenant l’espérance, on obtient \(|\varphi_{X_n + Y_n}(t) – \varphi_{X_n + c}(t)| \leq \mathbb{E}[\min(2, |t|\,|Y_n – c|)]\).
- Soit \(\delta > 0\). On découpe selon l’événement \(\{|Y_n – c| \leq \delta\}\) : le majorant est au plus \(|t|\delta + 2\,\mathbb{P}(|Y_n – c| > \delta)\). Sa limite supérieure est donc au plus \(|t|\delta\), pour tout \(\delta\), donc elle est nulle. Par ailleurs, \(\varphi_{X_n + c}(t) = e^{itc}\varphi_{X_n}(t) \to e^{itc}\varphi_X(t) = \varphi_{X + c}(t)\) par le théorème de Lévy. Ainsi, \(\varphi_{X_n + Y_n}(t) \to \varphi_{X + c}(t)\), et le théorème de Lévy donne \(X_n + Y_n \to X + c\) en loi.
- Les variables \(Z_k^2\) sont i.i.d. et intégrables, d’espérance \(\sigma^2 + m^2\). La loi forte donne \(\frac{1}{n}\sum Z_k^2 \to \sigma^2 + m^2\) et \(\bar{Z}_n \to m\) presque sûrement. Ainsi, \(\hat{\sigma}_n^2 \to \sigma^2 + m^2 – m^2 = \sigma^2\). Par continuité de la racine carrée, \(\hat{\sigma}_n \to \sigma\) presque sûrement.
- On écrit \(\sqrt{n}\,\frac{\bar{Z}_n – m}{\hat{\sigma}_n} = \sqrt{n}\,\frac{\bar{Z}_n – m}{\sigma} \cdot \frac{\sigma}{\hat{\sigma}_n}\), en donnant une valeur arbitraire au quotient lorsque \(\hat{\sigma}_n = 0\), ce qui n’arrive presque sûrement plus à partir d’un certain rang. Le premier facteur converge en loi vers \(\mathcal{N}(0, 1)\) par le théorème central limite. Le second tend vers \(1\) presque sûrement, donc en probabilité. La version produit du lemme donne la convergence vers \(\mathcal{N}(0, 1)\). L’intérêt est pratique : \(\sigma\) est en général inconnu, et ce résultat justifie l’intervalle \(\bar{Z}_n \pm 1{,}96\,\hat{\sigma}_n/\sqrt{n}\).
Corrigé de l’exercice 19 – La méthode delta
Idée clé : on linéarise \(g\) autour de \(m\) ; le facteur dérivé converge en probabilité et le lemme de Slutsky transporte le théorème central limite.
- L’intervalle \(I\) est convexe, donc \(\bar{X}_n \in I\). L’égalité des accroissements finis fournit \(\xi_n\) entre \(\bar{X}_n\) et \(m\). Pour éviter toute question de mesurabilité, on peut utiliser la fonction \(G\) définie par \(G(x) = \frac{g(x) – g(m)}{x – m}\) si \(x \neq m\) et \(G(m) = g^{\prime}(m)\). Elle est continue sur \(I\), car \(g\) est dérivable en \(m\), et \(g(\bar{X}_n) – g(m) = G(\bar{X}_n)(\bar{X}_n – m)\). Par la loi forte, \(\bar{X}_n \to m\) presque sûrement. Par continuité, \(G(\bar{X}_n) \to g^{\prime}(m)\) presque sûrement, donc en probabilité.
- On écrit \(\sqrt{n}\,(g(\bar{X}_n) – g(m)) = G(\bar{X}_n)\cdot\sqrt{n}\,(\bar{X}_n – m)\). Le second facteur converge en loi vers \(\mathcal{N}(0, \sigma^2)\). Le lemme de Slutsky, dans sa version produit, donne la convergence vers \(g^{\prime}(m)W\) avec \(W \sim \mathcal{N}(0, \sigma^2)\). La limite est donc la loi \(\mathcal{N}(0, g^{\prime}(m)^2\sigma^2)\).
- Pour la loi exponentielle, \(m = 1/\lambda\) et \(\sigma^2 = 1/\lambda^2\). On prend \(g(x) = 1/x\) sur \(I = ]0, +\infty[\), d’où \(g^{\prime}(m) = -1/m^2 = -\lambda^2\). La variance limite vaut \(\lambda^4 \times \frac{1}{\lambda^2} = \lambda^2\). Ainsi, \(\sqrt{n}\,(1/\bar{X}_n – \lambda) \to \mathcal{N}(0, \lambda^2)\) en loi.
Corrigé de l’exercice 20 – Produit de cosinus et loi uniforme
Idée clé : la formule de duplication du sinus télescope le produit de cosinus, et la limite obtenue est la fonction caractéristique de la loi uniforme.
- On a \(\varphi_{\varepsilon_k2^{-k}}(t) = \frac{1}{2}\left(e^{it/2^k} + e^{-it/2^k}\right) = \cos(t/2^k)\). Par indépendance, \(\varphi_{S_n}(t) = \prod_{k=1}^{n}\cos(t/2^k)\).
- Pour \(n = 1\), c’est la formule \(\sin t = 2\sin(t/2)\cos(t/2)\). Si la formule est vraie au rang \(n\), on remplace \(\sin(t/2^n)\) par \(2\sin(t/2^{n+1})\cos(t/2^{n+1})\). On obtient la formule au rang \(n + 1\), ce qui achève la récurrence.
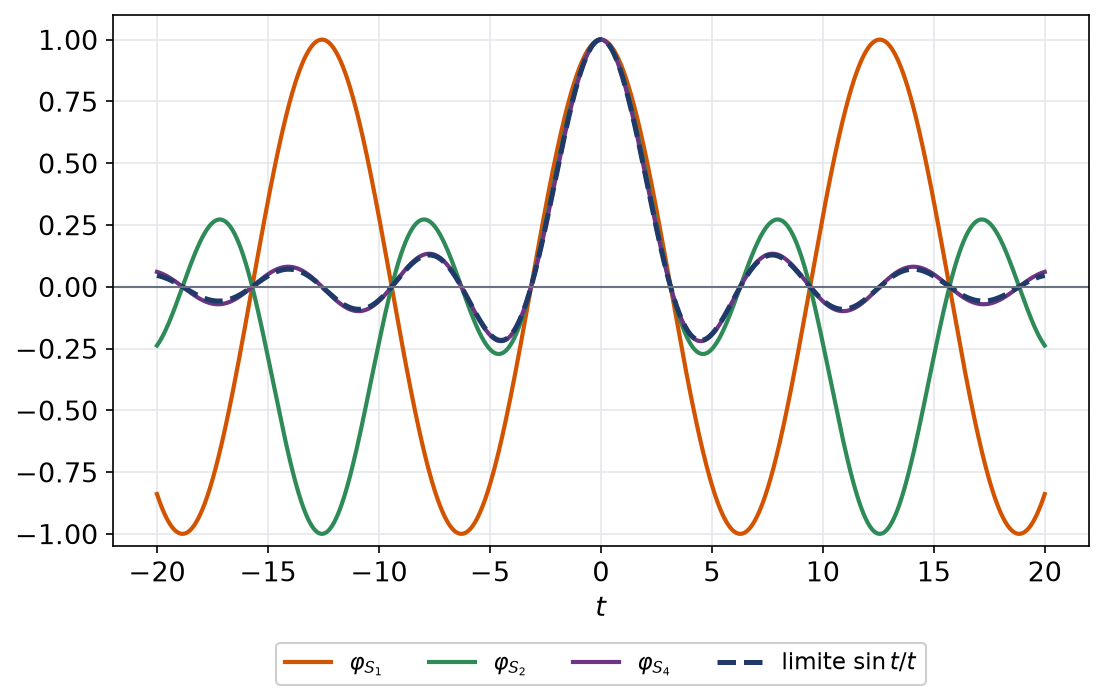
- Pour \(t \neq 0\) et \(n\) assez grand, \(\sin(t/2^n) \neq 0\), donc \(\varphi_{S_n}(t) = \frac{\sin t}{2^n\sin(t/2^n)}\). Or \(2^n\sin(t/2^n) \to t\). Ainsi, \(\varphi_{S_n}(t) \to \sin t/t\), et \(\varphi_{S_n}(0) = 1\). Comme dans l’exercice 2, on reconnaît la fonction caractéristique de la loi uniforme sur \([-1, 1]\). Le théorème de Lévy donne la convergence en loi de \(S_n\) vers cette loi.
La figure montre que trois ou quatre facteurs suffisent déjà à reproduire la limite près de l’origine.
- Pour tout \(\omega\), la série \(\sum\varepsilon_k2^{-k}\) converge absolument, car \(\sum 2^{-k} = 1\). Donc \(S_n \to S\) partout, et en particulier en loi. Par unicité de la loi limite, \(S\) suit la loi uniforme sur \([-1, 1]\). Enfin, les variables \(B_k = (\varepsilon_k + 1)/2\) sont i.i.d. de Bernoulli de paramètre \(1/2\), et \((S + 1)/2 = \sum_{k \geq 1} B_k2^{-k}\). Un réel dont les chiffres binaires sont des pile ou face indépendants suit donc la loi uniforme sur \([0, 1]\).
Corrigé de l’exercice 21 – Problème – Autour de la loi de Laplace
Idée clé : la fonction caractéristique \(1/(1 + t^2)\) se calcule par indépendance, puis elle fournit les moments et un théorème central limite explicite.
- On a \(\varphi_X(t) = \frac{1}{1 – it}\) et \(\varphi_{-Y}(t) = \varphi_Y(-t) = \frac{1}{1 + it}\). Par indépendance, \(\varphi_Z(t) = \dfrac{1}{(1 – it)(1 + it)} = \dfrac{1}{1 + t^2}\).
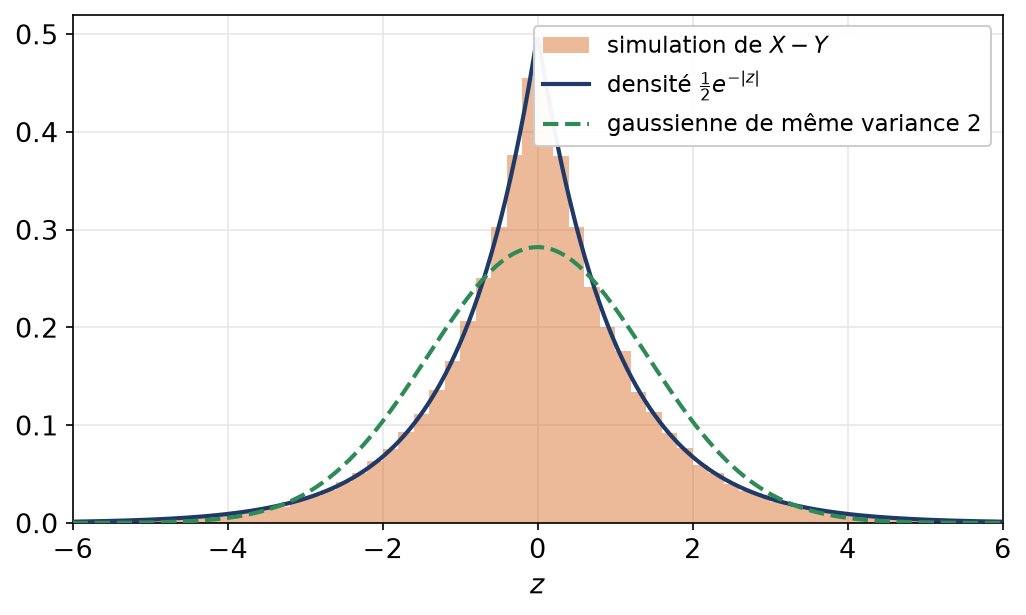
- La densité de \(Z\) est donnée par le produit de convolution \(f(z) = \int_{\mathbb{R}} f_X(z + y)f_Y(y)\,dy\). L’intégrande vaut \(e^{-z-2y}\) lorsque \(y \geq 0\) et \(z + y \geq 0\), et \(0\) sinon. Pour \(z \geq 0\), on obtient \(\int_0^{+\infty}e^{-z-2y}\,dy = \frac{1}{2}e^{-z}\). Pour \(z < 0\), on obtient \(\int_{-z}^{+\infty}e^{-z-2y}\,dy = \frac{1}{2}e^{-z}e^{2z} = \frac{1}{2}e^{z}\). Donc \(f(z) = \frac{1}{2}e^{-|z|}\). Vérification directe :
\[\int_{\mathbb{R}}\tfrac{1}{2}e^{-|z|}e^{itz}\,dz = \frac{1}{2}\left(\frac{1}{1 – it} + \frac{1}{1 + it}\right) = \frac{1}{1 + t^2}.\] - Au voisinage de \(0\), \(\frac{1}{1 + t^2} = 1 – t^2 + o(t^2)\). Il n’y a pas de terme en \(t\), donc \(\mathbb{E}[Z] = 0\), et \(\frac{1}{2}\mathbb{E}[Z^2] = 1\). Enfin, \(\mathbb{E}[|Z|] = \int_0^{+\infty}ze^{-z}\,dz = 1\). On obtient \(\mathbb{E}[Z] = 0\), \(\operatorname{Var}(Z) = 2\) et \(\mathbb{E}[|Z|] = 1\).
- Par indépendance, \(\varphi_{T_n}(t) = \left(1 + \frac{t^2}{2n}\right)^{-n} = \exp\left(-n\ln\left(1 + \frac{t^2}{2n}\right)\right)\). Ici, tout est réel et positif, donc le logarithme ne pose aucun problème. Comme \(n\ln(1 + t^2/(2n)) \to t^2/2\), on a \(\varphi_{T_n}(t) \to e^{-t^2/2}\). Le théorème de Lévy donne \(T_n \to \mathcal{N}(0, 1)\) en loi.
La figure compare la densité de Laplace à une simulation et à la gaussienne de même variance.
- La somme de \(200\) variables a pour variance \(400\), donc pour écart type \(20\). D’après la question 4, \(\mathbb{P}(|Z_1 + \dots + Z_{200}| \geq 30) \approx \mathbb{P}(|G| \geq 1{,}5)\) avec \(G \sim \mathcal{N}(0, 1)\). On obtient environ \(2(1 – 0{,}933) \approx 0{,}134\).
- Les variables \(|Z_k|\) et \(Z_k^2\) sont i.i.d. et intégrables, d’espérances \(1\) et \(2\). La loi forte des grands nombres donne les limites presque sûres \(1\) et \(2\).
Pour aller plus loin
- Revoir la leçon : cours de L3 de maths sur convergence en loi et TCL
- S’exercer : exercices corrigés de L3 de maths sur convergence en loi et TCL
- Bases utiles : Loi, espérance et indépendance en théorie de la mesure
- Chapitre d’avant : Loi, espérance et indépendance en théorie de la mesure
- Vérifier ses acquis : QCM de L3 de maths sur convergence en loi et TCL
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «corrigé des exercices : Convergence en loi et TCL en L3 de maths» au format PDF afin de pouvoir travailler en totale autonomie.