Espérance et indépendance en L3 de maths : cours et méthodes
Ce chapitre relit les probabilités avec les outils de la théorie de la mesure. Nous voyons une probabilité comme une mesure de poids total 1, un hasard numérique comme une application mesurable, et une moyenne comme une intégrale de Lebesgue. Le cours espérance indépendance L3 montre que ce cadre unifie enfin les lois discrètes et les lois à densité.
Nous mettons l’accent sur les méthodes. D’abord, la fonction muette détermine une loi image. Ensuite, le changement de variables avec jacobien traite les vecteurs aléatoires. Puis nous étudions l’indépendance de tribus et de variables, la covariance et l’espérance conditionnelle dans les cas élémentaires.
Ce chapitre arrive au second semestre de L3, après les théorèmes de convergence et Fubini. Ensuite, il servira de socle aux différentes notions de convergence de suites de variables, jusqu’au théorème central limite.
Ce que vous saurez faire
- Décrire une variable aléatoire comme une fonction mesurable et sa loi comme une mesure image.
- Calculer une espérance grâce au théorème de transfert.
- Déterminer la loi d’une variable transformée par la méthode de la fonction muette.
- Obtenir la loi image d’un couple par un changement de variables avec jacobien.
- Prouver ou réfuter l’indépendance de variables aléatoires.
- Calculer une covariance et une espérance conditionnelle dans les cas élémentaires.
1. Espace probabilisé et loi d’une variable aléatoire
La théorie de la mesure fournit un cadre unique pour toutes les situations aléatoires. Un tirage de dé, une durée de vie ou un point du plan relèvent ainsi du même formalisme. Le prix à payer est un peu de vocabulaire, que nous fixons maintenant.
Un espace probabilisé est un espace mesuré \((\Omega, \mathcal{F}, P)\) dont la mesure vérifie \(P(\Omega) = 1\). Les éléments de la tribu \(\mathcal{F}\) s’appellent des événements.
Toutes les propriétés des mesures s’appliquent donc à \(P\) : additivité dénombrable, continuité croissante et décroissante, sous-additivité. Une propriété vraie hors d’un ensemble de probabilité nulle est dite vraie presque sûrement.
1.1 Variables aléatoires
Une variable aléatoire réelle est une application \(X : \Omega \to \mathbb{R}\) mesurable pour les tribus \(\mathcal{F}\) et \(\mathcal{B}(\mathbb{R})\). Autrement dit, \(\{X \in B\} = X^{-1}(B)\) est un événement pour tout borélien \(B\). Un vecteur aléatoire est une application mesurable à valeurs dans \(\mathbb{R}^d\).
En pratique, la mesurabilité se vérifie sur les intervalles \(]-\infty, t]\), qui engendrent la tribu borélienne. De plus, les composées par des fonctions boréliennes, les sommes, produits et limites simples de variables aléatoires restent des variables aléatoires.
À chaque variable \(X\) on associe la tribu \(\sigma(X) = \{X^{-1}(B) \mid B \in \mathcal{B}(\mathbb{R})\}\). C’est la plus petite tribu qui rend \(X\) mesurable. Elle décrit l’information apportée par la connaissance de \(X\).
1.2 Loi d’une variable aléatoire
La loi de \(X\) est la mesure image \(P_X\) définie sur \(\mathcal{B}(\mathbb{R})\) par \(P_X(B) = P(X \in B)\). C’est une probabilité sur \(\mathbb{R}\). Sa fonction de répartition est \(F_X(t) = P(X \leq t)\).
Deux probabilités sur \(\mathbb{R}\) qui ont la même fonction de répartition sont égales. Ainsi, \(F_X\) caractérise la loi de \(X\).
Les intervalles \(]-\infty, t]\) forment une famille stable par intersection finie qui engendre \(\mathcal{B}(\mathbb{R})\). Deux probabilités qui coïncident sur une telle famille coïncident sur la tribu engendrée, par le lemme d’unicité des mesures. C’est exactement l’hypothèse.
Piège à éviter :
Deux variables qui ont la même loi ne sont pas égales pour autant. Par exemple, si \(X\) suit la loi uniforme sur \([0, 1]\), alors \(1 – X\) a la même loi. Pourtant, \(X\) et \(1 – X\) ne coïncident que sur l’événement \(\{X = 1/2\}\), de probabilité nulle.
2. L’espérance, une intégrale de Lebesgue
L’espérance n’est rien d’autre que l’intégrale de \(X\) contre la mesure \(P\). Tous les théorèmes du semestre précédent s’appliquent donc sans modification : convergence monotone, convergence dominée, Fubini.
Si \(X \geq 0\), on pose \(E[X] = \int_\Omega X \, dP\), élément de \([0, +\infty]\). Si \(E[|X|] < +\infty\), on dit que \(X\) est intégrable et l’on pose \(E[X] = E[X^+] – E[X^-]\).
L’espérance est linéaire et croissante sur les variables intégrables. Ensuite, l’inégalité de Markov découle de la croissance : pour \(X \geq 0\) et \(a > 0\), on a \(a\,\mathbf{1}_{\{X \geq a\}} \leq X\), donc \(P(X \geq a) \leq E[X]/a\).
2.1 Le théorème de transfert
Soit \(X\) une variable aléatoire et \(\varphi : \mathbb{R} \to \mathbb{R}\) borélienne, positive ou telle que \(\varphi(X)\) soit intégrable. Alors \[E[\varphi(X)] = \int_{\mathbb{R}} \varphi(x) \, dP_X(x).\]
Pour \(\varphi = \mathbf{1}_B\), les deux membres valent \(P(X \in B)\). Par linéarité, l’égalité s’étend aux fonctions étagées positives. Ensuite, une fonction borélienne positive est limite croissante de fonctions étagées positives. La convergence monotone, appliquée des deux côtés, conclut. Enfin, le cas intégrable s’obtient avec \(\varphi = \varphi^+ – \varphi^-\).
Ce théorème est fondamental : il ramène tout calcul sur \(\Omega\), espace abstrait, à une intégrale sur \(\mathbb{R}\). On n’a donc presque jamais besoin de connaître \(\Omega\).
2.2 Lois discrètes et lois à densité
Deux familles de lois couvrent l’essentiel des exemples. Leur traitement commun est l’un des bénéfices du point de vue mesuré.
La loi de \(X\) est discrète s’il existe un ensemble dénombrable \(D\) avec \(P(X \in D) = 1\). Elle s’écrit alors \(P_X = \sum_{x \in D} p_x \delta_x\), avec \(p_x = P(X = x)\). La loi de \(X\) est à densité s’il existe \(f \geq 0\) borélienne, d’intégrale 1, telle que \(P_X(B) = \int_B f(x) \, dx\) pour tout borélien \(B\).
Le transfert prend alors deux formes concrètes. Dans le cas discret, \(E[\varphi(X)] = \sum_{x \in D} \varphi(x) p_x\). Dans le cas à densité, \(E[\varphi(X)] = \int_{\mathbb{R}} \varphi(x) f(x) \, dx\). En effet, une somme est une intégrale contre une mesure de comptage pondérée.
- Loi géométrique de paramètre \(p\) sur \(\mathbb{N}^*\) : \(P(N = k) = p(1-p)^{k-1}\), espérance \(1/p\).
- Loi de Poisson de paramètre \(\lambda\) : \(P(N = k) = e^{-\lambda}\lambda^k/k!\), espérance \(\lambda\).
- Loi uniforme sur \([a, b]\) : densité \(\frac{1}{b-a}\) sur \([a, b]\), espérance \(\frac{a+b}{2}\).
- Loi exponentielle de paramètre \(\lambda\) : densité \(\lambda e^{-\lambda x}\) sur \(\mathbb{R}_+\), espérance \(1/\lambda\).
Soit \(T\) de loi exponentielle de paramètre \(\lambda = 4\). Calculons \(E[T^3]\). Par transfert, \(E[T^3] = \int_0^{+\infty} 4x^3 e^{-4x} \, dx\). Le changement de variable \(u = 4x\) donne \(\frac{1}{64}\int_0^{+\infty} u^3 e^{-u} \, du = \frac{3!}{64}\). Ainsi, \(E[T^3] = \frac{3}{32}\). De plus, Markov donne \(P(T^3 \geq 1) \leq \frac{3}{32}\), alors que la vraie valeur est \(e^{-4} \approx 0{,}018\).
2.3 Passages à la limite sous l’espérance
Les grands théorèmes d’intégration se traduisent directement en langage probabiliste. Nous les reformulons, car ils justifient la plupart des calculs de séries et de limites.
- (Convergence monotone) Si \(0 \leq X_n\) croît presque sûrement vers \(X\), alors \(E[X_n]\) croît vers \(E[X]\).
- (Séries positives) Si les \(X_n\) sont positives, alors \(E\big[\sum_n X_n\big] = \sum_n E[X_n]\) dans \([0, +\infty]\).
- (Convergence dominée) Si \(X_n \to X\) presque sûrement et \(|X_n| \leq Y\) avec \(Y\) intégrable, alors \(E[X_n] \to E[X]\).
Par exemple, pour \(X \geq 0\), la suite \(\min(X, n)\) croît vers \(X\). Ainsi \(E[\min(X, n)] \to E[X]\), même lorsque cette limite est infinie. Ce procédé de troncature ramène souvent une question sur une variable quelconque à des variables bornées.
Remarque :
Une espérance peut être infinie pour une variable finie presque partout. C’est le cas d’une variable entière \(N\) telle que \(P(N = k)\) soit proportionnelle à \(1/k^2\). En effet, la série \(\sum k \cdot \frac{1}{k^2}\) diverge. Il faut donc toujours vérifier l’intégrabilité avant d’utiliser la linéarité.
3. Déterminer une loi : la méthode de la fonction muette
Soit \(Y = g(X)\). Pour connaître la loi de \(Y\), il suffit de connaître \(E[h(Y)]\) pour une classe assez riche de fonctions \(h\). C’est le principe de la fonction muette.
Soit \(Y\) une variable aléatoire et \(f \geq 0\) une densité. Si \(E[h(Y)] = \int_{\mathbb{R}} h(y) f(y) \, dy\) pour toute fonction \(h\) borélienne bornée, alors \(Y\) a pour densité \(f\).
La preuve est immédiate : on prend \(h = \mathbf{1}_B\). Toutefois, l’intérêt de la méthode vient de la souplesse de \(h\). En effet, on peut effectuer un changement de variable dans l’intégrale sans se soucier de la monotonie globale de \(g\).
- Écrire \(E[h(g(X))]\) par transfert, sous forme d’intégrale contre la loi de \(X\).
- Découper le domaine en morceaux où \(g\) est un \(C^1\)-difféomorphisme.
- Sur chaque morceau, poser \(y = g(x)\) et remplacer \(dx\) par \(|(g^{-1})^{\prime}(y)| \, dy\).
- Regrouper les morceaux pour obtenir \(\int h(y) f(y) \, dy\) et lire la densité \(f\).
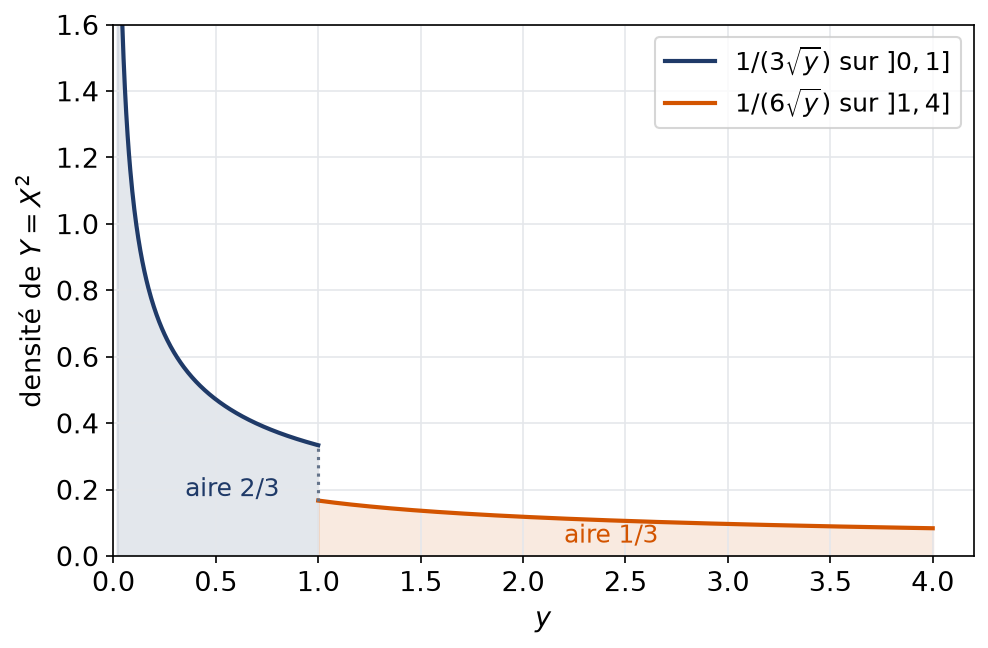
Soit \(X\) uniforme sur \([-1, 2]\) et \(Y = X^2\). Pour \(h\) bornée, \(E[h(Y)] = \frac{1}{3}\int_{-1}^{2} h(x^2) \, dx\). Nous coupons en \([-1, 0]\) et \([0, 2]\). Sur \([-1, 0]\), on pose \(x = -\sqrt{y}\) ; sur \([0, 2]\), on pose \(x = \sqrt{y}\). Dans les deux cas, \(dx\) devient \(\frac{dy}{2\sqrt{y}}\). On obtient \[E[h(Y)] = \frac{1}{3}\int_0^1 \frac{h(y)}{2\sqrt{y}} \, dy + \frac{1}{3}\int_0^4 \frac{h(y)}{2\sqrt{y}} \, dy.\] Par conséquent, \(Y\) a pour densité \(\frac{1}{3\sqrt{y}}\) sur \(]0, 1]\) et \(\frac{1}{6\sqrt{y}}\) sur \(]1, 4]\).
La figure montre cette densité. Elle saute en \(y = 1\), car les valeurs de \(Y\) inférieures à 1 proviennent de deux zones de \(X\), les autres d’une seule.
Piège à éviter :
Oublier une branche de \(g^{-1}\) est l’erreur la plus courante. Un contrôle simple consiste à vérifier que la densité obtenue a une intégrale égale à 1. Ici, \(\frac{2}{3} + \frac{1}{3} = 1\).
4. Vecteurs aléatoires et changement de variables
Un vecteur aléatoire \(Z = (X, Y)\) a une loi \(P_Z\) sur \(\mathbb{R}^2\). Cette loi conjointe contient bien plus d’information que les deux lois \(P_X\) et \(P_Y\), appelées lois marginales.
Si \((X, Y)\) a pour densité \(f\) sur \(\mathbb{R}^2\), alors \(X\) a pour densité \(f_X(x) = \int_{\mathbb{R}} f(x, y) \, dy\), et de même pour \(Y\).
Cette formule découle de Tonelli. En effet, pour \(h\) borélienne positive, \(E[h(X)] = \iint h(x) f(x, y) \, dx \, dy = \int h(x) f_X(x) \, dx\). La réciproque est fausse : deux marginales à densité ne garantissent pas que le couple en ait une. Par exemple, le couple \((X, X)\) est porté par une droite, de mesure de Lebesgue nulle.
4.1 Le théorème du jacobien
On considère un vecteur \(Z\) à valeurs dans \(\mathbb{R}^d\), dont la densité \(f\) s’annule en dehors d’un ouvert \(U\). On le transforme par une bijection \(\Phi\) de \(U\) sur un ouvert \(V\), de classe \(C^1\) ainsi que sa réciproque. Dans ces conditions, \(W = \Phi(Z)\) a pour densité \[g(w) = f(\Phi^{-1}(w)) \, |\det J_{\Phi^{-1}}(w)| \, \mathbf{1}_V(w).\]
Pour \(h\) borélienne positive, le transfert donne \(E[h(W)] = \int_U h(\Phi(z)) f(z) \, dz\). Le théorème de changement de variables du chapitre précédent, avec \(z = \Phi^{-1}(w)\), transforme cette intégrale en \(\int_V h(w) f(\Phi^{-1}(w)) |\det J_{\Phi^{-1}}(w)| \, dw\). La fonction muette conclut.
- Compléter la variable étudiée en un couple, par exemple \((g(X, Y), X)\), pour obtenir une bijection.
- Déterminer précisément l’image \(V\) de l’ouvert de départ.
- Exprimer \((x, y)\) en fonction des nouvelles variables et calculer le jacobien de cette application réciproque.
- Écrire la densité du couple, puis intégrer la variable auxiliaire pour obtenir la marginale cherchée.
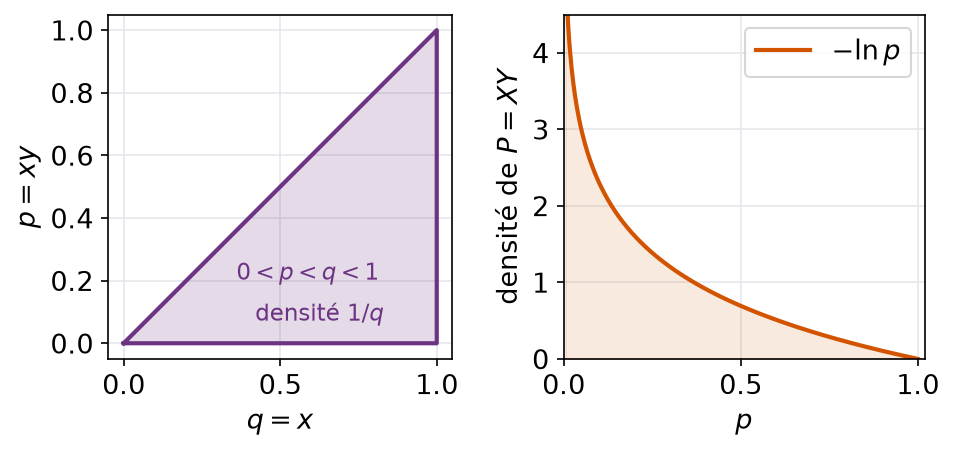
Soit \(X\) et \(Y\) indépendantes, uniformes sur \(]0, 1[\). Le couple a alors pour densité 1 sur \(]0, 1[^2\), comme nous le justifierons dans la partie 5. Cherchons la loi de \(P = XY\). Nous complétons avec \(Q = X\). L’application \((x, y) \mapsto (xy, x)\) est un \(C^1\)-difféomorphisme de \(]0, 1[^2\) sur \(V = \{(p, q) \mid 0 < p < q < 1\}\). Sa réciproque est \((p, q) \mapsto (q, p/q)\). Son jacobien vaut \[\det \begin{pmatrix} 0 & 1 \\ 1/q & -p/q^2 \end{pmatrix} = -\frac{1}{q}.\] Le couple \((P, Q)\) a donc pour densité \(\frac{1}{q}\) sur \(V\). Ensuite, on intègre en \(q\) : \(f_P(p) = \int_p^1 \frac{dq}{q} = -\ln p\) pour \(0 < p < 1\).
À gauche, la figure représente le domaine \(V\) ; à droite, la densité de \(P\). Celle-ci explose en 0, car un produit de deux nombres de \(]0, 1[\) est souvent petit.
Remarque :
En dimension 1, le théorème du jacobien redonne exactement la méthode de la partie 3 sur chaque intervalle de monotonie. Ainsi, les deux méthodes n’en font qu’une. Cependant, en dimension 2, le choix de la variable auxiliaire compte beaucoup : un mauvais choix rend le domaine image difficile à décrire. On choisit donc la variable auxiliaire la plus simple possible, souvent l’une des coordonnées de départ.
5. Espérance et indépendance de variables aléatoires
L’indépendance se définit d’abord pour des tribus. Elle se transmet ensuite aux variables par l’intermédiaire des tribus \(\sigma(X)\).
Des sous-tribus \(\mathcal{A}_1, \ldots, \mathcal{A}_n\) de \(\mathcal{F}\) sont indépendantes si \(P(A_1 \cap \cdots \cap A_n) = P(A_1) \cdots P(A_n)\) pour tous \(A_i \in \mathcal{A}_i\). Des variables \(X_1, \ldots, X_n\) sont indépendantes si les tribus \(\sigma(X_1), \ldots, \sigma(X_n)\) le sont.
Comme chaque tribu contient \(\Omega\), la définition couvre aussi les sous-familles. Une famille infinie est indépendante si toutes ses sous-familles finies le sont.
5.1 Critères d’indépendance
Pour deux variables réelles \(X\) et \(Y\), les propriétés suivantes sont équivalentes :
- \(X\) et \(Y\) sont indépendantes ;
- \(P(X \leq s, Y \leq t) = P(X \leq s)\,P(Y \leq t)\) pour tous réels \(s, t\) ;
- la loi du couple est le produit des lois : \(P_{(X, Y)} = P_X \otimes P_Y\) ;
- \(E[f(X)g(Y)] = E[f(X)]\,E[g(Y)]\) pour toutes \(f, g\) boréliennes bornées.
Le point 1 entraîne trivialement le point 2. Ensuite, sous 2, les mesures \(P_{(X, Y)}\) et \(P_X \otimes P_Y\) coïncident sur les pavés \(]-\infty, s] \times ]-\infty, t]\). Ces pavés forment une famille stable par intersection qui engendre \(\mathcal{B}(\mathbb{R}^2)\). Le lemme d’unicité donne 3. Puis le point 4 découle de 3 par Fubini. Enfin, 4 avec des indicatrices redonne 1.
Si \((X, Y)\) a une densité de la forme \(f(x, y) = a(x)\,b(y)\) sur \(\mathbb{R}^2\), alors \(X\) et \(Y\) sont indépendantes. Réciproquement, si \(X\) et \(Y\) sont indépendantes de densités \(f_X\) et \(f_Y\), le couple a pour densité \(f_X(x) f_Y(y)\).
- Avec une densité conjointe : vérifier qu’elle se factorise et que son support est un pavé.
- Avec des variables discrètes : vérifier \(P(X = x, Y = y) = P(X = x)P(Y = y)\) pour tous les couples de valeurs.
- Dans les autres cas : calculer \(E[f(X)g(Y)]\) pour \(f, g\) bornées et obtenir un produit.
- Pour réfuter : exhiber deux événements \(\{X \in A\}\) et \(\{Y \in B\}\) qui violent la formule produit.
Lançons deux dés équilibrés indépendants \(D_1\) et \(D_2\), et notons \(A\) l’événement « la somme est paire ». Pour chaque \(k\), sachant \(D_1 = k\), la somme est paire pour exactement trois valeurs de \(D_2\). Donc \(P(A \cap \{D_1 = k\}) = \frac{1}{6} \times \frac{1}{2} = P(A)P(D_1 = k)\). Ainsi \(\mathbf{1}_A\) est indépendante de \(D_1\), et de même de \(D_2\). Cependant, les trois variables \(D_1\), \(D_2\), \(\mathbf{1}_A\) ne sont pas indépendantes dans leur ensemble. En effet, si \(D_1\) et \(D_2\) sont impairs, la somme est paire. Par conséquent, \(P(D_1 \text{ impair}, D_2 \text{ impair}, A^c) = 0\), alors que le produit des trois probabilités vaut \(\frac{1}{8}\).
Piège à éviter :
L’indépendance deux à deux n’entraîne pas l’indépendance mutuelle, comme le montre l’exemple précédent. Pour une famille de plus de deux variables, il faut vérifier la formule produit sur toutes les sous-familles, ou utiliser la loi conjointe complète.
Enfin, l’indépendance se conserve par composition. Si \(X\) et \(Y\) sont indépendantes, alors \(\varphi(X)\) et \(\psi(Y)\) le sont aussi, car \(\sigma(\varphi(X)) \subset \sigma(X)\). Plus généralement, des fonctions de paquets disjoints de variables indépendantes restent indépendantes : c’est le lemme des coalitions.
5.2 Espérance d’un produit
Si \(X\) et \(Y\) sont indépendantes et intégrables, alors \(XY\) est intégrable et \(E[XY] = E[X]\,E[Y]\).
Par Tonelli et le point 3 du théorème, \(E[|XY|] = \iint |x|\,|y| \, dP_X(x) \, dP_Y(y) = E[|X|]\,E[|Y|]\), qui est fini. Ensuite, Fubini donne la même factorisation sans les valeurs absolues.
6. Variance et covariance
Pour des variables de carré intégrable, on mesure la dispersion par la variance. On mesure ensuite le lien linéaire entre deux variables par la covariance.
Pour \(X, Y\) de carré intégrable, on pose \(\mathrm{Cov}(X, Y) = E[(X – E[X])(Y – E[Y])] = E[XY] – E[X]E[Y]\), et \(\mathrm{Var}(X) = \mathrm{Cov}(X, X)\).
La covariance est bilinéaire et symétrique. De plus, l’inégalité de Cauchy-Schwarz donne \(|\mathrm{Cov}(X, Y)| \leq \sqrt{\mathrm{Var}(X)\mathrm{Var}(Y)}\). Par ailleurs, la variance d’une somme se développe : \[\mathrm{Var}(X_1 + \cdots + X_n) = \sum_{i=1}^n \mathrm{Var}(X_i) + 2\sum_{i < j} \mathrm{Cov}(X_i, X_j).\]
Si \(X\) et \(Y\) sont indépendantes et de carré intégrable, alors \(\mathrm{Cov}(X, Y) = 0\). Par conséquent, la variance d’une somme de variables indépendantes est la somme des variances.
Par exemple, une variable binomiale de paramètres \(n\) et \(p\) s’écrit comme somme de \(n\) variables de Bernoulli indépendantes de paramètre \(p\). Chacune a pour variance \(p(1-p)\). Sa variance vaut donc \(np(1-p)\), sans aucun calcul de série. Cette technique des indicatrices s’applique encore sans indépendance : il faut alors ajouter les covariances.
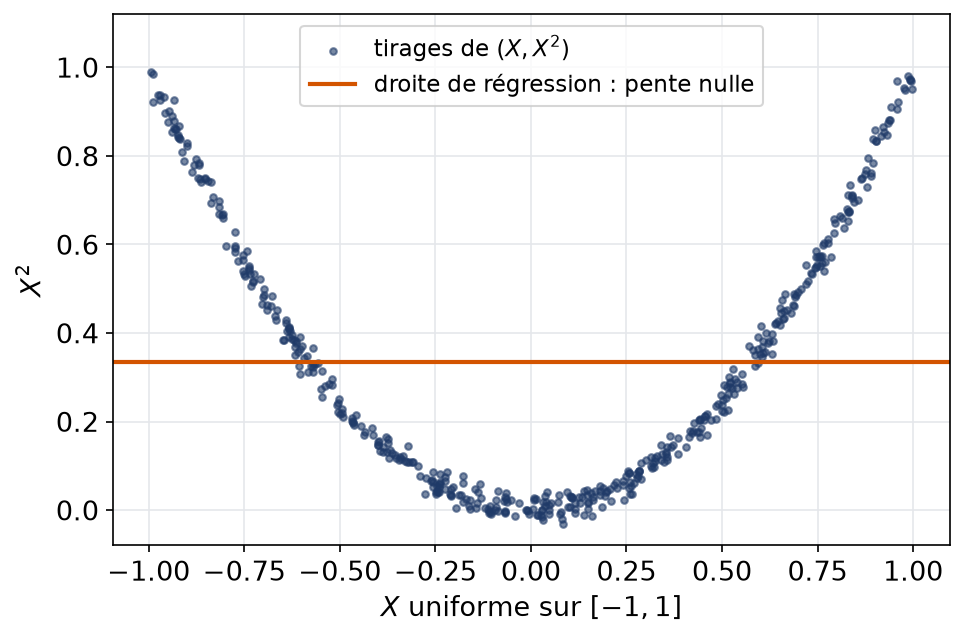
La réciproque est fausse. Soit \(X\) uniforme sur \([-1, 1]\) et \(Y = X^2\). Par symétrie, \(E[X] = 0\) et \(E[X^3] = 0\). Donc \(\mathrm{Cov}(X, Y) = E[X^3] – E[X]E[X^2] = 0\). Pourtant, \(P(X > 1/2,\ Y < 1/4) = 0\), alors que \(P(X > 1/2) = 1/4\) et \(P(Y < 1/4) = 1/2\). Les variables ne sont donc pas indépendantes.
Le nuage de points illustre ce phénomène. La dépendance est totale, puisque \(Y\) est une fonction de \(X\). Cependant, la meilleure droite d’ajustement est horizontale : la covariance ne détecte que les liens affines.
7. Espérance conditionnelle : les cas élémentaires
Connaître la valeur de \(Y\) modifie la prévision que l’on peut faire de \(X\). L’espérance conditionnelle formalise cette prévision révisée. Nous nous limitons ici aux deux situations où elle se calcule explicitement.
7.1 Conditionnement par une variable discrète
Soit \(X\) intégrable et \(Y\) discrète, à valeurs dans un ensemble dénombrable \(D\) avec \(P(Y = y) > 0\) pour tout \(y \in D\). On pose \[\psi(y) = \frac{E[X \mathbf{1}_{\{Y = y\}}]}{P(Y = y)}.\] L’espérance conditionnelle de \(X\) sachant \(Y\) est la variable aléatoire \(E[X \mid Y] = \psi(Y)\).
La variable \(\psi(Y)\) est intégrable et vérifie \(E[X g(Y)] = E[\psi(Y) g(Y)]\) pour toute \(g\) bornée. En particulier, \(E\big[E[X \mid Y]\big] = E[X]\). De plus, si \(X\) et \(Y\) sont indépendantes, alors \(E[X \mid Y] = E[X]\).
On décompose selon les valeurs de \(Y\) : \(E[X g(Y)] = \sum_{y \in D} g(y) E[X \mathbf{1}_{\{Y = y\}}]\), par convergence dominée. Or chaque terme vaut \(g(y)\psi(y)P(Y = y)\), et la somme obtenue est exactement \(E[\psi(Y) g(Y)]\). Le cas \(g = 1\) donne la deuxième formule. Enfin, sous indépendance, \(E[X \mathbf{1}_{\{Y = y\}}] = E[X]P(Y = y)\).
Soit \(X\) et \(Y\) indépendantes de loi géométrique de paramètre \(p\) sur \(\mathbb{N}^*\), et \(S = X + Y\). Pour \(n \geq 2\) et \(1 \leq k \leq n-1\), on a \(P(X = k, S = n) = p(1-p)^{k-1} \cdot p(1-p)^{n-k-1} = p^2(1-p)^{n-2}\). Cette quantité ne dépend pas de \(k\). Sachant \(S = n\), \(X\) est donc uniforme sur \(\{1, \ldots, n-1\}\). Par conséquent, \(E[X \mid S] = \frac{S}{2}\), résultat que la symétrie entre \(X\) et \(Y\) laissait prévoir.
Deux règles de calcul découlent de la caractérisation. D’abord, l’espérance conditionnelle est linéaire en \(X\). Ensuite, une fonction de \(Y\) se comporte comme une constante : \(E[\varphi(Y)X \mid Y] = \varphi(Y)\,E[X \mid Y]\) pour \(\varphi\) bornée. Ces règles évitent de revenir à la définition dans chaque calcul.
7.2 Conditionnement avec une densité
Soit \((X, Y)\) de densité \(f\), avec \(X\) intégrable, et \(f_Y\) la densité de \(Y\). Pour \(f_Y(y) > 0\), on pose \[\psi(y) = \frac{1}{f_Y(y)}\int_{\mathbb{R}} x f(x, y) \, dx,\] et \(\psi(y) = 0\) sinon. Alors \(E[X g(Y)] = E[\psi(Y) g(Y)]\) pour toute \(g\) bornée, et l’on note \(E[X \mid Y] = \psi(Y)\).
La preuve repose sur Fubini : les deux membres valent \(\iint x\,g(y) f(x, y) \, dx \, dy\). Autrement dit, \(\psi(y)\) est la moyenne de \(X\) pour la densité conditionnelle \(x \mapsto f(x, y)/f_Y(y)\).
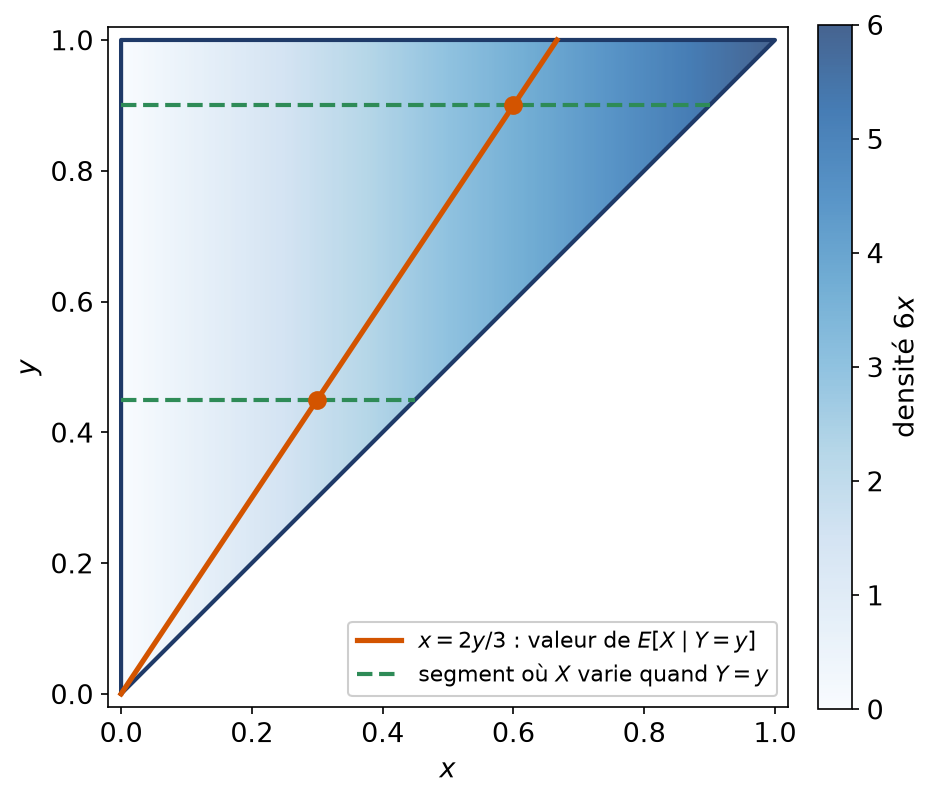
Soit \((X, Y)\) de densité \(6x\) sur \(\{0 < x < y < 1\}\). D’abord, \(f_Y(y) = \int_0^y 6x \, dx = 3y^2\) sur \(]0, 1[\). Ensuite, \(\int_0^y 6x^2 \, dx = 2y^3\). Donc \(\psi(y) = \frac{2y^3}{3y^2} = \frac{2y}{3}\), et \(E[X \mid Y] = \frac{2Y}{3}\). Vérifions la cohérence : \(E[Y] = \int_0^1 3y^3 \, dy = \frac{3}{4}\), donc \(E\big[\frac{2Y}{3}\big] = \frac{1}{2}\). Le calcul direct donne bien \(E[X] = \iint 6x^2 = \int_0^1 2y^3 \, dy = \frac{1}{2}\).
Remarque :
Le cas général, où \(Y\) n’est ni discrète ni à densité, demande le théorème de Radon-Nikodym ou une projection dans \(L^2\). Il sort du programme de ce chapitre. Cependant, la propriété \(E[Xg(Y)] = E[\psi(Y)g(Y)]\) reste la définition à retenir.
Les erreurs fréquentes
- Donner une densité sans préciser son domaine, puis intégrer sur le mauvais intervalle.
- Oublier une branche de la réciproque dans la méthode de la fonction muette.
- Conclure à l’indépendance à partir d’une densité factorisée dont le support n’est pas un pavé.
- Déduire l’indépendance d’une covariance nulle.
- Oublier la valeur absolue du jacobien, ou prendre le jacobien de \(\Phi\) au lieu de celui de \(\Phi^{-1}\).
- Écrire \(E[X \mid Y]\) comme un nombre, alors que c’est une variable aléatoire fonction de \(Y\).
Fiche mémo
- Probabilité = mesure de poids total 1 ; variable aléatoire = application mesurable vers \(\mathbb{R}\) ou \(\mathbb{R}^d\).
- La loi \(P_X\) est la mesure image ; la fonction de répartition la caractérise.
- Transfert : \(E[\varphi(X)] = \int \varphi \, dP_X\), somme dans le cas discret, intégrale contre \(f\) dans le cas à densité.
- Fonction muette : si \(E[h(Y)] = \int h f\) pour toute \(h\) bornée, alors \(Y\) a pour densité \(f\).
- Jacobien : \(W = \Phi(Z)\) a pour densité \(f(\Phi^{-1}(w))\,|\det J_{\Phi^{-1}}(w)|\) sur l’image.
- Indépendance : loi du couple égale au produit des lois, ou \(E[f(X)g(Y)] = E[f(X)]E[g(Y)]\).
- Densité factorisée sur un pavé : indépendance.
- \(\mathrm{Cov}(X, Y) = E[XY] – E[X]E[Y]\) ; nulle si indépendance, sans réciproque.
- \(E[X \mid Y] = \psi(Y)\) vérifie \(E[Xg(Y)] = E[\psi(Y)g(Y)]\) et \(E\big[E[X \mid Y]\big] = E[X]\).
Questions fréquentes
Quelle différence entre une variable aléatoire et sa loi ?
La variable est une fonction mesurable définie sur l’espace \(\Omega\). Sa loi est la mesure image sur \(\mathbb{R}\) ou \(\mathbb{R}^d\). Deux variables très différentes, définies sur des espaces différents, peuvent avoir la même loi. Tous les calculs d’espérance de \(\varphi(X)\) ne dépendent que de la loi.
Pourquoi utiliser la fonction muette plutôt que la fonction de répartition ?
La fonction de répartition marche bien en dimension 1 et pour des transformations monotones. La fonction muette s’adapte à toute transformation et à toute dimension. On calcule \(E[h(Y)]\) pour \(h\) mesurable bornée, puis on reconnaît une intégrale contre une densité.
Une covariance nulle prouve-t-elle l'indépendance ?
Non. L’indépendance entraîne une covariance nulle pour des variables de carré intégrable, mais la réciproque est fausse. L’exemple de \(X\) symétrique et de \(X^2\) le montre : la covariance est nulle alors que \(X^2\) est une fonction de \(X\).
Que vaut l'espérance conditionnelle en L3 ?
En L3, on la calcule quand la variable conditionnante est discrète ou quand le couple a une densité. C’est une variable aléatoire de la forme \(\psi(Y)\). Elle vérifie \(E[X g(Y)] = E[\psi(Y) g(Y)]\) pour toute fonction \(g\) bornée, et son espérance vaut \(E[X]\).
Pour aller plus loin
- S’exercer : exercices corrigés de L3 de maths sur espérance et indépendance
- Bases utiles : Beppo Levi, Fatou et convergence dominée, Tonelli, Fubini et changement de variables
- Chapitre d’avant : Bases hilbertiennes, L^2 et transformée de Fourier
- Chapitre d’après : Fonction caractéristique, convergences et TCL
- Vérifier ses acquis : QCM de L3 de maths sur espérance et indépendance
- Contrôle corrigé en temps limité : Fonction muette et espérance conditionnelle : contrôle de maths en L3
- Un autre sujet noté sur 20 : Examen final de probabilités : contrôle de maths en L3
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «espérance et indépendance en L3 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.