Pivot de Gauss et matrices en L1 de maths : cours et méthodes
Pour travailler les matrices en L1, ce chapitre construit d’abord l’outil de calcul le plus utilisé de l’algèbre : le pivot de Gauss. Nous partons des systèmes linéaires et de leur lecture géométrique, puis nous échelonnons pas à pas. Les exemples couvrent les trois issues possibles : une solution, aucune solution ou une infinité de solutions.
Ensuite, le cours introduit le calcul matriciel : somme, produit, transposée, matrices triangulaires et diagonales. Il montre comment inverser une matrice par le pivot et comment calculer son rang, y compris avec un paramètre. Chaque résultat important est démontré, et des contre-exemples signalent les réflexes faux.
Ce chapitre du premier semestre prépare directement les espaces vectoriels, les applications linéaires et les déterminants du second semestre.
Ce que vous saurez faire
- Lire un système linéaire comme une intersection de droites ou de plans, et prévoir le nombre de solutions.
- Échelonner un système par le pivot de Gauss, en notant chaque opération élémentaire.
- Repérer les inconnues principales et secondaires, puis paramétrer l’ensemble des solutions.
- Calculer une somme, un produit et une transposée de matrices, en contrôlant les formats.
- Inverser une matrice carrée par le pivot, ou prouver qu’elle n’est pas inversible.
- Calculer le rang d’une matrice, y compris lorsqu’elle dépend d’un paramètre.
1. Systèmes linéaires et lecture géométrique
Un système linéaire est une liste d’équations du premier degré, posées en même temps. En particulier, les inconnues n’y apparaissent jamais au carré, ni multipliées entre elles. Ainsi, \(3x-2y=1\) est linéaire, alors que \(xy=4\) ne l’est pas.
Un système de \(n\) équations à \(p\) inconnues réelles \(x_1,\dots,x_p\) s’écrit
\[\begin{cases} a_{11}x_1+a_{12}x_2+\dots+a_{1p}x_p=b_1 \\ \quad\vdots \\ a_{n1}x_1+a_{n2}x_2+\dots+a_{np}x_p=b_n \end{cases}\]
Les réels \(a_{ij}\) sont les coefficients, les \(b_i\) forment le second membre. Une solution est un \(p\)-uplet \((x_1,\dots,x_p)\) qui vérifie toutes les équations. Le système est homogène si tous les \(b_i\) sont nuls. Enfin, il est compatible s’il admet au moins une solution, incompatible sinon.
1.1 Deux inconnues : des droites du plan
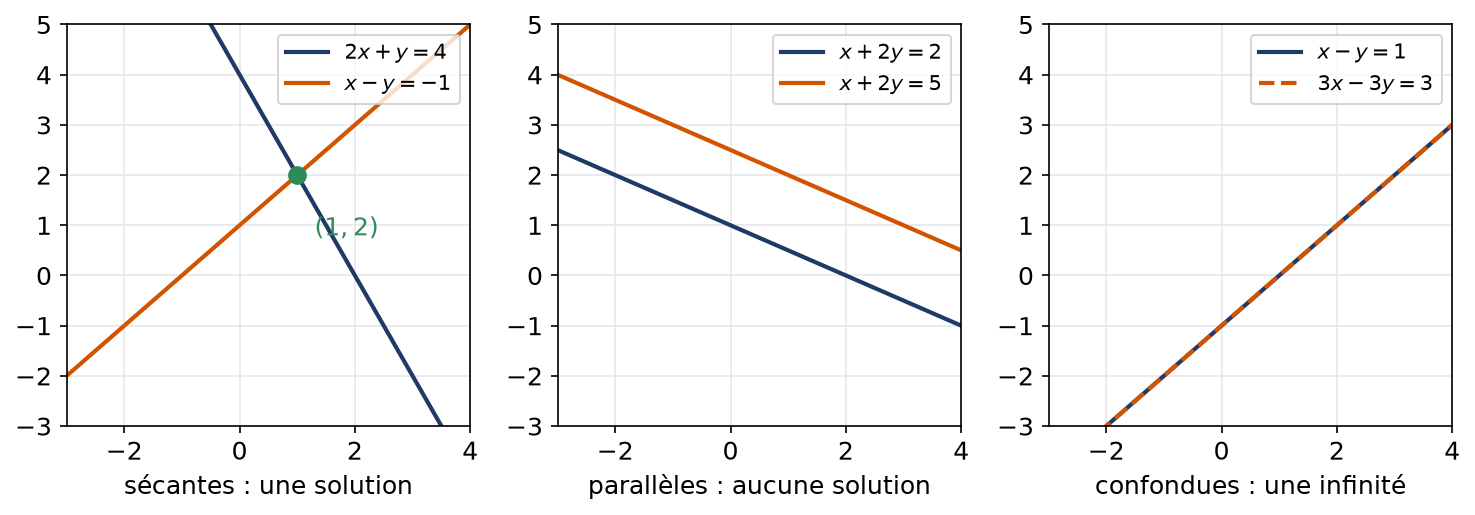
Avec deux inconnues, chaque équation \(ax+by=c\) (avec \((a,b)\neq(0,0)\)) décrit une droite. Résoudre le système revient donc à chercher les points communs à toutes ces droites. Pour deux droites, trois situations seulement se présentent.
- Les droites sont sécantes : il existe une solution unique.
- Les droites sont strictement parallèles : le système est incompatible.
- Les droites sont confondues : il existe une infinité de solutions.
La figure suivante illustre ces trois cas avec des équations simples.
1.2 Trois inconnues : des plans de l’espace
Avec trois inconnues, une équation \(ax+by+cz=d\) non triviale décrit un plan. Par conséquent, l’ensemble des solutions est l’intersection de plusieurs plans. Cette intersection peut être vide, réduite à un point, égale à une droite ou à un plan entier. En revanche, elle ne contient jamais exactement deux points. Nous démontrerons ce fait au paragraphe 3.
Prenons par exemple les plans d’équations \(x+y+z=6\) et \(x-y=0\). Ils ne sont pas parallèles, car leurs vecteurs normaux \((1,1,1)\) et \((1,-1,0)\) ne sont pas colinéaires. Leur intersection est donc une droite. En posant \(y=s\), on trouve \(x=s\) puis \(z=6-2s\). Ainsi, la droite est formée des points \((s,s,6-2s)\), où \(s\) parcourt \(\mathbb{R}\). Si l’on ajoute un troisième plan, par exemple \(z=2\), on impose \(6-2s=2\), donc \(s=2\). Il reste alors le seul point \((2,2,2)\). Chaque équation supplémentaire peut ainsi réduire l’ensemble des solutions, mais elle peut aussi ne rien changer si elle découle des précédentes.
Remarque :
Au-delà de trois inconnues, l’image géométrique disparaît. Cependant, le vocabulaire reste le même : on parle encore de « point » solution et de « droite » de solutions. Le pivot de Gauss, lui, fonctionne quel que soit le nombre d’inconnues.
2. Le pivot de Gauss, pas à pas
L’idée du pivot est ancienne et très simple. En effet, on élimine une inconnue après l’autre, sans jamais perdre ni ajouter de solution. Pour cela, on ne s’autorise que trois transformations, dites élémentaires.
2.1 Les opérations élémentaires
Les équations du système sont appelées ses lignes et notées \(L_1,\dots,L_n\). Trois manipulations sont autorisées :
- permuter deux lignes : \(L_i \leftrightarrow L_j\) ;
- dilater une ligne par un facteur \(\lambda\) différent de zéro : \(L_i \leftarrow \lambda L_i\) ;
- transvecter, c’est-à-dire remplacer \(L_i\) par \(L_i+\mu L_j\), où \(j\neq i\) et \(\mu\) est un réel quelconque.
Après une permutation, une dilatation ou une transvection, le nouveau système possède le même ensemble de solutions que l’ancien.
Pour l’échange, la liste des équations est la même, seul l’ordre change. Pour \(L_i \leftarrow \lambda L_i\), l’égalité \(\lambda u=\lambda v\) équivaut à \(u=v\) car \(\lambda\neq 0\). Reste le cas \(L_i \leftarrow L_i+\mu L_j\). D’abord, toute solution de l’ancien système vérifie \(L_i\) et \(L_j\), donc aussi \(L_i+\mu L_j\). Ensuite, l’opération inverse \(L_i \leftarrow L_i-\mu L_j\) ramène le nouveau système à l’ancien. Ainsi, les solutions du nouveau système sont aussi celles de l’ancien. Les deux ensembles de solutions sont donc égaux.
Piège à éviter :
On n’effectue jamais en même temps \(L_1 \leftarrow L_1-L_2\) et \(L_2 \leftarrow L_2-L_1\). En effet, les deux nouvelles lignes sont alors opposées, et une équation disparaît sans justification. Chaque opération doit utiliser une ligne qui reste inchangée à cette étape.
2.2 La forme échelonnée
Le but du pivot est d’atteindre une forme où chaque ligne commence plus à droite que la précédente. Ensuite, on lit les solutions de bas en haut.
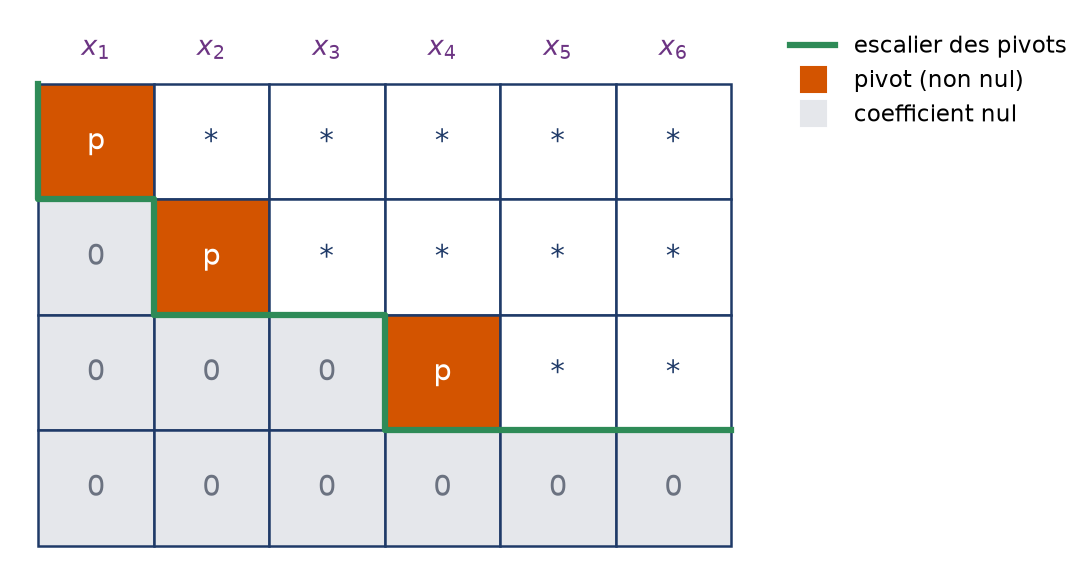
Un système (ou une matrice) est échelonné lorsque :
- les lignes nulles, s’il y en a, sont placées en bas ;
- le premier coefficient non nul de chaque ligne, appelé pivot, est strictement à droite du pivot de la ligne précédente.
Sur la figure, les cases orange sont les pivots et les cases grises sont nulles. On voit bien l’escalier qui donne son nom à la forme échelonnée. De plus, une marche peut couvrir plusieurs colonnes.
2.3 L’algorithme
- Choisir la première colonne qui contient un coefficient non nul. Si besoin, échanger deux lignes pour placer ce coefficient en haut : c’est le pivot.
- Annuler tous les coefficients situés sous le pivot, par des opérations \(L_i \leftarrow L_i-\frac{a_{i}}{a}L_1\), où \(a\) est le pivot.
- Oublier la première ligne et recommencer avec les lignes restantes.
- S’arrêter lorsqu’il ne reste que des lignes nulles ou plus aucune ligne.
- Remonter le système, de la dernière équation vers la première.
En pratique, on choisit si possible un pivot égal à \(1\) ou \(-1\). On évite ainsi les fractions dans les calculs intermédiaires.
Pour éviter les fractions, on peut aussi combiner deux lignes avec des coefficients entiers. Par exemple, si le pivot vaut \(3\) et que le coefficient à annuler vaut \(2\), on effectue \(L_i \leftarrow 3L_i-2L_1\). Cette opération enchaîne une dilatation de facteur \(3\), non nul, puis une transvection. Elle est donc légitime. En revanche, l’écriture \(L_1 \leftarrow 3L_i-2L_1\) remplacerait la mauvaise ligne : on modifie toujours la ligne dont on annule le coefficient.
Remarque :
Pourquoi cet algorithme est-il si important ? D’abord, il s’arrête toujours, car chaque étape traite une colonne de plus. Ensuite, il ne demande que des additions, des multiplications et des divisions. C’est pourquoi les logiciels de calcul l’utilisent encore pour résoudre des systèmes de grande taille. Pour un système carré de taille \(n\), le nombre d’opérations est de l’ordre de \(n^3\), ce qui reste raisonnable.
2.4 Un premier exemple complet
Résolvons le système suivant.
\[\begin{cases} x+2y-z=-1 \\ 2x+5y+z=3 \\ -x+y+4z=4 \end{cases}\]
Le pivot de la première colonne vaut \(1\). Les opérations \(L_2 \leftarrow L_2-2L_1\) et \(L_3 \leftarrow L_3+L_1\) donnent \(y+3z=5\) et \(3y+3z=3\). Ensuite, le pivot de la deuxième colonne est le \(1\) de la nouvelle ligne \(L_2\). L’opération \(L_3 \leftarrow L_3-3L_2\) fournit \(-6z=-12\). Le système échelonné est donc
\[\begin{cases} x+2y-z=-1 \\ y+3z=5 \\ -6z=-12 \end{cases}\]
On remonte : \(z=2\), puis \(y=5-6=-1\), enfin \(x=-1+2+2=3\). L’unique solution est \((3,-1,2)\). Une vérification dans les trois équations de départ confirme le résultat.
3. Inconnues principales, inconnues secondaires
Un système échelonné ne possède pas toujours autant de pivots que d’inconnues. Autrement dit, certaines colonnes n’ont pas de pivot. Ce sont justement elles qui créent l’infinité de solutions.
3.1 Lire les solutions d’un système échelonné
Dans un système échelonné, les inconnues dont la colonne contient un pivot sont les inconnues principales. Les autres sont les inconnues secondaires, ou paramètres. Une ligne de la forme \(0=c\) avec \(c\neq 0\) est une équation incompatible.
Soit un système échelonné.
- S’il contient une équation \(0=c\) avec \(c\neq 0\), il n’a aucune solution.
- Sinon, on choisit librement les inconnues secondaires, et chaque choix donne une unique valeur des inconnues principales.
Par conséquent, un système linéaire admet zéro, une ou une infinité de solutions.
Le premier point est immédiat. Pour le second, on fixe les inconnues secondaires. Ensuite, la dernière ligne non nulle contient une seule inconnue principale, avec un coefficient non nul : elle la détermine. On remonte ainsi ligne par ligne. S’il existe au moins une inconnue secondaire, chacune de ses valeurs réelles donne une solution différente : il y en a donc une infinité. S’il n’y en a aucune, la solution est unique.
- Échelonner le système complet, second membre compris.
- Chercher une ligne \(0=c\) avec \(c\neq 0\) : si elle existe, conclure à l’absence de solution.
- Repérer les colonnes des pivots et nommer les inconnues secondaires.
- Exprimer les inconnues principales en fonction des secondaires, de bas en haut.
- Écrire l’ensemble des solutions comme un point plus une combinaison des paramètres.
3.2 Une infinité de solutions, ou aucune
Considérons trois équations à quatre inconnues.
\[\begin{cases} x+y+2z-t=1 \\ 2x+3y+3z+t=5 \\ x+2y+z+2t=4 \end{cases}\]
Les opérations \(L_2 \leftarrow L_2-2L_1\) et \(L_3 \leftarrow L_3-L_1\) donnent deux fois la même équation \(y-z+3t=3\). Ensuite, \(L_3 \leftarrow L_3-L_2\) produit la ligne \(0=0\). Il reste deux pivots, dans les colonnes de \(x\) et de \(y\). Ainsi, \(x\) et \(y\) sont principales, tandis que \(z\) et \(t\) sont secondaires. On remonte : \(y=3+z-3t\), puis \(x=1-y-2z+t=-2-3z+4t\). L’ensemble des solutions est donc
\[\mathcal{S}=\{(-2,3,0,0)+z(-3,1,1,0)+t(4,-3,0,1)\ :\ (z,t)\in\mathbb{R}^2\}.\]
Par exemple, \(z=0\) et \(t=1\) donnent \((2,0,0,1)\), qui vérifie bien les trois équations.
Gardons le même premier membre, mais remplaçons le second membre de la troisième équation par \(6\). Les mêmes opérations conduisent alors à \(y-z+3t=3\), puis à \(y-z+3t=5\). Enfin, \(L_3 \leftarrow L_3-L_2\) donne \(0=2\). Le système est donc incompatible. Géométriquement, il n’existe aucun point commun aux trois hyperplans de \(\mathbb{R}^4\).
Avoir plus d’inconnues que d’équations ne garantit pas une infinité de solutions. Par exemple, le système \(x+y+z=1\), \(x+y+z=2\) n’a aucune solution. De même, autant d’équations que d’inconnues ne garantit pas une solution unique : le système \(x+2y=2\), \(2x+4y=4\) en admet une infinité. Seul le nombre de pivots permet de conclure.
Remarque :
Un système homogène est toujours compatible, car \((0,\dots,0)\) le vérifie. Ainsi, lorsqu’il a plus d’inconnues que d’équations, il possède au moins une inconnue secondaire. Il admet donc une infinité de solutions.
4. Calcul sur les matrices
Dans le pivot, seuls les coefficients comptent : les lettres \(x\), \(y\), \(z\) ne font que marquer les colonnes. Il est donc naturel de ranger ces coefficients dans un tableau. Ainsi apparaît la notion de matrice.
Un tableau rectangulaire \(A=(a_{ij})\) de nombres réels, avec \(n\) lignes et \(p\) colonnes, s’appelle une matrice de format \(n\times p\). L’indice \(i\) repère la ligne du coefficient \(a_{ij}\), l’indice \(j\) sa colonne. Toutes ces matrices forment l’ensemble \(\mathcal{M}_{n,p}(\mathbb{R})\). Quand \(n=p\), la matrice est dite carrée, et cet ensemble s’écrit plus simplement \(\mathcal{M}_n(\mathbb{R})\).
4.1 Somme et produit par un réel
Deux matrices de même format s’additionnent coefficient par coefficient : \((A+B)_{ij}=a_{ij}+b_{ij}\). De même, \((\lambda A)_{ij}=\lambda a_{ij}\). Ces opérations ont les règles habituelles : associativité, commutativité de la somme, distributivité. La matrice nulle \(0_{n,p}\) est l’élément neutre de l’addition.
Par exemple, \(\begin{pmatrix} 1 & -3 \\ 4 & 0 \end{pmatrix}+2\begin{pmatrix} 0 & 1 \\ -1 & 5 \end{pmatrix}=\begin{pmatrix} 1 & -1 \\ 2 & 10 \end{pmatrix}\). En revanche, on n’additionne jamais deux matrices de formats différents : la somme d’une matrice \(2\times 3\) et d’une matrice \(3\times 2\) n’a aucun sens. Ces règles font de \(\mathcal{M}_{n,p}(\mathbb{R})\) un espace vectoriel, notion qui sera étudiée en détail au second semestre.
4.2 Le produit de deux matrices
Soient \(A\in\mathcal{M}_{n,p}(\mathbb{R})\) et \(B\in\mathcal{M}_{p,q}(\mathbb{R})\). Le produit \(AB\) est la matrice de \(\mathcal{M}_{n,q}(\mathbb{R})\) définie par
\[(AB)_{ij}=\sum_{k=1}^{p}a_{ik}b_{kj}.\]
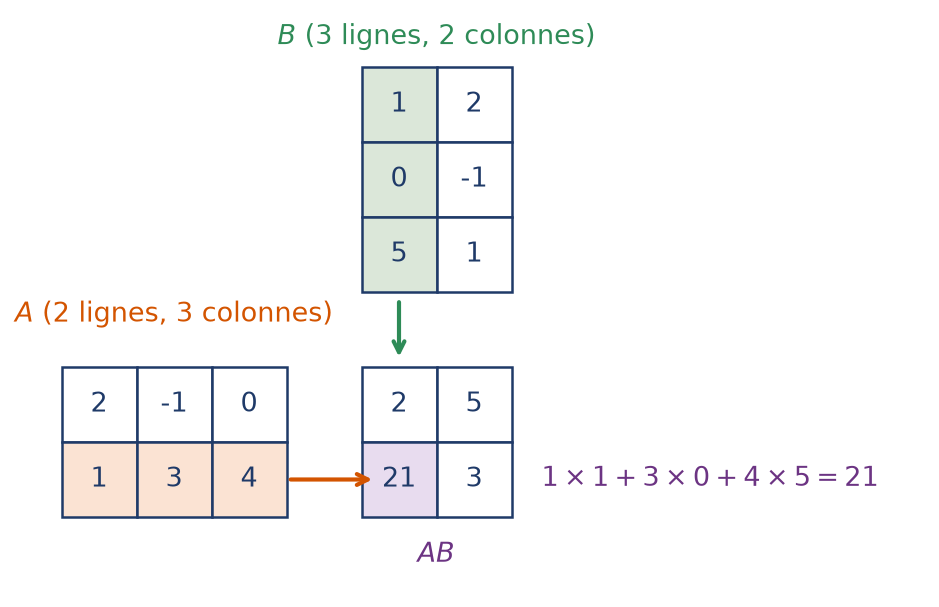
Pour obtenir la case \((i,j)\), on parcourt donc en même temps la \(i\)-ème rangée de \(A\) et la \(j\)-ème colonne de \(B\), terme à terme.
Cette formule a un sens seulement si le nombre de colonnes de \(A\) égale le nombre de lignes de \(B\). La figure montre comment une ligne et une colonne se rencontrent pour fabriquer un coefficient.
Prenons les deux matrices
\[A=\begin{pmatrix} 2 & -1 & 0 \\ 1 & 3 & 4 \end{pmatrix},\qquad B=\begin{pmatrix} 1 & 2 \\ 0 & -1 \\ 5 & 1 \end{pmatrix}.\]
D’abord, \(A\) a trois colonnes et \(B\) trois lignes : \(AB\) existe et possède deux lignes et deux colonnes. Le coefficient \((2,1)\) vaut \(1\times 1+3\times 0+4\times 5=21\). En calculant les trois autres, on obtient
\[AB=\begin{pmatrix} 2 & 5 \\ 21 & 3 \end{pmatrix},\qquad BA=\begin{pmatrix} 4 & 5 & 8 \\ -1 & -3 & -4 \\ 11 & -2 & 4 \end{pmatrix}.\]
Ici, \(AB\) et \(BA\) n’ont même pas le même format.
4.3 Règles de calcul sur les matrices en L1
Lorsque les formats le permettent, on a \((AB)C=A(BC)\), \(A(B+C)=AB+AC\) et \((A+B)C=AC+BC\). Notons \(I_n\) la matrice unité d’ordre \(n\), dont le coefficient \((i,j)\) vaut \(1\) si \(i=j\) et \(0\) sinon. Elle joue le rôle du nombre \(1\) : \(I_nA=A\) et \(AI_p=A\) pour \(A\in\mathcal{M}_{n,p}(\mathbb{R})\).
Piège à éviter :
Le produit matriciel n’est pas commutatif, même entre matrices carrées. En outre, un produit peut être nul sans qu’aucun facteur ne le soit. Ces deux faits interdisent de recopier les réflexes du calcul sur les réels.
Posons \(A=\begin{pmatrix} 0 & 1 \\ 0 & 0 \end{pmatrix}\) et \(B=\begin{pmatrix} 1 & 0 \\ 0 & 0 \end{pmatrix}\). Alors \(AB=0_2\), alors que \(BA=A\neq 0_2\). Ainsi, \(AB\neq BA\), et le produit \(AB\) est nul avec deux facteurs non nuls. Par conséquent, l’égalité \(AB=AC\) n’entraîne pas \(B=C\) en général.
4.4 La transposée
La transposée de \(A\in\mathcal{M}_{n,p}(\mathbb{R})\) est la matrice \({}^tA\in\mathcal{M}_{p,n}(\mathbb{R})\) définie par \(({}^tA)_{ij}=a_{ji}\). Les lignes de \(A\) deviennent les colonnes de \({}^tA\). Une matrice carrée est symétrique si \({}^tA=A\), antisymétrique si \({}^tA=-A\).
Pour des formats compatibles, \({}^t(A+B)={}^tA+{}^tB\), \({}^t({}^tA)=A\) et surtout \({}^t(AB)={}^tB\,{}^tA\).
Seule la dernière formule demande un calcul. Soient \(A\in\mathcal{M}_{n,p}(\mathbb{R})\) et \(B\in\mathcal{M}_{p,q}(\mathbb{R})\). Pour tous \(i\) et \(j\), on a
\[\left({}^t(AB)\right)_{ij}=(AB)_{ji}=\sum_{k=1}^{p}a_{jk}b_{ki}=\sum_{k=1}^{p}({}^tB)_{ik}({}^tA)_{kj}=\left({}^tB\,{}^tA\right)_{ij}.\]
Les deux matrices ont donc les mêmes coefficients. Notons que l’ordre des facteurs s’inverse, ce qui rend aussi les formats compatibles.
5. Matrices carrées et matrices inversibles
5.1 Matrices triangulaires et diagonales
Une matrice \(A\in\mathcal{M}_n(\mathbb{R})\) est triangulaire supérieure si \(a_{ij}=0\) dès que \(i>j\). Elle est triangulaire inférieure si \(a_{ij}=0\) dès que \(i<j\). Enfin, elle est diagonale si \(a_{ij}=0\) dès que \(i\neq j\) ; on note alors \(A=\mathrm{diag}(a_{11},\dots,a_{nn})\).
Le produit de deux matrices triangulaires supérieures est triangulaire supérieure. Ses coefficients diagonaux sont les produits des coefficients diagonaux. En particulier, \(\mathrm{diag}(d_1,\dots,d_n)^k=\mathrm{diag}(d_1^k,\dots,d_n^k)\) pour tout entier \(k\geq 1\).
Soient \(A\) et \(B\) triangulaires supérieures, et \(i>j\). Dans la somme \((AB)_{ij}=\sum_k a_{ik}b_{kj}\), le terme \(a_{ik}\) est nul si \(k<i\). De plus, \(b_{kj}\) est nul si \(k>j\). Or aucun \(k\) ne vérifie \(i\leq k\leq j\), puisque \(i>j\). Chaque terme est donc nul, et \((AB)_{ij}=0\). Pour \(i=j\), seul le terme \(k=i\) survit, d’où \((AB)_{ii}=a_{ii}b_{ii}\). La formule des puissances s’en déduit par récurrence.
Ce résultat a une conséquence pratique. Ainsi, \(\mathrm{diag}(2,-1,\frac{1}{2})^{4}=\mathrm{diag}(16,1,\frac{1}{16})\) se calcule de tête. En revanche, une matrice triangulaire non diagonale a des puissances plus difficiles à prévoir : seuls les coefficients diagonaux se lisent directement. Par exemple, la matrice \(\begin{pmatrix} 2 & 1 \\ 0 & 2 \end{pmatrix}\) a pour carré \(\begin{pmatrix} 4 & 4 \\ 0 & 4 \end{pmatrix}\). Le coefficient en haut à droite ne vaut donc pas \(1^2\).
Remarque :
Les systèmes triangulaires se résolvent sans pivot, par simple remontée. C’est pourquoi l’algorithme de Gauss cherche justement à se ramener à cette forme. De plus, une matrice triangulaire est inversible exactement quand tous ses coefficients diagonaux sont non nuls. En effet, ce sont alors ses \(n\) pivots.
5.2 Matrices inversibles
Soit \(A\) carrée d’ordre \(n\). On dit que \(A\) admet un inverse lorsqu’une matrice \(B\) du même ordre vérifie à la fois \(AB=I_n\) et \(BA=I_n\). Une telle \(B\) est forcément unique ; on la note \(A^{-1}\).
Montrons l’unicité annoncée. Supposons que \(B\) et \(C\) conviennent toutes les deux. Alors \(B=BI_n=B(AC)=(BA)C=I_nC=C\). L’associativité du produit suffit donc.
Si \(A\) et \(B\) sont inversibles, alors \(AB\) l’est, et \((AB)^{-1}=B^{-1}A^{-1}\). De même, \({}^tA\) est inversible, d’inverse \({}^t(A^{-1})\).
Piège à éviter :
En général, \((A+B)^{-1}\) n’est pas \(A^{-1}+B^{-1}\). Par exemple, \(I_2\) et \(-I_2\) sont inversibles, mais leur somme est nulle. De même, on n’écrit jamais \(\frac{B}{A}\) : la position de \(A^{-1}\), à gauche ou à droite, change le résultat.
5.3 Écriture matricielle et inverse par le pivot
Revenons aux systèmes. Notons \(A\) la matrice des coefficients, \(X\) la colonne des inconnues et \(B\) la colonne du second membre. Par définition du produit, le système s’écrit simplement \(AX=B\). Ainsi, lorsque \(A\) est inversible, on obtient \(X=A^{-1}B\) en multipliant à gauche par \(A^{-1}\).
Chaque opération élémentaire sur les lignes de \(A\) revient à multiplier \(A\) à gauche par une matrice inversible \(E\). On obtient \(E\) en appliquant cette même opération à \(I_n\). Par exemple, dans \(\mathcal{M}_3(\mathbb{R})\), l’opération \(L_2 \leftarrow L_2+5L_1\) correspond à la matrice \(E\) ci-dessous.
\[E=\begin{pmatrix} 1 & 0 & 0 \\ 5 & 1 & 0 \\ 0 & 0 & 1 \end{pmatrix},\qquad E^{-1}=\begin{pmatrix} 1 & 0 & 0 \\ -5 & 1 & 0 \\ 0 & 0 & 1 \end{pmatrix}.\]
Pour \(A\in\mathcal{M}_n(\mathbb{R})\), les propriétés suivantes sont équivalentes :
- \(A\) est inversible ;
- le système homogène \(AX=0\) n’a que la solution nulle ;
- la forme échelonnée de \(A\) possède \(n\) pivots ;
- des opérations élémentaires sur les lignes transforment \(A\) en \(I_n\).
Si \(A\) est inversible et \(AX=0\), alors \(X=A^{-1}AX=0\). Ensuite, si \(AX=0\) n’a que la solution nulle, il n’existe aucune inconnue secondaire : il y a donc \(n\) pivots. Avec \(n\) pivots, une dilatation ramène chacun d’eux à \(1\). Ensuite, des transvections menées du bas vers le haut font disparaître tout ce qui se trouve au-dessus de la diagonale. Le résultat est \(I_n\). Enfin, si \(E_k\cdots E_1A=I_n\), la matrice \(P=E_k\cdots E_1\) est inversible comme produit de matrices inversibles. Alors \(A=P^{-1}\), donc \(A\) est inversible d’inverse \(P\).
5.4 Calculer un inverse par le pivot
La preuve fournit une méthode de calcul. En effet, les opérations qui changent \(A\) en \(I_n\) changent \(I_n\) en \(P=A^{-1}\). On les applique donc aux deux matrices en même temps.
- Écrire côte à côte \(A\) et \(I_n\), sous la forme \(\left(A\,|\,I_n\right)\).
- Échelonner la partie gauche ; appliquer chaque opération à toute la ligne.
- Si un pivot manque, conclure que \(A\) n’est pas inversible.
- Sinon, rendre les pivots égaux à \(1\), puis annuler les coefficients au-dessus d’eux.
- Lire \(A^{-1}\) dans la partie droite, et vérifier un produit.
Inversons \(A=\begin{pmatrix} 1 & 0 & 2 \\ 2 & 1 & 3 \\ 1 & 1 & 2 \end{pmatrix}\). D’abord, \(L_2 \leftarrow L_2-2L_1\) et \(L_3 \leftarrow L_3-L_1\) donnent les lignes \((0,1,-1\,|\,-2,1,0)\) et \((0,1,0\,|\,-1,0,1)\). Ensuite, \(L_3 \leftarrow L_3-L_2\) fournit \((0,0,1\,|\,1,-1,1)\). Il y a trois pivots, donc \(A\) est inversible. On remonte avec \(L_2 \leftarrow L_2+L_3\), puis \(L_1 \leftarrow L_1-2L_3\). On obtient finalement
\[A^{-1}=\begin{pmatrix} -1 & 2 & -2 \\ -1 & 0 & 1 \\ 1 & -1 & 1 \end{pmatrix}.\]
Le produit \(AA^{-1}\) redonne bien \(I_3\), ce qui valide le calcul.
6. Rang d’une matrice et nombre de solutions
Le nombre de pivots est l’information essentielle d’une forme échelonnée. Il mérite donc un nom.
6.1 Définition et premières propriétés
On échelonne \(A\in\mathcal{M}_{n,p}(\mathbb{R})\) en agissant sur ses lignes. On compte alors les pivots de la matrice obtenue : ce nombre est le rang de \(A\), que l’on note \(\mathrm{rg}(A)\).
Remarque :
Plusieurs suites d’opérations mènent à des formes échelonnées différentes. Cependant, elles ont toujours le même nombre de pivots. Nous admettons ce fait ici ; il sera démontré avec la notion de dimension, au chapitre sur les espaces vectoriels.
Soit \(A\in\mathcal{M}_{n,p}(\mathbb{R})\) de rang \(r\). Alors \(r\leq n\) et \(r\leq p\). De plus, si le système \(AX=B\) est compatible, ses solutions dépendent de \(p-r\) paramètres. Enfin, une matrice carrée d’ordre \(n\) est inversible si et seulement si son rang vaut \(n\).
Chaque ligne porte au plus un pivot, et chaque colonne aussi : d’où \(r\leq n\) et \(r\leq p\). Ensuite, les \(r\) colonnes à pivot donnent les inconnues principales. Il reste donc \(p-r\) inconnues secondaires, qui sont les paramètres. Le dernier point découle du théorème du paragraphe 5.3.
6.2 Discuter le rang selon un paramètre
Cherchons le rang de \(A_a=\begin{pmatrix} 1 & 1 & 1 \\ 1 & a & 3 \\ 2 & 2 & a \end{pmatrix}\) selon le réel \(a\). Les opérations \(L_2 \leftarrow L_2-L_1\) et \(L_3 \leftarrow L_3-2L_1\) donnent les lignes \((0,a-1,2)\) et \((0,0,a-2)\).
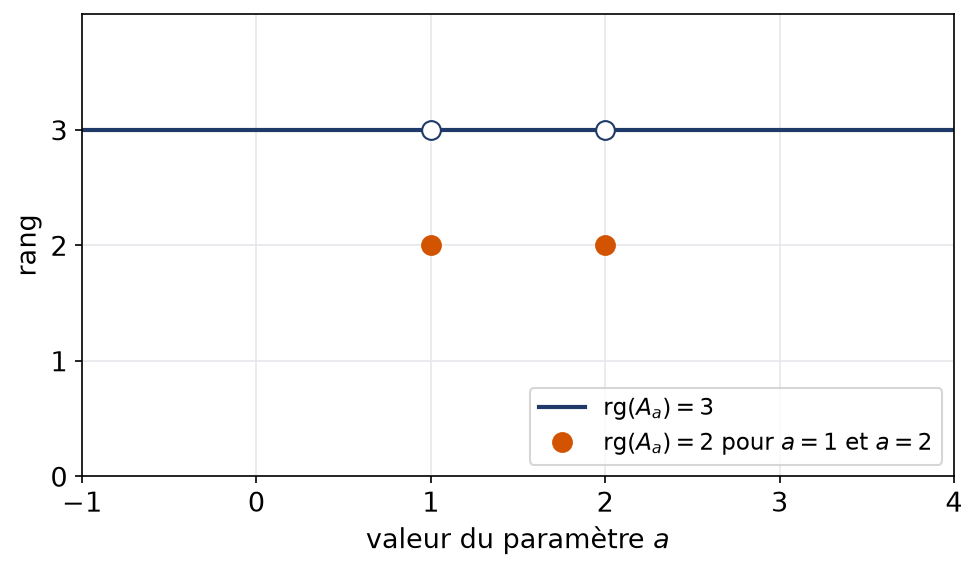
- Si \(a\notin\{1,2\}\), la matrice obtenue est échelonnée avec trois pivots : \(\mathrm{rg}(A_a)=3\).
- Si \(a=2\), la dernière ligne est nulle et \(\mathrm{rg}(A_2)=2\).
- Si \(a=1\), la deuxième ligne devient \((0,0,2)\). Son pivot est en troisième colonne, et l’opération \(L_3 \leftarrow L_3+\frac{1}{2}L_2\) annule la troisième ligne \((0,0,-1)\). Ainsi, \(\mathrm{rg}(A_1)=2\).
Par conséquent, \(A_a\) est inversible si et seulement si \(a\neq 1\) et \(a\neq 2\).
Cet exemple illustre une situation fréquente. Pour presque toutes les valeurs du paramètre, la matrice est de rang maximal. Cependant, quelques valeurs isolées font chuter le rang. Ce sont justement ces valeurs que les sujets d’examen demandent de trouver. Autrement dit, une discussion de rang revient à repérer les valeurs qui annulent un pivot.
La figure résume ce résultat : le rang vaut \(3\) partout, sauf en deux valeurs isolées du paramètre.
Piège à éviter :
Dans une discussion, on ne divise jamais par une expression comme \(a-1\) sans traiter à part le cas où elle s’annule. De plus, il faut reprendre le pivot dans chaque cas particulier : le rang ne se lit pas toujours directement sur la forme générale.
Les erreurs fréquentes
- Combiner deux lignes en les modifiant toutes les deux à la même étape, ce qui fait disparaître une équation.
- Oublier d’appliquer l’opération au second membre, ou à la partie droite de \(\left(A\,|\,I_n\right)\).
- Conclure à une solution unique parce qu’il y a autant d’équations que d’inconnues, sans compter les pivots.
- Calculer \(AB\) au lieu de \(BA\), ou écrire \((AB)^{-1}=A^{-1}B^{-1}\) et \({}^t(AB)={}^tA\,{}^tB\).
- Diviser par un paramètre qui peut s’annuler lors d’une discussion de rang.
Fiche mémo
- Opérations élémentaires : \(L_i \leftrightarrow L_j\), \(L_i \leftarrow \lambda L_i\) avec \(\lambda\neq 0\), \(L_i \leftarrow L_i+\mu L_j\) avec \(j\neq i\). Elles conservent les solutions.
- Forme échelonnée : chaque pivot est strictement à droite du précédent, lignes nulles en bas.
- Une ligne \(0=c\) avec \(c\neq 0\) signale un système incompatible.
- Inconnues principales : colonnes à pivot. Les autres sont des paramètres libres.
- Un système linéaire a zéro, une ou une infinité de solutions.
- Produit : \((AB)_{ij}=\sum_k a_{ik}b_{kj}\), défini si les formats se raccordent ; il n’est pas commutatif.
- \({}^t(AB)={}^tB\,{}^tA\) et \((AB)^{-1}=B^{-1}A^{-1}\).
- Inverse : on transforme \(\left(A\,|\,I_n\right)\) en \(\left(I_n\,|\,A^{-1}\right)\) par opérations sur les lignes.
- Rang : nombre de pivots ; \(p-r\) paramètres pour un système compatible à \(p\) inconnues.
- \(A\in\mathcal{M}_n(\mathbb{R})\) est inversible si et seulement si \(\mathrm{rg}(A)=n\).
Questions fréquentes
Le rang d'une matrice dépend-il des opérations choisies pendant le pivot ?
Non. Deux suites d’opérations différentes peuvent mener à deux formes échelonnées différentes, mais le nombre de pivots est toujours le même. Ce résultat se démontre proprement avec la notion de dimension, vue plus tard dans l’année. En attendant, vous pouvez choisir les pivots les plus commodes.
Comment savoir rapidement si un système a une infinité de solutions ?
Il faut échelonner le système complet, second membre compris. S’il n’apparaît aucune ligne du type 0 = c avec c non nul, et s’il reste au moins une colonne sans pivot, il y a une infinité de solutions. Compter seulement les équations et les inconnues ne suffit pas.
Peut-on faire des opérations sur les colonnes pour inverser une matrice ?
Oui, à condition de ne faire que des opérations sur les colonnes du début à la fin, sur la matrice (A | I) disposée en colonnes. En revanche, mélanger opérations sur les lignes et sur les colonnes dans un même calcul d’inverse donne un résultat faux. Pour la résolution d’un système, seules les opérations sur les lignes sont sûres.
Pourquoi le produit de matrices est-il défini de façon si particulière ?
Cette définition traduit la composition des substitutions linéaires. Si X = BZ et Y = AX, alors Y = (AB)Z, et la formule ligne par colonne est exactement celle qui rend ce calcul vrai. C’est aussi ce qui permet d’écrire un système sous la forme AX = B.
Pour aller plus loin
- S’exercer : exercices corrigés de L1 de maths sur pivot de Gauss et matrices
- Bases utiles : Connecteurs, quantificateurs et types de démonstration
- Chapitre d’avant : Polynômes : division, racines et d'Alembert-Gauss
- Chapitre d’après : Intégrale de Riemann et théorème fondamental
- Vérifier ses acquis : QCM de L1 de maths sur pivot de Gauss et matrices
- Contrôle corrigé en temps limité : Échelonnement et systèmes à paramètre : contrôle de maths en L1
- Un autre sujet noté sur 20 : Partiel d'algèbre du premier semestre : contrôle de maths en L1
- Le même thème en maths sup (MPSI) : Produit matriciel, matrices inversibles et pivot
- Tous les chapitres : le sommaire de la L1 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «pivot de Gauss et matrices en L1 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.