Projection orthogonale en L2 de maths : cours et méthodes
Ce cours de projection orthogonale L2 ouvre l’algèbre bilinéaire du quatrième semestre. Nous partons des formes bilinéaires symétriques pour dégager la notion de produit scalaire, puis nous établissons l’inégalité de Cauchy-Schwarz et ses conséquences sur la norme. Viennent ensuite l’orthogonalité, les bases orthonormées et le procédé de Gram-Schmidt, qui permet d’en construire une à partir de n’importe quelle base.
Le cœur du chapitre est le théorème du supplémentaire orthogonal : il fournit la projection sur un sous-espace et la distance d’un vecteur à ce sous-espace. Nous transposons enfin ces outils aux espaces hermitiens, puis nous les appliquons à la méthode des moindres carrés, qui ajuste une droite ou une parabole à des mesures. Ces résultats préparent directement le théorème spectral et l’étude des formes quadratiques.
Ce que vous saurez faire
- Reconnaître un produit scalaire parmi les formes bilinéaires symétriques, et justifier qu’il est défini positif.
- Trouver un maximum ou une minoration grâce à Cauchy-Schwarz, en exploitant le cas où l’inégalité devient une égalité.
- Orthonormaliser une famille libre par le procédé de Gram-Schmidt.
- Projeter orthogonalement un vecteur sur un sous-espace et calculer sa distance à ce sous-espace.
- Adapter ces calculs au cadre complexe des espaces hermitiens.
- Résoudre un problème de moindres carrés par les équations normales, par exemple pour ajuster une droite à des mesures.
1. Produit scalaire et formes bilinéaires symétriques
En géométrie plane, le produit scalaire mesure à la fois des longueurs et des angles. Nous voulons garder ces deux usages dans un espace vectoriel quelconque. Pour cela, nous isolons les propriétés algébriques qui font fonctionner les calculs. Dans toute cette partie, \(E\) désigne un espace vectoriel réel.
Considérons \(\varphi : E \times E \to \mathbb{R}\). Lorsque \(\varphi\) dépend linéairement de chacune de ses deux variables et ne change pas quand on les échange, on parle de forme bilinéaire symétrique.
On dit que \(\varphi\) est positive quand chaque nombre \(\varphi(x, x)\) est positif ou nul. Elle est définie quand le seul vecteur \(x\) qui annule \(\varphi(x, x)\) est le vecteur nul.
Nous appelons produit scalaire toute forme bilinéaire symétrique à la fois définie et positive, et nous l’écrivons \(\langle x, y \rangle\). Le couple formé de \(E\) et de ce produit est un espace préhilbertien. Quand \(E\) est en outre de dimension finie, nous parlons d’espace euclidien.
Grâce à la symétrie, la linéarité par rapport à la première variable suffit à obtenir la bilinéarité. En pratique, nous vérifions donc la symétrie, puis la linéarité à gauche, puis la positivité, et enfin le caractère défini. C’est presque toujours ce dernier point qui demande un argument.
1.1 Trois exemples de référence
Sur \(\mathbb{R}^n\), le produit scalaire canonique est \(\langle x, y \rangle = \sum_{k=1}^{n} x_k y_k\), soit \(X^{\top} Y\) en écriture matricielle. Sur l’espace \(\mathcal{C}([a, b], \mathbb{R})\) des fonctions continues, la formule \(\langle f, g \rangle = \int_a^b f(t) g(t) \, \mathrm{d}t\) en définit un autre. Ici, le caractère défini vient d’un fait d’analyse : si \(f^2\), continue et positive, a une intégrale nulle sur \([a, b]\), alors \(f^2\) s’annule partout.
Le troisième exemple nous accompagnera tout au long du chapitre. Sur \(\mathbb{R}_2[X]\), posons
\[\langle P, Q \rangle = P(0) Q(0) + P(1) Q(1) + P(2) Q(2).\]
La symétrie et la linéarité sont immédiates, et \(\langle P, P \rangle\) est une somme de carrés. Si \(\langle P, P \rangle = 0\), alors \(P\) s’annule en \(0\), \(1\) et \(2\). Or un polynôme de degré au plus \(2\) qui possède trois racines est nul. Ainsi la forme est définie : c’est un produit scalaire sur \(\mathbb{R}_2[X]\).
La même formule, considérée sur \(\mathbb{R}_3[X]\), n’est plus un produit scalaire. En effet, le polynôme non nul \(X(X-1)(X-2)\) vérifie \(\langle P, P \rangle = 0\). La forme reste bilinéaire, symétrique et positive, mais elle n’est plus définie. Le choix de l’espace compte donc autant que la formule.
1.2 Le cas de R² : écriture matricielle
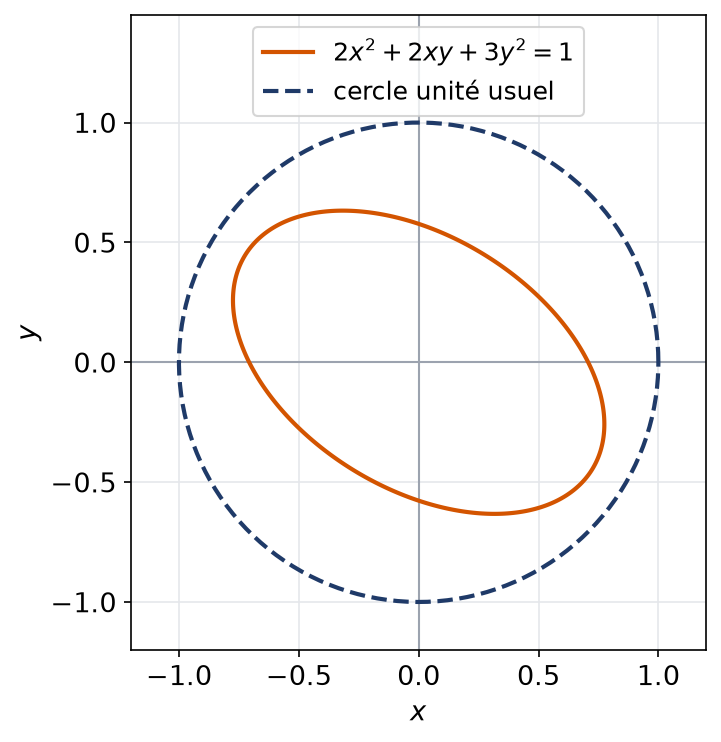
Sur \(\mathbb{R}^2\), considérons \(\varphi(u, v) = 2 x_1 x_2 + x_1 y_2 + y_1 x_2 + 3 y_1 y_2\), avec \(u = (x_1, y_1)\) et \(v = (x_2, y_2)\). Elle s’écrit \(\varphi(u, v) = U^{\top} S \, V\), où
\[S = \begin{pmatrix} 2 & 1 \\ 1 & 3 \end{pmatrix}.\]
La matrice \(S\) est symétrique, donc \(\varphi\) est bilinéaire symétrique. Ensuite, nous complétons le carré :
\[\varphi(u, u) = 2x^2 + 2xy + 3y^2 = 2 \left( x + \frac{y}{2} \right)^2 + \frac{5}{2} \, y^2.\]
Cette quantité est positive. Elle ne s’annule que si \(y = 0\) et \(x + y/2 = 0\), c’est-à-dire si \(u = 0\). Par conséquent, \(\varphi\) est un produit scalaire sur \(\mathbb{R}^2\).
Pour ce produit scalaire, l’ensemble des vecteurs de norme \(1\) n’est plus un cercle. C’est une ellipse inclinée, que la figure compare au cercle unité usuel.
Piège à éviter :
La positivité des coefficients diagonaux ne suffit pas. Par exemple, avec la matrice \(\begin{pmatrix} 1 & 3 \\ 3 & 4 \end{pmatrix}\), on a \(x^2 + 6xy + 4y^2 = (x + 3y)^2 – 5y^2\), qui vaut \(-5\) pour \((x, y) = (-3, 1)\). Il faut toujours une vraie preuve de positivité, par exemple une réduction en somme de carrés.
2. Norme euclidienne et inégalité de Cauchy-Schwarz
Dans un espace préhilbertien, on pose \(\|x\| = \sqrt{\langle x, x \rangle}\). Cette quantité est bien définie grâce à la positivité. Il reste à prouver qu’il s’agit d’une norme, et l’inégalité triangulaire en est le seul point délicat. Elle découle d’une inégalité centrale.
Inégalité de Cauchy-Schwarz. Quels que soient \(x\) et \(y\) dans \(E\), le produit \(\langle x, y \rangle\) a une valeur absolue au plus égale à \(\|x\| \, \|y\|\). On atteint l’égalité exactement quand l’un des deux vecteurs est multiple de l’autre.
Le cas \(y = 0\) est immédiat. Supposons donc \(y \neq 0\) et étudions \(\lambda \mapsto \|x + \lambda y\|^2\). En développant par bilinéarité, nous obtenons
\[\|x + \lambda y\|^2 = \|y\|^2 \lambda^2 + 2 \langle x, y \rangle \lambda + \|x\|^2.\]
Puisque \(\|y\|^2 > 0\), nous avons affaire à un polynôme de degré deux. Ce polynôme ne prend jamais de valeur négative ; par conséquent son discriminant \(4 \langle x, y \rangle^2 – 4 \|x\|^2 \|y\|^2\) est négatif ou nul, ce qui est exactement l’inégalité.
Supposons maintenant l’égalité. Le discriminant s’annule, donc le polynôme admet une racine \(\lambda_0\). Ainsi \(\|x + \lambda_0 y\| = 0\), et le caractère défini force \(x = -\lambda_0 y\). Inversement, deux vecteurs colinéaires réalisent l’égalité par un calcul direct.
L’application \(x \mapsto \|x\|\) est une norme. En particulier, \(\|x + y\| \leqslant \|x\| + \|y\|\).
Seule l’inégalité triangulaire demande un argument. On développe \(\|x + y\|^2 = \|x\|^2 + 2 \langle x, y \rangle + \|y\|^2\). Cauchy-Schwarz majore le terme central par \(2 \|x\| \|y\|\). On obtient \((\|x\| + \|y\|)^2\), et il suffit de prendre la racine carrée.
En développant aussi \(\|x – y\|^2\), on obtient deux relations très utiles. D’abord, la polarisation \(\langle x, y \rangle = \frac{1}{4} \left( \|x + y\|^2 – \|x – y\|^2 \right)\) montre que la norme suffit à reconstituer tout le produit scalaire. Ensuite, en additionnant au lieu de soustraire, on trouve la règle du parallélogramme : \(\|x + y\|^2 + \|x – y\|^2 = 2 \|x\|^2 + 2 \|y\|^2\).
2.1 Utiliser le cas d’égalité
Cherchons le maximum de \(2x – y + 2z\) lorsque \(x^2 + y^2 + z^2 = 1\). Dans \(\mathbb{R}^3\) muni du produit canonique, posons \(a = (2, -1, 2)\) et \(u = (x, y, z)\). L’expression vaut \(\langle a, u \rangle\), et \(\|a\| = \sqrt{4 + 1 + 4} = 3\).
D’une part, Cauchy-Schwarz donne \(\langle a, u \rangle \leqslant \|a\| \, \|u\| = 3\). D’autre part, le cas d’égalité suggère de prendre \(u\) colinéaire à \(a\) et de même sens : \(u = \frac{1}{3}(2, -1, 2)\). On vérifie que \(\|u\| = 1\) et que \(\langle a, u \rangle = \frac{9}{3} = 3\). Le maximum vaut donc \(3\).
Pour obtenir une inégalité par Cauchy-Schwarz :
- repérer une somme de produits ou une intégrale de produit, et l’écrire \(\langle a, u \rangle\) pour un produit scalaire bien choisi ;
- calculer les deux normes ;
- appliquer l’inégalité, puis chercher le cas d’égalité pour savoir si la borne est atteinte.
3. Orthogonalité et bases orthonormées
Nous disons que \(x\) et \(y\) sont orthogonaux, et nous écrivons \(x \perp y\), quand leur produit scalaire vaut zéro. Une famille \((e_1, \dots, e_p)\) mérite le nom d’orthogonale quand \(\langle e_i, e_j \rangle = 0\) dès que \(i \neq j\). Quand on exige en plus \(\|e_i\| = 1\) pour chaque indice, la famille est orthonormée : cela revient à \(\langle e_i, e_j \rangle = \delta_{ij}\).
Pythagore. Si \(x\) et \(y\) sont orthogonaux, alors \(\|x + y\|^2 = \|x\|^2 + \|y\|^2\). Plus généralement, pour une famille orthogonale, \(\left\| \sum_{k} x_k \right\|^2 = \sum_{k} \|x_k\|^2\).
Dans un espace réel, la réciproque est vraie, car \(\|x + y\|^2 – \|x\|^2 – \|y\|^2 = 2 \langle x, y \rangle\). Nous verrons qu’elle tombe en défaut dans le cadre complexe.
Si aucun des vecteurs d’une famille orthogonale n’est nul, cette famille est automatiquement libre.
Partons d’une relation \(\sum_k \lambda_k e_k = 0\) et multiplions-la scalairement par \(e_j\). Tous les termes disparaissent sauf un, et il reste \(\lambda_j \|e_j\|^2 = 0\). Comme \(e_j \neq 0\), on en déduit \(\lambda_j = 0\), et ce pour chaque indice \(j\).
3.1 Calculer dans une base orthonormée
Une base orthonormée rend tous les calculs explicites. En effet, les coordonnées s’obtiennent par simples produits scalaires, sans résoudre de système.
Fixons une base orthonormée \((e_1, \dots, e_n)\) de \(E\), et notons \(x_k = \langle e_k, x \rangle\), \(y_k = \langle e_k, y \rangle\). Alors \(x\) se reconstitue à partir de ces nombres, qui sont donc ses coordonnées :
\[x = \sum_{k=1}^{n} x_k \, e_k, \qquad \langle x, y \rangle = \sum_{k=1}^{n} x_k y_k, \qquad \|x\|^2 = \sum_{k=1}^{n} x_k^2.\]
En pratique, une base orthonormée ramène n’importe quel produit scalaire à la formule canonique de \(\mathbb{R}^n\), appliquée aux coordonnées. En termes de matrices, si les colonnes de \(Q\) forment une base orthonormée de \(\mathbb{R}^n\), alors \(Q^{\top} Q = I_n\), car le coefficient \((i, j)\) de ce produit vaut \(\langle e_i, e_j \rangle\).
3.2 Pourquoi le calcul est si simple
La première formule se démontre en une ligne. En effet, si \(x = \sum_j c_j e_j\), le produit avec \(e_k\) isole un seul terme et donne \(c_k = \langle e_k, x \rangle\). Les deux autres formules s’obtiennent ensuite en développant par bilinéarité : tous les produits croisés \(\langle e_i, e_j \rangle\) avec \(i \neq j\) disparaissent. C’est précisément ce qui manque dans une base quelconque, où chaque calcul de coordonnées exige la résolution d’un système.
Piège à éviter :
La formule \(x_k = \langle e_k, x \rangle\) ne vaut que pour une base orthonormée. Dans une base seulement orthogonale, il faut diviser : \(x_k = \langle e_k, x \rangle / \|e_k\|^2\). Dans une base quelconque, aucune de ces formules ne s’applique.
4. Le procédé de Gram-Schmidt
Malheureusement, les bases que l’on rencontre sont rarement orthonormées. Nous allons donc en fabriquer une à partir de n’importe quelle famille libre, en conservant à chaque étape l’espace engendré par les premiers vecteurs. Géométriquement, chaque nouveau vecteur est débarrassé de ce qu’il a « en commun » avec les directions déjà traitées.
Partons de vecteurs \(u_1, \dots, u_p\) linéairement indépendants. Il existe alors une et une seule famille orthonormée \((e_1, \dots, e_p)\) qui vérifie, à chaque rang \(k\), les deux conditions suivantes :
- les \(k\) premiers \(e_j\) engendrent le même espace que les \(k\) premiers \(u_j\) ;
- le produit \(\langle e_k, u_k \rangle\) est strictement positif.
Nous construisons les \(e_k\) par récurrence. D’abord, \(e_1 = u_1 / \|u_1\|\). Supposons ensuite \(e_1, \dots, e_{k-1}\) construits, et posons
\[w_k = u_k – \sum_{j=1}^{k-1} \langle e_j, u_k \rangle \, e_j.\]
Pour \(i < k\), le produit \(\langle e_i, w_k \rangle\) vaut \(\langle e_i, u_k \rangle – \langle e_i, u_k \rangle = 0\). De plus, \(w_k \neq 0\), sinon \(u_k\) appartiendrait à \(\mathrm{Vect}(u_1, \dots, u_{k-1})\), ce qui contredirait la liberté. On pose alors \(e_k = w_k / \|w_k\|\). L’égalité des sous-espaces et le signe de \(\langle e_k, u_k \rangle = \|w_k\|\) se vérifient directement. Pour l’unicité, \(e_k\) doit être orthogonal à un hyperplan de \(\mathrm{Vect}(u_1, \dots, u_k)\), ce qui le fixe au signe près ; la condition de signe le détermine.
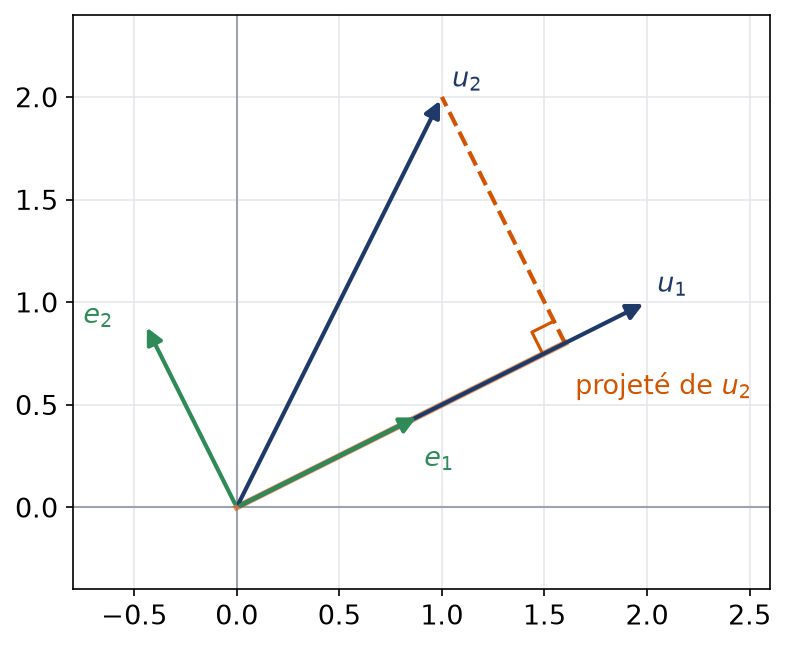
Sur la figure, avec \(u_1 = (2, 1)\) et \(u_2 = (1, 2)\), l’étape clé apparaît nettement. On retire à \(u_2\) son ombre portée sur \(u_1\), et seule subsiste la partie perpendiculaire, qui donne la direction de \(e_2\).
4.1 La méthode en pratique
Pour orthonormaliser \((u_1, \dots, u_p)\) :
- normaliser \(u_1\) ;
- pour chaque \(k \geqslant 2\), calculer les produits \(\langle e_j, u_k \rangle\) pour \(j < k\), puis former \(w_k\) ;
- vérifier sur un ou deux produits que \(w_k\) est bien orthogonal aux vecteurs précédents ;
- normaliser \(w_k\). Pour éviter les racines carrées, on peut orthogonaliser d’abord, puis normaliser à la fin.
Orthonormalisons \((1, X, X^2)\) dans \(\mathbb{R}_2[X]\) pour le produit \(\langle P, Q \rangle = P(0)Q(0) + P(1)Q(1) + P(2)Q(2)\). Nous orthogonalisons d’abord.
- Le polynôme \(1\) vérifie \(\|1\|^2 = 3\).
- On a \(\langle X, 1 \rangle = 0 + 1 + 2 = 3\). Le vecteur \(X – \frac{3}{3} \cdot 1 = X – 1\) est orthogonal à \(1\), et \(\|X – 1\|^2 = 1 + 0 + 1 = 2\).
- Ensuite, \(\langle X^2, 1 \rangle = 5\) et \(\langle X^2, X – 1 \rangle = 0 + 0 + 4 = 4\). On retranche donc \(\frac{5}{3}\) et \(\frac{4}{2}(X – 1)\), ce qui donne \(R = X^2 – 2X + \frac{1}{3}\).
Les valeurs de \(R\) en \(0\), \(1\), \(2\) sont \(\frac{1}{3}\), \(-\frac{2}{3}\), \(\frac{1}{3}\). On vérifie ainsi les deux orthogonalités, et \(\|R\|^2 = \frac{1 + 4 + 1}{9} = \frac{2}{3}\). En normalisant, on obtient la base orthonormée
\[\left( \frac{1}{\sqrt{3}}, \ \frac{X – 1}{\sqrt{2}}, \ \sqrt{\tfrac{3}{2}} \left( X^2 – 2X + \tfrac{1}{3} \right) \right).\]
Un espace euclidien admet toujours au moins une base orthonormée. Mieux : partant d’une famille orthonormée donnée, on peut lui adjoindre des vecteurs jusqu’à obtenir une base orthonormée.
Pour le second point, on complète la famille en une base quelconque, puis on applique Gram-Schmidt. Les premiers vecteurs, déjà orthonormés, ne sont pas modifiés par le procédé.
5. Supplémentaire orthogonal et projection orthogonale
À une partie \(F\) de \(E\), on associe l’ensemble \(F^{\perp}\) des vecteurs orthogonaux à tous les éléments de \(F\), appelé orthogonal de \(F\). Quelle que soit \(F\), cet ensemble est stable par combinaison linéaire. Si \(F\) est un sous-espace, un vecteur commun à \(F\) et \(F^{\perp}\) est orthogonal à lui-même, donc nul.
Pour déterminer \(F^{\perp}\) quand \(F = \mathrm{Vect}(f_1, \dots, f_p)\), il suffit d’écrire l’orthogonalité aux seuls générateurs. On obtient ainsi un système de \(p\) équations linéaires.
Dès que le sous-espace \(F\) est de dimension finie, il admet \(F^{\perp}\) pour supplémentaire : \(E = F \oplus F^{\perp}\). Lorsque \(E\) lui-même est euclidien, on dispose en outre de la relation \(\dim F + \dim F^{\perp} = \dim E\), et l’orthogonal de \(F^{\perp}\) redonne \(F\).
Gram-Schmidt nous donne une base orthonormée \((e_1, \dots, e_p)\) de \(F\). À chaque \(x\) de \(E\), associons le vecteur \(p(x) = \sum_{k=1}^{p} \langle e_k, x \rangle e_k\). Ce vecteur appartient à \(F\). De plus, \(\langle e_j, x – p(x) \rangle = \langle e_j, x \rangle – \langle e_j, x \rangle = 0\) pour chaque \(j\), donc \(x – p(x) \in F^{\perp}\). L’écriture \(x = p(x) + (x – p(x))\) montre que \(E = F + F^{\perp}\). La somme est directe car l’intersection est nulle.
Quand \(E\) est euclidien, la somme directe fournit aussitôt la relation entre les dimensions. Par ailleurs, tout vecteur de \(F\) est orthogonal à \(F^{\perp}\), d’où \(F \subset (F^{\perp})^{\perp}\). En appliquant deux fois la relation des dimensions, on voit que ces deux sous-espaces ont la même dimension : ils coïncident.
5.1 Projection orthogonale et distance
Toujours avec \(F\) de dimension finie, la décomposition \(E = F \oplus F^{\perp}\) définit une projection d’image \(F\) et de noyau \(F^{\perp}\). Nous l’appelons projection orthogonale sur \(F\) et nous la notons \(p_F\). Concrètement, \(p_F(x)\) est le seul vecteur \(y\) qui appartient à \(F\) et pour lequel \(x – y\) est orthogonal à \(F\).
Pour toute base orthonormée \((e_1, \dots, e_p)\) de \(F\), on a \(p_F(x) = \sum_{k=1}^{p} \langle e_k, x \rangle e_k\). Parmi tous les vecteurs de \(F\), c’est \(p_F(x)\), et lui seul, qui réalise le plus petit écart avec \(x\) :
\[d(x, F) = \min_{y \in F} \|x – y\| = \|x – p_F(x)\|, \qquad \|x\|^2 = \|p_F(x)\|^2 + d(x, F)^2.\]
La formule a été établie dans la preuve précédente. Prenons ensuite un vecteur quelconque \(y\) de \(F\) et décomposons \(x – y = \big( x – p_F(x) \big) + \big( p_F(x) – y \big)\). Le premier morceau est orthogonal à \(F\) et le second vit dans \(F\). Pythagore donne alors
\[\|x – y\|^2 = \|x – p_F(x)\|^2 + \|p_F(x) – y\|^2 \geqslant \|x – p_F(x)\|^2,\]
avec égalité si et seulement si \(y = p_F(x)\). La dernière relation est Pythagore appliqué à \(x = p_F(x) + (x – p_F(x))\).
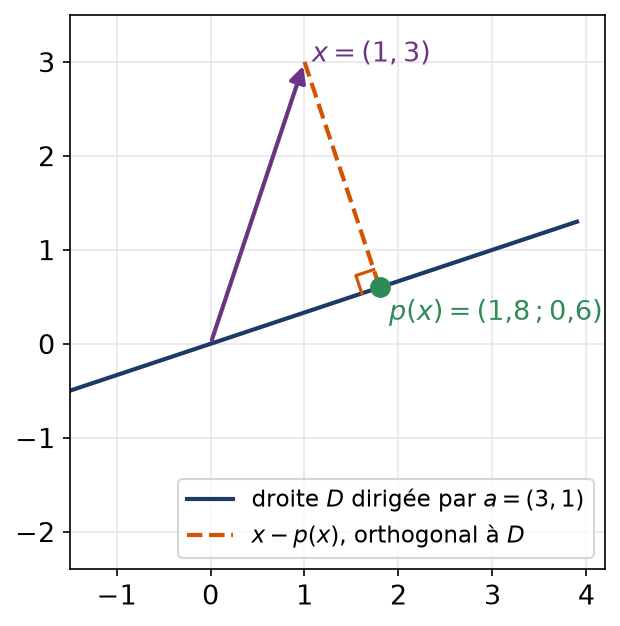
Sur une droite \(D = \mathrm{Vect}(a)\), la formule devient \(p_D(x) = \dfrac{\langle a, x \rangle}{\|a\|^2} \, a\). Par exemple, pour \(a = (3, 1)\) et \(x = (1, 3)\), on trouve \(p_D(x) = \frac{6}{10} (3, 1) = (1{,}8 \, ; 0{,}6)\). La figure montre l’angle droit qui caractérise ce point.
Pour un hyperplan \(H = a^{\perp}\), on projette plutôt sur la droite normale. On en déduit \(p_H(x) = x – \frac{\langle a, x \rangle}{\|a\|^2} a\) et la formule de distance \(d(x, H) = \frac{|\langle a, x \rangle|}{\|a\|}\).
Dans \(\mathbb{R}^4\) muni du produit canonique, soit \(F = \mathrm{Vect}(u, v)\) avec \(u = (1, 1, 0, 1)\) et \(v = (1, -1, 1, 0)\). Calculons la distance de \(x = (2, 1, 3, 0)\) à \(F\).
D’abord, \(\langle u, v \rangle = 1 – 1 + 0 + 0 = 0\) : la famille est déjà orthogonale, avec \(\|u\|^2 = \|v\|^2 = 3\). Ensuite, \(\langle u, x \rangle = 3\) et \(\langle v, x \rangle = 4\). Donc
\[p_F(x) = \frac{3}{3} \, u + \frac{4}{3} \, v = \left( \frac{7}{3}, -\frac{1}{3}, \frac{4}{3}, 1 \right).\]
Le vecteur \(x – p_F(x) = \frac{1}{3}(-1, 4, 5, -3)\) est bien orthogonal à \(u\) et à \(v\). Sa norme au carré vaut \(\frac{1 + 16 + 25 + 9}{9} = \frac{17}{3}\). Ainsi \(d(x, F) = \sqrt{17/3}\). Enfin, \(\|p_F(x)\|^2 = 3 + \frac{16}{3} = \frac{25}{3}\), et l’on retrouve bien \(\frac{25}{3} + \frac{17}{3} = 14 = \|x\|^2\).
Piège à éviter :
La formule \(\sum \langle e_k, x \rangle e_k\) exige une base orthonormée de \(F\). Avec une base quelconque, on écrit \(p_F(x) = \sum \lambda_k f_k\) et l’on impose \(\langle f_j, x – p_F(x) \rangle = 0\) pour chaque \(j\). On obtient un système linéaire dont la matrice est la matrice de Gram des \(f_k\).
6. Espaces hermitiens
Sur \(\mathbb{C}^n\), la formule \(\sum x_k y_k\) ne convient pas : pour \(x = (1, i)\), elle donne \(1 + i^2 = 0\) avec \(x \neq 0\). Il faut conjuguer l’une des variables. Nous adoptons ici la convention qui rend le produit linéaire à droite et semi-linéaire à gauche.
Soit \(E\) un \(\mathbb{C}\)-espace vectoriel. Nous appelons produit hermitien sur \(E\) toute règle \((x, y) \mapsto \langle x, y \rangle \in \mathbb{C}\) qui satisfait les trois exigences suivantes :
- elle est linéaire en \(y\) ;
- \(\langle y, x \rangle = \overline{\langle x, y \rangle}\) (symétrie hermitienne) ;
- \(\langle x, x \rangle\) est un réel positif, nul seulement pour \(x = 0\).
Il en résulte que \(\langle \lambda x, y \rangle = \overline{\lambda} \langle x, y \rangle\). Un espace hermitien est un espace complexe de dimension finie muni d’un tel produit.
L’exemple canonique est \(\langle x, y \rangle = \sum_{k=1}^{n} \overline{x_k} \, y_k\) sur \(\mathbb{C}^n\), soit \(\overline{X}^{\top} Y\). L’inégalité de Cauchy-Schwarz reste vraie, de même que Gram-Schmidt et la projection orthogonale. Il faut seulement respecter l’ordre des variables : avec notre convention, \(p_F(x) = \sum_k \langle e_k, x \rangle e_k\).
Le développement devient \(\|x + y\|^2 = \|x\|^2 + \|y\|^2 + 2 \, \mathrm{Re} \langle x, y \rangle\). La réciproque de Pythagore échoue donc. Dans \(\mathbb{C}\), prenons \(x = 1\) et \(y = i\). On a \(|1 + i|^2 = 2 = |1|^2 + |i|^2\), et pourtant \(\langle x, y \rangle = \overline{1} \cdot i = i \neq 0\).
Dans \(\mathbb{C}^2\), orthonormalisons \(u_1 = (1, i)\) et \(u_2 = (1, 1)\). D’abord, \(\|u_1\|^2 = 1 + |i|^2 = 2\), donc \(e_1 = \frac{1}{\sqrt{2}} (1, i)\). Ensuite, \(\langle u_1, u_2 \rangle = \overline{1} \cdot 1 + \overline{i} \cdot 1 = 1 – i\). Nous retirons la composante sur \(u_1\) :
\[w = u_2 – \frac{1 – i}{2} (1, i) = (1, 1) – \left( \frac{1 – i}{2}, \frac{1 + i}{2} \right) = \left( \frac{1 + i}{2}, \frac{1 – i}{2} \right).\]
On vérifie que \(\langle u_1, w \rangle = \frac{1 + i}{2} – i \cdot \frac{1 – i}{2} = 0\). Enfin, \(\|w\|^2 = \frac{2}{4} + \frac{2}{4} = 1\), donc \(e_2 = w\).
7. Moindres carrés
Un système linéaire \(AX = B\) avec plus d’équations que d’inconnues n’a en général aucune solution. C’est le cas des mesures expérimentales bruitées. On cherche alors \(X\) qui rend le résidu \(\|AX – B\|\) le plus petit possible. Ce problème se résout entièrement par la projection orthogonale.
On se donne une matrice réelle \(A\) à \(n\) lignes et \(p\) colonnes, ainsi qu’un vecteur \(B\) de \(\mathbb{R}^n\). Les vecteurs \(X\) qui rendent \(\|AX – B\|\) minimal sont exactement les solutions des équations normales
\[A^{\top} A \, X = A^{\top} B.\]
Lorsque les \(p\) colonnes de \(A\) sont indépendantes, ce système carré est de Cramer : le minimum est atteint en un seul \(X\).
Quand \(X\) décrit \(\mathbb{R}^p\), le vecteur \(AX\) décrit l’image \(F = \mathrm{Im}\, A\). Le minimum est atteint exactement lorsque \(AX = p_F(B)\), c’est-à-dire lorsque \(B – AX\) est orthogonal à \(F\). Or \(F\) est engendré par les colonnes de \(A\). La condition s’écrit donc \(A^{\top}(B – AX) = 0\).
Pour l’inversibilité, supposons \(A^{\top} A X = 0\). Alors \(X^{\top} A^{\top} A X = \|AX\|^2 = 0\), donc \(AX = 0\), puis \(X = 0\) si les colonnes sont libres.
7.1 Ajuster une droite à des mesures
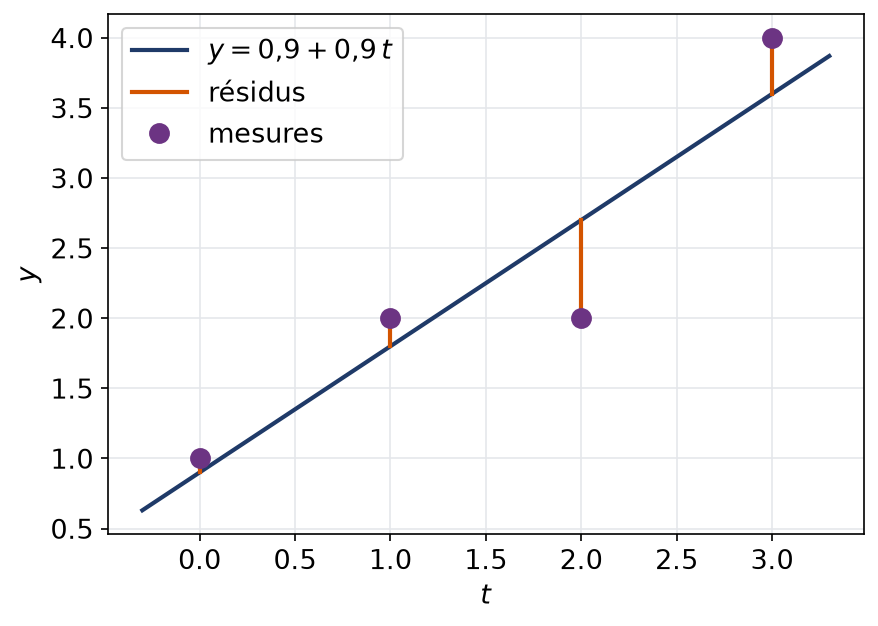
On a mesuré les couples \((t, y)\) suivants : \((0, 1)\), \((1, 2)\), \((2, 2)\), \((3, 4)\). Cherchons la droite \(y = a + bt\) qui minimise la somme des carrés des écarts. Ici \(B = (1, 2, 2, 4)\), et \(A\) a pour colonnes \((1, 1, 1, 1)\) et \((0, 1, 2, 3)\).
On calcule \(A^{\top} A = \begin{pmatrix} 4 & 6 \\ 6 & 14 \end{pmatrix}\) et \(A^{\top} B = (9, 18)\). Le système \(4a + 6b = 9\), \(6a + 14b = 18\) a pour déterminant \(20\). On trouve \(a = \frac{126 – 108}{20} = 0{,}9\) et \(b = \frac{72 – 54}{20} = 0{,}9\).
On obtient ensuite les écarts \(0{,}1\), \(0{,}2\), \(-0{,}7\) et \(0{,}4\) entre mesures et valeurs ajustées. Ils se compensent exactement, ce qui traduit l’orthogonalité à la première colonne. La somme de leurs carrés vaut \(0{,}70\) : aucune autre droite ne fait mieux.
Remarque :
Le produit scalaire de la partie 1 donne une autre lecture du même problème. Chercher le polynôme de degré au plus \(1\) le plus proche de \(X^2\) revient à ajuster une droite aux points \((0, 0)\), \((1, 1)\) et \((2, 4)\). D’après la partie 4, le projeté vaut \(X^2 – R = 2X – \frac{1}{3}\). La droite optimale est donc \(y = 2t – \frac{1}{3}\), et l’écart quadratique minimal vaut \(\|R\| = \sqrt{2/3}\).
Les erreurs fréquentes
- Oublier de vérifier le caractère défini, qui dépend de l’espace choisi et pas seulement de la formule.
- Utiliser \(\sum \langle e_k, x \rangle e_k\) avec une base qui n’est pas orthonormée.
- Conclure à l’orthogonalité à partir de l’égalité de Pythagore dans un espace hermitien.
- Inverser l’ordre des variables dans un produit hermitien, ce qui conjugue les coefficients de projection.
- Résoudre \(AX = B\) au lieu des équations normales, alors que le système n’a pas de solution.
Fiche mémo
- Produit scalaire : forme bilinéaire, symétrique, positive et définie.
- Cauchy-Schwarz : \(|\langle x, y \rangle| \leqslant \|x\| \|y\|\), avec égalité pour des vecteurs colinéaires.
- Polarisation : la norme détermine le produit scalaire.
- Des vecteurs non nuls deux à deux orthogonaux sont indépendants ; en base orthonormée, chaque coordonnée vaut \(\langle e_k, x \rangle\).
- Gram-Schmidt : \(w_k = u_k – \sum_{j < k} \langle e_j, u_k \rangle e_j\), puis \(e_k = w_k / \|w_k\|\).
- Si \(F\) est de dimension finie, \(E = F \oplus F^{\perp}\).
- Projection orthogonale : \(p_F(x) \in F\) et \(x – p_F(x) \perp F\) ; elle réalise la distance de \(x\) à \(F\).
- Hyperplan \(a^{\perp}\) : la distance vaut \(|\langle a, x \rangle| / \|a\|\).
- Cadre hermitien : conjuguer une variable ; Pythagore reste vrai, mais sa réciproque tombe.
- Moindres carrés : \(A^{\top} A X = A^{\top} B\), solution unique si les colonnes de \(A\) sont libres.
Questions fréquentes
Comment montrer qu'une forme bilinéaire est un produit scalaire ?
Contrôlez d’abord que la forme ne change pas quand on échange les variables et qu’elle est linéaire à gauche, puis que q(x) reste positif. Le point décisif est le caractère défini : il faut prouver que seule l’application au vecteur nul donne zéro. Une réduction en somme de carrés ou un argument de racines de polynôme suffit souvent.
Pourquoi faut-il une base orthonormée pour projeter ?
La formule qui somme les produits scalaires avec les vecteurs de base n’est valable que si ces vecteurs sont orthonormés. Avec une base quelconque du sous-espace, on écrit le projeté comme combinaison inconnue et on impose l’orthogonalité du reste à chaque vecteur de base. On obtient alors un système dont la matrice est la matrice de Gram.
Quel est le lien entre moindres carrés et projection orthogonale ?
Minimiser la norme de AX – B revient à chercher le point de l’image de A le plus proche de B. Ce point est le projeté orthogonal de B sur l’image de A. Écrire que le résidu est orthogonal aux colonnes de A donne les équations normales.
Passer de R à C, est-ce que cela modifie les règles de calcul ?
Le produit scalaire conjugue l’une des deux variables, ce qui garantit que la norme au carré est un réel positif. Cauchy-Schwarz, Gram-Schmidt et la projection restent valables. En revanche, l’égalité de Pythagore n’implique plus l’orthogonalité, car elle ne contrôle que la partie réelle du produit.
Pour aller plus loin
- S’exercer : exercices corrigés de L2 de maths sur projection orthogonale
- Chapitre d’avant : Continuité et dérivation sous l'intégrale, Gamma
- Chapitre d’après : Isométries et endomorphismes symétriques
- Vérifier ses acquis : QCM de L2 de maths sur projection orthogonale
- Contrôle corrigé en temps limité : Moindres carrés et projection orthogonale : contrôle de maths en L2
- Tous les chapitres : le sommaire de la L2 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «projection orthogonale en L2 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.