Produit scalaire et Gram-Schmidt en maths sup (MPSI) : cours et méthodes
Ce cours de produit scalaire MPSI ouvre la géométrie euclidienne, en fin de second semestre. Il s’appuie sur la dimension et sur le théorème du rang, puis ajoute aux espaces vectoriels des longueurs et des angles droits.
Nous suivons un fil précis : vérifier qu’une forme est un produit scalaire, exploiter l’inégalité de Cauchy-Schwarz, fabriquer une base orthonormée par le procédé de Gram-Schmidt, puis calculer un projeté orthogonal. La dernière partie traite le calcul de distance à un sous-espace. Ce savoir-faire revient chaque année à l’écrit comme à l’oral, souvent sous la forme d’une intégrale à minimiser.
Chaque méthode est rédigée comme en colle, avec un exemple chiffré et un dessin. Ce chapitre prépare directement les isométries, les matrices orthogonales et la réduction des endomorphismes symétriques de seconde année.
Ce que vous saurez faire
- Vérifier, point par point, qu’une application \(E\times E\to\mathbb{R}\) est un produit scalaire.
- Utiliser l’inégalité de Cauchy-Schwarz et son cas d’égalité pour majorer ou optimiser.
- Déterminer l’orthogonal d’une partie et exploiter une base orthonormée.
- Orthonormaliser une famille libre par le procédé de Gram-Schmidt.
- Calculer un projeté orthogonal, puis une distance à un sous-espace.
- Résoudre un problème de minimisation en le ramenant à une projection.
1. Produit scalaire : définition et exemples
Jusqu’ici, nos espaces vectoriels ne connaissaient ni longueur ni angle. Le produit scalaire ajoute exactement cette information. Dans tout le chapitre, \(E\) désigne un \(\mathbb{R}\)-espace vectoriel.
Un produit scalaire sur \(E\) est une application \(\langle\cdot,\cdot\rangle:E\times E\to\mathbb{R}\) qui est :
- symétrique : \(\langle x,y\rangle=\langle y,x\rangle\) ;
- bilinéaire : linéaire par rapport à chaque variable ;
- positive : \(\langle x,x\rangle\geqslant 0\) ;
- définie : \(\langle x,x\rangle=0\) entraîne \(x=0\).
Muni d’un tel objet, \(E\) devient un espace préhilbertien réel. Le cas particulier où \(\dim E\) est finie reçoit le nom d’espace euclidien.
Remarque :
Grâce à la symétrie, la linéarité par rapport à la première variable suffit. En effet, elle se transmet alors à la seconde. Cela allège les vérifications.
1.1 Les produits scalaires de référence
- Sur \(\mathbb{R}^n\) : \(\langle x,y\rangle=\sum_{i=1}^{n}x_iy_i\), c’est le produit scalaire canonique.
- Sur \(\mathcal{M}_{n}(\mathbb{R})\) : \(\langle A,B\rangle=\mathrm{tr}(A^{\mathsf{T}}B)=\sum_{i,j}a_{ij}b_{ij}\).
- Sur \(\mathcal{C}([a,b],\mathbb{R})\), avec \(a<b\) : \(\langle f,g\rangle=\int_a^b f(t)g(t)\,\mathrm{d}t\), c’est le produit scalaire intégral.
Le produit matriciel se calcule coefficient par coefficient, sans effectuer de produit de matrices. Par exemple, pour \(A=\begin{pmatrix}1&2\\0&-1\end{pmatrix}\) et \(B=\begin{pmatrix}3&0\\1&1\end{pmatrix}\), on trouve \(\langle A,B\rangle=3+0+0-1=2\). De même, \(\|A\|^2=1+4+0+1=6\). Plus généralement, \(\|I_n\|=\sqrt{n}\), puisque \(I_n\) possède exactement \(n\) coefficients égaux à \(1\). Ce dernier calcul reviendra dans la fiche d’exercices, à propos de la trace.
Pour le produit intégral, le caractère défini vient de l’analyse. Si \(\int_a^bf^2=0\), la fonction \(f^2\) est positive, continue, et son intégrale s’annule. Le cours sur l’intégrale assure qu’elle est alors identiquement nulle, donc \(f=0\). Sans l’hypothèse de continuité, l’argument tombe.
1.2 Vérifier qu’une forme est un produit scalaire
- Vérifier la symétrie, souvent immédiate sur la formule.
- Vérifier la linéarité par rapport à la première variable.
- Écrire \(\langle x,x\rangle\) et montrer qu’il est positif, par exemple en mettant sous forme canonique ou en reconnaissant une somme de carrés.
- Supposer \(\langle x,x\rangle=0\) et en déduire \(x=0\) : c’est l’étape où se cachent les pièges.
Sur \(\mathbb{R}^2\), posons \(\langle x,y\rangle=2x_1y_1+x_1y_2+x_2y_1+3x_2y_2\).
D’abord, l’expression est symétrique, car échanger \(x\) et \(y\) échange les deux termes croisés. Ensuite, chaque terme est linéaire en \(x\).
Pour la positivité, on complète le carré : \(\langle x,x\rangle=2x_1^2+2x_1x_2+3x_2^2=2\big(x_1+\frac{x_2}{2}\big)^2+\frac{5}{2}x_2^2\geqslant 0\).
Enfin, si cette quantité est nulle, les deux carrés sont nuls. Donc \(x_2=0\), puis \(x_1=0\). C’est bien un produit scalaire.
Piège à éviter :
Sur \(\mathbb{R}_2[X]\), l’application \((P,Q)\mapsto P(0)Q(0)+P(1)Q(1)\) est symétrique, bilinéaire et positive. Pourtant, elle n’est pas définie : le polynôme \(X(X-1)\) est non nul et vérifie \(\langle P,P\rangle=0\). Il faut au moins trois points d’évaluation pour \(\mathbb{R}_2[X]\).
2. Norme associée et inégalité de Cauchy-Schwarz
On pose \(\|x\|=\sqrt{\langle x,x\rangle}\), qui a un sens grâce à la positivité. Développer par bilinéarité fournit les identités de base, que l’on utilise sans cesse.
Pour tous \(x,y\in E\) :
\[\|x+y\|^2=\|x\|^2+2\langle x,y\rangle+\|y\|^2,\qquad \langle x,y\rangle=\frac{1}{4}\Big(\|x+y\|^2-\|x-y\|^2\Big).\]
La seconde égalité, dite de polarisation, montre que la norme détermine le produit scalaire.
2.1 L’inégalité et son cas d’égalité
Quels que soient les vecteurs \(x\) et \(y\), la valeur absolue \(|\langle x,y\rangle|\) reste inférieure ou égale au produit \(\|x\|\,\|y\|\). Le cas d’égalité correspond exactement aux couples liés, c’est-à-dire à \(x\) et \(y\) colinéaires.
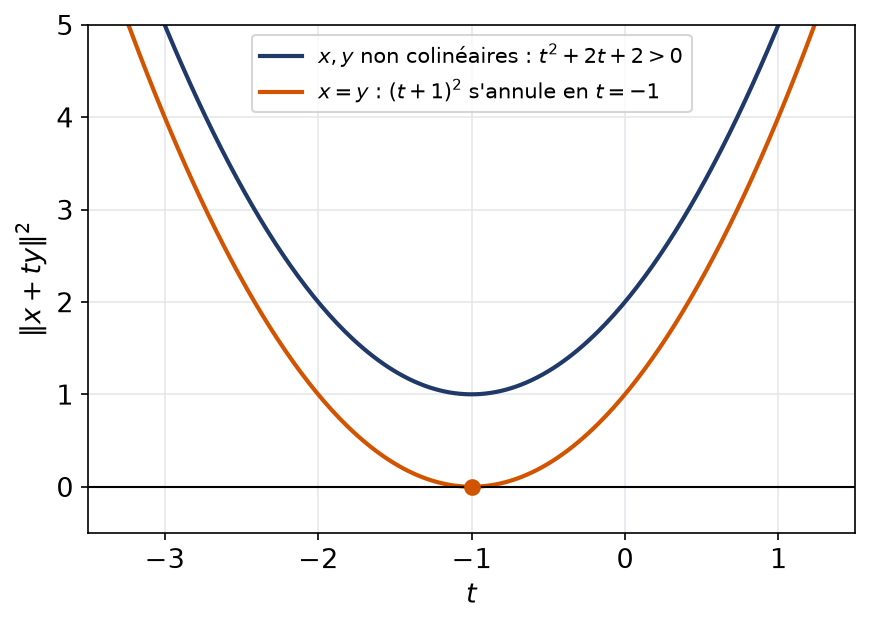
Si \(y=0\), tout est nul et \(x,y\) sont colinéaires. Supposons donc \(y\neq 0\). Pour \(t\in\mathbb{R}\), considérons \(T(t)=\|x+ty\|^2=\|y\|^2t^2+2\langle x,y\rangle t+\|x\|^2\).
C’est un trinôme de degré \(2\), toujours positif. Son discriminant est donc négatif ou nul : \(4\langle x,y\rangle^2-4\|x\|^2\|y\|^2\leqslant 0\). On obtient l’inégalité.
Supposons maintenant l’égalité. Le discriminant s’annule, et \(T\) possède une racine double \(t_0\). Ainsi, \(\|x+t_0y\|=0\). Comme le produit scalaire est défini, \(x=-t_0y\). La réciproque se vérifie directement.
La figure illustre l’argument : la parabole reste au-dessus de l’axe, et elle ne le touche que dans le cas colinéaire.
La quantité \(\|x\|\) définit une norme sur \(E\). Le point délicat est l’inégalité triangulaire \(\|x+y\|\leqslant\|x\|+\|y\|\), qui découle de Cauchy-Schwarz.
En effet, \(\|x+y\|^2\leqslant\|x\|^2+2\|x\|\|y\|+\|y\|^2\) d’après Cauchy-Schwarz, ce qui donne le résultat en prenant la racine.
Remarque :
Pour \(x\) et \(y\) non nuls, Cauchy-Schwarz garantit que \(\frac{\langle x,y\rangle}{\|x\|\|y\|}\) appartient à \([-1,1]\). On peut donc définir l’angle non orienté \(\theta\in[0,\pi]\) par \(\cos\theta=\frac{\langle x,y\rangle}{\|x\|\|y\|}\). Par exemple, dans l’exercice de polarisation de la fiche, on trouve \(\cos\theta=\frac{1}{4}\). Cette notion géométrique repose donc entièrement sur l’inégalité.
2.2 Cauchy-Schwarz comme outil d’optimisation
Le cas d’égalité est aussi important que l’inégalité. En effet, il indique où un minimum ou un maximum est atteint.
Cherchons le minimum de \(x^2+y^2+z^2\) sous la contrainte \(x+2y+2z=6\).
Posons \(a=(1,2,2)\) et \(v=(x,y,z)\) dans \(\mathbb{R}^3\) muni du produit canonique. La contrainte s’écrit \(\langle a,v\rangle=6\). Cauchy-Schwarz donne alors \(36\leqslant\|a\|^2\|v\|^2=9\|v\|^2\), donc \(\|v\|^2\geqslant 4\).
Ensuite, l’égalité impose \(v=\lambda a\). La contrainte donne \(9\lambda=6\), soit \(\lambda=\frac{2}{3}\). Le point \(\big(\frac{2}{3},\frac{4}{3},\frac{4}{3}\big)\) vérifie bien la contrainte, et la somme de ses carrés vaut \(\frac{36}{9}=4\).
Finalement, le minimum vaut \(4\). Nous verrons en partie 5 que c’est le carré de la distance de l’origine au plan affine de la contrainte.
Piège à éviter :
L’inégalité \(\langle x,y\rangle\leqslant\|x\|\|y\|\) donne un majorant, pas forcément un maximum. Pour conclure à un extremum, on exhibe toujours un point qui réalise l’égalité.
2.3 La version intégrale
Dans \(\mathcal{C}([a,b],\mathbb{R})\), l’inégalité prend une forme qui sert très souvent en analyse. Elle permet de majorer une intégrale de produit par des intégrales de carrés, plus faciles à contrôler.
Pour \(f,g\) continues sur \([a,b]\) :
\[\Big(\int_a^bf(t)g(t)\,\mathrm{d}t\Big)^2\leqslant\int_a^bf(t)^2\,\mathrm{d}t\ \int_a^bg(t)^2\,\mathrm{d}t,\]
avec égalité si et seulement si \(f\) et \(g\) sont colinéaires.
Soit \(f\) continue sur \([0,1]\). Majorons \(I=\int_0^1t\,f(t)\,\mathrm{d}t\).
D’abord, on choisit \(g(t)=t\), dont le carré s’intègre en \(\frac{1}{3}\). Ensuite, l’inégalité donne \(I^2\leqslant\frac{1}{3}\int_0^1f^2\).
Enfin, l’égalité a lieu exactement pour \(f(t)=\lambda t\). Par exemple, avec \(f(t)=t\), on trouve \(I=\frac{1}{3}\) et \(I^2=\frac{1}{9}=\frac{1}{3}\cdot\frac{1}{3}\).
3. Orthogonalité et familles orthonormées
Deux vecteurs \(x\) et \(y\) sont orthogonaux lorsque \(\langle x,y\rangle=0\). Nous étendons maintenant cette notion aux parties de \(E\), puis aux familles.
3.1 Orthogonal d’une partie
Pour une partie \(A\) de \(E\), on note \(A^{\perp}=\{x\in E\mid\forall a\in A,\ \langle x,a\rangle=0\}\) : c’est l’orthogonal de \(A\).
- Quelle que soit la partie \(A\), l’ensemble \(A^{\perp}\) est un sous-espace vectoriel de \(E\).
- L’inclusion \(A\subset B\) entraîne l’inclusion inverse \(B^{\perp}\subset A^{\perp}\).
- \(A^{\perp}=\big(\mathrm{Vect}\,A\big)^{\perp}\) : il suffit de tester les générateurs.
- \(\{0\}^{\perp}=E\) et \(E^{\perp}=\{0\}\).
La dernière propriété découle du caractère défini. En effet, un vecteur orthogonal à tout \(E\) est orthogonal à lui-même, donc nul. Par ailleurs, le troisième point est très utile en pratique. Pour décrire l’orthogonal d’un plan, on écrit simplement deux équations, une par vecteur générateur.
3.2 Familles orthonormées et Pythagore
On qualifie la famille \((e_1,\dots,e_p)\) d’orthogonale lorsque \(\langle e_i,e_j\rangle=0\) pour tous indices \(i\neq j\). Quand on impose en outre \(\|e_i\|=1\) pour chaque \(i\), on parle de famille orthonormée.
Une famille orthogonale de vecteurs non nuls est libre. De plus, si \((x_1,\dots,x_p)\) est orthogonale, on a le théorème de Pythagore :
\[\|x_1+\dots+x_p\|^2=\|x_1\|^2+\dots+\|x_p\|^2.\]
Supposons \(\sum_j\lambda_je_j=0\). Faisons le produit scalaire avec \(e_i\). Tous les termes croisés disparaissent, et il reste \(\lambda_i\|e_i\|^2=0\). Comme \(e_i\neq 0\), on obtient \(\lambda_i=0\). Pour Pythagore, on développe le carré de la somme : les doubles produits sont tous nuls.
Fixons une base \((e_1,\dots,e_n)\) de \(E\), supposée orthonormée. Les vecteurs \(x\) et \(y\) vérifient alors :
\[x=\sum_{i=1}^{n}\langle e_i,x\rangle e_i,\qquad\langle x,y\rangle=\sum_{i=1}^{n}x_iy_i,\qquad\|x\|^2=\sum_{i=1}^{n}x_i^2,\]
en notant \(x_i=\langle e_i,x\rangle\) et \(y_i=\langle e_i,y\rangle\).
Retenons l’essentiel : une coordonnée se calcule par un simple produit scalaire avec le vecteur de base correspondant. De plus, tout calcul se ramène au produit canonique de \(\mathbb{R}^n\). C’est pourquoi on cherche à fabriquer de telles bases.
3.3 Calculer un orthogonal en pratique
- Choisir une famille génératrice \((a_1,\dots,a_m)\) de la partie étudiée.
- Écrire les \(m\) conditions \(\langle x,a_j\rangle=0\) : ce sont des équations linéaires en les coordonnées de \(x\).
- Résoudre le système, puis donner une base de l’orthogonal.
- Contrôler, en dimension finie, que \(\dim A^{\perp}=n-\dim\mathrm{Vect}(A)\).
Sur \(\mathbb{R}_2[X]\), prenons \(\langle P,Q\rangle=\int_{-1}^{1}P(t)Q(t)\,\mathrm{d}t\). Cherchons l’orthogonal de \(X\).
Écrivons \(P=a+bX+cX^2\). Alors \(\langle P,X\rangle=\int_{-1}^{1}\big(at+bt^2+ct^3\big)\,\mathrm{d}t=\frac{2b}{3}\), car les puissances impaires s’intègrent en \(0\) sur un intervalle symétrique.
Par conséquent, \(P\perp X\) équivaut à \(b=0\). L’orthogonal de \(X\) est le plan \(\mathrm{Vect}(1,X^2)\) des polynômes pairs. On retrouve bien \(\dim=3-1=2\).
4. Le procédé de Gram-Schmidt
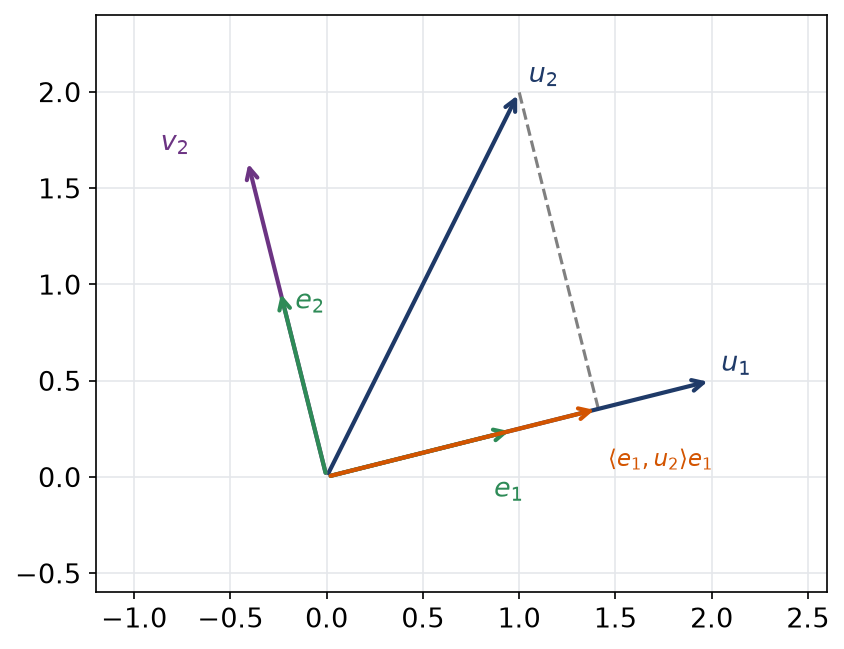
Partons d’une famille libre quelconque. Nous voulons la remplacer par une famille orthonormée qui engendre, étape par étape, les mêmes sous-espaces. L’idée est simple : on retire à chaque nouveau vecteur sa composante le long des précédents, puis on normalise.
Partons de \((u_1,\dots,u_p)\) libre dans \(E\). On peut lui associer une et une seule famille orthonormée \((e_1,\dots,e_p)\) vérifiant, à chaque rang \(k\) :
- \(\mathrm{Vect}(e_1,\dots,e_k)=\mathrm{Vect}(u_1,\dots,u_k)\) ;
- \(\langle e_k,u_k\rangle>0\).
Elle se construit par récurrence : \(e_1=\frac{u_1}{\|u_1\|}\), puis
\[v_k=u_k-\sum_{j=1}^{k-1}\langle e_j,u_k\rangle\,e_j,\qquad e_k=\frac{v_k}{\|v_k\|}.\]
Supposons \(e_1,\dots,e_{k-1}\) construits. Le vecteur \(v_k\) n’est pas nul : sinon \(u_k\) appartiendrait à \(\mathrm{Vect}(e_1,\dots,e_{k-1})=\mathrm{Vect}(u_1,\dots,u_{k-1})\), ce que la liberté interdit.
Ensuite, pour \(i<k\), on a \(\langle e_i,v_k\rangle=\langle e_i,u_k\rangle-\langle e_i,u_k\rangle=0\), car la famille \((e_j)\) est orthonormée. Ainsi, \(e_k\) est unitaire et orthogonal aux précédents.
De plus, \(\langle e_k,u_k\rangle=\langle e_k,v_k\rangle=\|v_k\|>0\). L’égalité des sous-espaces vient de ce que \(u_k\) s’exprime avec \(e_1,\dots,e_k\), et réciproquement. L’unicité se prouve par la même récurrence : \(e_k\) est un vecteur unitaire de \(\mathrm{Vect}(u_1,\dots,u_k)\) orthogonal aux \(e_j\) précédents, donc il vaut \(\pm\frac{v_k}{\|v_k\|}\), et le signe est fixé par la condition de positivité.
Un espace euclidien possède toujours des bases orthonormées : il suffit d’appliquer le procédé à une base quelconque. Par ailleurs, une famille orthonormée donnée peut être prolongée en base orthonormée de l’espace entier.
La figure montre la deuxième étape dans le plan. On projette \(u_2\) sur la droite de \(e_1\), on retire ce projeté, puis on normalise le reste \(v_2\).
4.1 Orthonormaliser en pratique
- Normaliser \(u_1\) : \(e_1=\frac{u_1}{\|u_1\|}\).
- Pour chaque \(k\geqslant 2\), calculer les produits \(\langle e_j,u_k\rangle\) pour \(j<k\).
- Former \(v_k\), puis vérifier qu’il est bien orthogonal aux \(e_j\) déjà obtenus.
- Diviser \(v_k\) par sa norme.
Variante utile : on peut orthogonaliser sans normaliser, avec \(v_k=u_k-\sum_{j}\frac{\langle v_j,u_k\rangle}{\|v_j\|^2}v_j\). Les racines carrées n’apparaissent alors qu’à la fin.
Dans \(\mathbb{R}^3\) canonique, orthonormalisons \(u_1=(1,2,2)\), \(u_2=(1,0,1)\), \(u_3=(0,0,1)\).
D’abord, \(\|u_1\|=3\), donc \(e_1=\frac{1}{3}(1,2,2)\).
Ensuite, \(\langle e_1,u_2\rangle=\frac{1+0+2}{3}=1\). Ainsi, \(v_2=(1,0,1)-\frac{1}{3}(1,2,2)=\frac{1}{3}(2,-2,1)\). Sa norme vaut \(\frac{\sqrt{9}}{3}=1\), donc \(e_2=\frac{1}{3}(2,-2,1)\).
Enfin, \(\langle e_1,u_3\rangle=\frac{2}{3}\) et \(\langle e_2,u_3\rangle=\frac{1}{3}\). On obtient \(v_3=(0,0,1)-\frac{2}{9}(1,2,2)-\frac{1}{9}(2,-2,1)=\frac{1}{9}(-4,-2,4)\). Sa norme vaut \(\frac{6}{9}\), d’où \(e_3=\frac{1}{3}(-2,-1,2)\).
Contrôle : \(\langle e_1,e_3\rangle=\frac{-2-2+4}{9}=0\) et \(\langle e_2,e_3\rangle=\frac{-4+2+2}{9}=0\).
Piège à éviter :
L’ordre des vecteurs compte. Si l’on traite \(u_3\) avant \(u_1\), on obtient une autre base orthonormée. Par conséquent, on respecte l’ordre imposé par l’énoncé, surtout lorsqu’on demande \(\mathrm{Vect}(e_1,\dots,e_k)=\mathrm{Vect}(u_1,\dots,u_k)\).
4.2 Gram-Schmidt dans un espace de fonctions
Le procédé ne se limite pas à \(\mathbb{R}^n\). Il s’applique tel quel aux polynômes ou aux fonctions continues, à condition de calculer les produits scalaires avec la bonne formule.
Sur \(\mathcal{C}([0,2],\mathbb{R})\) muni de \(\langle f,g\rangle=\int_0^2fg\), orthonormalisons la famille \((1,t)\).
D’abord, \(\|1\|^2=\int_0^2 1\,\mathrm{d}t=2\), donc \(e_0=\frac{1}{\sqrt{2}}\).
Ensuite, \(\langle t,1\rangle=\int_0^2t\,\mathrm{d}t=2\). On retire la composante sur la constante : \(v_1=t-\frac{2}{2}=t-1\). Par ailleurs, \(\|t-1\|^2=\int_0^2(t-1)^2\,\mathrm{d}t=\frac{2}{3}\).
Finalement, \(e_1(t)=\sqrt{\frac{3}{2}}\,(t-1)\). On remarque que \(t-1\) est centrée sur \([0,2]\) : c’est la condition d’orthogonalité à la constante.
Remarque :
Changer l’intervalle d’intégration change le produit scalaire, donc la base obtenue. Ainsi, sur \([0,2]\), le polynôme orthogonal aux constantes est \(t-1\). En revanche, sur \([-1,1]\), ce serait simplement \(t\). Il faut donc toujours lire l’énoncé avec attention.
5. Projection orthogonale et distance à un sous-espace
C’est la partie la plus utile aux concours. Elle transforme des problèmes de minimisation en calculs de projection. Désormais, \(F\) désigne un sous-espace de \(E\) que l’on suppose de dimension finie, même si \(E\) ne l’est pas.
5.1 Le supplémentaire orthogonal
On a \(E=F\oplus F^{\perp}\). La projection sur \(F\) parallèlement à \(F^{\perp}\) s’appelle la projection orthogonale sur \(F\), notée \(p_F\). Si \((e_1,\dots,e_m)\) est une base orthonormée de \(F\), alors
\[p_F(x)=\sum_{i=1}^{m}\langle e_i,x\rangle\,e_i.\]
Si \(z\in F\cap F^{\perp}\), alors \(\langle z,z\rangle=0\), donc \(z=0\) : la somme est directe. Pour l’existence, Gram-Schmidt fournit une base orthonormée \((e_i)\) de \(F\). Posons \(y=\sum_i\langle e_i,x\rangle e_i\in F\). Pour tout \(k\), on a \(\langle e_k,x-y\rangle=\langle e_k,x\rangle-\langle e_k,x\rangle=0\). Donc \(x-y\in F^{\perp}\), et \(x=y+(x-y)\) est la décomposition cherchée.
En dimension finie \(n\), on en déduit \(\dim F^{\perp}=n-\dim F\) et \((F^{\perp})^{\perp}=F\). En revanche, si \(F\) est de dimension infinie, ces résultats peuvent tomber en défaut.
Le projeté \(p=p_F(x)\) est caractérisé par les deux conditions \(p\in F\) et \(x-p\in F^{\perp}\). Si \(F=\mathrm{Vect}(f_1,\dots,f_m)\), la seconde condition s’écrit \(\langle x-p,f_i\rangle=0\) pour chaque \(i\).
5.2 Distance à un sous-espace
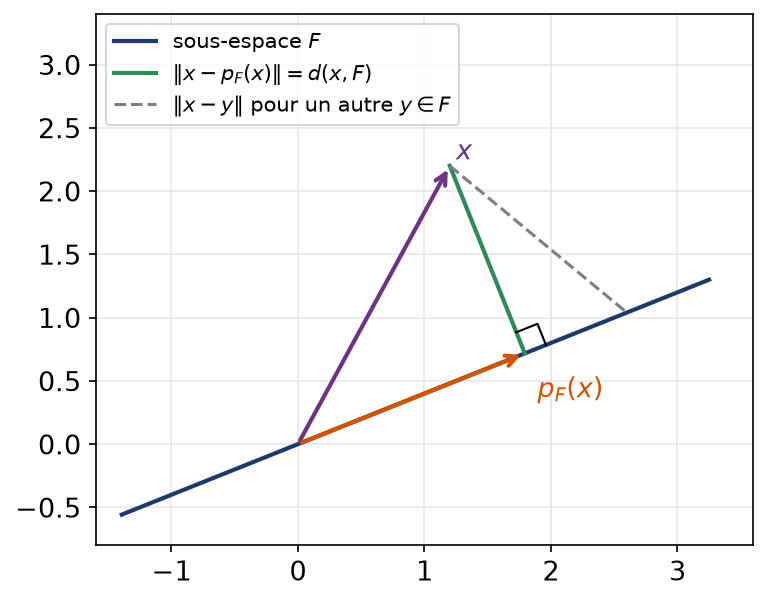
Pour tout \(x\in E\), le minimum de \(\|x-y\|\) pour \(y\in F\) est atteint en un unique point, à savoir \(p_F(x)\). Ainsi,
\[d(x,F)=\|x-p_F(x)\|\qquad\text{et}\qquad d(x,F)^2=\|x\|^2-\|p_F(x)\|^2.\]
Soit \(y\in F\). On écrit \(x-y=\big(x-p_F(x)\big)+\big(p_F(x)-y\big)\). Le premier vecteur est dans \(F^{\perp}\) et le second dans \(F\). Par Pythagore, \(\|x-y\|^2=\|x-p_F(x)\|^2+\|p_F(x)-y\|^2\geqslant\|x-p_F(x)\|^2\). L’égalité a lieu exactement quand \(y=p_F(x)\). La seconde formule s’obtient de même, en appliquant Pythagore à \(x=p_F(x)+(x-p_F(x))\).
Pour calculer \(p_F(x)\) lorsque \(F=\mathrm{Vect}(f_1,\dots,f_m)\) :
- Méthode directe : écrire \(p_F(x)=\sum_j\lambda_jf_j\), puis résoudre le système \(\sum_j\lambda_j\langle f_j,f_i\rangle=\langle x,f_i\rangle\), pour \(i=1,\dots,m\).
- Méthode orthonormée : orthonormaliser \((f_j)\) par Gram-Schmidt, puis appliquer la formule \(\sum_i\langle e_i,x\rangle e_i\).
- Pour un hyperplan \(H=\{n\}^{\perp}\), passer par la droite normale : \(p_H(x)=x-\frac{\langle n,x\rangle}{\|n\|^2}n\) et \(d(x,H)=\frac{|\langle n,x\rangle|}{\|n\|}\).
Dans \(\mathbb{R}^3\), projetons \(x=(2,1,0)\) sur le plan \(H:x+y-z=0\). Un vecteur normal est \(n=(1,1,-1)\), avec \(\|n\|^2=3\) et \(\langle n,x\rangle=3\).
Ainsi, \(p_H(x)=(2,1,0)-(1,1,-1)=(1,0,1)\). On vérifie que \(1+0-1=0\). Enfin, \(d(x,H)=\frac{3}{\sqrt{3}}=\sqrt{3}\).
5.3 Minimiser une intégrale par projection
Voici l’application qui tombe régulièrement. On cherche les réels \(a,b\) qui minimisent \(J(a,b)=\int_0^1\big(\sqrt{t}-a-bt\big)^2\,\mathrm{d}t\).
On se place dans \(\mathcal{C}([0,1],\mathbb{R})\) muni du produit intégral. Avec \(f(t)=\sqrt{t}\) et \(F=\mathrm{Vect}(1,t)\), on a \(J(a,b)=\|f-(a+bt)\|^2\). Le minimum est donc \(d(f,F)^2\), atteint au projeté.
Ensuite, on calcule \(\langle 1,1\rangle=1\), \(\langle 1,t\rangle=\frac{1}{2}\), \(\langle t,t\rangle=\frac{1}{3}\), \(\langle f,1\rangle=\frac{2}{3}\) et \(\langle f,t\rangle=\frac{2}{5}\). Les conditions d’orthogonalité donnent
\[\left\{\begin{array}{l}a+\frac{1}{2}b=\frac{2}{3}\\ \frac{1}{2}a+\frac{1}{3}b=\frac{2}{5}\end{array}\right.\]
La résolution donne \(b=\frac{4}{5}\), puis \(a=\frac{4}{15}\).
Enfin, puisque \(f-p\) est orthogonal à \(p\), on a \(\min J=\|f\|^2-\langle f,p\rangle=\frac{1}{2}-\Big(\frac{4}{15}\cdot\frac{2}{3}+\frac{4}{5}\cdot\frac{2}{5}\Big)=\frac{1}{2}-\frac{112}{225}=\frac{1}{450}\).

Remarque :
Le résultat \(\frac{1}{450}\) est très petit. Cela confirme visuellement que la droite colle à la courbe, sauf près de \(0\) où la racine a une tangente verticale.
5.4 Inégalité de Bessel et contrôle des calculs
Le théorème de Pythagore appliqué à \(x=p_F(x)+\big(x-p_F(x)\big)\) fournit un contrôle gratuit. En effet, le projeté est toujours plus court que le vecteur de départ.
Si \((e_1,\dots,e_m)\) est une famille orthonormée de \(E\), alors pour tout \(x\in E\) :
\[\sum_{i=1}^{m}\langle e_i,x\rangle^2\leqslant\|x\|^2.\]
C’est l’inégalité de Bessel ; l’égalité a lieu si et seulement si \(x\in\mathrm{Vect}(e_1,\dots,e_m)\).
Ainsi, après un calcul de projeté, on vérifie que \(\|p_F(x)\|\leqslant\|x\|\). Dans l’exemple de la partie 5.2, on a \(\|(1,0,1)\|^2=2\leqslant 5=\|(2,1,0)\|^2\). De plus, la différence \(5-2=3\) vaut bien \(d(x,H)^2\).
Piège à éviter :
Prenons \(F=\mathrm{Vect}(f_1,f_2)\) dans \(\mathbb{R}^3\), avec \(f_1=(1,0,0)\) et \(f_2=(1,1,0)\). Posons \(e_1=f_1\) et \(e_2=\frac{f_2}{\sqrt{2}}\) : ces vecteurs sont unitaires, mais pas orthogonaux. Pour \(x=(0,1,0)\), la formule \(\sum\langle e_i,x\rangle e_i\) donne alors \(\big(\frac{1}{2},\frac{1}{2},0\big)\). Or \(x\) appartient déjà à \(F\), donc son projeté est \(x\) lui-même. Il faut donc orthonormaliser avant d’appliquer la formule.
Les erreurs fréquentes
- Oublier de prouver le caractère défini, ou le justifier sans invoquer la continuité dans le cas intégral.
- Appliquer la formule \(\sum_i\langle e_i,x\rangle e_i\) avec une base de \(F\) qui n’est pas orthonormée : le résultat est alors faux.
- Annoncer un minimum grâce à Cauchy-Schwarz sans exhiber le cas d’égalité.
- Confondre \(d(x,F)\) et \(d(x,F)^2\) dans un problème de moindres carrés : l’intégrale minimisée est un carré de distance.
- Normaliser trop tôt dans Gram-Schmidt et traîner des racines carrées dans tous les calculs.
- Écrire \((F^{\perp})^{\perp}=F\) ou \(\dim F^{\perp}=n-\dim F\) sans vérifier que l’on travaille en dimension finie. Dans un espace de fonctions, ces égalités demandent une justification, et elles peuvent même être fausses. Avant de les citer, on précise donc toujours le cadre euclidien.
Fiche mémo
- Produit scalaire : symétrique, bilinéaire, positif, défini.
- Exemples : \(\sum x_iy_i\) sur \(\mathbb{R}^n\), \(\mathrm{tr}(A^{\mathsf{T}}B)\) sur les matrices, \(\int_a^b fg\) sur les fonctions continues.
- Polarisation : \(\langle x,y\rangle=\frac{1}{4}\big(\|x+y\|^2-\|x-y\|^2\big)\).
- Cauchy-Schwarz : \(|\langle x,y\rangle|\leqslant\|x\|\|y\|\), égalité si et seulement si colinéarité.
- \(A^{\perp}\) est un sous-espace ; il suffit de tester les générateurs.
- Famille orthogonale de vecteurs non nuls : libre ; Pythagore s’applique.
- Base orthonormée : coordonnées \(x_i=\langle e_i,x\rangle\).
- Gram-Schmidt : \(v_k=u_k-\sum_{j<k}\langle e_j,u_k\rangle e_j\), puis \(e_k=\frac{v_k}{\|v_k\|}\).
- Projeté : \(p\in F\) et \(x-p\in F^{\perp}\) ; distance \(d(x,F)=\|x-p_F(x)\|\).
- Hyperplan de normale \(n\) : \(d(x,H)=\frac{|\langle n,x\rangle|}{\|n\|}\).
Questions fréquentes
Pourquoi faut-il la continuité pour le produit scalaire intégral ?
Pour conclure que f est nulle quand l’intégrale de son carré s’annule, on utilise un théorème qui exige la continuité de f au carré. Pour une fonction en escalier valant 1 en un seul point et 0 ailleurs, le carré s’intègre en 0 alors que la fonction ne s’annule pas partout. On travaille donc dans l’espace des fonctions continues sur un segment.
Faut-il normaliser à chaque étape de Gram-Schmidt ?
Ce n’est pas obligatoire. On peut d’abord orthogonaliser en gardant des vecteurs non unitaires, puis diviser chacun par sa norme à la fin. Cette variante évite de manipuler des racines carrées pendant tout le calcul.
Comment reconnaître un exercice de distance déguisé ?
Un signal fort : la quantité à minimiser est une norme au carré, par exemple une somme ou une intégrale de carrés, où les paramètres entrent linéairement. On a alors affaire à une distance à un sous-espace. On identifie le vecteur, le sous-espace et le produit scalaire. Le minimum est alors le carré de la distance, atteint au projeté orthogonal.
Pour aller plus loin
- S’exercer : exercices corrigés de maths sup (MPSI) sur produit scalaire et Gram-Schmidt
- Bases utiles : Bases, dimension et formule de Grassmann, Noyau, image et théorème du rang
- Chapitre d’avant : Variables aléatoires finies, espérance et variance
- Chapitre d’après : Dérivées partielles, gradient et points critiques
- Vérifier ses acquis : QCM de maths sup (MPSI) sur produit scalaire et Gram-Schmidt
- Contrôle corrigé en temps limité : Distance à un sous-espace euclidien : contrôle de maths en MPSI
- Tous les chapitres : le sommaire de maths sup (MPSI)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «produit scalaire et Gram-Schmidt en maths sup (MPSI) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths sup (MPSI)
Cours
Tout voir Équivalents et négligeabilité en maths sup (MPSI)
- Injections, surjections et relations en maths sup (MPSI)
- Dérivées partielles et gradient en maths sup (MPSI)
- Lois internes, groupes et anneaux en maths sup (MPSI)
- Variables aléatoires finies en maths sup (MPSI)
- Calcul de développements limités en maths sup (MPSI)
Exercices corrigés
Tout voir- Projecteurs, symétries et hyperplans en maths sup (MPSI)
- Dérivées partielles et gradient en maths sup (MPSI)
- Équivalents et négligeabilité en maths sup (MPSI)
- Dimension et formule de Grassmann en maths sup (MPSI)
- IPP et changement de variable en maths sup (MPSI)
- Calcul de développements limités en maths sup (MPSI)
Contrôles
Tout voir
QCM
Tout voir