Exponentielle de matrice en maths spé (MP) : cours et méthodes

L’exponentielle d’une matrice prolonge la fonction exponentielle réelle aux matrices carrées, grâce à une série qui converge dans tout espace normé de dimension finie. Ce chapitre du second semestre s’appuie sur la réduction des endomorphismes et sur les séries de fonctions : il en est une application directe.
Le cours d’exponentielle matrice MP suit une logique de méthodes. Nous voyons d’abord comment calculer \(\exp(A)\) selon ce que l’on sait de \(A\) : matrice nilpotente, diagonalisable, annulée par un petit polynôme ou seulement trigonalisable. Ensuite, nous étudions le spectre, le déterminant et la dérivée de \(t\mapsto\exp(tA)\).
Le but final est la résolution des systèmes différentiels \(X^{\prime}=AX\) à coefficients constants, puis l’étude du comportement des solutions quand \(t\) tend vers l’infini.
Ce que vous saurez faire
- Justifier l’existence de \(\exp(A)\) et de \(\exp(u)\) par une série absolument convergente.
- Choisir la méthode de calcul de \(\exp(tA)\) selon la réduction disponible.
- Vérifier la commutation avant d’écrire \(\exp(A+B)=\exp(A)\exp(B)\), et produire un contre-exemple sinon.
- Relier le spectre et le déterminant de \(\exp(A)\) à ceux de \(A\).
- Résoudre un système \(X^{\prime}=AX\) par diagonalisation, trigonalisation ou calcul direct de \(\exp(tA)\).
- Décrire le comportement des solutions quand \(t\to+\infty\).
1. Définir l’exponentielle de matrice
On fixe \(n\geqslant 1\) et \(\mathbb{K}=\mathbb{R}\) ou \(\mathbb{C}\). On munit \(\mathcal{M}_n(\mathbb{K})\) d’une norme d’algèbre, c’est-à-dire vérifiant \(\|AB\|\leqslant\|A\|\,\|B\|\). Une norme subordonnée convient, par exemple. Toutes les normes étant équivalentes en dimension finie, ce choix n’influe pas sur les convergences.
Pour \(A\in\mathcal{M}_n(\mathbb{K})\), on pose :
\[\exp(A)=\sum_{k=0}^{+\infty}\frac{A^k}{k!}=I_n+A+\frac{A^2}{2}+\frac{A^3}{6}+\cdots\]
De même, pour un endomorphisme \(u\) d’un espace \(E\) de dimension finie, \(\exp(u)=\sum_{k\geqslant 0}u^k/k!\). Si \(A\) représente \(u\) dans une base, alors \(\exp(A)\) représente \(\exp(u)\) dans cette même base.
Par sous-multiplicativité, \(\|A^k\|\leqslant\|A\|^k\). Ainsi, \(\left\|\frac{A^k}{k!}\right\|\leqslant\frac{\|A\|^k}{k!}\), terme général de la série de \(\mathrm{e}^{\|A\|}\). La série matricielle est donc absolument convergente. Or, en dimension finie, une série absolument convergente converge. De plus, on obtient \(\|\exp(A)\|\leqslant\mathrm{e}^{\|A\|}\).
1.1 Premiers calculs : matrices nilpotentes et diagonales
Lorsque \(A\) est nilpotente, la série s’arrête : il ne reste qu’une somme finie. C’est le cas le plus agréable.
Soit \(N=\begin{pmatrix}0&2&-1\\0&0&3\\0&0&0\end{pmatrix}\). D’abord, on calcule \(N^2=\begin{pmatrix}0&0&6\\0&0&0\\0&0&0\end{pmatrix}\), puis \(N^3=0\). Ensuite, la série se réduit à trois termes :
\[\exp(N)=I_3+N+\frac{N^2}{2}=\begin{pmatrix}1&2&2\\0&1&3\\0&0&1\end{pmatrix}.\]
Le coefficient en haut à droite vaut en effet \(-1+6/2=2\).
- Si \(D=\mathrm{diag}(\lambda_1,\ldots,\lambda_n)\), alors \(\exp(D)=\mathrm{diag}(\mathrm{e}^{\lambda_1},\ldots,\mathrm{e}^{\lambda_n})\).
- Pour \(P\) inversible, \(\exp(PAP^{-1})=P\exp(A)P^{-1}\).
- \(\exp(A^{\top})=\exp(A)^{\top}\), et \(A\) commute avec \(\exp(A)\).
- Si \(T\) est triangulaire supérieure, \(\exp(T)\) l’est aussi, avec les \(\mathrm{e}^{t_{ii}}\) sur la diagonale.
Ces règles viennent toutes du même principe. On les vérifie d’abord sur les sommes partielles, où le calcul est algébrique. Ensuite, on passe à la limite, car les applications \(M\mapsto PMP^{-1}\) et \(M\mapsto M^{\top}\) sont linéaires en dimension finie, donc continues.
Piège à éviter :
L’exponentielle n’agit pas coefficient par coefficient. Par exemple, la matrice \(N\) ci-dessus a des zéros sur la diagonale, mais \(\exp(N)\) a des \(1\). Seules les matrices diagonales se traitent terme à terme.
1.2 Le point de vue des endomorphismes
Raisonner sur \(u\) plutôt que sur une matrice évite parfois tout calcul. En effet, \(\exp(u)\) ne dépend pas de la base, et certaines identités se lisent directement sur l’action de \(u\).
Sur \(E=\mathbb{R}_3[X]\), notons \(D\) la dérivation \(P\mapsto P^{\prime}\). Elle est nilpotente, car \(D^4=0\). Ainsi, pour tout réel \(t\) et tout \(P\in E\) :
\[\exp(tD)(P)=P+tP^{\prime}+\frac{t^2}{2}P^{\prime\prime}+\frac{t^3}{6}P^{(3)}.\]
Or la formule de Taylor pour les polynômes affirme que cette somme vaut exactement \(P(X+t)\). Autrement dit, \(\exp(tD)\) est l’opérateur de translation \(P(X)\mapsto P(X+t)\). On vérifie au passage que \(\exp(sD)\exp(tD)=\exp((s+t)D)\), puisque translater de \(t\) puis de \(s\) revient à translater de \(s+t\).
Dans la base \((1,X,X^2,X^3)\), la matrice de \(D\) est strictement triangulaire. On retrouve donc la règle du 1.1 : sa puissance quatrième est nulle, et la série s’arrête au rang \(3\).
2. Exponentielle d’une somme et commutation
Pour les réels, \(\mathrm{e}^{a+b}=\mathrm{e}^a\mathrm{e}^b\). Pour les matrices, cette règle exige une hypothèse : les deux matrices doivent commuter. C’est le point le plus surveillé à l’oral.
Hypothèse : \(AB=BA\). Conclusion : \(\exp(A+B)=\exp(A)\exp(B)=\exp(B)\exp(A)\).
Comme \(A\) et \(B\) commutent, la formule du binôme s’applique : \(\frac{(A+B)^m}{m!}=\sum_{k+\ell=m}\frac{A^k}{k!}\cdot\frac{B^\ell}{\ell!}\). Ainsi, la série de \(\exp(A+B)\) est le produit de Cauchy des séries de \(\exp(A)\) et \(\exp(B)\). Or ces deux séries convergent absolument dans l’algèbre normée \(\mathcal{M}_n(\mathbb{K})\). Le produit de Cauchy converge donc vers le produit des sommes.
- \(\exp(A)\) est inversible, d’inverse \(\exp(-A)\), car \(A\) et \(-A\) commutent.
- Pour tous réels \(s\) et \(t\), \(\exp\bigl((s+t)A\bigr)=\exp(sA)\exp(tA)\).
- Pour \(\lambda\in\mathbb{K}\), \(\exp(\lambda I_n+A)=\mathrm{e}^{\lambda}\exp(A)\).
- Si \(AB=BA\), alors \(B\) commute aussi avec \(\exp(A)\), car \(B\) commute avec chaque somme partielle.
Prenons \(A=\begin{pmatrix}0&2\\0&0\end{pmatrix}\) et \(B=\begin{pmatrix}0&0\\2&0\end{pmatrix}\). Elles ne commutent pas. D’une part, \(\exp(A)\exp(B)=\begin{pmatrix}1&2\\0&1\end{pmatrix}\begin{pmatrix}1&0\\2&1\end{pmatrix}=\begin{pmatrix}5&2\\2&1\end{pmatrix}\). D’autre part, \((A+B)^2=4I_2\), donc en séparant les puissances paires et impaires :
\[\exp(A+B)=\mathrm{ch}(2)\,I_2+\frac{\mathrm{sh}(2)}{2}(A+B)=\begin{pmatrix}\mathrm{ch}\,2&\mathrm{sh}\,2\\\mathrm{sh}\,2&\mathrm{ch}\,2\end{pmatrix}.\]
Comme \(\mathrm{ch}\,2\approx 3{,}76\neq 5\), les deux résultats diffèrent.
2.1 La décomposition « scalaire plus nilpotente »
Le corollaire précédent fournit la méthode la plus rapide pour une matrice à une seule valeur propre. On écrit \(A=\lambda I_n+N\) : la partie scalaire commute avec tout, et \(N\) est nilpotente.
Soit \(A=\begin{pmatrix}2&1&-2\\0&2&3\\0&0&2\end{pmatrix}=2I_3+N\). On trouve \(N^2=\begin{pmatrix}0&0&3\\0&0&0\\0&0&0\end{pmatrix}\) et \(N^3=0\). Par conséquent, pour tout réel \(t\) :
\[\exp(tA)=\mathrm{e}^{2t}\left(I_3+tN+\frac{t^2}{2}N^2\right)=\mathrm{e}^{2t}\begin{pmatrix}1&t&-2t+\frac{3}{2}t^2\\0&1&3t\\0&0&1\end{pmatrix}.\]
En \(t=0\), on retrouve bien \(I_3\).
Piège à éviter :
Écrire \(A=D+N\) avec \(D\) diagonale et \(N\) nilpotente ne suffit pas : il faut encore \(DN=ND\). Par exemple, \(\begin{pmatrix}1&1\\0&2\end{pmatrix}\) est la somme de \(\mathrm{diag}(1,2)\) et d’une nilpotente, mais ces deux morceaux ne commutent pas. Cette matrice est d’ailleurs diagonalisable, et on la traite par la partie 3.
3. Calculer exp(tA) selon la réduction disponible
Le calcul d’une exponentielle de matrice ne se fait presque jamais en sommant la série terme à terme. On commence par réduire \(A\), ou par trouver une relation polynomiale simple. Le tableau de bord est le suivant.
3.1 Cas diagonalisable
- Trouver les valeurs propres \(\lambda_i\) et une base de vecteurs propres, rangés dans \(P\).
- Écrire \(A=PDP^{-1}\), donc \(\exp(tA)=P\,\mathrm{diag}(\mathrm{e}^{\lambda_1t},\ldots,\mathrm{e}^{\lambda_nt})\,P^{-1}\).
- Calculer \(P^{-1}\) seulement si la matrice \(\exp(tA)\) elle-même est demandée ; pour un système, \(P\) suffit souvent.
- Contrôler le résultat en \(t=0\).
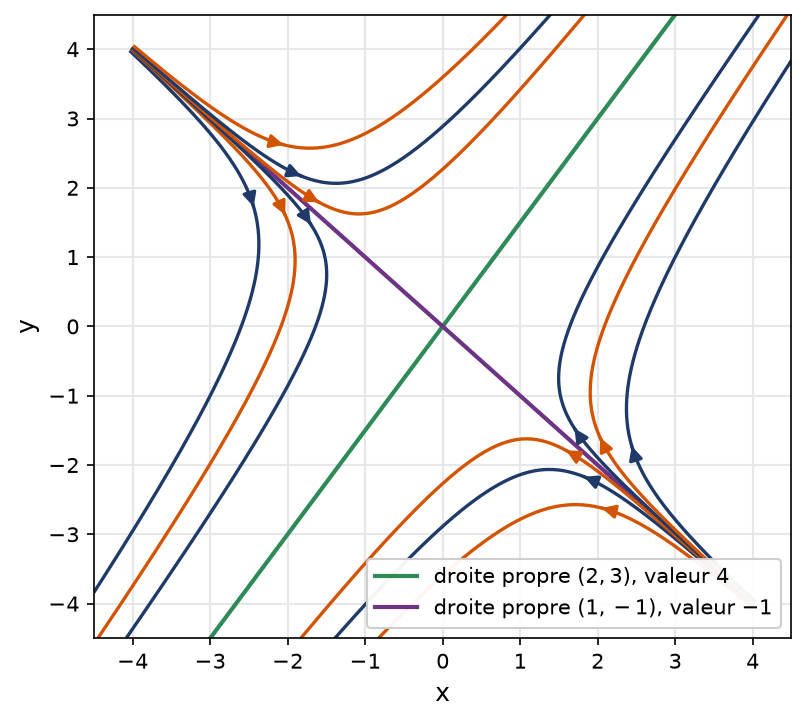
Soit \(A=\begin{pmatrix}1&2\\3&2\end{pmatrix}\). Son polynôme caractéristique vaut \(X^2-3X-4=(X-4)(X+1)\). Ensuite, \((2,3)\) engendre l’espace propre associé à \(4\), et \((1,-1)\) celui associé à \(-1\). Avec \(P=\begin{pmatrix}2&1\\3&-1\end{pmatrix}\), on obtient \(P^{-1}=\frac15\begin{pmatrix}1&1\\3&-2\end{pmatrix}\), puis :
\[\exp(tA)=\frac15\begin{pmatrix}2\mathrm{e}^{4t}+3\mathrm{e}^{-t}&2\mathrm{e}^{4t}-2\mathrm{e}^{-t}\\3\mathrm{e}^{4t}-3\mathrm{e}^{-t}&3\mathrm{e}^{4t}+2\mathrm{e}^{-t}\end{pmatrix}.\]
3.2 Une relation polynomiale de petit degré
Souvent, \(A\) vérifie une relation comme \(A^2=A\), \(A^2=I_n\) ou \(A^2=-\omega^2I_n\). On regroupe alors les puissances de la série selon leur parité ou leur forme.
- Chercher une relation simple, par exemple avec le théorème de Cayley-Hamilton en taille 2 : \(A^2-\mathrm{tr}(A)A+\det(A)I_2=0\).
- En déduire toutes les puissances \(A^k\) en fonction de \(I_n\) et \(A\) (ou de \(I_n\), \(A\), \(A^2\)).
- Regrouper les termes de la série et reconnaître des séries usuelles : \(\cos\), \(\sin\), \(\mathrm{ch}\), \(\mathrm{sh}\), \(\exp\).
Soit \(A=\begin{pmatrix}1&-2\\1&-1\end{pmatrix}\). Ici \(\mathrm{tr}A=0\) et \(\det A=1\), donc Cayley-Hamilton donne \(A^2=-I_2\). Ainsi, \(A^{2k}=(-1)^kI_2\) et \(A^{2k+1}=(-1)^kA\). En séparant les indices pairs et impairs :
\[\exp(tA)=\cos(t)\,I_2+\sin(t)\,A=\begin{pmatrix}\cos t+\sin t&-2\sin t\\\sin t&\cos t-\sin t\end{pmatrix}.\]
Pour un projecteur \(p\), on a de même \(\exp(tp)=\mathrm{id}+(\mathrm{e}^t-1)p\), car \(p^k=p\) pour \(k\geqslant 1\).
Pour une matrice \(2\times 2\) à deux valeurs propres distinctes \(\lambda\) et \(\mu\), on peut chercher directement \(\exp(tA)=\alpha(t)I_2+\beta(t)A\). En effet, \(\exp(tA)\) est un polynôme en \(A\), et tout polynôme en \(A\) se réduit au degré \(1\) par Cayley-Hamilton. En appliquant l’égalité à un vecteur propre, on obtient le système \(\alpha+\beta\lambda=\mathrm{e}^{\lambda t}\) et \(\alpha+\beta\mu=\mathrm{e}^{\mu t}\).
Par exemple, pour \(A=\begin{pmatrix}1&2\\3&2\end{pmatrix}\) de valeurs propres \(4\) et \(-1\), on trouve \(\beta=\frac{\mathrm{e}^{4t}-\mathrm{e}^{-t}}{5}\) et \(\alpha=\frac{\mathrm{e}^{4t}+4\mathrm{e}^{-t}}{5}\). Le coefficient en haut à gauche vaut alors \(\alpha+\beta=\frac{2\mathrm{e}^{4t}+3\mathrm{e}^{-t}}{5}\) : c’est bien le résultat obtenu en 3.1, sans inverser de matrice de passage.
3.3 Cas seulement trigonalisable
Sur \(\mathbb{C}\), toute matrice est trigonalisable. Si \(A\) n’a qu’une valeur propre, la méthode 2.1 s’applique. Sinon, on évite de calculer \(\exp(tA)\) et l’on résout directement le système triangulaire, ligne par ligne, comme en partie 5.
Devant une matrice concrète, on peut suivre cet ordre de questions.
- La matrice est-elle diagonale, triangulaire ou nilpotente ? Le calcul est alors immédiat ou se réduit à une somme finie.
- A-t-elle une seule valeur propre ? On écrit \(A=\lambda I_n+N\).
- Vérifie-t-elle une relation simple, comme \(A^2=A\), \(A^2=I_n\), \(A^2=-\omega^2I_n\) ou \(A^3=-\omega^2A\) ? On regroupe la série.
- Est-elle diagonalisable ? On passe par \(P\) et \(D\), ou par l’astuce \(\alpha I+\beta A\) en taille \(2\).
- Sinon, on trigonalise et l’on travaille sur le système triangulaire associé.
4. Spectre, continuité et dérivée
4.1 Spectre et déterminant
Soit \(A\in\mathcal{M}_n(\mathbb{C})\) de valeurs propres \(\lambda_1,\ldots,\lambda_n\), comptées avec multiplicité. Alors les valeurs propres de \(\exp(A)\) sont \(\mathrm{e}^{\lambda_1},\ldots,\mathrm{e}^{\lambda_n}\), avec les mêmes multiplicités. En particulier :
\[\det\bigl(\exp(A)\bigr)=\mathrm{e}^{\mathrm{tr}(A)}.\]
On trigonalise : \(A=PTP^{-1}\) avec \(T\) triangulaire supérieure, de diagonale \((\lambda_1,\ldots,\lambda_n)\). D’après la partie 1, \(\exp(T)\) est triangulaire, de diagonale \((\mathrm{e}^{\lambda_1},\ldots,\mathrm{e}^{\lambda_n})\). De plus, \(\exp(A)=P\exp(T)P^{-1}\) est semblable à \(\exp(T)\). On lit donc le spectre sur la diagonale. Enfin, le déterminant est le produit des valeurs propres, soit \(\mathrm{e}^{\lambda_1+\cdots+\lambda_n}\).
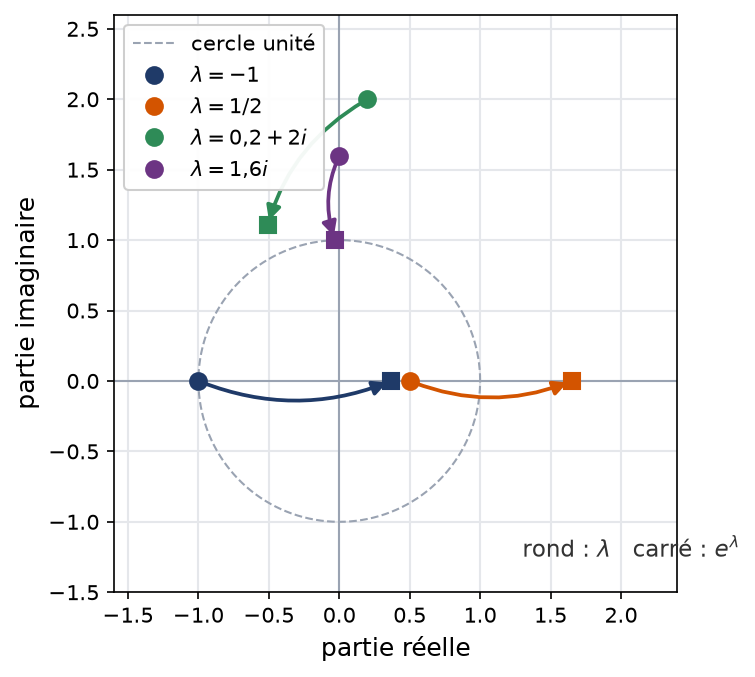
La figure place dans le plan complexe quatre valeurs propres et leurs images par l’exponentielle. Une valeur propre réelle donne une image réelle strictement positive ; une valeur propre de partie réelle nulle donne une image de module \(1\).
Remarque :
Une matrice réelle de déterminant négatif n’est donc jamais l’exponentielle d’une matrice réelle, puisque \(\mathrm{e}^{\mathrm{tr}A}>0\). Ainsi, \(\mathrm{diag}(-1,2)\) n’est pas une exponentielle dans \(\mathcal{M}_2(\mathbb{R})\).
Soit \(A=\begin{pmatrix}0&-\pi\\\pi&0\end{pmatrix}\). D’abord, \(A^2=-\pi^2I_2\), donc \(\exp(A)=\cos(\pi)I_2+\frac{\sin\pi}{\pi}A=-I_2\). Ensuite, les valeurs propres de \(A\) sont \(\pm\mathrm{i}\pi\), et leurs exponentielles valent toutes deux \(-1\). La proposition est donc respectée. Cet exemple montre aussi que deux valeurs propres distinctes de \(A\) peuvent avoir la même image : l’exponentielle complexe n’est pas injective.
4.2 Continuité de l’exponentielle
L’application \(A\mapsto\exp(A)\) est continue sur \(\mathcal{M}_n(\mathbb{K})\).
Fixons \(R>0\). Sur la boule fermée \(\|A\|\leqslant R\), chaque terme \(A\mapsto A^k/k!\) est continu, car polynomial en les coefficients. De plus, il est majoré en norme par \(R^k/k!\), terme d’une série convergente. La convergence est donc normale sur cette boule, et la somme y est continue. Comme \(R\) est quelconque, l’exponentielle est continue partout.
4.3 Dérivée de t ↦ exp(tA)
L’application \(E:t\mapsto\exp(tA)\) est de classe \(\mathcal{C}^1\) sur \(\mathbb{R}\), et :
\[E^{\prime}(t)=A\exp(tA)=\exp(tA)A.\]
Posons \(u_k(t)=\frac{t^k}{k!}A^k\). Pour \(k\geqslant 1\), on a \(u_k^{\prime}(t)=\frac{t^{k-1}}{(k-1)!}A^k=A\,u_{k-1}(t)\). Sur un segment \([-R,R]\), on majore \(\|u_k^{\prime}(t)\|\leqslant\|A\|\frac{(R\|A\|)^{k-1}}{(k-1)!}\). La série des dérivées converge donc normalement sur tout segment. Par dérivation terme à terme, \(E^{\prime}(t)=A\sum_{k\geqslant 1}u_{k-1}(t)=A\exp(tA)\). Enfin, \(A\) commute avec \(\exp(tA)\).
Remarque :
Ce théorème caractérise \(t\mapsto\exp(tA)\) : c’est l’unique application dérivable \(M:\mathbb{R}\to\mathcal{M}_n(\mathbb{K})\) telle que \(M^{\prime}=AM\) et \(M(0)=I_n\). En effet, chaque colonne de \(M\) résout alors un système \(X^{\prime}=AX\), et la partie 5 donne l’unicité. Cette caractérisation sert à reconnaître une exponentielle sans sommer de série : il suffit de vérifier une équation différentielle et une valeur en \(0\).
5. Systèmes X’ = AX à coefficients constants
On cherche les fonctions \(X:\mathbb{R}\to\mathbb{K}^n\) dérivables telles que \(X^{\prime}(t)=AX(t)\) pour tout \(t\). L’exponentielle de matrice donne toutes les solutions d’un coup.
Pour \(t_0\in\mathbb{R}\) et \(X_0\in\mathbb{K}^n\), le problème \(X^{\prime}=AX\), \(X(t_0)=X_0\) admet une unique solution sur \(\mathbb{R}\) :
\[X(t)=\exp\bigl((t-t_0)A\bigr)X_0.\]
Par conséquent, l’ensemble des solutions est un espace vectoriel de dimension \(n\).
D’abord, cette fonction convient d’après 4.3, et elle vaut \(X_0\) en \(t_0\). Ensuite, soit \(X\) une solution quelconque. Posons \(Y(t)=\exp\bigl(-(t-t_0)A\bigr)X(t)\). La dérivée d’un produit donne \(Y^{\prime}(t)=\exp\bigl(-(t-t_0)A\bigr)\bigl(-AX(t)+X^{\prime}(t)\bigr)=0\). Donc \(Y\) est constante, égale à \(X_0\), et \(X(t)=\exp\bigl((t-t_0)A\bigr)X_0\).
Piège à éviter :
Le facteur \(\exp((t-t_0)A)\) se place à gauche de \(X_0\), qui est une colonne : l’écriture \(X_0\exp(tA)\) n’a pas de sens. De plus, avec une condition donnée en \(t_0\neq 0\), on n’écrit pas \(\exp(tA)X_0\) : cette fonction vaut \(\exp(t_0A)X_0\) en \(t_0\), et non \(X_0\).
- Écrire la matrice \(A\) du système, en vérifiant l’ordre des inconnues.
- Choisir la stratégie : calcul de \(\exp(tA)\) si la matrice est simple, changement de base \(X=PY\) sinon.
- Résoudre le système en \(Y\), diagonal ou triangulaire, puis revenir à \(X=PY\).
- Ajuster les constantes avec la condition initiale, puis vérifier \(X^{\prime}=AX\) en \(t_0\).
5.1 Résolution par diagonalisation
Si \(A=PDP^{-1}\), on pose \(X=PY\). Le système devient \(Y^{\prime}=DY\), dont les équations sont découplées : \(y_i(t)=c_i\mathrm{e}^{\lambda_it}\). Ainsi, en notant \(V_1,\ldots,V_n\) les colonnes de \(P\) :
\[X(t)=c_1\mathrm{e}^{\lambda_1t}V_1+\cdots+c_n\mathrm{e}^{\lambda_nt}V_n.\]
Pour la matrice \(\begin{pmatrix}1&2\\3&2\end{pmatrix}\) de la partie 3, les solutions s’écrivent \(c_1\mathrm{e}^{4t}(2,3)+c_2\mathrm{e}^{-t}(1,-1)\). La figure montre les trajectoires correspondantes : elles longent la droite propre \((1,-1)\) puis s’enfuient le long de la droite \((2,3)\).
5.2 Matrices réelles à valeurs propres complexes
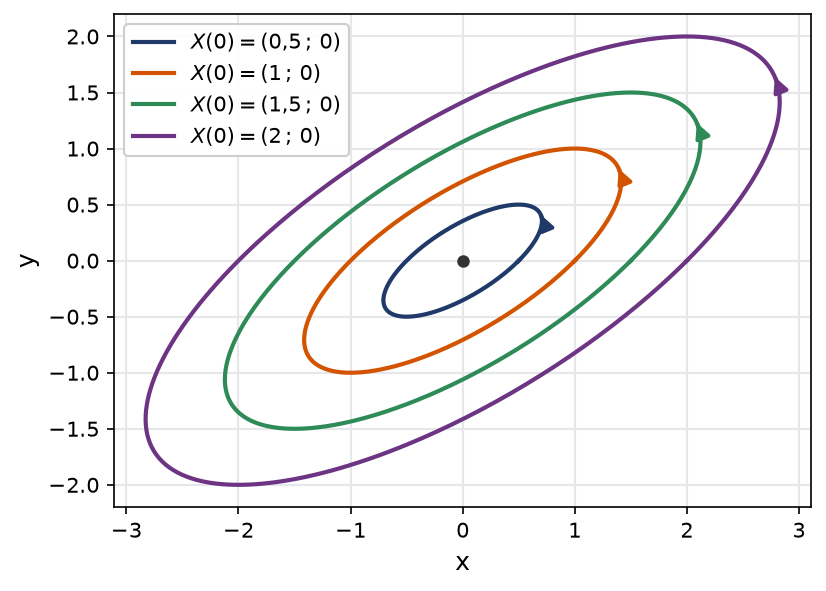
Pour une matrice réelle, on veut des solutions réelles. Lorsque les valeurs propres sont complexes conjuguées, il vaut mieux calculer \(\exp(tA)\) par une relation polynomiale. Par exemple, avec \(A=\begin{pmatrix}1&-2\\1&-1\end{pmatrix}\) de la partie 3.2, chaque solution est \(2\pi\)-périodique. En effet, \(X(t)=\bigl(\cos(t)I_2+\sin(t)A\bigr)X_0\). Les trajectoires sont des ellipses centrées en l’origine.
Une seconde méthode passe par les nombres complexes. Si \(V\) est un vecteur propre complexe associé à \(\lambda=\alpha+\mathrm{i}\beta\), alors \(t\mapsto\mathrm{e}^{\lambda t}V\) est une solution complexe. Comme \(A\) est réelle, sa partie réelle et sa partie imaginaire sont encore des solutions. Ces deux fonctions réelles s’écrivent avec \(\mathrm{e}^{\alpha t}\cos(\beta t)\) et \(\mathrm{e}^{\alpha t}\sin(\beta t)\), et elles engendrent les solutions réelles du plan correspondant.
5.3 Comportement des solutions
Si toutes les valeurs propres complexes de \(A\) ont une partie réelle strictement négative, alors toute solution de \(X^{\prime}=AX\) tend vers \(0\) en \(+\infty\). Si au moins une valeur propre a une partie réelle strictement positive, certaines solutions ne sont pas bornées.
Traitons le cas diagonalisable sur \(\mathbb{C}\). Chaque solution est une combinaison des \(\mathrm{e}^{\lambda_it}V_i\), et \(|\mathrm{e}^{\lambda_it}|=\mathrm{e}^{\mathrm{Re}(\lambda_i)t}\). Si toutes les parties réelles sont négatives, chaque terme tend vers \(0\). Si \(\mathrm{Re}(\lambda_1)>0\), la solution \(\mathrm{e}^{\lambda_1t}V_1\) a une norme qui tend vers \(+\infty\). Dans le cas général, la trigonalisation fait apparaître des facteurs polynomiaux \(t^k\mathrm{e}^{\lambda t}\), qui ne changent pas la conclusion.
Soit \(A=\begin{pmatrix}-1&-4\\1&-1\end{pmatrix}\), de trace \(-2\) et de déterminant \(5\). Ses valeurs propres sont \(-1\pm 2\mathrm{i}\). Posons \(K=A+I_2=\begin{pmatrix}0&-4\\1&0\end{pmatrix}\) : on vérifie que \(K^2=-4I_2\). Comme \(-I_2\) commute avec \(K\), on obtient :
\[\exp(tA)=\mathrm{e}^{-t}\left(\cos(2t)I_2+\frac{\sin(2t)}{2}K\right)=\mathrm{e}^{-t}\begin{pmatrix}\cos 2t&-2\sin 2t\\\frac12\sin 2t&\cos 2t\end{pmatrix}.\]
Les coefficients entre parenthèses restent bornés, tandis que \(\mathrm{e}^{-t}\to 0\). Ainsi, toute solution tend vers \(0\) en tournant autour de l’origine, conformément à la proposition : la partie réelle commune des valeurs propres vaut \(-1\).
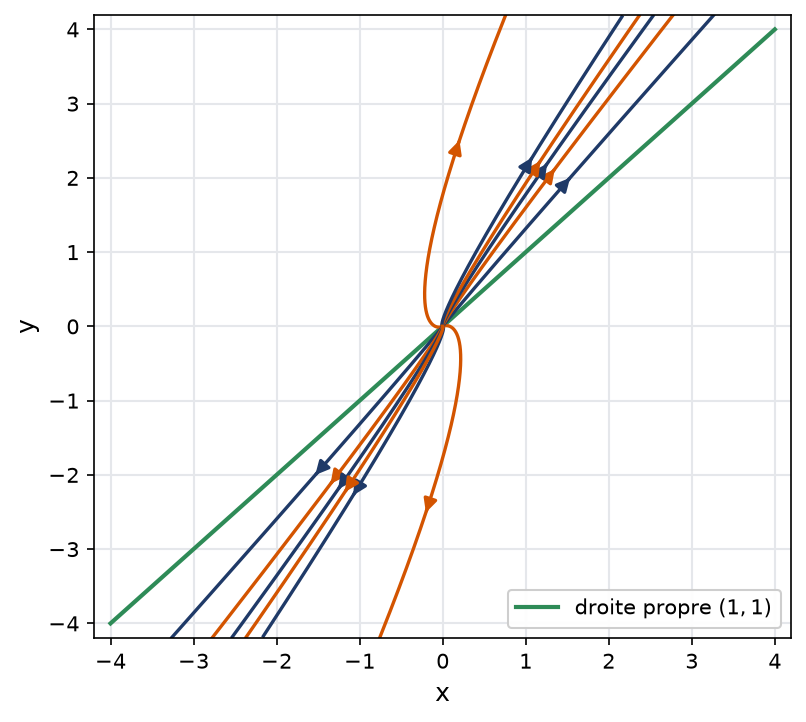
Soit \(A=\begin{pmatrix}2&1\\-1&4\end{pmatrix}\). Son polynôme caractéristique est \((X-3)^2\), et \(N=A-3I_2=\begin{pmatrix}-1&1\\-1&1\end{pmatrix}\) vérifie \(N^2=0\) sans être nulle. Donc \(A\) n’est pas diagonalisable, et :
\[\exp(tA)=\mathrm{e}^{3t}(I_2+tN)=\mathrm{e}^{3t}\begin{pmatrix}1-t&t\\-t&1+t\end{pmatrix}.\]
La seule valeur propre est \(3>0\). Ainsi, toute solution non nulle a une norme qui tend vers \(+\infty\), avec une direction limite donnée par le noyau de \(N\), la droite engendrée par \((1,1)\).
5.4 Équations scalaires d’ordre supérieur
Une équation \(y^{(n)}=a_{n-1}y^{(n-1)}+\cdots+a_1y^{\prime}+a_0y\) à coefficients constants se ramène à un système. On pose \(X=(y,y^{\prime},\ldots,y^{(n-1)})\). Alors \(X^{\prime}=CX\), où \(C\) est la matrice compagnon : des \(1\) juste au-dessus de la diagonale, puis la dernière ligne \((a_0,a_1,\ldots,a_{n-1})\).
Ainsi, tout ce qui précède s’applique. L’espace des solutions est de dimension \(n\), et une solution est déterminée par \(y(t_0),\ldots,y^{(n-1)}(t_0)\). De plus, les valeurs propres de \(C\) sont les racines de l’équation caractéristique \(r^n=a_{n-1}r^{n-1}+\cdots+a_0\). Par conséquent, on retrouve les solutions en \(\mathrm{e}^{rt}\), et les facteurs \(t^k\mathrm{e}^{rt}\) en cas de racine multiple.
Les erreurs fréquentes
- Écrire \(\exp(A+B)=\exp(A)\exp(B)\) sans vérifier que \(AB=BA\).
- Calculer l’exponentielle coefficient par coefficient pour une matrice non diagonale.
- Oublier \(P^{-1}\) dans \(\exp(tA)=P\exp(tD)P^{-1}\), ou inverser l’ordre des facteurs.
- Décomposer \(A=D+N\) avec \(D\) et \(N\) qui ne commutent pas.
- Croire qu’une valeur propre de partie réelle nulle donne des solutions bornées : avec un bloc nilpotent, un facteur \(t\) apparaît.
Fiche mémo
- \(\exp(A)=\sum A^k/k!\) converge absolument, et \(\|\exp(A)\|\leqslant\mathrm{e}^{\|A\|}\).
- Matrice nilpotente : somme finie ; matrice diagonale : exponentielle des coefficients diagonaux.
- \(\exp(PAP^{-1})=P\exp(A)P^{-1}\).
- Si \(AB=BA\) : \(\exp(A+B)=\exp(A)\exp(B)\) ; donc \(\exp(A)^{-1}=\exp(-A)\).
- Une seule valeur propre : \(\exp(tA)=\mathrm{e}^{\lambda t}\sum_k t^kN^k/k!\) avec \(N=A-\lambda I_n\).
- \(A^2=-\omega^2I\) : \(\exp(tA)=\cos(\omega t)I+\frac{\sin(\omega t)}{\omega}A\).
- Spectre de \(\exp(A)\) : les \(\mathrm{e}^{\lambda}\) ; \(\det\exp(A)=\mathrm{e}^{\mathrm{tr}A}\).
- \(\frac{\mathrm{d}}{\mathrm{d}t}\exp(tA)=A\exp(tA)\).
- \(X^{\prime}=AX\), \(X(t_0)=X_0\) : \(X(t)=\exp((t-t_0)A)X_0\).
- Parties réelles des valeurs propres toutes négatives : solutions qui tendent vers \(0\).
Questions fréquentes
A-t-on toujours exp(A + B) = exp(A) exp(B) ?
Non. L’égalité est garantie lorsque A et B commutent, et elle peut tomber en défaut sinon. Avec deux matrices nilpotentes 2×2 qui ne commutent pas, on obtient facilement deux résultats différents. Il faut donc vérifier la commutation avant d’écrire cette formule.
Faut-il diagonaliser pour calculer une exponentielle de matrice ?
Pas forcément. Si A s’écrit λI + N avec N nilpotente, la somme est finie et le calcul est immédiat. Si A vérifie une relation du type A² = -ω²I ou A² = A, on regroupe les termes de la série. La diagonalisation reste la méthode générale quand les valeurs propres sont simples.
Pourquoi exp(A) est-elle toujours inversible ?
Les matrices A et -A commutent, donc exp(A) exp(-A) = exp(0) = I. L’inverse de exp(A) est ainsi exp(-A). On retrouve aussi ce fait avec la formule det(exp A) = exp(tr A), qui ne s’annule jamais.
Comment savoir si toutes les solutions de X' = AX tendent vers 0 ?
Il suffit que toutes les valeurs propres complexes de A aient une partie réelle strictement négative. Dans le cas diagonalisable, chaque solution est une combinaison de termes en exp(λt), ce qui rend le résultat immédiat. Le cas général se traite par trigonalisation.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur exponentielle de matrice
- Bases utiles : Théorème de Cauchy linéaire et wronskien, Polynôme minimal, lemme des noyaux et Cayley-Hamilton, Compacité, connexité et applications linéaires continues
- Chapitre d’avant : Théorème de Cauchy linéaire et wronskien
- Chapitre d’après : Différentielle, jacobienne et règle de la chaîne
- Vérifier ses acquis : QCM de maths spé (MP) sur exponentielle de matrice
- Contrôle corrigé en temps limité : Raccordements, wronskien et exp(tA) : contrôle de maths en MP
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «exponentielle de matrice en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir
Exercices corrigés
Tout voir

Contrôles
Tout voir
QCM
Tout voir