Corrigé des exercices : Applications linéaires et rang en L1 de maths
Ce corrigé rang L1 rédige chaque solution comme une copie de partiel. Chaque exercice s’ouvre sur une idée clé qui indique par où attaquer. Viennent ensuite les hypothèses vérifiées, les théorèmes cités par leur nom et les calculs intermédiaires.
Nous insistons sur trois points de vigilance. D’abord, on vérifie toujours la linéarité avant de parler de noyau. Ensuite, le théorème du rang ne s’applique qu’avec un espace de départ de dimension finie. Enfin, une égalité de sous-espaces se prouve par une inclusion et une égalité de dimensions. Les résultats finaux sont en gras, et plusieurs figures illustrent les solutions géométriques. Avant de lire une solution, comparez d’abord votre résultat final, puis reprenez seulement l’étape où vos calculs divergent.
Pour démarrer
Corrigé de l’exercice 1 – Quatre applications à tester
Idée clé : on teste d’abord l’image de zéro, puis on vérifie la définition ou on exhibe un contre-exemple numérique.
- Soient \(M, N \in \mathcal{M}_2(\mathbb{R})\) et \(\lambda \in \mathbb{R}\). Le produit matriciel est distributif, donc \(A(\lambda M + N) = \lambda AM + AN\). De plus, la trace est linéaire. Ainsi, \(a(\lambda M + N) = \lambda\, a(M) + a(N)\). L’application \(a\) est linéaire.
- On a \(b(1,1) = (0,1)\) et \(b(2,2) = (0,4)\). Or \(2\,b(1,1) = (0,2) \neq b(2,2)\). L’application \(b\) n’est pas linéaire.
- La dérivation est linéaire : \((\lambda P + Q)^{\prime} = \lambda P^{\prime} + Q^{\prime}\). Par conséquent, \(c(\lambda P + Q) = X(\lambda P^{\prime} + Q^{\prime}) – 3(\lambda P + Q) = \lambda\, c(P) + c(Q)\). L’application \(c\) est linéaire.
- La fonction nulle a pour image \(d(0) = 1 \neq 0\). L’application \(d\) n’est pas linéaire.
Corrigé de l’exercice 2 – Noyau et image d’une application de R3 dans R2
Idée clé : on résout le système qui définit le noyau, puis le théorème du rang donne l’image sans calcul supplémentaire.
- Chaque coordonnée de \(u(x,y,z)\) est une combinaison linéaire de \(x\), \(y\), \(z\). Pour deux vecteurs et un scalaire, les coordonnées de \(u(\lambda v + w)\) sont donc celles de \(\lambda u(v) + u(w)\). Ainsi, \(u\) est linéaire.
- On résout \(x – y + 2z = 0\) et \(2x + y + z = 0\). En additionnant, on obtient \(3x + 3z = 0\), soit \(x = -z\). Ensuite, la première équation donne \(y = x + 2z = z\). Les solutions sont donc les vecteurs \((-z, z, z)\). Une base de \(\mathrm{Ker}\, u\) est \(\big((-1,1,1)\big)\).
- Le théorème du rang donne \(\mathrm{rg}\, u = 3 – 1 = 2\). Or \(\mathrm{Im}\, u\) est un sous-espace de \(\mathbb{R}^2\) de dimension 2. Par conséquent, \(\mathrm{Im}\, u = \mathbb{R}^2\) : \(u\) est surjective mais pas injective.
Pour contrôler le noyau, on substitue : \(u(-1,1,1) = (-1 – 1 + 2, -2 + 1 + 1) = (0,0)\). Une telle vérification prend dix secondes et évite de perdre tous les points d’une question.
Corrigé de l’exercice 3 – Évaluation en trois points
Idée clé : un polynôme de degré au plus 2 qui a trois racines distinctes est nul ; l’égalité des dimensions fait le reste.
- L’évaluation en un point est linéaire : \((\lambda P + Q)(a) = \lambda P(a) + Q(a)\). Donc \(v\) est linéaire. Si \(v(P) = 0\), alors \(P\) admet les trois racines distinctes \(0\), \(1\) et \(3\). Or \(\deg P \leqslant 2\), donc \(P = 0\). Ainsi, \(\mathrm{Ker}\, v = \{0\}\).
- L’application \(v\) est injective, et \(\dim \mathbb{R}_2[X] = 3 = \dim \mathbb{R}^3\). D’après le corollaire du théorème du rang, \(v\) est un isomorphisme.
- On cherche \(P\) qui s’annule en \(1\) et en \(3\), donc \(P = c(X-1)(X-3)\). La condition \(P(0) = 1\) donne \(3c = 1\). Ainsi, \(P = \frac{1}{3}(X-1)(X-3) = \frac{1}{3}(X^2 – 4X + 3)\).
Corrigé de l’exercice 4 – Retrouver une application à partir de deux images
Idée clé : une application linéaire est fixée par l’image d’une base ; il suffit de décomposer \((x,y)\) dans la base donnée.
- Les vecteurs \((1,1)\) et \((1,-1)\) ne sont pas colinéaires, donc ils forment une base de \(\mathbb{R}^2\). Par le théorème sur l’image d’une base, \(f\) existe et elle est unique.
- On écrit \((x,y) = a(1,1) + b(1,-1)\), d’où \(a = \frac{x+y}{2}\) et \(b = \frac{x-y}{2}\). Ensuite :
\[f(x,y) = \frac{x+y}{2}(1,0,2) + \frac{x-y}{2}(3,2,0).\]
Après regroupement, \(f(x,y) = (2x – y,\ x – y,\ x + y)\). On vérifie : \(f(1,1) = (1,0,2)\) et \(f(1,-1) = (3,2,0)\). - L’image est engendrée par \((1,0,2)\) et \((3,2,0)\), qui ne sont pas colinéaires. Donc \(\mathrm{rg}\, f = 2\), puis \(\dim \mathrm{Ker}\, f = 2 – 2 = 0\). Le rang vaut 2 et \(f\) est injective.
Corrigé de l’exercice 5 – Projecteur ou symétrie du plan
Idée clé : on calcule le carré de chaque application et on le compare à l’application ou à l’identité.
- Posons \(w = -x + 2y\), de sorte que \(p(x,y) = (w, w)\). Alors \(p(w,w) = (-w + 2w, -w + 2w) = (w,w)\). Donc \(p \circ p = p\), et \(p\) est un projecteur. D’abord, les images sont de la forme \((w,w)\), et \(p(x,x) = (x,x)\) : l’image est \(\mathrm{Vect}\big((1,1)\big)\). Ensuite, \(p(x,y) = 0\) équivaut à \(x = 2y\). Ainsi, \(p\) est la projection sur \(\mathrm{Vect}\big((1,1)\big)\) parallèlement à \(\mathrm{Vect}\big((2,1)\big)\).
- On a \(q(1,0) = (0,1)\) et \(q\big(q(1,0)\big) = (1,0) \neq q(1,0)\), donc \(q\) n’est pas un projecteur. En revanche, \(q\big(q(x,y)\big) = q(y,x) = (x,y)\), donc \(q \circ q = \mathrm{id}\). De plus, \(q(x,y) = (x,y)\) équivaut à \(x = y\), et \(q(x,y) = -(x,y)\) équivaut à \(y = -x\). Ainsi, \(q\) est la symétrie par rapport à \(\mathrm{Vect}\big((1,1)\big)\) parallèlement à \(\mathrm{Vect}\big((1,-1)\big)\).
Corrigé de l’exercice 6 – Équation d’un hyperplan de R4
Idée clé : on écrit une équation inconnue et on impose qu’elle soit vérifiée par les trois vecteurs générateurs.
- Supposons \(a w_1 + b w_2 + c w_3 = 0\). Les coordonnées donnent \(a + 2c = 0\), \(2a + b = 0\), \(b + c = 0\) et \(-a + b = 0\). La dernière équation donne \(b = a\), puis la deuxième donne \(3a = 0\). Donc \(a = b = 0\), puis \(c = 0\). La famille est libre, et \(H\) est de dimension 3.
- On cherche \(\alpha x + \beta y + \gamma z + \delta t = 0\). Les conditions sont \(\alpha + 2\beta – \delta = 0\), \(\beta + \gamma + \delta = 0\) et \(2\alpha + \gamma = 0\). Ainsi, \(\gamma = -2\alpha\), puis \(\delta = -\beta + 2\alpha\). En reportant dans la première, on obtient \(-\alpha + 3\beta = 0\). Avec \(\beta = 1\), il vient \(\alpha = 3\), \(\gamma = -6\) et \(\delta = 5\). Une équation de \(H\) est \(3x + y – 6z + 5t = 0\). On vérifie : \(3 + 2 – 5 = 0\), puis \(1 – 6 + 5 = 0\), puis \(6 – 6 = 0\).
- La forme \(\varphi(x,y,z,t) = 3x + y – 6z + 5t\) est non nulle et \(H = \mathrm{Ker}\, \varphi\). Or \(\varphi(1,1,1,1) = 3 \neq 0\), donc \((1,1,1,1) \notin H\). D’après le cours sur les hyperplans, \(\mathbb{R}^4 = H \oplus \mathrm{Vect}\big((1,1,1,1)\big)\).
Pour s’entraîner
Corrigé de l’exercice 7 – Endomorphisme de polynômes et base adaptée
Idée clé : dans la base des puissances de \(X – 1\), l’endomorphisme multiplie chaque vecteur par un scalaire.
- La linéarité découle de celle de la dérivation. De plus, si \(\deg P \leqslant 3\), alors \(\deg P^{\prime} \leqslant 2\), donc \((X-1)P^{\prime}\) est de degré au plus 3. Ainsi, \(\varphi\) est un endomorphisme de \(\mathbb{R}_3[X]\).
- Pour \(k \geqslant 1\), la dérivée de \((X-1)^k\) vaut \(k(X-1)^{k-1}\). Donc \((X-1) \cdot k(X-1)^{k-1} = k(X-1)^k\). Ce calcul reste vrai pour \(k = 0\). Par conséquent, \(\varphi\big((X-1)^k\big) = (k – 2)(X-1)^k\) : on obtient \(-2\), \(-(X-1)\), \(0\) et \((X-1)^3\).
- La famille \(\big(1, X-1, (X-1)^2, (X-1)^3\big)\) est échelonnée en degré, donc c’est une base. Si \(P = \sum c_k (X-1)^k\), alors \(\varphi(P) = \sum (k-2) c_k (X-1)^k\). Ce polynôme est nul si et seulement si \(c_0 = c_1 = c_3 = 0\). Ensuite, l’image est engendrée par les images des vecteurs de base. Ainsi, \(\mathrm{Ker}\, \varphi = \mathrm{Vect}\big((X-1)^2\big)\), \(\mathrm{Im}\, \varphi = \mathrm{Vect}\big(1, X-1, (X-1)^3\big)\) et \(\mathrm{rg}\, \varphi = 3\). On retrouve bien \(1 + 3 = 4 = \dim \mathbb{R}_3[X]\).
Dans cet exemple, noyau et image sont supplémentaires, car la base adaptée se partage entre eux. Cependant, ce n’est pas une conséquence du théorème du rang : c’est la forme particulière de \(\varphi\) qui le permet. Le choix de la base des puissances de \(X – 1\) est la vraie clé de l’exercice, car il évite tout système linéaire.
Corrigé de l’exercice 8 – Multiplication à gauche dans les matrices carrées d’ordre 2
Idée clé : chaque colonne de \(AM\) est le produit de \(A\) par la colonne correspondante de \(M\).
- Par distributivité, \(A(\lambda M + N) = \lambda AM + AN\). Donc \(g\) est un endomorphisme de \(\mathcal{M}_2(\mathbb{R})\).
- Pour \(M = \begin{pmatrix} a & b \\ c & d \end{pmatrix}\), on obtient \(AM = \begin{pmatrix} a + 2c & b + 2d \\ 2a + 4c & 2b + 4d \end{pmatrix}\). La seconde ligne vaut deux fois la première. Ainsi, \(AM = 0\) équivaut à \(a = -2c\) et \(b = -2d\). Une base du noyau est formée de \(\begin{pmatrix} -2 & 0 \\ 1 & 0 \end{pmatrix}\) et \(\begin{pmatrix} 0 & -2 \\ 0 & 1 \end{pmatrix}\).
- D’après le calcul précédent, chaque colonne de \(AM\) est un multiple de \(\begin{pmatrix} 1 \\ 2 \end{pmatrix}\). De plus, les images des matrices élémentaires \(E_{11}\) et \(E_{12}\) sont \(\begin{pmatrix} 1 & 0 \\ 2 & 0 \end{pmatrix}\) et \(\begin{pmatrix} 0 & 1 \\ 0 & 2 \end{pmatrix}\), qui sont libres. Ensuite, l’ensemble des matrices dont les deux colonnes sont multiples de \(\begin{pmatrix} 1 \\ 2 \end{pmatrix}\) est de dimension 2. Ces deux matrices forment donc une base de \(\mathrm{Im}\, g\), et \(\mathrm{rg}\, g = 2\). On vérifie : \(2 + 2 = 4 = \dim \mathcal{M}_2(\mathbb{R})\).
Corrigé de l’exercice 9 – Dérivation et primitive sur les polynômes
Idée clé : la relation \(D \circ I = \mathrm{id}\) donne d’un coup la surjectivité de \(D\) et l’injectivité de \(I\).
- La dérivation est linéaire. De même, \(I(P)(x) = \int_0^x P(t)\,\mathrm{d}t\), et l’intégrale est linéaire. Enfin, \(I(X^k) = \frac{X^{k+1}}{k+1}\), donc \(I(P)\) est bien un polynôme. Ainsi, \(D\) et \(I\) sont des endomorphismes de \(\mathbb{R}[X]\).
- Par construction, \(D\big(I(Q)\big) = Q\) pour tout \(Q\). Donc \(D\) est surjective, et \(I\) est injective : si \(I(P) = 0\), alors \(P = D\big(I(P)\big) = 0\). Ensuite, \(D(1) = 0\), donc \(D\) n’est pas injective. Enfin, tout polynôme \(I(P)\) s’annule en \(0\), donc \(1 \notin \mathrm{Im}\, I\). Ainsi, \(D\) est surjective non injective et \(I\) est injective non surjective.
- On a \(D \circ I = \mathrm{id}\) et \(I \circ D(P) = P – P(0)\), qui diffère de l’identité puisque \(I \circ D(1) = 0\). En dimension finie, \(D \circ I = \mathrm{id}\) rendrait \(I\) injective, donc bijective par le théorème du rang. On aurait alors \(D = I^{-1}\), puis \(I \circ D = \mathrm{id}\). Cette situation est donc propre à la dimension infinie.
Corrigé de l’exercice 10 – Projecteur de R3 donné par ses formules
Idée clé : on réécrit \(p(v) = v – \frac{\ell(v)}{2}(1,1,1)\) avec la forme linéaire \(\ell(x,y,z) = 2x + y – z\).
- Par exemple, la première coordonnée vaut \(x – \frac{2x + y – z}{2} = \frac{-y + z}{2}\). Les deux autres se vérifient de la même façon. Or \(\ell(1,1,1) = 2\), donc \(\ell\big(p(v)\big) = \ell(v) – \ell(v) = 0\). Par conséquent, \(p\big(p(v)\big) = p(v) – 0 = p(v)\). Ainsi, \(p \circ p = p\).
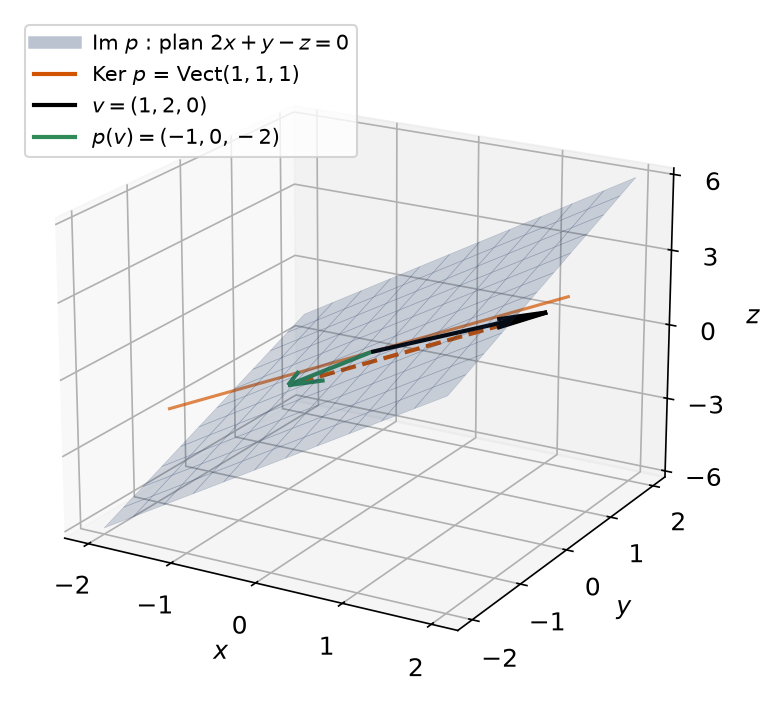
- Si \(p(v) = 0\), alors \(v\) est colinéaire à \((1,1,1)\). Réciproquement, \(p(1,1,1) = (1,1,1) – (1,1,1) = 0\). Ensuite, toute image vérifie \(\ell\big(p(v)\big) = 0\). De plus, si \(\ell(v) = 0\), alors \(p(v) = v\). Donc \(\mathrm{Ker}\, p = \mathrm{Vect}\big((1,1,1)\big)\) et \(\mathrm{Im}\, p\) est le plan d’équation \(2x + y – z = 0\).
- On a \(\ell(1,2,0) = 4\), d’où \(p(1,2,0) = (1,2,0) – 2(1,1,1) = (-1,0,-2)\). Ce vecteur est dans le plan, car \(-2 + 0 + 2 = 0\). De plus, la différence \((2,2,2)\) est dans le noyau : on projette bien parallèlement à \((1,1,1)\).
- Le calcul donne \(s(x,y,z) = (-x – y + z,\ -2x + z,\ -2x – y + 2z)\). C’est la symétrie par rapport au plan \(2x + y – z = 0\), parallèlement à \(\mathrm{Vect}\big((1,1,1)\big)\). Par exemple, \(s(1,1,1) = (-1,-1,-1)\).
La figure montre le vecteur \(v\), son projeté dans le plan et la direction de projection.
Corrigé de l’exercice 11 – Rang d’une application de R4 dans R3
Idée clé : la troisième coordonnée est la somme des deux premières, ce qui rend une équation superflue.
- On remarque que \((x + y + z + t) + (x – y + 2z) = 2x + 3z + t\). Le noyau est donc défini par les deux premières équations. La seconde donne \(x = y – 2z\), puis la première donne \(t = -x – y – z = -2y + z\). Les paramètres libres sont \(y\) et \(z\). Une base de \(\mathrm{Ker}\, f\) est \(\big((1,1,0,-2), (-2,0,1,1)\big)\).
- Par le théorème du rang, \(\mathrm{rg}\, f = 4 – 2 = 2\).
- On a \(f(1,0,0,0) = (1,1,2)\) et \(f(0,1,0,0) = (1,-1,0)\), qui ne sont pas colinéaires. Comme le rang vaut 2, ces deux vecteurs forment une base de \(\mathrm{Im}\, f\). De plus, toute image \((u,v,w)\) vérifie \(w = u + v\). Ce plan contient l’image et il est de dimension 2. Une équation de \(\mathrm{Im}\, f\) est donc \(u + v – w = 0\).
Corrigé de l’exercice 12 – Deux formes linéaires sur les polynômes
Idée clé : on écrit \(P\) dans la base canonique pour lire chaque forme sur les coefficients.
- Écrivons \(P = a + bX + cX^2\). Alors \(\alpha(P) = b\) et \(\beta(P) = (a + b + c) – (a – b + c) = 2b\). Ces expressions sont linéaires en \((a,b,c)\). De plus, \(\alpha(X) = 1\). Ce sont donc deux formes linéaires non nulles.
- Le noyau d’une forme linéaire non nulle est un hyperplan. Ici, \(\alpha(P) = 0\) équivaut à \(b = 0\). Une base de \(\mathrm{Ker}\, \alpha\) est \((1, X^2)\), de dimension \(3 – 1 = 2\).
- On a \(\beta = 2\alpha\). Deux formes proportionnelles avec un facteur non nul ont le même noyau. Donc \(\mathrm{Ker}\, \beta = \mathrm{Vect}(1, X^2)\).
- Sur \(\mathbb{R}_3[X]\), avec \(P = a + bX + cX^2 + dX^3\), on obtient \(\alpha(P) = b\) et \(\beta(P) = 2b + 2d\). Ainsi, \(\alpha(X^3) = 0\) mais \(\beta(X^3) = 2\). Le polynôme \(X^3\) est dans \(\mathrm{Ker}\, \alpha\) sans être dans \(\mathrm{Ker}\, \beta\) : les noyaux diffèrent.
Corrigé de l’exercice 13 – Endomorphismes de carré nul
Idée clé : l’inclusion de l’image dans le noyau, combinée au théorème du rang, borne le rang.
- La condition \(u \circ u = 0\) signifie que \(u\big(u(x)\big) = 0\) pour tout \(x\). Autrement dit, tout vecteur \(u(x)\) de l’image appartient au noyau. Ainsi, \(u \circ u = 0\) équivaut à \(\mathrm{Im}\, u \subset \mathrm{Ker}\, u\).
- L’inclusion donne \(\mathrm{rg}\, u \leqslant \dim \mathrm{Ker}\, u\). Or le théorème du rang donne \(\dim \mathrm{Ker}\, u = n – \mathrm{rg}\, u\). Par conséquent, \(2\, \mathrm{rg}\, u \leqslant n\), soit \(\mathrm{rg}\, u \leqslant \frac{n}{2}\).
- On calcule \(u\big(u(x,y,z,t)\big) = u(z,t,0,0) = (0,0,0,0)\). Ensuite, \(u(x,y,z,t) = 0\) équivaut à \(z = t = 0\). Enfin, les images sont les vecteurs \((z,t,0,0)\). Donc \(\mathrm{Ker}\, u = \mathrm{Im}\, u = \mathrm{Vect}(e_1, e_2)\), et le rang vaut \(2 = \frac{4}{2}\) : la borne est atteinte.
Corrigé de l’exercice 14 – Interpolation de Hermite en deux points
Idée clé : un polynôme du noyau admet deux racines doubles, ce qui est trop pour un degré au plus 3.
- L’évaluation et la dérivation sont linéaires, donc chaque coordonnée de \(\Phi\) l’est. Ainsi, \(\Phi\) est linéaire.
- Si \(\Phi(P) = 0\), alors \(0\) est racine au moins double de \(P\), donc \(X^2\) divise \(P\). De même, \((X-2)^2\) divise \(P\). Ces deux polynômes sont premiers entre eux, donc \(X^2(X-2)^2\) divise \(P\). Or ce produit est de degré 4 et \(\deg P \leqslant 3\), d’où \(P = 0\). Le noyau est nul, et comme \(\dim \mathbb{R}_3[X] = 4 = \dim \mathbb{R}^4\), \(\Phi\) est un isomorphisme.
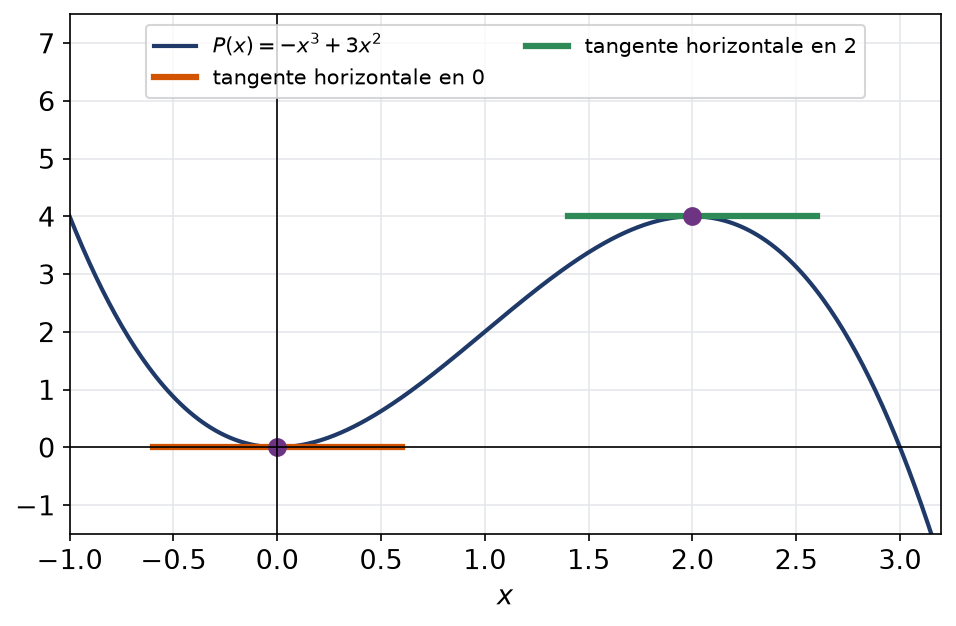
- Les conditions \(P(0) = P^{\prime}(0) = 0\) imposent \(P = X^2(aX + b)\). Alors \(P^{\prime} = 3aX^2 + 2bX\). Les conditions en \(2\) donnent \(4(2a + b) = 4\) et \(12a + 4b = 0\). Ainsi, \(b = -3a\), puis \(2a – 3a = 1\), soit \(a = -1\) et \(b = 3\). Le polynôme cherché est \(P = -X^3 + 3X^2\). On vérifie : \(P(2) = -8 + 12 = 4\) et \(P^{\prime}(2) = -12 + 12 = 0\).
La courbe obtenue passe par les deux points imposés avec des tangentes horizontales.
Corrigé de l’exercice 15 – Matrices de trace nulle et projection
Idée clé : \(H\) est le noyau de la trace, et la matrice identité n’en fait pas partie.
- La trace est une forme linéaire non nulle, car \(\mathrm{tr}\, E_{11} = 1\). Son noyau \(H\) est donc un hyperplan. Ainsi, \(\dim H = n^2 – 1\).
- On a \(\mathrm{tr}\, I_n = n \neq 0\), donc \(I_n \notin H\). D’après le théorème sur les hyperplans, \(\mathcal{M}_n(\mathbb{R}) = H \oplus \mathrm{Vect}(I_n)\).
- On écrit \(M = \left(M – \frac{\mathrm{tr}\, M}{n} I_n\right) + \frac{\mathrm{tr}\, M}{n} I_n\). Le premier terme a une trace nulle, et le second est dans \(\mathrm{Vect}(I_n)\). Par unicité de la décomposition, \(\pi(M) = M – \frac{\mathrm{tr}\, M}{n} I_n\).
- Ici, \(\mathrm{tr}\, M = 3 – 1 = 2\) et \(n = 2\). Donc \(\pi(M) = M – I_2 = \begin{pmatrix} 2 & 1 \\ 4 & -2 \end{pmatrix}\), dont la trace est bien nulle.
Pour approfondir
Corrigé de l’exercice 16 – Noyaux itérés d’un endomorphisme
Idée clé : une suite croissante de sous-espaces d’un espace de dimension \(n\) ne peut pas croître strictement plus de \(n\) fois.
- Si \(u^k(x) = 0\), alors \(u^{k+1}(x) = u(0) = 0\). Donc \(N_k \subset N_{k+1}\).
- Raisonnons par récurrence sur \(j\), le cas \(j = 0\) étant clair. Supposons \(N_{m+j} = N_m\) et prenons \(x \in N_{m+j+1}\). Alors \(u^{m+1}\big(u^j(x)\big) = 0\), donc \(u^j(x) \in N_{m+1} = N_m\). Ainsi, \(u^{m+j}(x) = 0\), c’est-à-dire \(x \in N_{m+j} = N_m\). Avec la question 1, on obtient \(N_{m+j+1} = N_m\).
- Supposons que \(N_0 \subsetneq N_1 \subsetneq \dots \subsetneq N_{n+1}\). Les dimensions augmenteraient d’au moins 1 à chaque étape, donc \(\dim N_{n+1} \geqslant n + 1\). C’est impossible dans \(E\). Il existe donc \(m \leqslant n\) tel que \(N_m = N_{m+1}\), et la question 2 montre que la suite est constante à partir de \(m\).
- Pour la dérivation, \(D^k(P) = 0\) équivaut à \(\deg P \leqslant k – 1\). Ainsi, \(N_0 = \{0\}\), \(N_1 = \mathbb{R}_0[X]\), \(N_2 = \mathbb{R}_1[X]\), \(N_3 = \mathbb{R}_2[X]\) et \(N_k = \mathbb{R}_3[X]\) pour \(k \geqslant 4\). Ici \(m = 4 = n\) : la borne est atteinte.
De la même manière, les images \(\mathrm{Im}\, u^k\) forment une suite décroissante. Par le théorème du rang, leurs dimensions valent \(n – \dim N_k\). Elles se stabilisent donc exactement au même rang \(m\) que les noyaux. Pour la dérivation de \(\mathbb{R}_3[X]\), on obtient successivement des images de dimensions 4, 3, 2, 1 puis 0.
Corrigé de l’exercice 17 – Inégalités sur le rang
Idée clé : on compare des images par inclusion, puis on applique le théorème du rang à une restriction bien choisie.
- Pour tout \(x\), on a \((u + v)(x) = u(x) + v(x)\), donc \(\mathrm{Im}(u+v) \subset \mathrm{Im}\, u + \mathrm{Im}\, v\). Or la dimension d’une somme est au plus la somme des dimensions. Ainsi, \(\mathrm{rg}(u + v) \leqslant \mathrm{rg}\, u + \mathrm{rg}\, v\).
- On écrit \(u = (u – v) + v\), d’où \(\mathrm{rg}\, u \leqslant \mathrm{rg}(u – v) + \mathrm{rg}\, v\). De même, \(v = (v – u) + u\) et \(\mathrm{rg}(v – u) = \mathrm{rg}(u – v)\). En combinant les deux, \(|\mathrm{rg}\, u – \mathrm{rg}\, v| \leqslant \mathrm{rg}(u – v)\).
- D’abord, \(\mathrm{Im}(v \circ u) \subset \mathrm{Im}\, v\). Ensuite, \(\mathrm{Im}(v \circ u) = v(\mathrm{Im}\, u)\) est l’image d’un espace de dimension \(\mathrm{rg}\, u\) par une application linéaire. Sa dimension est donc au plus \(\mathrm{rg}\, u\). Ainsi, \(\mathrm{rg}(v \circ u) \leqslant \min(\mathrm{rg}\, u, \mathrm{rg}\, v)\).
- L’application \(w : \mathrm{Im}\, u \to G\), \(y \mapsto v(y)\), est linéaire. D’une part, \(w\) atteint exactement les vecteurs \(v\big(u(x)\big)\), donc \(\mathrm{Im}\, w = \mathrm{Im}(v \circ u)\). D’autre part, un vecteur \(y\) annule \(w\) lorsqu’il est à la fois dans \(\mathrm{Im}\, u\) et dans \(\mathrm{Ker}\, v\). L’espace de départ de \(w\) étant de dimension \(\mathrm{rg}\, u\), le théorème du rang fournit \(\mathrm{rg}\, u = \dim(\mathrm{Ker}\, v \cap \mathrm{Im}\, u) + \mathrm{rg}(v \circ u)\). Or \(\dim(\mathrm{Ker}\, v \cap \mathrm{Im}\, u) \leqslant \dim \mathrm{Ker}\, v = \dim F – \mathrm{rg}\, v\). Par conséquent, \(\mathrm{rg}(v \circ u) \geqslant \mathrm{rg}\, u + \mathrm{rg}\, v – \dim F\).
Corrigé de l’exercice 18 – Somme de deux projecteurs
Idée clé : on développe \((p + q)^2\) en respectant l’ordre des compositions, qui ne commutent pas a priori.
- Par bilinéarité de la composition, \((p+q) \circ (p+q) = p^2 + p \circ q + q \circ p + q^2 = p + q + p \circ q + q \circ p\). Donc \(p + q\) est un projecteur si et seulement si \(p \circ q + q \circ p = 0\).
- Supposons \(p \circ q + q \circ p = 0\). En composant par \(p\) à gauche, on obtient \(p \circ q + p \circ q \circ p = 0\), car \(p^2 = p\). En composant par \(p\) à droite, on obtient \(p \circ q \circ p + q \circ p = 0\). La différence donne \(p \circ q = q \circ p\). Ensuite, l’hypothèse devient \(2\, p \circ q = 0\). La réciproque est immédiate. Ainsi, la condition équivaut à \(p \circ q = q \circ p = 0\).
- D’abord, \(\mathrm{Im}(p+q) \subset \mathrm{Im}\, p + \mathrm{Im}\, q\). Réciproquement, si \(y = p(a)\), alors \((p+q)(y) = p(a) + q\big(p(a)\big) = y\). Le même calcul vaut pour \(\mathrm{Im}\, q\), donc l’inclusion inverse est vraie. De plus, si \(y \in \mathrm{Im}\, p \cap \mathrm{Im}\, q\), alors \(y = q(y)\) et \(y = p(y) = p\big(q(y)\big) = 0\). Donc \(\mathrm{Im}(p+q) = \mathrm{Im}\, p \oplus \mathrm{Im}\, q\). Enfin, si \(p(x) + q(x) = 0\), on applique \(p\) : \(p(x) + p\big(q(x)\big) = p(x) = 0\), puis \(q(x) = 0\). L’autre inclusion est évidente. Ainsi, \(\mathrm{Ker}(p+q) = \mathrm{Ker}\, p \cap \mathrm{Ker}\, q\).
Un exemple concret aide à fixer les idées. Dans \(\mathbb{R}^3\), les projections sur l’axe des abscisses et sur l’axe des ordonnées, prises parallèlement aux deux autres axes, vérifient la condition. Leur somme est alors la projection sur le plan \(z = 0\) parallèlement à l’axe des cotes. En revanche, deux projections sur des droites non perpendiculaires du plan donnent en général une somme qui n’est pas un projecteur.
Corrigé de l’exercice 19 – Problème : opérateur de différence et sommes de cubes
Idée clé : \(\Delta\) fait baisser le degré d’exactement une unité ; le théorème du rang décrit alors son image, et un télescopage donne la somme.
- Pour \(P, Q\) et \(\lambda\), on a \((\lambda P + Q)(X+1) = \lambda P(X+1) + Q(X+1)\), donc \(\Delta\) est linéaire. Écrivons \(P = aX^d + R\) avec \(a \neq 0\) et \(\deg R \leqslant d – 1\). La formule du binôme donne \((X+1)^d – X^d = dX^{d-1} + \dots\), de degré \(d – 1\). Ensuite, \(\Delta(R)\) est de degré au plus \(d – 2\) par le même calcul. Ainsi, \(\Delta(P)\) a pour terme dominant \(ad\,X^{d-1}\) et \(\deg \Delta(P) = d – 1\). En particulier, \(\Delta(P) \in \mathbb{R}_n[X]\).
- Les constantes vérifient \(\Delta(c) = c – c = 0\). Réciproquement, si \(P\) n’est pas constant, la question 1 donne \(\deg \Delta(P) \geqslant 0\), donc \(\Delta(P) \neq 0\). Ainsi, \(\mathrm{Ker}\, \Delta = \mathbb{R}_0[X]\).
- Par le théorème du rang, \(\mathrm{rg}\, \Delta = (n + 1) – 1 = n\). De plus, la question 1 montre que \(\mathrm{Im}\, \Delta \subset \mathbb{R}_{n-1}[X]\), espace de dimension \(n\). Par égalité des dimensions, \(\mathrm{Im}\, \Delta = \mathbb{R}_{n-1}[X]\).
- Soit \(Q \in \mathbb{R}_{n-1}[X]\). Il existe \(P_1\) tel que \(\Delta(P_1) = Q\). Posons \(P = P_1 – P_1(0)\) : les constantes étant dans le noyau, \(\Delta(P) = Q\), et \(P(0) = 0\). Ensuite, si \(P\) et \(\tilde{P}\) conviennent, alors \(P – \tilde{P}\) est dans le noyau, donc constant. Sa valeur en \(0\) est nulle. Il existe donc un unique \(P\) convenable.
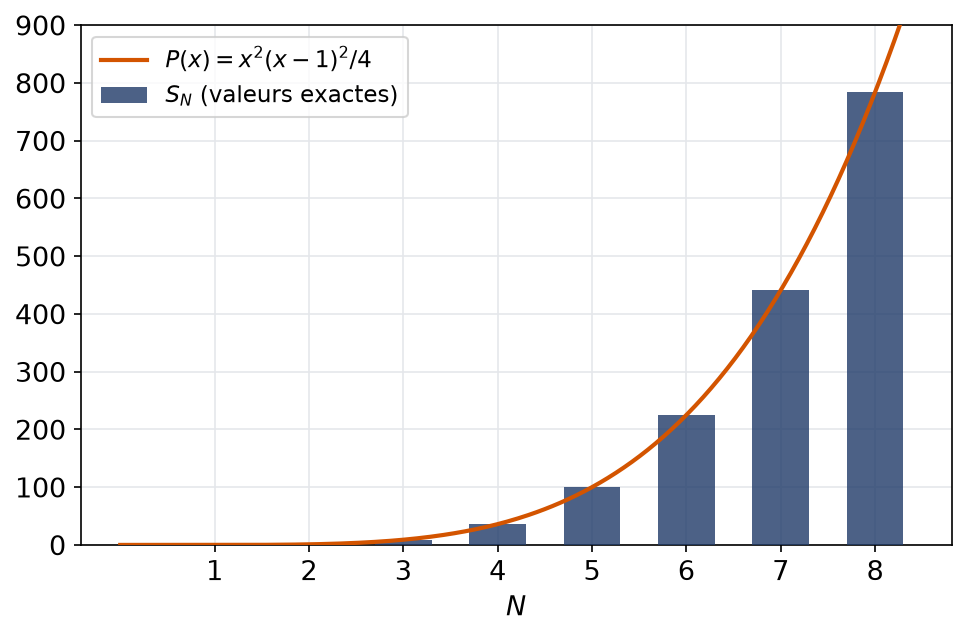
- On a \(P(X+1) = \frac{1}{4}(X+1)^2X^2\). Donc \(\Delta(P) = \frac{1}{4}X^2\big((X+1)^2 – (X-1)^2\big) = \frac{1}{4}X^2 \cdot 4X\). Ainsi, \(\Delta(P) = X^3\), et \(P(0) = 0\) : c’est l’unique solution de la question 4.
- On somme les égalités \(P(k+1) – P(k) = k^3\) pour \(k\) de \(0\) à \(N – 1\). Les termes se télescopent, d’où \(S_N = P(N) – P(0)\). Ainsi, \(S_N = \frac{N^2(N-1)^2}{4}\), puis \(\sum_{k=1}^{N} k^3 = S_{N+1} = \frac{N^2(N+1)^2}{4}\). Par exemple, \(S_8 = \frac{64 \times 49}{4} = 784\).
- Par la question 1, chaque application de \(\Delta\) fait baisser le degré d’une unité et annule les constantes. Ainsi, \(\Delta^n(P)\) est constant pour tout \(P \in \mathbb{R}_n[X]\), puis \(\Delta^{n+1}(P) = 0\). Ensuite, le coefficient dominant de \(X^n\) est multiplié successivement par \(n\), \(n – 1\), …, \(1\). Donc \(\Delta^{n+1} = 0\) et \(\Delta^n(X^n) = n! \neq 0\).
La figure confirme que la courbe de \(P\) passe exactement par le sommet de chaque barre \(S_N\).
Pour aller plus loin
- Revoir la leçon : cours de L1 de maths sur applications linéaires et rang
- S’exercer : exercices corrigés de L1 de maths sur applications linéaires et rang
- Bases utiles : Espaces vectoriels : bases et dimension
- Chapitre d’avant : Espaces vectoriels : bases et dimension
- Chapitre d’après : Matrices de passage et matrices semblables
- Vérifier ses acquis : QCM de L1 de maths sur applications linéaires et rang
- Contrôle corrigé en temps limité : Noyau, image et projecteurs : contrôle de maths en L1
- Le même thème en maths sup (MPSI) : Noyau, image et théorème du rang
- Tous les chapitres : le sommaire de la L1 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «corrigé des exercices : Applications linéaires et rang en L1 de maths» au format PDF afin de pouvoir travailler en totale autonomie.