Variables aléatoires finies en maths sup (MPSI) : cours et méthodes
Ce chapitre fait passer des événements aux nombres. Une variable aléatoire retient d’une expérience une seule grandeur, et sa loi dit avec quelles probabilités elle prend chaque valeur. Ce cours sur les variables aléatoires MPSI arrive en fin d’année, juste après les probabilités sur un univers fini. Il prépare directement les variables discrètes et les séries génératrices de seconde année.
Vous apprendrez d’abord à reconnaître et à justifier une loi binomiale. Ensuite, nous étudions les couples, l’indépendance et le lemme des coalitions. Enfin, l’espérance, la variance et la covariance mènent aux inégalités de Markov et de Bienaymé-Tchebychev. La méthode des indicatrices, si utile en colle, y occupe une place centrale.
Ce que vous saurez faire
- Déterminer la loi d’une variable aléatoire et celle d’une variable \(f(X)\).
- Reconnaître une loi binomiale et rédiger proprement sa justification.
- Exploiter une loi conjointe : lois marginales, indépendance, lemme des coalitions.
- Calculer une espérance par linéarité, en décomposant une variable en somme d’indicatrices.
- Calculer une variance avec la formule de König-Huygens, puis la variance d’une somme grâce aux covariances.
- Majorer une probabilité d’écart avec les inégalités de Markov et de Bienaymé-Tchebychev.
1. Variables aléatoires sur un univers fini
Nous fixons un univers fini \(\Omega\), muni d’une probabilité \(P\). Une variable aléatoire sert à ne retenir d’une expérience qu’une seule grandeur : un gain, un nombre de succès, un rang. Ainsi, on passe d’événements parfois compliqués à des nombres que l’on peut additionner.
On appelle variable aléatoire toute application \(X\) de \(\Omega\) dans un ensemble \(E\). Si les valeurs sont des réels, la variable est dite réelle. Étant donné \(A\subset E\), on écrit \((X\in A)\) l’événement \(X^{-1}(A)\), et \((X=x)\) l’événement \(X^{-1}(\{x\})\).
Comme \(\Omega\) est fini, l’ensemble image \(X(\Omega)\) est fini lui aussi. Par conséquent, les événements \((X=x)\), pour \(x\in X(\Omega)\), forment un système complet d’événements. C’est ce système qui porte toute l’information utile sur \(X\).
La loi de \(X\) est l’application \(P_X:A\mapsto P(X\in A)\), définie sur les parties de \(X(\Omega)\). C’est une probabilité sur \(X(\Omega)\). Elle est entièrement déterminée par la donnée des nombres \(P(X=x)\), pour \(x\in X(\Omega)\), dont la somme vaut \(1\).
Remarque :
Deux variables peuvent avoir la même loi sans être égales. Par exemple, si l’on lance une pièce équilibrée, l’indicatrice de « pile » et celle de « face » suivent la même loi. Pourtant, elles ne prennent jamais la même valeur au même moment.
1.1 Loi d’une variable f(X)
Si \(f\) est une fonction définie sur \(X(\Omega)\), la composée \(f\circ X\) est encore une variable aléatoire, notée \(f(X)\). Sa loi se déduit de celle de \(X\) en regroupant les antécédents.
Pour tout \(y\in f(X(\Omega))\), on a \(P(f(X)=y)=\sum_{x\in X(\Omega),\ f(x)=y}P(X=x)\).
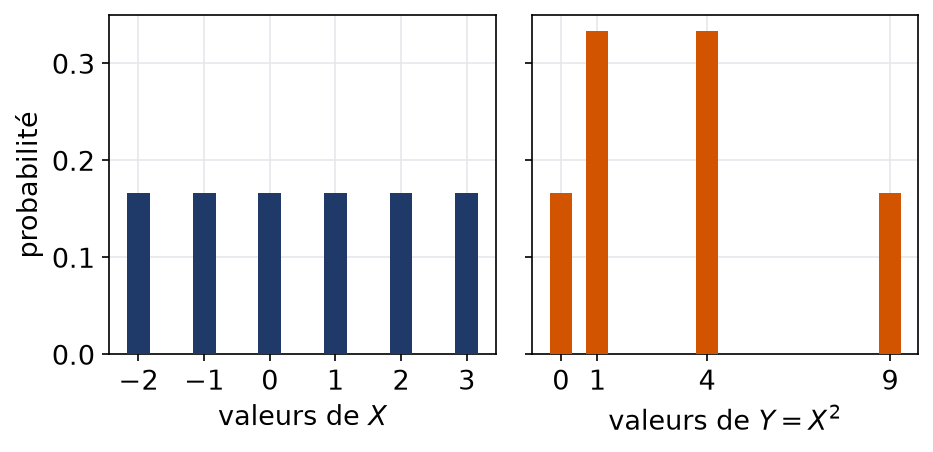
Soit \(X\) uniforme sur \(\{-2,-1,0,1,2,3\}\), et \(Y=X^2\). D’abord, \(Y\) prend les valeurs \(0\), \(1\), \(4\) et \(9\). Ensuite, on regroupe : \((Y=1)=(X=-1)\cup(X=1)\) et \((Y=4)=(X=-2)\cup(X=2)\). On obtient donc \(P(Y=0)=\frac{1}{6}\), \(P(Y=1)=\frac{2}{6}\), \(P(Y=4)=\frac{2}{6}\) et \(P(Y=9)=\frac{1}{6}\). Enfin, on contrôle que la somme vaut \(1\).
La figure compare les deux lois. Les barres de \(X\) sont toutes égales, alors que celles de \(Y\) réunissent les valeurs opposées.
2. Lois usuelles
Trois lois reviennent sans cesse sur un univers fini. Il faut savoir les reconnaître, mais surtout justifier qu’une variable les suit.
Soit \(n\in\mathbb{N}^*\) et \(p\in[0,1]\).
- \(X\) suit la loi uniforme sur un ensemble fini \(E\) de cardinal \(m\) si \(P(X=x)=\frac{1}{m}\) pour tout \(x\in E\).
- \(X\) suit la loi de Bernoulli \(\mathcal{B}(p)\) si \(X(\Omega)\subset\{0,1\}\) et \(P(X=1)=p\).
- \(X\) suit la loi binomiale \(\mathcal{B}(n,p)\) si \(X(\Omega)\subset[\![0,n]\!]\) et \(P(X=k)=\binom{n}{k}p^k(1-p)^{n-k}\) pour \(0\leqslant k\leqslant n\).
La formule du binôme montre que ces nombres \(P(X=k)\) ont bien pour somme \((p+1-p)^n=1\). De plus, toute indicatrice \(\mathbf{1}_A\) d’un événement suit la loi \(\mathcal{B}(P(A))\).
Une somme \(S=X_1+\dots+X_n\) de variables de Bernoulli de paramètre commun \(p\), mutuellement indépendantes, suit la loi \(\mathcal{B}(n,p)\).
Fixons \(k\in[\![0,n]\!]\). L’événement \((S=k)\) est la réunion disjointe des événements « \(X_i=1\) pour \(i\in I\) et \(X_i=0\) sinon », où \(I\) décrit les parties de \([\![1,n]\!]\) à \(k\) éléments. Par indépendance, chacun a pour probabilité \(p^k(1-p)^{n-k}\). Or il y a \(\binom{n}{k}\) parties \(I\) de ce type, d’où la formule annoncée pour \(P(S=k)\).
- Décrire une épreuve élémentaire à deux issues, et préciser ce que l’on appelle « succès ».
- Donner la probabilité \(p\) du succès, identique à chaque répétition.
- Justifier que les \(n\) répétitions sont mutuellement indépendantes : tirages avec remise, lancers successifs, individus distincts.
- Conclure : \(X\), qui compte les succès, suit la loi \(\mathcal{B}(n,p)\).
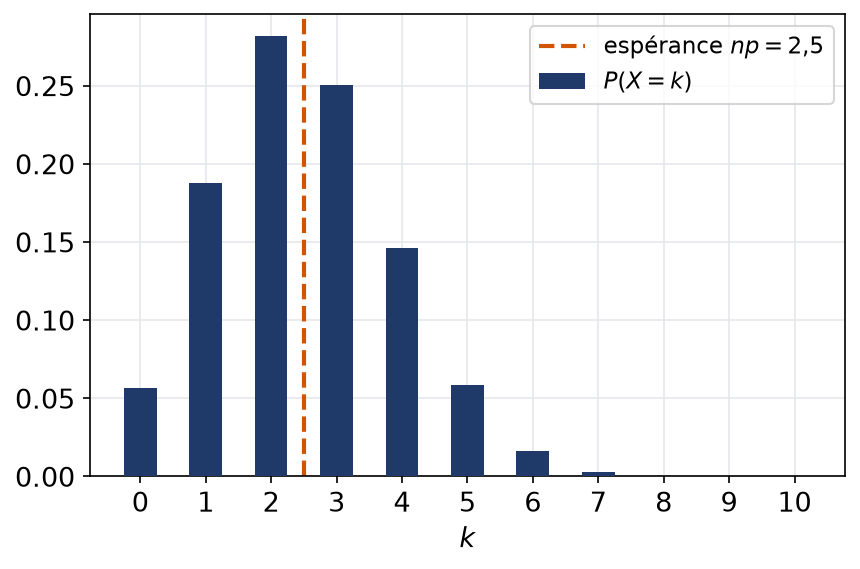
On lance dix fois un dé équilibré à quatre faces numérotées de 1 à 4, et \(X\) compte les « 4 » obtenus. Chaque lancer est une épreuve à deux issues, de succès « obtenir 4 », de probabilité \(\frac{1}{4}\). Ensuite, les lancers sont indépendants. Donc \(X\) suit la loi \(\mathcal{B}\big(10,\frac{1}{4}\big)\). Par exemple, aucun « 4 » n’apparaît avec probabilité \(\left(\frac{3}{4}\right)^{10}\), soit environ \(0{,}056\).
Piège à éviter :
Un tirage sans remise ne donne pas une loi binomiale. En effet, la composition de l’urne change après chaque tirage, et les épreuves ne sont plus indépendantes. Dans ce cas, on calcule la loi par dénombrement, ou l’on se contente de l’espérance par linéarité.
3. Couples de variables et indépendance
Souvent, une même expérience fournit plusieurs grandeurs à la fois. On les étudie alors ensemble, sous la forme d’un couple \((X,Y)\), qui est une variable aléatoire à valeurs dans \(X(\Omega)\times Y(\Omega)\).
La loi conjointe du couple \((X,Y)\) est la donnée des nombres \(P(X=x,Y=y)\), pour \(x\in X(\Omega)\) et \(y\in Y(\Omega)\). Les lois de \(X\) et de \(Y\) sont appelées les lois marginales du couple.
Les lois marginales se déduisent de la loi conjointe par la formule des probabilités totales : \(P(X=x)=\sum_{y\in Y(\Omega)}P(X=x,Y=y)\). En revanche, les lois marginales ne déterminent pas, en général, la loi conjointe.
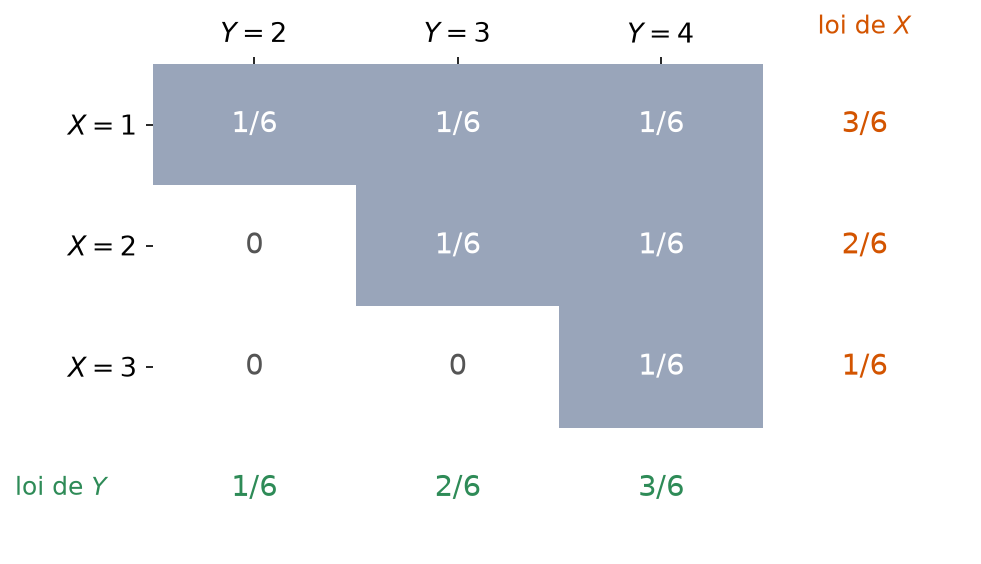
On tire simultanément deux jetons dans un sac contenant les jetons numérotés 1, 2, 3 et 4. On note \(X\) le plus petit numéro et \(Y\) le plus grand. Les six paires sont équiprobables. Ainsi, \(P(X=i,Y=j)=\frac{1}{6}\) si \(1\leqslant i<j\leqslant4\), et \(0\) sinon. En sommant les lignes, on trouve \(P(X=1)=\frac{3}{6}\), \(P(X=2)=\frac{2}{6}\) et \(P(X=3)=\frac{1}{6}\). De même, en sommant les colonnes, \(P(Y=2)=\frac{1}{6}\), \(P(Y=3)=\frac{2}{6}\) et \(P(Y=4)=\frac{3}{6}\).
Le tableau coloré ci-dessous représente cette loi conjointe. Les marges donnent les lois de \(X\) et de \(Y\).
3.1 Variables indépendantes
L’indépendance de deux variables traduit l’idée qu’aucune information sur l’une ne renseigne sur l’autre. On l’exprime sur tous les événements de la forme \((X=x)\) et \((Y=y)\).
On dit que \(X\) et \(Y\) sont indépendantes lorsque chaque case de la loi conjointe est le produit des deux marges : \(P(X=x,Y=y)=P(X=x)P(Y=y)\), quelles que soient les valeurs \(x\) et \(y\). Pour une famille \(X_1,\dots,X_n\), l’indépendance mutuelle demande que, quelles que soient les valeurs \(x_1,\dots,x_n\), \(P(X_1=x_1,\dots,X_n=x_n)=\prod_{i=1}^{n}P(X_i=x_i)\).
Dans l’exemple des jetons, \(X\) et \(Y\) ne sont pas indépendantes. En effet, \(P(X=3,Y=2)=0\), alors que \(P(X=3)P(Y=2)=\frac{1}{36}\). Pour prouver une dépendance, il suffit donc d’exhiber une seule case qui ne convient pas.
À l’inverse, pour prouver une indépendance, il faut contrôler toutes les cases du tableau. Une case nulle dans la loi conjointe, alors que les deux marges correspondantes sont non nulles, est d’ailleurs un signal immédiat de dépendance.
Si \(X\) et \(Y\) sont indépendantes, alors \(P(X\in A,Y\in B)=P(X\in A)P(Y\in B)\) pour toutes parties \(A\) et \(B\). De plus, \(f(X)\) et \(g(Y)\) sont encore indépendantes, quelles que soient les fonctions \(f\) et \(g\).
Le résultat suivant généralise cette remarque à des paquets de variables. Il permet de rédiger très vite de nombreuses justifications d’indépendance.
Lemme des coalitions. On suppose \(X_1,\dots,X_n\) mutuellement indépendantes, et l’on coupe la liste en deux paquets : les \(m\) premières variables d’un côté, les autres de l’autre. Toute variable \(f(X_1,\dots,X_m)\) construite sur le premier paquet est alors indépendante de toute variable \(g(X_{m+1},\dots,X_n)\) construite sur le second. Le résultat s’étend à un nombre quelconque de paquets disjoints.
Piège à éviter :
Le lemme exige des paquets disjoints. Par exemple, \(X_1+X_2\) et \(X_2+X_3\) partagent la variable \(X_2\) : elles ne sont pas indépendantes en général. De même, l’indépendance deux à deux d’une famille n’entraîne pas son indépendance mutuelle.
4. Espérance
L’espérance est la moyenne des valeurs de \(X\), pondérée par leurs probabilités. Elle résume la loi par un seul nombre, qui représente la valeur moyenne observée sur un grand nombre de répétitions.
L’espérance d’une variable aléatoire réelle \(X\) est le réel \(E(X)=\sum_{x\in X(\Omega)}x\,P(X=x)\). On peut aussi sommer sur les issues : \(E(X)=\sum_{\omega}P(\{\omega\})X(\omega)\). Une variable d’espérance nulle est dite centrée.
La seconde écriture s’obtient en regroupant les \(\omega\) selon la valeur de \(X(\omega)\). Elle est moins pratique pour calculer, mais elle rend évidentes les propriétés suivantes.
Soit \(X\) et \(Y\) deux variables réelles et \(a,b\) deux réels.
- Linéarité : \(E(aX+bY)=aE(X)+bE(Y)\).
- Positivité : si \(X\geqslant0\), alors \(E(X)\geqslant0\). Croissance : si \(X\leqslant Y\), alors \(E(X)\leqslant E(Y)\).
- Indicatrice : \(E(\mathbf{1}_A)=P(A)\) pour tout événement \(A\).
En particulier, une variable de loi \(\mathcal{B}(p)\) a pour espérance \(p\). Par linéarité, une variable de loi \(\mathcal{B}(n,p)\), somme de \(n\) indicatrices, a donc pour espérance \(np\). Remarquons que l’indépendance ne sert pas ici.
Formule de transfert. Pour toute fonction \(f\) définie sur \(X(\Omega)\) à valeurs réelles, l’espérance de \(f(X)\) vaut \(\sum_{x\in X(\Omega)}P(X=x)f(x)\).
La formule de transfert évite de calculer la loi de \(f(X)\). Ainsi, pour l’exemple de la partie 1, on trouve directement \(E(X^2)=\frac{1}{6}(4+1+0+1+4+9)=\frac{19}{6}\). Elle s’applique aussi à un couple : \(E(g(X,Y))=\sum_{x,y}g(x,y)P(X=x,Y=y)\).
Si \(X\) et \(Y\) sont indépendantes, alors \(E(XY)=E(X)E(Y)\).
Par la formule de transfert appliquée au couple, \(E(XY)=\sum_{x,y}xy\,P(X=x,Y=y)\). Par indépendance, chaque terme vaut \(xP(X=x)\cdot yP(Y=y)\). La somme double se factorise donc en \(\left(\sum_x xP(X=x)\right)\left(\sum_y yP(Y=y)\right)=E(X)E(Y)\).
4.1 La méthode des indicatrices
Beaucoup de variables comptent des objets : des boîtes vides, des points fixes, des répétitions. Leur loi est souvent inaccessible. En revanche, leur espérance se calcule presque sans effort.
- Écrire la variable comme un nombre d’objets vérifiant une propriété, puis poser \(A_i\) : « l’objet \(i\) vérifie la propriété ».
- Écrire \(X=\sum_{i}\mathbf{1}_{A_i}\).
- Appliquer la linéarité : \(E(X)=\sum_iP(A_i)\), sans aucune hypothèse d’indépendance.
- Exploiter la symétrie : souvent, tous les \(P(A_i)\) sont égaux.
On répartit \(k\) boules au hasard dans \(n\) boîtes, chaque boule choisissant sa boîte uniformément et indépendamment des autres. Soit \(N\) le nombre de boîtes vides. Pour chaque boîte \(i\), l’événement \(A_i\) « la boîte \(i\) reste vide » demande que les \(k\) boules évitent la boîte \(i\). Donc \(P(A_i)=\left(1-\frac{1}{n}\right)^k\). Par conséquent, \(E(N)=n\left(1-\frac{1}{n}\right)^k\). Par exemple, avec \(5\) boîtes et \(8\) boules, on attend en moyenne \(5\times0{,}8^8\approx0{,}84\) boîte vide.
5. Variance, écart type et covariance
L’espérance ne dit rien de l’étalement des valeurs. Par exemple, un gain certain de 10 euros et un gain de 0 ou 20 euros à pile ou face ont tous deux pour espérance 10. Il faut donc mesurer la dispersion autour de la moyenne.
La variance de \(X\) est l’espérance du carré de l’écart à la moyenne : \(V(X)=E\big([X-E(X)]^2\big)\). Elle est positive, et son écart type est \(\sigma(X)=\sqrt{V(X)}\). Une variable centrée de variance \(1\) est dite réduite.
Formule de König-Huygens : \(V(X)=E(X^2)-E(X)^2\). De plus, pour tous réels \(a\) et \(b\), \(V(aX+b)=a^2V(X)\).
Posons \(m=E(X)\). On développe \((X-m)^2=X^2-2mX+m^2\). Ensuite, la linéarité donne \(V(X)=E(X^2)-2m\cdot m+m^2=E(X^2)-m^2\). Enfin, \(aX+b-E(aX+b)=a(X-m)\), dont le carré a pour espérance \(a^2V(X)\).
Par exemple, pour \(X\) uniforme sur \(\{-2,-1,0,1,2,3\}\), on a \(E(X)=\frac{1}{2}\) et \(E(X^2)=\frac{19}{6}\). Donc \(V(X)=\frac{19}{6}-\frac{1}{4}=\frac{35}{12}\). De même, une variable de loi \(\mathcal{B}(p)\) vérifie \(X^2=X\), donc \(V(X)=p-p^2=p(1-p)\).
5.1 Covariance et variance d’une somme
La variance n’est pas linéaire. Pour calculer la variance d’une somme, il faut tenir compte des liens entre les termes. C’est le rôle de la covariance.
La covariance de \(X\) et \(Y\) est l’espérance du produit des écarts : \(\operatorname{Cov}(X,Y)=E\big([X-E(X)][Y-E(Y)]\big)\). En développant, on obtient \(\operatorname{Cov}(X,Y)=E(XY)-E(X)E(Y)\). Elle est symétrique, bilinéaire, et \(\operatorname{Cov}(X,X)=V(X)\).
Pour des variables \(X_1,\dots,X_n\), on a
\[V\Big(\sum_{i=1}^{n}X_i\Big)=\sum_{i=1}^{n}V(X_i)+2\sum_{1\leqslant i<j\leqslant n}\operatorname{Cov}(X_i,X_j).\]
Ainsi, quand les covariances \(\operatorname{Cov}(X_i,X_j)\) sont toutes nulles, par exemple pour des variables indépendantes deux à deux, les variances s’additionnent.
Par bilinéarité, \(V(\sum X_i)=\operatorname{Cov}(\sum_iX_i,\sum_jX_j)=\sum_{i,j}\operatorname{Cov}(X_i,X_j)\). Les termes \(i=j\) donnent les variances. Ensuite, les termes \(i\neq j\) vont par paires égales, par symétrie. Enfin, si \(X_i\) et \(X_j\) sont indépendantes, \(E(X_iX_j)=E(X_i)E(X_j)\), donc leur covariance est nulle.
On en déduit la variance d’une loi binomiale. En effet, \(\mathcal{B}(n,p)\) est la loi d’une somme de \(n\) variables de Bernoulli indépendantes. Donc une variable de loi \(\mathcal{B}(n,p)\) a pour variance \(np(1-p)\).
- Écrire la variable comme une somme \(X_1+\dots+X_m\), souvent d’indicatrices.
- Calculer chaque variance ; pour une indicatrice de probabilité \(p\), elle vaut \(p(1-p)\).
- Repérer les paires indépendantes, par le lemme des coalitions : leurs covariances sont nulles.
- Calculer les covariances restantes par \(E(X_iX_j)-E(X_i)E(X_j)\), puis appliquer la formule de la variance d’une somme.
On lance \(n\geqslant2\) fois une pièce équilibrée, et \(C\) compte les positions \(i\in[\![1,n-1]\!]\) où un pile est immédiatement suivi d’un face. On pose \(J_i\) l’indicatrice de cet événement, de probabilité \(\frac{1}{4}\). D’abord, la linéarité donne \(E(C)=\frac{n-1}{4}\). Ensuite, chaque \(J_i\) a pour variance \(\frac{3}{16}\). Deux indicatrices \(J_i\) et \(J_j\) avec \(|i-j|\geqslant2\) portent sur des lancers disjoints : elles sont indépendantes. En revanche, \(J_iJ_{i+1}=0\), car le lancer \(i+1\) ne peut pas être à la fois face et pile. Donc \(\operatorname{Cov}(J_i,J_{i+1})=-\frac{1}{16}\). Comme il y a \(n-2\) paires voisines, on obtient
\[V(C)=\frac{3(n-1)}{16}-\frac{2(n-2)}{16}=\frac{n+1}{16}.\]
Enfin, on contrôle pour \(n=2\) : on retrouve \(\frac{3}{16}\), la variance d’une variable de Bernoulli de paramètre \(\frac{1}{4}\).
Piège à éviter :
Les covariances entre voisins sont souvent oubliées. Pourtant, elles changent le résultat : sans elles, on trouverait \(\frac{3(n-1)}{16}\), ce qui est faux dès que \(n\geqslant3\).
Une covariance nulle n’entraîne pas l’indépendance. Soit \(X\) uniforme sur \(\{-2,-1,1,2\}\) et \(Y=|X|\). D’une part, \(E(X)=0\) et \(E(XY)=\frac{1}{4}(-4-1+1+4)=0\), donc \(\operatorname{Cov}(X,Y)=0\). D’autre part, \(P(X=1,Y=2)=0\), alors que \(P(X=1)P(Y=2)=\frac{1}{4}\times\frac{1}{2}\). Ainsi, les variables ne sont pas indépendantes.
6. Inégalités de Markov et de Bienaymé-Tchebychev
Lorsque la loi est inconnue, on peut encore contrôler la probabilité des grandes valeurs. Il suffit de connaître l’espérance ou la variance. Les majorations obtenues sont grossières, mais elles valent pour toutes les lois.
Inégalité de Markov. Si \(X\) est une variable réelle positive et \(a>0\), alors \(P(X\geqslant a)\leqslant\frac{E(X)}{a}\).
L’idée est de minorer \(X\) par une variable plus simple. Pour tout \(\omega\in\Omega\), l’inégalité \(X(\omega)\geqslant a\mathbf{1}_{(X\geqslant a)}(\omega)\) est vraie, puisque \(X\) est positive. En effet, le membre de droite vaut \(0\) ou \(a\), et il ne vaut \(a\) que si \(X\geqslant a\). Par croissance de l’espérance, \(aP(X\geqslant a)\leqslant E(X)\).
Un serveur reçoit chaque minute un nombre aléatoire \(X\) de requêtes, positif, d’espérance \(40\). D’abord, l’inégalité de Markov donne \(P(X\geqslant100)\leqslant\frac{40}{100}=0{,}4\). Supposons ensuite que l’on connaisse aussi \(V(X)=64\). Comme \((X\geqslant100)\) est inclus dans \((|X-40|\geqslant60)\), l’inégalité ci-dessous fournit \(P(X\geqslant100)\leqslant\frac{64}{3600}\approx0{,}018\). Ainsi, connaître la variance améliore nettement la majoration.
Remarque :
Pour appliquer l’inégalité de Markov, on vérifie d’abord la positivité de la variable. Sinon, on l’applique à une variable positive construite à partir d’elle, comme \(|X|\), \(X^2\) ou \((X-E(X))^2\).
Inégalité de Bienaymé-Tchebychev. Pour toute variable réelle \(X\) et tout \(\varepsilon>0\), \(P\big(|X-E(X)|\geqslant\varepsilon\big)\leqslant\frac{V(X)}{\varepsilon^2}\).
Les événements \(\big(|X-E(X)|\geqslant\varepsilon\big)\) et \(\big((X-E(X))^2\geqslant\varepsilon^2\big)\) sont égaux. On applique alors l’inégalité de Markov à la variable positive \((X-E(X))^2\), d’espérance \(V(X)\), avec \(a=\varepsilon^2\).
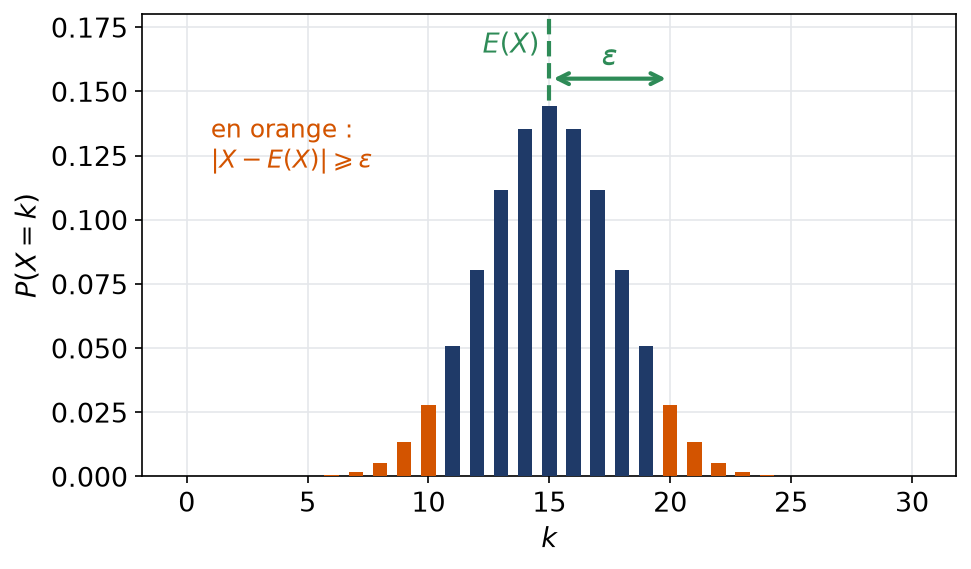
La figure représente une loi binomiale avec, en couleur, les valeurs éloignées de l’espérance. L’inégalité majore la masse totale de ces barres par \(V(X)/\varepsilon^2\).
On lance \(2000\) fois une pièce équilibrée, et \(F=\frac{S}{2000}\) est la fréquence des piles, où \(S\) suit la loi \(\mathcal{B}\big(2000,\frac{1}{2}\big)\). D’abord, \(E(F)=\frac{1}{2}\). Ensuite, \(V(F)=\frac{1}{2000^2}\cdot2000\cdot\frac{1}{4}=\frac{1}{8000}\). Par conséquent, \(P\big(|F-\frac{1}{2}|\geqslant0{,}05\big)\leqslant\frac{1}{8000\times0{,}0025}=0{,}05\). Autrement dit, la fréquence reste entre \(0{,}45\) et \(0{,}55\) avec une probabilité d’au moins \(0{,}95\).
Remarque :
Cette majoration est souvent très pessimiste : la vraie probabilité est ici minuscule. Cependant, elle a l’avantage d’être rigoureuse et de ne demander que deux moments. C’est pourquoi on l’utilise pour trouver un nombre de répétitions suffisant.
Les erreurs fréquentes
- Annoncer une loi binomiale sans justifier l’indépendance des épreuves, ou pour un tirage sans remise.
- Écrire \(V(X+Y)=V(X)+V(Y)\) sans indépendance, ou \(V(aX)=aV(X)\) au lieu de \(a^2V(X)\).
- Croire qu’une covariance nulle prouve l’indépendance.
- Penser que la linéarité de l’espérance exige l’indépendance : elle est toujours vraie.
- Appliquer l’inégalité de Markov à une variable qui n’est pas positive.
- Utiliser le lemme des coalitions avec deux paquets qui partagent une variable.
Fiche mémo
- Loi de \(X\) : les nombres \(P(X=x)\), de somme \(1\) ; loi de \(f(X)\) : on regroupe les antécédents.
- \(\mathcal{B}(p)\) : espérance \(p\), variance \(p(1-p)\).
- \(\mathcal{B}(n,p)\) : nombre de succès en \(n\) épreuves indépendantes ; espérance \(np\), variance \(np(1-p)\).
- Uniforme sur \([\![1,n]\!]\) : espérance \(\frac{n+1}{2}\), variance \(\frac{n^2-1}{12}\).
- Marginales : on somme la loi conjointe sur l’autre variable.
- Indépendance : produit des probabilités pour toutes les valeurs ; les coalitions disjointes restent indépendantes.
- Transfert : \(E(f(X))=\sum f(x)P(X=x)\) ; indicatrices : \(E(\mathbf{1}_A)=P(A)\).
- König-Huygens : \(V(X)=E(X^2)-E(X)^2\) ; \(V(aX+b)=a^2V(X)\).
- Variance d’une somme : somme des variances plus deux fois la somme des covariances.
- Markov : \(P(X\geqslant a)\leqslant E(X)/a\) ; Bienaymé-Tchebychev : \(P(|X-E(X)|\geqslant\varepsilon)\leqslant V(X)/\varepsilon^2\).
Questions fréquentes
Quand peut-on affirmer qu'une variable suit une loi binomiale ?
Il faut une épreuve à deux issues répétée n fois, une probabilité de succès identique à chaque répétition et des répétitions mutuellement indépendantes. La variable doit compter le nombre de succès. Dans une copie, ces trois points doivent apparaître explicitement, faute de quoi la justification est jugée incomplète.
La linéarité de l'espérance demande-t-elle l'indépendance ?
Non. L’égalité E(X+Y) = E(X) + E(Y) est toujours vraie, quelles que soient les dépendances entre X et Y. C’est ce qui rend la méthode des indicatrices si efficace. En revanche, l’indépendance est utile pour la variance d’une somme ou pour l’espérance d’un produit.
Une covariance nulle prouve-t-elle que deux variables sont indépendantes ?
Pas en général. Par exemple, une variable uniforme symétrique et sa valeur absolue ont une covariance nulle sans être indépendantes. L’équivalence devient vraie pour deux variables qui ne prennent chacune que deux valeurs, comme des indicatrices.
À quoi sert l'inégalité de Bienaymé-Tchebychev en pratique ?
Elle majore la probabilité qu’une variable s’écarte de son espérance, en n’utilisant que la variance. On s’en sert pour trouver un nombre de répétitions suffisant, par exemple pour qu’une fréquence soit proche d’une probabilité avec un niveau de confiance donné. La majoration est souvent grossière, mais elle est valable pour toutes les lois.
Pour aller plus loin
- S’exercer : exercices corrigés de maths sup (MPSI) sur variables aléatoires finies
- Bases utiles : Dénombrer et calculer des probabilités conditionnelles
- Chapitre d’avant : Dénombrer et calculer des probabilités conditionnelles
- Chapitre d’après : Produit scalaire, orthogonalité et Gram-Schmidt
- Vérifier ses acquis : QCM de maths sup (MPSI) sur variables aléatoires finies
- Contrôle corrigé en temps limité : Indicatrices et variance d'une somme : contrôle de maths en MPSI
- Le même thème en L2 de maths : Lois discrètes, espérance et variance
- Le même thème en maths spé (MP) : Espérance, variance et covariance d'une variable discrète
- Tous les chapitres : le sommaire de maths sup (MPSI)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «variables aléatoires finies en maths sup (MPSI) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths sup (MPSI)
Cours
Tout voir Module, argument et racines n-ièmes en maths sup (MPSI)
- Limite d’une suite et convergence en maths sup (MPSI)
- Quantificateurs et raisonnements en maths sup (MPSI)
- IPP et changement de variable en maths sup (MPSI)
- Produit scalaire et Gram-Schmidt en maths sup (MPSI)
- Nature d’une série numérique en maths sup (MPSI)
Exercices corrigés
Tout voir
Contrôles
Tout voir
QCM
Tout voir