Matrices de passage en L1 de maths : cours et méthodes
Ce chapitre sur les matrices passage L1 construit le dictionnaire entre applications linéaires et tableaux de nombres. Il prolonge directement l’étude du rang et le calcul matriciel du pivot de Gauss. On y apprend à coder une application par sa matrice dans deux bases, puis à lire une composée comme un produit et un isomorphisme comme une matrice inversible.
Le cœur du cours explique comment les coordonnées d’un vecteur se transforment quand on remplace une base par une autre, et comment la matrice d’un endomorphisme suit ce mouvement. Nous en tirons deux relations entre matrices, l’équivalence et la similitude, avec leurs invariants : le rang, conservé par transposition, et la trace.
Ces outils préparent les déterminants, puis la réduction des endomorphismes en deuxième année. Vous trouverez des schémas commentés, des preuves détaillées et des contre-exemples.
Ce que vous saurez faire
- Traduire une application linéaire en tableau de nombres, colonne par colonne, une fois les bases fixées.
- Traduire une composée en produit de matrices et un isomorphisme en matrice inversible.
- Construire une matrice de passage et convertir des coordonnées d’une base à l’autre.
- Effectuer un changement de base sur une application linéaire ou sur un endomorphisme.
- Reconnaître des matrices équivalentes et décider si deux matrices sont semblables.
- Calculer une trace et l’utiliser comme invariant.
1. La matrice d’une application linéaire
Le corps de base, noté \(\mathbb{K}\), est ici l’un des deux corps usuels, réel ou complexe. Nous travaillons avec deux espaces \(E\) et \(F\) de dimensions \(p\) et \(n\), sans jamais quitter la dimension finie. Sur \(E\), nous choisissons une base \(\mathcal{B} = (e_1, \dots, e_p)\), et sur \(F\), une base \(\mathcal{C} = (f_1, \dots, f_n)\).
D’abord, rappelons ce que le chapitre précédent a établi : connaître \(f\) sur les \(p\) vecteurs \(e_j\) revient à connaître \(f\) partout. Nous n’avons donc que \(p\) vecteurs à mémoriser. De plus, chacun d’eux se résume à ses \(n\) coordonnées dans \(\mathcal{C}\). On obtient ainsi un tableau de \(n\) lignes et \(p\) colonnes.
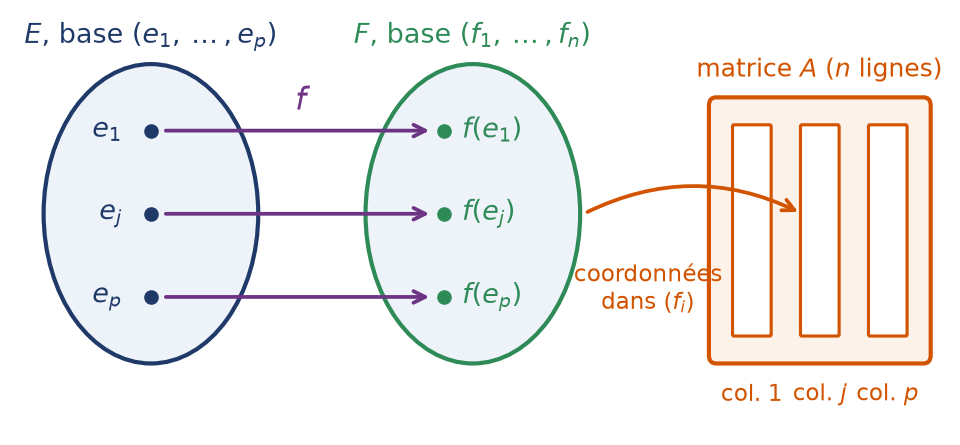
Soit \(f \in \mathcal{L}(E, F)\). On appelle matrice de \(f\) relativement à \(\mathcal{B}\) et \(\mathcal{C}\), et l’on note \(\mathrm{Mat}_{\mathcal{B}, \mathcal{C}}(f)\), le tableau à \(n\) lignes et \(p\) colonnes construit ainsi : pour chaque indice \(j\), sa colonne numéro \(j\) range, de haut en bas, les composantes de \(f(e_j)\) sur \(f_1, \dots, f_n\). Autrement dit, son coefficient \(a_{ij}\) est défini par \(f(e_j) = \sum_{i=1}^{n} a_{ij} f_i\).
Le schéma suivant résume la lecture : on part d’un vecteur de base au départ, on calcule son image, puis on range ses coordonnées en colonne.
Considérons \(f : \mathbb{R}_2[X] \to \mathbb{R}^2\) définie par \(f(P) = \left(P(3), P^{\prime}(-1)\right)\). Elle est linéaire, car l’évaluation et la dérivation le sont. L’espace de départ reçoit sa base usuelle \((1, X, X^2)\), et \(\mathbb{R}^2\) garde ses deux vecteurs canoniques.
- On calcule \(f(1) = (1, 0)\), puis \(f(X) = (3, 1)\), enfin \(f(X^2) = (9, -2)\) car la dérivée de \(X^2\) vaut \(2X\).
- On range ces images en colonnes, dans l’ordre de la base de départ.
On obtient \(\mathrm{Mat}(f) = \begin{pmatrix} 1 & 3 & 9 \\ 0 & 1 & -2 \end{pmatrix}\), qui possède 2 lignes car l’arrivée est de dimension 2.
Piège à éviter :
Les images se rangent en colonnes, jamais en lignes. Par ailleurs, la matrice dépend de l’ordre des vecteurs de base. Si l’on permute la base de départ, on permute les colonnes ; si l’on permute la base d’arrivée, on permute les lignes.
1.1 Calculer l’image d’un vecteur
La matrice ne sert pas qu’à stocker l’information. En effet, elle permet de calculer n’importe quelle image par un simple produit. Notons \(X\) la colonne des coordonnées de \(x\) dans \(\mathcal{B}\) et \(Y\) celle de \(f(x)\) dans \(\mathcal{C}\).
Si \(A = \mathrm{Mat}_{\mathcal{B}, \mathcal{C}}(f)\), alors pour tout \(x \in E\), on a \(Y = AX\).
Écrivons \(x = \sum_{j} x_j e_j\). Par linéarité, \(f(x) = \sum_{j} x_j f(e_j) = \sum_{j} x_j \sum_{i} a_{ij} f_i\). On échange les deux sommes finies : la coordonnée de \(f(x)\) sur \(f_i\) vaut \(\sum_{j} a_{ij} x_j\). C’est exactement le \(i\)-ième coefficient du produit \(AX\).
Par exemple, avec l’application \(f\) précédente et \(P = 2 – X + X^2\), on a \(X = (2, -1, 1)\) en colonne. Le produit donne \(Y = (2 – 3 + 9, \, 0 – 1 – 2) = (8, -3)\). On vérifie directement : \(P(3) = 8\) et \(P^{\prime}(-1) = -1 – 2 = -3\).
1.2 L’isomorphisme entre applications et matrices
Fixons maintenant les bases et faisons varier \(f\). On définit ainsi une application de \(\mathcal{L}(E, F)\) dans \(\mathcal{M}_{n,p}(\mathbb{K})\). Le résultat suivant montre que ce dictionnaire est parfait.
Les bases étant fixées, l’application \(\Phi\) qui associe à \(f\) sa matrice réalise une bijection linéaire de \(\mathcal{L}(E, F)\) sur l’espace \(\mathcal{M}_{n,p}(\mathbb{K})\) des tableaux à \(n\) lignes et \(p\) colonnes. Par conséquent, \(\dim \mathcal{L}(E, F) = np = \dim E \times \dim F\).
La linéarité vient du calcul \((\lambda f + g)(e_j) = \lambda f(e_j) + g(e_j)\) : les coordonnées s’ajoutent colonne par colonne. Ensuite, \(\Phi\) est injective, car une matrice nulle signifie que \(f\) s’annule sur une base, donc partout. Enfin, \(\Phi\) est surjective : pour une matrice \(A\) donnée, on définit \(f\) sur la base \(\mathcal{B}\) en imposant \(f(e_j) = \sum_i a_{ij} f_i\), ce qui est toujours possible.
Remarque :
Ce théorème justifie une habitude courante. On identifie souvent une matrice \(A\) de \(\mathcal{M}_{n,p}(\mathbb{K})\) à l’application \(X \mapsto AX\) de \(\mathbb{K}^p\) dans \(\mathbb{K}^n\). C’est l’application canoniquement associée à \(A\). Son rang, son noyau et son image sont alors ceux de \(A\).
2. Composée, inverse et matrices inversibles
Le produit matriciel n’a pas été défini au hasard. En réalité, sa définition est choisie pour traduire la composition des applications linéaires. Prenons un troisième espace \(G\), muni d’une base \(\mathcal{D}\).
Soient \(f \in \mathcal{L}(E, F)\) et \(g \in \mathcal{L}(F, G)\). Alors \(\mathrm{Mat}_{\mathcal{B}, \mathcal{D}}(g \circ f) = \mathrm{Mat}_{\mathcal{C}, \mathcal{D}}(g) \times \mathrm{Mat}_{\mathcal{B}, \mathcal{C}}(f)\).
Appelons \(A\) la matrice associée à \(f\) et \(B\) celle associée à \(g\). Un vecteur \(x\) de \(E\), repéré par sa colonne \(X\), a une image \(f(x)\) repérée par \(AX\). Ensuite, appliquer \(g\) multiplie cette colonne par \(B\), ce qui produit \(B(AX) = (BA)X\). Ainsi, la matrice \(BA\) calcule les images par \(g \circ f\). Appliquée à la colonne de \(e_j\), elle fournit la \(j\)-ième colonne de la matrice de \(g \circ f\), qui est donc \(BA\).
L’ordre des facteurs suit celui de l’écriture \(g \circ f\) : la matrice de l’application appliquée en dernier se place à gauche. On retrouve d’ailleurs pourquoi le produit matriciel n’est pas commutatif, puisque la composition ne l’est pas.
2.1 Isomorphismes et matrices inversibles
On suppose désormais \(\dim E = \dim F = n\). Une application linéaire bijective possède une réciproque linéaire. Le théorème de composition donne alors le lien avec l’inversibilité des matrices.
Soit \(f \in \mathcal{L}(E, F)\) avec \(\dim E = \dim F\), et \(A = \mathrm{Mat}_{\mathcal{B}, \mathcal{C}}(f)\). La bijectivité de \(f\) équivaut à l’inversibilité de \(A\). Lorsqu’elles ont lieu, la réciproque \(f^{-1}\), lue de \(\mathcal{C}\) vers \(\mathcal{B}\), a pour matrice \(A^{-1}\).
Si \(f\) est bijective, notons \(B\) la matrice de \(f^{-1}\). Les égalités \(f^{-1} \circ f = \mathrm{id}_E\) et \(f \circ f^{-1} = \mathrm{id}_F\) donnent \(BA = I_n\) et \(AB = I_n\). Réciproquement, supposons \(A\) inversible et construisons \(g\) de \(F\) vers \(E\) en lui donnant \(A^{-1}\) pour matrice, avec \(\mathcal{C}\) au départ et \(\mathcal{B}\) à l’arrivée. Les produits \(A^{-1}A\) et \(AA^{-1}\) valent \(I_n\), donc \(g \circ f\) et \(f \circ g\) sont les identités, et \(f\) est bijective.
Pour établir la bijectivité de \(f\) lorsque départ et arrivée ont la même dimension :
- on choisit des bases simples et on écrit la matrice \(A\) de \(f\) ;
- on prouve que \(A\) est inversible, par le pivot de Gauss ou parce qu’elle est triangulaire à diagonale sans zéro ;
- on calcule \(A^{-1}\) si l’on veut expliciter \(f^{-1}\), puis on traduit ses colonnes en vecteurs.
Par exemple, l’endomorphisme \(\delta\) de \(\mathbb{R}_2[X]\) défini par \(\delta(P) = P + 2P^{\prime}\) envoie \(1\) sur \(1\), \(X\) sur \(X + 2\) et \(X^2\) sur \(X^2 + 4X\). Sa matrice ne comporte que des zéros sous la diagonale et des 1 sur celle-ci. Elle est donc inversible, et \(\delta\) est un automorphisme.
3. Matrices de passage et changement de base
Un même vecteur possède des coordonnées différentes selon la base choisie. Nous cherchons maintenant à passer des unes aux autres. Soient \(\mathcal{B}\) et \(\mathcal{B}^{\prime}\) deux bases du même espace \(E\), de dimension \(n\). On appelle souvent \(\mathcal{B}\) l’ancienne base et \(\mathcal{B}^{\prime}\) la nouvelle.
On note \(\mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}\) et l’on appelle matrice de passage de \(\mathcal{B}\) vers \(\mathcal{B}^{\prime}\) la matrice carrée d’ordre \(n\) obtenue en écrivant, colonne après colonne, chaque vecteur de \(\mathcal{B}^{\prime}\) à l’aide de ses composantes sur \(\mathcal{B}\). Une autre lecture, plus profonde, en fait la matrice de l’identité : \(\mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}\) représente \(\mathrm{id}_E\) avec \(\mathcal{B}^{\prime}\) au départ et \(\mathcal{B}\) à l’arrivée.
La seconde écriture est la clé de tout le chapitre. En effet, elle présente la matrice de passage comme la matrice d’une application, l’identité, lue avec deux bases différentes. Toutes ses propriétés découlent donc du paragraphe précédent.
Une matrice de passage est toujours inversible, et son inverse est la matrice du trajet retour : \(\mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}^{-1} = \mathrm{P}_{\mathcal{B}^{\prime} \to \mathcal{B}}\). Par ailleurs, prenons un vecteur \(x\) quelconque et appelons \(X\) sa colonne relative à \(\mathcal{B}\), puis \(X^{\prime}\) celle relative à \(\mathcal{B}^{\prime}\). En posant \(P = \mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}\), ces deux colonnes sont liées par \(X = P X^{\prime}\).
L’identité est un isomorphisme, donc sa matrice est inversible. Son inverse est la matrice de \(\mathrm{id}_E^{-1} = \mathrm{id}_E\) lue dans les bases échangées, c’est-à-dire \(\mathrm{P}_{\mathcal{B}^{\prime} \to \mathcal{B}}\). Enfin, la relation \(Y = AX\) appliquée à l’identité, avec \(\mathcal{B}^{\prime}\) au départ et \(\mathcal{B}\) à l’arrivée, donne exactement \(X = PX^{\prime}\).
Piège à éviter :
La formule \(X = PX^{\prime}\) exprime les anciennes coordonnées en fonction des nouvelles. Elle va donc dans le sens inverse de l’intuition. Pour obtenir les nouvelles coordonnées, il faut calculer \(X^{\prime} = P^{-1}X\). Ce renversement est la première source d’erreurs du chapitre.
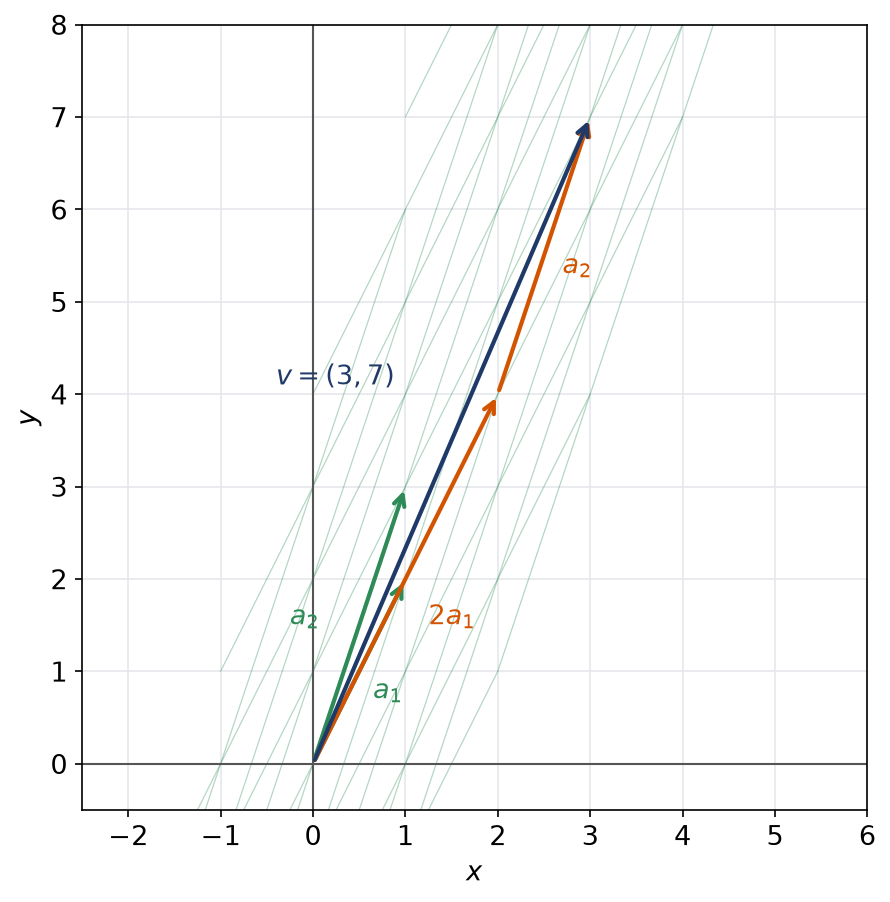
Le plan \(\mathbb{R}^2\) est d’abord muni de sa base canonique \(\mathcal{B}\). On lui donne ensuite une base plus pentue, formée de \(a_1 = (1, 2)\) et \(a_2 = (1, 3)\). Quelles sont, dans ce nouveau repère, les composantes de \(v = (3, 7)\) ?
- La matrice de passage vaut \(P = \begin{pmatrix} 1 & 1 \\ 2 & 3 \end{pmatrix}\), avec un déterminant égal à \(3 – 2 = 1\).
- Son inverse s’écrit donc \(P^{-1} = \begin{pmatrix} 3 & -1 \\ -2 & 1 \end{pmatrix}\).
- Ensuite, \(X^{\prime} = P^{-1} X\) fournit \((9 – 7, \, -6 + 7) = (2, 1)\).
Enfin, on contrôle : \(2a_1 + a_2 = (2 + 1, \, 4 + 3) = (3, 7)\). La figure montre la décomposition de \(v\) suivant le nouveau repère.
3.1 La formule de changement de base
Revenons à une application \(f \in \mathcal{L}(E, F)\). On change la base de départ, de \(\mathcal{B}\) en \(\mathcal{B}^{\prime}\), et la base d’arrivée, de \(\mathcal{C}\) en \(\mathcal{C}^{\prime}\). On note \(P\) et \(Q\) les deux matrices de passage correspondantes.
Si \(A = \mathrm{Mat}_{\mathcal{B}, \mathcal{C}}(f)\) et \(A^{\prime} = \mathrm{Mat}_{\mathcal{B}^{\prime}, \mathcal{C}^{\prime}}(f)\), alors \(A^{\prime} = Q^{-1} A P\).
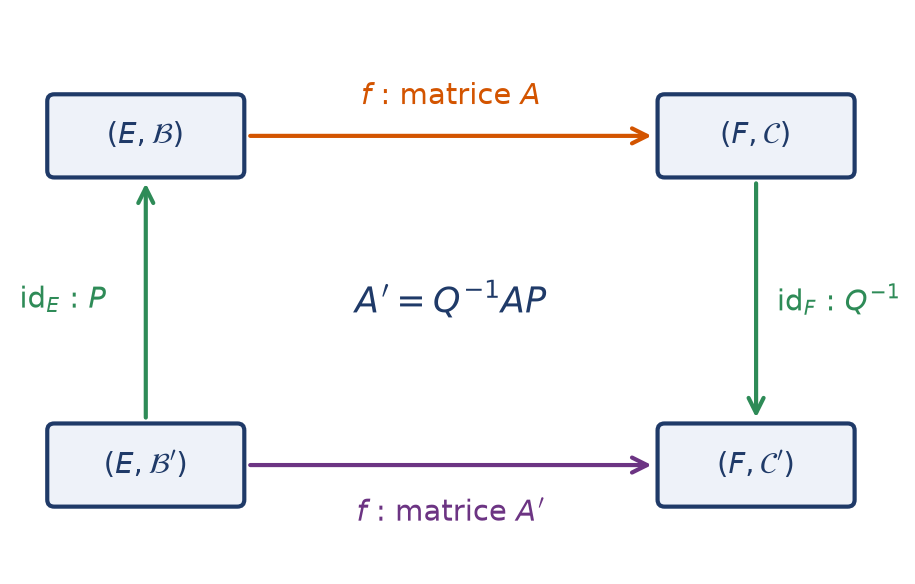
On écrit \(f = \mathrm{id}_F \circ f \circ \mathrm{id}_E\) et l’on choisit les bases avec soin. Au départ, \(\mathrm{id}_E\) va de \(\mathcal{B}^{\prime}\) vers \(\mathcal{B}\), de matrice \(P\). Ensuite, \(f\) va de \(\mathcal{B}\) vers \(\mathcal{C}\), de matrice \(A\). Enfin, \(\mathrm{id}_F\) va de \(\mathcal{C}\) vers \(\mathcal{C}^{\prime}\), de matrice \(Q^{-1}\). Le théorème de composition donne alors \(A^{\prime} = Q^{-1} A P\).
Le diagramme ci-dessous aide à retrouver la formule sans l’apprendre. On parcourt le chemin du coin \(\mathcal{B}^{\prime}\) au coin \(\mathcal{C}^{\prime}\) par le détour, et l’on écrit les matrices de droite à gauche.
Si \(u\) est un endomorphisme de \(E\), de matrice \(A\) dans \(\mathcal{B}\) et \(A^{\prime}\) dans \(\mathcal{B}^{\prime}\), alors \(A^{\prime} = P^{-1} A P\), où \(P\) désigne \(\mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}\).
Pour représenter un endomorphisme \(u\) dans une base \(\mathcal{B}^{\prime}\) qui remplace \(\mathcal{B}\) :
- on remplit \(P\) colonne par colonne avec les composantes, sur \(\mathcal{B}\), des vecteurs de \(\mathcal{B}^{\prime}\) ;
- soit on calcule \(P^{-1}AP\), soit on calcule directement l’image de chaque nouveau vecteur et on l’exprime dans la nouvelle base ;
- on contrôle le résultat sur un vecteur, ou bien par la trace, qui ne doit pas changer.
Considérons l’endomorphisme \(u\) de \(\mathbb{R}^2\) représenté canoniquement par \(A = \begin{pmatrix} -7 & 3 \\ -18 & 8 \end{pmatrix}\). Nous gardons la base \((a_1, a_2)\) de l’exemple précédent.
- D’abord, \(A a_1 = (-7 + 6, \, -18 + 16) = (-1, -2) = -a_1\). Ensuite, \(A a_2 = (-7 + 9, \, -18 + 24) = (2, 6) = 2a_2\).
- Par conséquent, dans \((a_1, a_2)\), la matrice de \(u\) devient \(D = \mathrm{diag}(-1, 2)\).
- La formule confirme ce résultat : \(AP = \begin{pmatrix} -1 & 2 \\ -2 & 6 \end{pmatrix}\), puis \(P^{-1}(AP) = \begin{pmatrix} -3 + 2 & 6 – 6 \\ 2 – 2 & -4 + 6 \end{pmatrix} = D\).
Cette nouvelle base simplifie tout. Par exemple, \(A^k = P D^k P^{-1}\) pour tout entier \(k\), et \(D^k\) se calcule terme à terme.
4. Matrices équivalentes et matrices semblables
La formule de changement de base suggère deux relations entre matrices. Elles répondent à deux questions différentes. Deux matrices peuvent-elles représenter la même application avec des bases libres au départ et à l’arrivée ? Peuvent-elles représenter le même endomorphisme avec une seule base ?
On dit que \(B\) est équivalente à \(A\), toutes deux de taille \(n \times p\), lorsque \(B = Q^{-1} A P\) pour un choix de \(Q\) inversible d’ordre \(n\) et de \(P\) inversible d’ordre \(p\). Pour des matrices carrées d’ordre \(n\), on dit que \(B\) est semblable à \(A\) lorsque \(B = P^{-1} A P\) pour une seule et même \(P\) inversible.
Ces deux relations sont réflexives, symétriques et transitives. De plus, la similitude entraîne l’équivalence, puisqu’il suffit de prendre \(Q = P\). Le chemin inverse, lui, n’existe pas, comme nous allons le voir.
4.1 L’équivalence se résume au rang
Pour \(r \leqslant \min(n, p)\), nous appelons \(J_r\) le tableau de taille \(n \times p\) rempli de zéros, sauf aux positions \((1, 1), \dots, (r, r)\), où l’on place des 1.
Le rang de \(A\) vaut \(r\) exactement lorsque \(A\) se ramène à \(J_r\) par un changement de bases au départ et à l’arrivée. Ainsi, pour deux tableaux de même format, l’équivalence se lit sur un seul nombre : leur rang commun.
Travaillons avec \(f : X \mapsto AX\), dont le rang vaut \(r\). Son noyau occupe alors \(p – r\) dimensions. Nous prenons un supplémentaire \(S\) de ce noyau, de base \((s_1, \dots, s_r)\), puis nous ajoutons à la suite une base \((k_1, \dots, k_{p-r})\) du noyau. Ensuite, la restriction de \(f\) à \(S\) est injective et atteint toute l’image, donc les \(f(s_i)\) engendrent \(\mathrm{Im} f\) et sont libres. Il reste à leur adjoindre \(n – r\) vecteurs pour remplir \(\mathbb{K}^n\). Dans ces deux bases, la matrice de \(f\) vaut exactement \(J_r\). Réciproquement, le rang ne change pas quand on multiplie par une matrice inversible, donc une matrice équivalente à \(J_r\) est de rang \(r\).
4.2 La similitude est beaucoup plus fine
Pour la similitude, la situation change complètement. On impose en effet la même base au départ et à l’arrivée, ce qui laisse beaucoup moins de liberté. Plusieurs quantités restent alors invariantes : le rang, la trace et, plus tard, le déterminant.
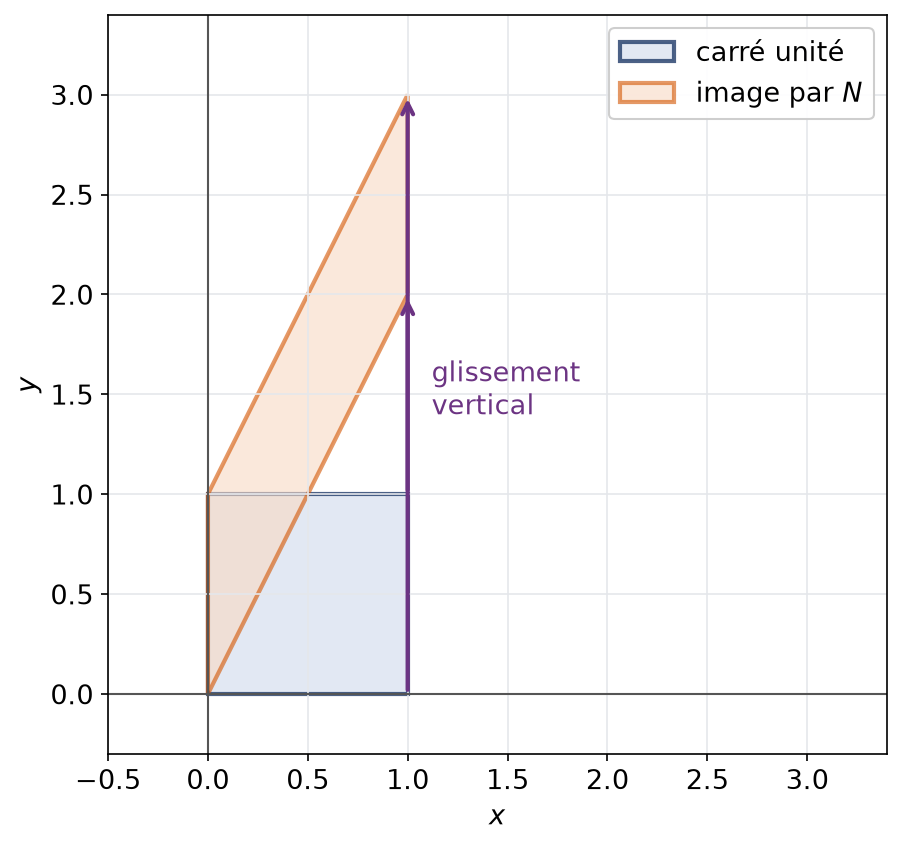
Comparons \(I_2\) avec \(N = \begin{pmatrix} 1 & 0 \\ 2 & 1 \end{pmatrix}\). Chacune est inversible, donc de rang 2 : elles sont équivalentes. Leurs diagonales coïncident, si bien que leurs traces valent toutes deux 2. Pourtant, quelle que soit \(P\) inversible, le produit \(P^{-1} I_2 P\) redonne \(I_2\). Aucune autre matrice que \(I_2\) ne lui est donc semblable, et \(N\) en particulier ne l’est pas.
Plus généralement, une matrice scalaire \(\lambda I_n\) n’est semblable qu’à elle-même. La figure suivante montre d’ailleurs que \(N\) agit très différemment de l’identité : elle fait glisser le carré unité vers le haut.
Pour décider si deux matrices carrées \(A\) et \(B\) sont semblables :
- on compare d’abord les invariants simples (trace, rang) : s’ils diffèrent, la réponse est non ;
- s’ils coïncident, on cherche une base \((v_1, \dots, v_n)\) dans laquelle l’endomorphisme associé à \(A\) a pour matrice \(B\) ;
- on peut aussi montrer que \(A\) et \(B\) sont toutes deux semblables à une même matrice simple, par exemple diagonale, puis conclure par transitivité.
5. Rang d’une matrice et transposition
Par définition, \(\mathrm{rg}(A)\) mesure combien de colonnes indépendantes \(A\) contient au maximum. C’est aussi le rang de chaque application linéaire que \(A\) représente. Une question naturelle se pose alors : que se passe-t-il pour les lignes ?
Transposer une matrice ne modifie pas son rang : \(\mathrm{rg}\left(A^{\top}\right) = \mathrm{rg}(A)\). En d’autres termes, une matrice possède autant de lignes indépendantes que de colonnes indépendantes.
Soit \(r = \mathrm{rg}(A)\). D’après le théorème d’équivalence, il existe \(Q\) et \(P\) inversibles telles que \(A = Q J_r P^{-1}\). On transpose : \(A^{\top} = \left(P^{-1}\right)^{\top} J_r^{\top} Q^{\top}\). Or la transposée d’une matrice inversible est inversible. Ainsi, \(A^{\top}\) est équivalente à \(J_r^{\top}\), qui est visiblement de rang \(r\). Donc \(\mathrm{rg}(A^{\top}) = r\).
Pour calculer un rang, on peut donc travailler indifféremment sur les lignes ou sur les colonnes. Par exemple, dans \(\begin{pmatrix} 2 & -1 & 3 \\ 4 & -2 & 6 \end{pmatrix}\), la seconde ligne est le double de la première : le rang vaut 1, sans examiner les trois colonnes.
6. La trace, invariant de similitude
Nous terminons par un invariant très simple à calculer. Il ne fait intervenir que la diagonale, et pourtant il ne dépend pas de la base.
À toute matrice carrée \(A\) d’ordre \(n\), on associe le nombre \(\mathrm{tr}(A) = a_{11} + a_{22} + \dots + a_{nn}\), appelé trace de \(A\) : on additionne les \(n\) termes situés sur la diagonale principale.
D’abord, l’application \(A \mapsto \mathrm{tr}(A)\) est linéaire, à valeurs dans \(\mathbb{K}\). Ensuite, elle vérifie \(\mathrm{tr}(A^{\top}) = \mathrm{tr}(A)\), puisque la transposition ne touche pas la diagonale. Sa propriété essentielle concerne toutefois les produits.
Si \(A\) a \(n\) lignes et \(p\) colonnes, et \(B\) au contraire \(p\) lignes et \(n\) colonnes, les deux produits \(AB\) et \(BA\) existent et \(\mathrm{tr}(BA) = \mathrm{tr}(AB)\). Il en découle que la trace ne varie pas d’une matrice à une matrice semblable.
Sur la diagonale de \(AB\), à la place \(i\), on lit \(\sum_{k=1}^{p} a_{ik} b_{ki}\). Donc \(\mathrm{tr}(AB) = \sum_{i=1}^{n} \sum_{k=1}^{p} a_{ik} b_{ki}\). De même, \(\mathrm{tr}(BA) = \sum_{k=1}^{p} \sum_{i=1}^{n} b_{ki} a_{ik}\). Les deux sommes doubles portent sur les mêmes termes, donc elles sont égales. Enfin, si \(B = P^{-1}AP\), on écrit \(\mathrm{tr}(P^{-1}(AP)) = \mathrm{tr}((AP)P^{-1}) = \mathrm{tr}(A)\).
Piège à éviter :
Contrairement au déterminant que nous verrons bientôt, la trace ne respecte pas les produits. Avec \(A = B = \begin{pmatrix} 0 & 1 \\ 1 & 0 \end{pmatrix}\), on trouve \(\mathrm{tr}(AB) = \mathrm{tr}(I_2) = 2\), alors que \(\mathrm{tr}(A)\,\mathrm{tr}(B) = 0\). De même, on peut permuter circulairement trois facteurs, mais pas les échanger librement.
6.1 Trace d’un endomorphisme
Grâce au théorème précédent, un endomorphisme \(u\) a la même trace dans toutes ses représentations matricielles. Ce nombre commun s’appelle la trace de \(u\) et se note \(\mathrm{tr}(u)\). En pratique, on le calcule dans la base où la matrice est la plus simple.
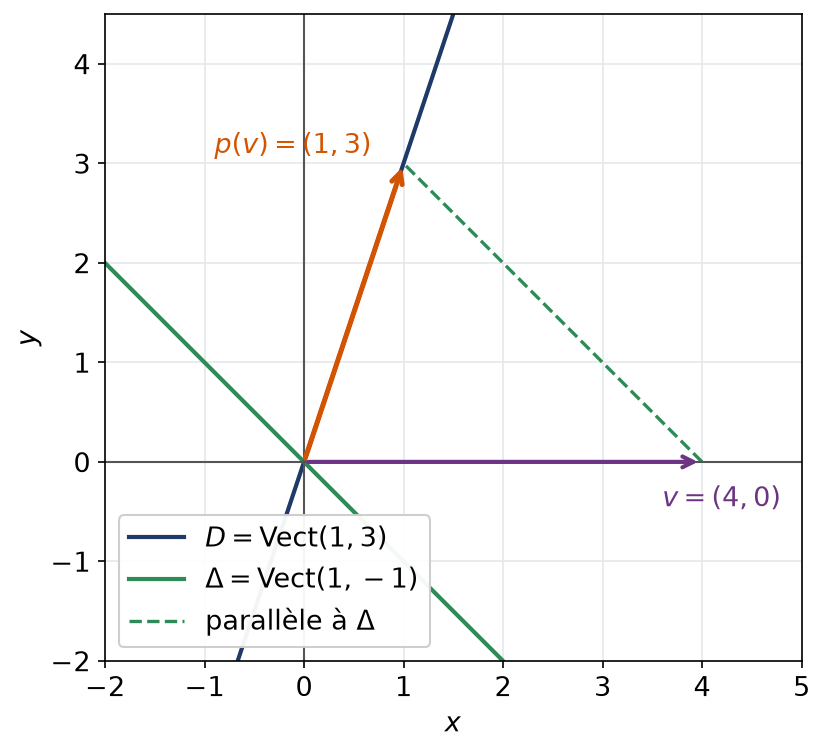
Dans \(\mathbb{R}^2\), notons \(p\) le projecteur d’image \(D = \mathrm{Vect}(1, 3)\) et de noyau \(\Delta = \mathrm{Vect}(1, -1)\).
- Prenons d’abord la base \(\left((1, 3), (1, -1)\right)\), adaptée à \(D\) et \(\Delta\). La matrice de \(p\) y vaut \(\mathrm{diag}(1, 0)\), donc sa trace vaut 1.
- Passons à la base canonique. On résout \((x, y) = a(1, 3) + b(1, -1)\) : en ajoutant les deux équations, \(4a = x + y\). Ainsi, \(p(x, y) = a(1, 3) = \left(\frac{x + y}{4}, \frac{3(x + y)}{4}\right)\).
- La matrice canonique s’écrit donc \(\frac{1}{4}\begin{pmatrix} 1 & 1 \\ 3 & 3 \end{pmatrix}\), et sa diagonale donne \(\frac{1 + 3}{4} = 1\).
Les deux calculs concordent, comme prévu. Plus généralement, pour tout projecteur, trace et rang coïncident.
Remarque :
Le calcul dans la base adaptée est presque immédiat. C’est la morale du chapitre : une bonne base transforme un problème de calcul en simple lecture. La réduction des endomorphismes, étudiée l’an prochain, systématise cette recherche de bases adaptées.
Les erreurs fréquentes
- Écrire horizontalement les composantes de \(f(e_j)\), ce qui fabrique la transposée de la bonne matrice.
- Écrire la matrice de passage à l’envers, avec l’ancienne base exprimée dans la nouvelle.
- Utiliser \(X^{\prime} = PX\) au lieu de \(X = PX^{\prime}\) pour convertir des coordonnées.
- Écrire \(PAP^{-1}\) au lieu de \(P^{-1}AP\) pour la nouvelle matrice d’un endomorphisme.
- Conclure que deux matrices sont semblables parce qu’elles ont même trace et même rang.
- Croire que la trace d’un produit est le produit des traces.
Fiche mémo
- Matrice de \(f\) : on empile verticalement les composantes de \(f(e_1)\), puis de \(f(e_2)\), et ainsi de suite.
- Image d’un vecteur : \(Y = AX\).
- Dimension : \(\dim \mathcal{L}(E, F) = \dim E \cdot \dim F\).
- Composée : la matrice de \(g \circ f\) vaut \(BA\) ; bijectivité de \(f\) et inversibilité de \(A\) vont ensemble.
- Passage : \(\mathrm{P}_{\mathcal{B} \to \mathcal{B}^{\prime}}\) range la nouvelle base, écrite dans l’ancienne, et \(X = PX^{\prime}\).
- Changement de bases : \(A^{\prime} = Q^{-1}AP\) ; pour un endomorphisme, \(A^{\prime} = P^{-1}AP\).
- Équivalence : un seul invariant, le rang, et un représentant simple, \(J_r\).
- Transposition : elle conserve le rang.
- Trace : \(\mathrm{tr}(BA) = \mathrm{tr}(AB)\), d’où son invariance par similitude.
- Trace et rang sont des invariants de similitude, mais ils ne suffisent pas à la caractériser.
Questions fréquentes
Comment ne plus se tromper de sens avec la matrice de passage ?
On retient que ses colonnes décrivent les nouveaux vecteurs avec l’alphabet de l’ancienne base. Multipliée par une colonne de nouvelles composantes, elle restitue les anciennes : X = PX’. Le trajet inverse, plus souvent utile, demande donc P⁻¹.
Une même trace et un même rang suffisent-ils pour conclure à la similitude ?
Non, ces invariants ne suffisent pas. La matrice identité d’ordre 2 et la matrice triangulaire inférieure avec des 1 sur la diagonale et un 2 en bas à gauche ont toutes deux trace 2 et rang 2. Pourtant, seule l’identité est semblable à l’identité.
Peut-on parler de la trace d'un endomorphisme sans préciser de base ?
Oui. Si l’on change de base, la nouvelle matrice s’écrit P⁻¹AP, et la relation tr(MN) = tr(NM) montre que sa trace reste celle de A. Le nombre obtenu appartient donc à l’endomorphisme lui-même, et l’on peut le calculer dans la base la plus commode.
Équivalence ou similitude : laquelle utiliser ?
L’équivalence autorise deux changements de base indépendants, l’un au départ, l’autre à l’arrivée ; elle concerne toutes les matrices rectangulaires. La similitude impose le même changement des deux côtés et ne concerne que les matrices carrées. La première se résume au rang, la seconde est beaucoup plus exigeante.
Pour aller plus loin
- S’exercer : exercices corrigés de L1 de maths sur matrices de passage
- Bases utiles : Applications linéaires : noyau, image, rang, Pivot de Gauss, systèmes et matrices
- Chapitre d’avant : Applications linéaires : noyau, image, rang
- Chapitre d’après : Déterminant, formules de Cramer et inverse
- Vérifier ses acquis : QCM de L1 de maths sur matrices de passage
- Contrôle corrigé en temps limité : Matrices de passage et similitude : contrôle de maths en L1
- Tous les chapitres : le sommaire de la L1 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «matrices de passage en L1 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.