Corrigé des exercices : Espérance et indépendance en L3 de maths
Ce corrigé indépendance L3 rédige chaque solution comme une copie de partiel. Chaque exercice commence par une idée clé. Les théorèmes utilisés sont nommés : transfert, Tonelli, Fubini, changement de variables.
Trois points de vigilance reviennent souvent. D’abord, une densité doit toujours être donnée avec son domaine, sinon le calcul de marginale est faux. Ensuite, une densité qui s’écrit comme un produit ne prouve l’indépendance que si son support est un pavé. Enfin, une espérance conditionnelle est une variable aléatoire : on l’écrit \(\psi(Y)\), et non comme un simple nombre. Les figures montrent la densité d’une somme, les moyennes conditionnelles d’un dé et l’évolution d’une loi après observation.
Pour démarrer
Corrigé de l’exercice 1 – Loi de un moins la racine d’une uniforme
Idée clé : la transformation \(x \mapsto 1 – \sqrt{x}\) est décroissante, donc l’événement \(\{Y \leq y\}\) se traduit directement en un événement sur \(X\).
- La variable \(Y\) prend ses valeurs dans \([0, 1]\). Pour \(y \in [0, 1]\), on a \(\{Y \leq y\} = \{\sqrt{X} \geq 1 – y\} = \{X \geq (1-y)^2\}\). Donc \(P(Y \leq y) = 1 – (1-y)^2\). Ainsi \(F_Y(y) = 0\) si \(y < 0\), \(F_Y(y) = 1 – (1-y)^2\) si \(0 \leq y \leq 1\), et \(F_Y(y) = 1\) si \(y > 1\).
- La fonction \(F_Y\) est continue et de classe \(C^1\) par morceaux. Sa dérivée vaut \(2(1-y)\) sur \(]0, 1[\). Donc \(Y\) a pour densité \(2(1-y)\mathbf{1}_{[0, 1]}(y)\).
- D’une part, \(E[Y] = \int_0^1 2y(1-y) \, dy = 1 – \frac{2}{3} = \frac{1}{3}\). D’autre part, par transfert, \(E[\sqrt{X}] = \int_0^1 \sqrt{x} \, dx = \frac{2}{3}\), d’où \(E[Y] = 1 – \frac{2}{3}\). Les deux méthodes donnent \(E[Y] = \frac{1}{3}\).
Corrigé de l’exercice 2 – Espérances par la formule de transfert
Idée clé : chaque espérance \(E[\varphi(X)]\) est l’intégrale de \(\varphi(x) \cdot 3x^2\) sur \([0, 1]\).
- On a \(f \geq 0\) et \(\int_0^1 3x^2 \, dx = 1\). Ensuite, \(E[X] = \int_0^1 3x^3 \, dx = \frac{3}{4}\) et \(E[X^2] = \int_0^1 3x^4 \, dx = \frac{3}{5}\). Donc \(E[X] = \frac{3}{4}\) et \(\mathrm{Var}(X) = \frac{3}{5} – \frac{9}{16} = \frac{3}{80}\).
- D’abord, \(E[1/X] = \int_0^1 3x \, dx = \frac{3}{2}\). Ensuite, une intégration par parties donne \(\int_0^1 x^2 \ln x \, dx = \big[\frac{x^3}{3}\ln x\big]_0^1 – \int_0^1 \frac{x^2}{3} \, dx = -\frac{1}{9}\). Donc \(E[1/X] = \frac{3}{2}\) et \(E[\ln X] = -\frac{1}{3}\).
- On a \(E[X^{-k}] = \int_0^1 3x^{2-k} \, dx\). Cette intégrale converge si et seulement si \(2 – k > -1\), soit \(k < 3\). La variable \(X^{-k}\) est intégrable exactement pour \(k = 1\) et \(k = 2\), avec \(E[X^{-2}] = 3\).
Ce dernier point mérite un commentaire. La densité \(3x^2\) s’annule en 0, ce qui atténue la singularité de \(x^{-k}\). Ainsi, l’intégrabilité dépend à la fois de la fonction et de la loi : avec une loi uniforme, déjà \(1/X\) ne serait pas intégrable.
Corrigé de l’exercice 3 – Une loi discrète sans espérance
Idée clé : la décomposition \(\frac{1}{k(k+1)} = \frac{1}{k} – \frac{1}{k+1}\) rend toutes les sommes télescopiques.
- Les nombres sont positifs. De plus, \(\sum_{k=1}^{K} \big(\frac{1}{k} – \frac{1}{k+1}\big) = 1 – \frac{1}{K+1}\), qui tend vers 1. On a donc bien une loi de probabilité sur \(\mathbb{N}^*\).
- De même, \(\sum_{k \geq n} \big(\frac{1}{k} – \frac{1}{k+1}\big) = \frac{1}{n}\). Ainsi \(P(N \geq n) = \frac{1}{n}\).
- Par transfert, \(E[N] = \sum_{k \geq 1} \frac{k}{k(k+1)} = \sum_{k \geq 1} \frac{1}{k+1}\). C’est la série harmonique, qui diverge. Donc \(E[N] = +\infty\). Pourtant, \(P(N \in \mathbb{N}^*) = 1\) : la variable est finie presque sûrement.
- On a \(E[\sqrt{N}] = \sum_{k \geq 1} \frac{\sqrt{k}}{k(k+1)} \leq \sum_{k \geq 1} k^{-3/2}\). Cette série de Riemann converge, donc \(E[\sqrt{N}] < +\infty\).
On retient de cet exemple qu’une variable finie partout peut avoir une espérance infinie. C’est le cas dès que la queue \(P(N \geq n)\) décroît trop lentement, ici comme \(1/n\). En effet, la formule \(E[N] = \sum_{n \geq 1} P(N \geq n)\), établie à l’exercice 7, redonne immédiatement la série harmonique.
Corrigé de l’exercice 4 – Chiffres en base 3 d’une variable uniforme
Idée clé : chaque couple de chiffres correspond à un intervalle de longueur \(1/9\).
- La partie entière est borélienne, donc \(D_1\) et \(D_2\) sont mesurables. Comme \(3U \in [0, 3[\), on a \(D_1 \in \{0, 1, 2\}\). Ensuite, \(3U \in [D_1, D_1 + 1[\), donc \(9U \in [3D_1, 3D_1 + 3[\). Par conséquent, \(D_2 \in \{0, 1, 2\}\).
- L’événement \(\{D_1 = a, D_2 = b\}\) équivaut à \(\lfloor 9U \rfloor = 3a + b\). C’est l’événement \(\big\{\frac{3a + b}{9} \leq U < \frac{3a + b + 1}{9}\big\}\), de probabilité \(\frac{1}{9}\).
- En sommant sur \(b\), on obtient \(P(D_1 = a) = \frac{1}{3}\). De même, \(P(D_2 = b) = \frac{1}{3}\). Ainsi \(P(D_1 = a, D_2 = b) = P(D_1 = a)P(D_2 = b)\) pour tous \(a, b\). Les deux chiffres sont indépendants, de loi uniforme sur \(\{0, 1, 2\}\).
- On compte les couples de somme donnée. La somme \(D_1 + D_2\) vaut 0, 1, 2, 3, 4 avec les probabilités \(\frac{1}{9}, \frac{2}{9}, \frac{3}{9}, \frac{2}{9}, \frac{1}{9}\), et son espérance vaut \(1 + 1 = 2\).
Corrigé de l’exercice 5 – Covariance d’un produit
Idée clé : l’indépendance de \(X\) et \(Y\) permet de factoriser toutes les espérances de produits.
- On a \(E[X] = E[X^2] = \frac{1}{3}\), \(E[Y] = 2\) et \(E[Y^2] = \frac{14}{3}\). Par indépendance, \(E[Z] = \frac{1}{3} \times 2 = \frac{2}{3}\). Ensuite, \(E[Z^2] = E[X^2]E[Y^2] = \frac{14}{9}\). Donc \(E[Z] = \frac{2}{3}\) et \(\mathrm{Var}(Z) = \frac{14}{9} – \frac{4}{9} = \frac{10}{9}\).
- D’abord, \(\mathrm{Cov}(X, Z) = E[X^2 Y] – E[X]E[XY] = \frac{2}{3} – \frac{1}{3} \times \frac{2}{3} = \frac{4}{9}\). Ensuite, \(\mathrm{Cov}(Y, Z) = E[XY^2] – E[Y]E[XY] = \frac{14}{9} – \frac{4}{3} = \frac{2}{9}\). Ainsi \(\mathrm{Cov}(X, Z) = \frac{4}{9}\) et \(\mathrm{Cov}(Y, Z) = \frac{2}{9}\).
- La covariance de \(X\) et \(Z\) n’est pas nulle. Donc \(X\) et \(Z\) ne sont pas indépendantes. On le voit aussi directement : \(P(X = 0, Z = 1) = 0\), alors que \(P(X = 0)P(Z = 1) = \frac{2}{3} \times \frac{1}{9}\).
Corrigé de l’exercice 6 – Minimum de deux exponentielles indépendantes
Idée clé : l’événement \(\{M > t\}\) est l’intersection de deux événements indépendants.
- On a \(\{M > t\} = \{X > t\} \cap \{Y > t\}\). Par indépendance, \(P(M > t) = e^{-2t}e^{-5t} = e^{-7t}\). Donc \(M\) suit la loi exponentielle de paramètre 7, et \(E[M] = \frac{1}{7}\).
- Le couple a pour densité \(10e^{-2x}e^{-5y}\) sur \(\mathbb{R}_+^2\). Par Fubini, \(P(X < Y) = \int_0^{+\infty} 2e^{-2x}\Big(\int_x^{+\infty} 5e^{-5y} \, dy\Big) dx = \int_0^{+\infty} 2e^{-7x} \, dx\). Donc \(P(X < Y) = \frac{2}{7}\).
- Deux composants indépendants de durées de vie \(X\) et \(Y\) sont montés en série. Le système tombe en panne au bout d’un temps exponentiel de paramètre \(2 + 5\), et c’est le premier composant qui lâche dans 2 cas sur 7.
Ce résultat se généralise sans peine. Pour \(n\) exponentielles indépendantes de paramètres \(\lambda_1, \ldots, \lambda_n\), le minimum suit la loi exponentielle de paramètre \(\lambda_1 + \cdots + \lambda_n\). De plus, l’indice du minimum vaut \(i\) avec probabilité \(\lambda_i/(\lambda_1 + \cdots + \lambda_n)\). Ces deux faits servent constamment dans l’étude des files d’attente.
Pour s’entraîner
Corrigé de l’exercice 7 – Espérance d’une variable positive par sa queue
Idée clé : on écrit \(X\) comme une intégrale d’indicatrices, puis on échange espérance et intégrale par Tonelli.
- Pour tout \(\omega\), on a \(X(\omega) = \int_0^{+\infty} \mathbf{1}_{\{t < X(\omega)\}} \, dt\). La fonction \((t, \omega) \mapsto \mathbf{1}_{\{t < X(\omega)\}}\) est mesurable et positive. Tonelli permet donc d’intervertir. Ainsi \(E[X] = \int_0^{+\infty} P(X > t) \, dt\).
- De même, \(X^2 = \int_0^{+\infty} 2t\,\mathbf{1}_{\{t < X\}} \, dt\). Tonelli donne \(E[X^2] = \int_0^{+\infty} 2t\,P(X > t) \, dt\).
- On calcule \(E[X] = \int_0^{+\infty} (1+t)^{-3} \, dt = \frac{1}{2}\). Ensuite, avec \(v = 1 + t\), \(E[X^2] = \int_1^{+\infty} \frac{2(v-1)}{v^3} \, dv = 2\big(1 – \frac{1}{2}\big) = 1\). Donc \(E[X] = \frac{1}{2}\), \(E[X^2] = 1\) et \(\mathrm{Var}(X) = \frac{3}{4}\).
- Si \(N\) est à valeurs entières, pour \(t \in [n-1, n[\), on a \(\{N > t\} = \{N \geq n\}\). En découpant l’intégrale, on obtient \(E[N] = \sum_{n \geq 1} P(N \geq n)\).
Cette méthode évite de calculer la densité de \(X\). Pourtant, celle-ci existe ici : elle vaut \(3(1+t)^{-4}\) sur \(\mathbb{R}_+\). Le calcul direct de \(E[X]\) par cette densité demande une intégration par parties, alors que la formule de la queue donne le résultat en une ligne.
Corrigé de l’exercice 8 – Logarithme d’une variable de densité 2x
Idée clé : on écrit \(E[h(Y)]\) comme une intégrale en \(x\), puis on change de variable pour faire apparaître \(h(y)\).
- Pour \(h\) borélienne bornée, \(E[h(Y)] = \int_0^1 h(-\ln x)\,2x \, dx\). On pose \(x = e^{-y}\), avec \(dx = -e^{-y}dy\) ; quand \(x\) va de 0 à 1, \(y\) va de \(+\infty\) à 0. On obtient \(E[h(Y)] = \int_0^{+\infty} h(y)\,2e^{-2y} \, dy\). Donc \(Y\) suit la loi exponentielle de paramètre 2.
- De même, \(E[h(Z)] = \int_0^1 h(x^2)\,2x \, dx\). Avec \(z = x^2\), on a \(dz = 2x\,dx\), d’où \(E[h(Z)] = \int_0^1 h(z) \, dz\). Ainsi \(Z\) suit la loi uniforme sur \([0, 1]\).
- D’une part, \(E[Y] = \frac{1}{2}\). D’autre part, \(E[\ln Z] = \int_0^1 \ln z \, dz = -1\). Or \(\ln Z = 2\ln X = -2Y\), et l’on retrouve bien \(-1 = -2 \times \frac{1}{2}\).
Corrigé de l’exercice 9 – Quotient de deux exponentielles par jacobien
Idée clé : on complète \(U = X/Y\) par \(V = Y\) pour obtenir un difféomorphisme, puis on intègre la variable auxiliaire.
- L’application \(\Phi(x, y) = (x/y, y)\) est de classe \(C^1\) sur \(]0, +\infty[^2\). Elle est bijective, de réciproque \(\Phi^{-1}(u, v) = (uv, v)\), elle aussi de classe \(C^1\). Le jacobien de \(\Phi^{-1}\) vaut \(\det \begin{pmatrix} v & u \\ 0 & 1 \end{pmatrix} = v\).
- Par indépendance, \((X, Y)\) a pour densité \(e^{-x-y}\) sur \(]0, +\infty[^2\). Le théorème du jacobien donne la densité \(g(u, v) = v\,e^{-uv – v}\) sur \(]0, +\infty[^2\). La marginale de \(V = Y\) est \(e^{-v}\), et celle de \(U\) est calculée ci-dessous. En \((u, v) = (1, 1)\), on a \(g(1, 1) = e^{-2}\), alors que le produit des marginales vaut \(\frac{1}{4}e^{-1}\). Ces fonctions continues diffèrent donc sur un voisinage. Par conséquent, \(U\) et \(V\) ne sont pas indépendantes.
- Pour \(u > 0\), \(f_U(u) = \int_0^{+\infty} v\,e^{-(1+u)v} \, dv = \frac{1}{(1+u)^2}\). C’est la densité annoncée.
- On a \(P(X \leq 2Y) = P(U \leq 2) = \int_0^2 \frac{du}{(1+u)^2} = 1 – \frac{1}{3}\). Donc \(P(X \leq 2Y) = \frac{2}{3}\). Enfin, \(\frac{u}{(1+u)^2} \sim \frac{1}{u}\) en \(+\infty\), qui n’est pas intégrable. La variable \(U\) n’est donc pas intégrable.
On peut aussi le voir sans densité. Par indépendance, \(E[X/Y] = E[X]\,E[1/Y]\) dans \([0, +\infty]\). Or \(E[1/Y] = \int_0^{+\infty} \frac{e^{-y}}{y} \, dy\) diverge en 0. Le quotient de deux variables intégrables n’a donc aucune raison d’être intégrable.
Corrigé de l’exercice 10 – Coordonnées polaires d’un point uniforme du disque
Idée clé : le passage en coordonnées polaires a pour jacobien \(r\), et la densité obtenue se factorise sur un pavé.
- L’application \((r, \theta) \mapsto (r\cos\theta, r\sin\theta)\) est un \(C^1\)-difféomorphisme de \(]0, 1[ \times ]-\pi, \pi[\) sur le disque privé du segment \([-1, 0] \times \{0\}\), qui est négligeable. Son jacobien vaut \(r\). Le couple \((R, \Theta)\) a donc pour densité \(\frac{r}{\pi}\) sur \(]0, 1[ \times ]-\pi, \pi[\).
- On écrit \(\frac{r}{\pi} = 2r \times \frac{1}{2\pi}\), sur un pavé. Ainsi \(R\) et \(\Theta\) sont indépendantes, \(R\) de densité \(2r\) sur \(]0, 1[\) et \(\Theta\) uniforme sur \(]-\pi, \pi[\).
- On a \(E[R] = \int_0^1 2r^2 \, dr = \frac{2}{3}\). Ensuite, pour \(t \in [0, 1]\), \(P(R^2 \leq t) = P(R \leq \sqrt{t}) = \int_0^{\sqrt{t}} 2r \, dr = t\). Donc \(E[R] = \frac{2}{3}\) et \(R^2\) est uniforme sur \([0, 1]\).
- Les événements \(\{X > 0{,}8\}\) et \(\{Y > 0{,}8\}\) ont une probabilité strictement positive. Pourtant, leur intersection est vide, car \(0{,}8^2 + 0{,}8^2 > 1\). Donc \(X\) et \(Y\) ne sont pas indépendantes.
La figure de l’énoncé le suggère déjà : les points ne remplissent pas les coins du carré \([-1, 1]^2\), ce qui interdit une loi produit.
Corrigé de l’exercice 11 – Indépendance lue sur une densité jointe
Idée clé : une densité factorisée prouve l’indépendance seulement si son support est un pavé.
- On a \(4xy = 2x \times 2y\) sur le pavé \([0, 1]^2\). Donc \(X\) et \(Y\) sont indépendantes, chacune de densité \(2x\) sur \([0, 1]\).
- La marginale de \(X\) est \(\int_0^1 (x + y) \, dy = x + \frac{1}{2}\), et de même pour \(Y\). Or \((x + \frac{1}{2})(y + \frac{1}{2}) – (x + y) = (x – \frac{1}{2})(y – \frac{1}{2})\), qui n’est nul que sur deux segments. Les variables ne sont donc pas indépendantes. Ensuite, \(E[X] = \frac{1}{3} + \frac{1}{4} = \frac{7}{12}\) et \(E[XY] = \iint (x^2y + xy^2) = \frac{1}{6} + \frac{1}{6} = \frac{1}{3}\). Ainsi \(\mathrm{Cov}(X, Y) = \frac{1}{3} – \frac{49}{144} = -\frac{1}{144}\).
- On trouve \(f_X(x) = \int_x^1 8xy \, dy = 4x(1 – x^2)\) et \(f_Y(y) = \int_0^y 8xy \, dx = 4y^3\), sur \(]0, 1[\). Sur le triangle \(\{0 < y < x < 1\}\), la densité jointe est nulle, alors que \(f_X f_Y\) y est strictement positive. Les variables ne sont pas indépendantes, malgré la forme produit de \(8xy\).
Le troisième cas est le piège classique. En réalité, la densité vaut \(8xy\,\mathbf{1}_{\{x < y\}}\), et l’indicatrice ne se factorise pas en une fonction de \(x\) fois une fonction de \(y\). C’est pourquoi il faut toujours écrire le domaine avec la densité. Par ailleurs, le deuxième cas montre qu’une covariance très faible, ici \(-1/144\), n’empêche pas une dépendance réelle.
Corrigé de l’exercice 12 – Boîtes vides et covariance d’indicatrices
Idée clé : la variance d’une somme d’indicatrices se calcule avec les probabilités des intersections deux à deux.
- On a \(N = \mathbf{1}_{A_1} + \mathbf{1}_{A_2} + \mathbf{1}_{A_3}\). Chaque boule évite la boîte 1 avec probabilité \(\frac{2}{3}\), indépendamment. Donc \(P(A_1) = \big(\frac{2}{3}\big)^4 = \frac{16}{81}\). Par linéarité, \(E[N] = 3 \times \frac{16}{81} = \frac{16}{27}\).
- L’événement \(A_1 \cap A_2\) signifie que les 4 boules sont dans la boîte 3. Donc \(P(A_1 \cap A_2) = \frac{1}{81}\). Ainsi \(\mathrm{Cov}(\mathbf{1}_{A_1}, \mathbf{1}_{A_2}) = \frac{1}{81} – \frac{256}{6561} = -\frac{175}{6561}\). Ce signe négatif est naturel : une boîte vide oblige les boules à remplir les autres.
- On a \(\mathrm{Var}(\mathbf{1}_{A_1}) = \frac{16}{81} \times \frac{65}{81} = \frac{1040}{6561}\). Puis \(\mathrm{Var}(N) = 3 \times \frac{1040}{6561} + 6 \times \big(-\frac{175}{6561}\big) = \frac{2070}{6561}\). Donc \(\mathrm{Var}(N) = \frac{230}{729}\).
- Toutes les boules sont dans une même boîte avec probabilité \(\frac{3}{81}\) : c’est \(\{N = 2\}\). Ensuite, il y a \(3^4 – 3 \times 2^4 + 3 = 36\) répartitions sans boîte vide. Donc \(P(N = 0) = \frac{36}{81}\) et \(P(N = 1) = \frac{42}{81}\). On retrouve \(E[N] = \frac{42 + 6}{81} = \frac{16}{27}\).
Corrigé de l’exercice 13 – Premier dé sachant le maximum
Idée clé : on calcule la loi conjointe de \((D_1, M)\), puis on applique la formule \(\psi(m) = E[D_1\mathbf{1}_{\{M = m\}}]/P(M = m)\).
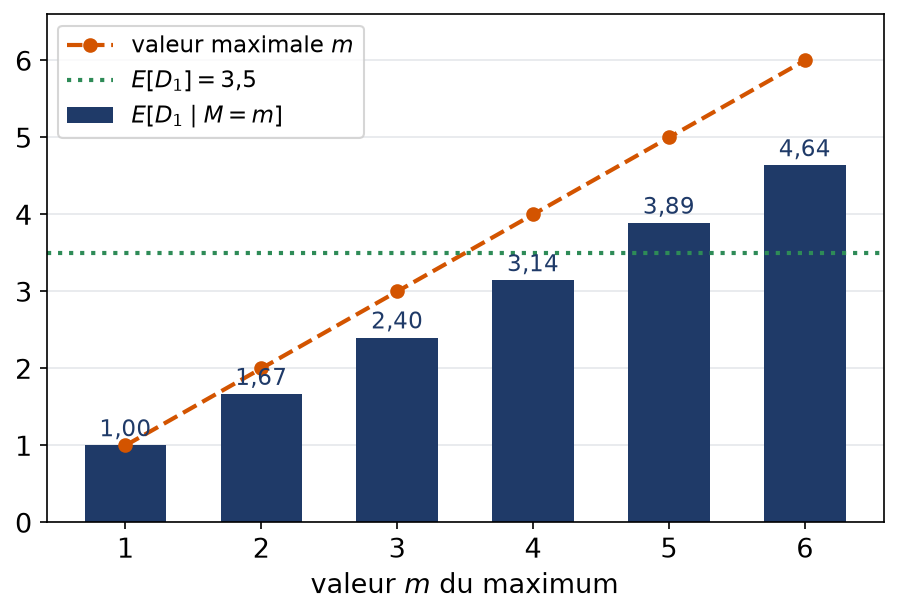
- On a \(P(M \leq m) = \big(\frac{m}{6}\big)^2\). Donc \(P(M = m) = \frac{m^2 – (m-1)^2}{36}\). Ainsi \(P(M = m) = \frac{2m – 1}{36}\) pour \(1 \leq m \leq 6\).
- Si \(k < m\), l’événement \(\{D_1 = k, M = m\}\) impose \(D_2 = m\) : probabilité \(\frac{1}{36}\). Si \(k = m\), il impose \(D_2 \leq m\) : probabilité \(\frac{m}{36}\). Enfin, si \(k > m\), l’événement est impossible. On obtient \(\frac{1}{36}\), \(\frac{m}{36}\) ou 0 selon les cas.
- On a \(E[D_1\mathbf{1}_{\{M = m\}}] = \frac{1}{36}\Big(\sum_{k=1}^{m-1} k + m^2\Big) = \frac{1}{36}\cdot\frac{m(3m – 1)}{2}\). En divisant par \(P(M = m)\), on trouve \(\psi(m) = \frac{m(3m-1)}{2(2m-1)}\). Donc \(E[D_1 \mid M] = \frac{M(3M-1)}{2(2M-1)}\).
- On a \(E[\psi(M)] = \sum_{m=1}^{6} \frac{2m-1}{36}\cdot\frac{m(3m-1)}{2(2m-1)} = \frac{1}{72}\sum_{m=1}^{6}(3m^2 – m)\). Or \(\sum m^2 = 91\) et \(\sum m = 21\). Donc \(E[\psi(M)] = \frac{273 – 21}{72} = \frac{7}{2} = E[D_1]\).
Le diagramme compare \(E[D_1 \mid M = m]\) à \(m\). La moyenne conditionnelle reste sous le maximum, et elle dépasse \(3{,}5\) dès que \(m \geq 5\).
Corrigé de l’exercice 14 – Espérances conditionnelles sur un triangle
Idée clé : sachant \(X = x\), la variable \(Y\) est uniforme sur \(]0, x[\) ; sachant \(Y = y\), la variable \(X\) est uniforme sur \(]y, 1[\).
- On a \(f_X(x) = \int_0^x 2 \, dy = 2x\) et \(f_Y(y) = \int_y^1 2 \, dx = 2(1-y)\), sur \(]0, 1[\). Les marginales ont pour densités \(2x\) et \(2(1-y)\).
- Pour \(0 < x < 1\), \(\frac{1}{2x}\int_0^x 2y \, dy = \frac{x}{2}\). Pour \(0 < y < 1\), \(\frac{1}{2(1-y)}\int_y^1 2x \, dx = \frac{1 – y^2}{2(1-y)} = \frac{1+y}{2}\). Donc \(E[Y \mid X] = \frac{X}{2}\) et \(E[X \mid Y] = \frac{1+Y}{2}\).
- On a \(E[X] = \frac{2}{3}\), \(E[Y] = \frac{1}{3}\) et \(E[XY] = \int_0^1\!\int_0^x 2xy \, dy \, dx = \int_0^1 x^3 \, dx = \frac{1}{4}\). Donc \(\mathrm{Cov}(X, Y) = \frac{1}{4} – \frac{2}{9} = \frac{1}{36}\).
- On calcule \(E\big[\frac{1+Y}{2}\big] = \frac{1}{2}\big(1 + \frac{1}{3}\big) = \frac{2}{3}\). C’est bien \(E[X]\).
La covariance positive confirme l’intuition de la figure : quand \(X\) est grand, le segment où vit \(Y\) s’allonge, et \(Y\) tend à être grand aussi. De plus, les deux espérances conditionnelles sont affines, ce qui est rare. Pour une densité non uniforme, \(\psi\) est en général une fonction non affine de la variable conditionnante.
Corrigé de l’exercice 15 – Partie entière et partie fractionnaire d’une exponentielle
Idée clé : l’espérance \(E[\mathbf{1}_{\{K = k\}}h(F)]\) se factorise en un terme en \(k\) et un terme en \(h\).
- Sur \(\{K = k\}\), on a \(X \in [k, k+1[\) et \(F = X – k\). Donc \(E[\mathbf{1}_{\{K = k\}}h(F)] = \int_k^{k+1} h(x – k)e^{-x} \, dx\). Avec \(z = x – k\), on obtient \(e^{-k}\int_0^1 h(z)e^{-z} \, dz\).
- Avec \(h = 1\), \(P(K = k) = e^{-k}(1 – e^{-1})\) : loi géométrique sur \(\mathbb{N}\). Ensuite, en sommant sur \(k\), \(E[h(F)] = \int_0^1 h(z)\frac{e^{-z}}{1 – e^{-1}} \, dz\). Donc \(F\) a pour densité \(\frac{e^{-z}}{1 – e^{-1}}\) sur \([0, 1[\).
- La question 1 s’écrit \(E[\mathbf{1}_{\{K = k\}}h(F)] = P(K = k)\,E[h(F)]\). Pour \(g\) bornée sur \(\mathbb{N}\), on somme sur \(k\) par convergence dominée : \(E[g(K)h(F)] = E[g(K)]\,E[h(F)]\). Le critère du cours montre que \(K\) et \(F\) sont indépendantes.
- Avec \(q = e^{-1}\), \(E[K] = \sum_{k \geq 0} k(1-q)q^k = \frac{q}{1-q} = \frac{1}{e – 1}\). Par linéarité, \(E[F] = E[X] – E[K]\). Donc \(E[K] = \frac{1}{e-1}\) et \(E[F] = \frac{e-2}{e-1} \approx 0{,}418\).
Ce résultat est propre à la loi exponentielle. Il traduit son absence de mémoire : sachant \(X \geq k\), la variable \(X – k\) a la même loi que \(X\). Pour une autre loi, la partie fractionnaire dépend en général de la partie entière. Notons enfin que \(E[F] < \frac{1}{2}\), car la densité de \(F\) est décroissante.
Pour approfondir
Corrigé de l’exercice 16 – Somme d’une uniforme et d’une exponentielle
Idée clé : par indépendance, le couple a pour densité \(e^{-y}\) sur \([0, 1] \times \mathbb{R}_+\) ; on change \(y\) en \(s = x + y\), puis on échange les intégrales.
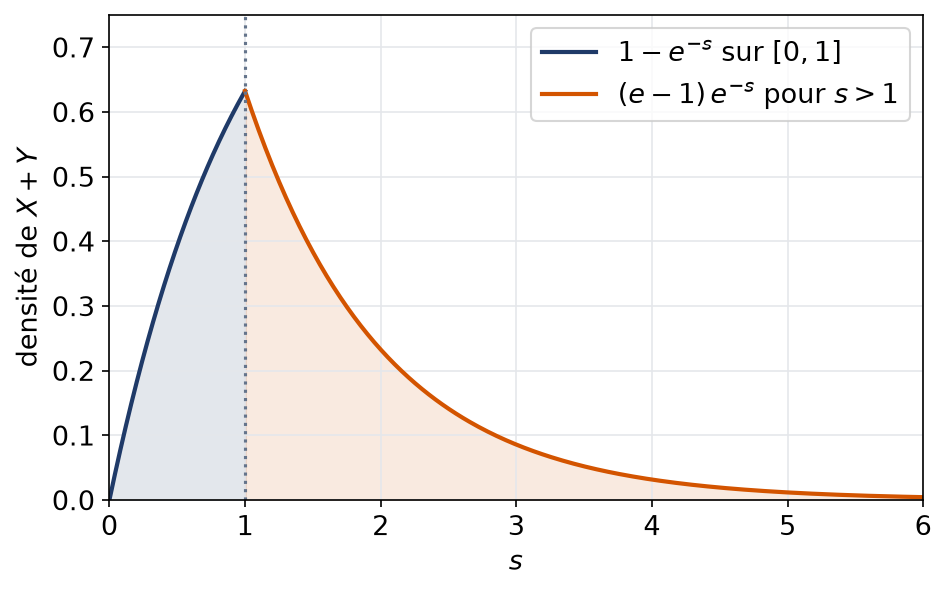
- Pour \(h\) borélienne bornée, \(E[h(S)] = \int_0^1\!\int_0^{+\infty} h(x + y)e^{-y} \, dy \, dx = \int_0^1\!\int_x^{+\infty} h(s)e^{x – s} \, ds \, dx\). Par Fubini, cette intégrale vaut \(\int_0^{+\infty} h(s)\Big(\int_0^{\min(s, 1)} e^{x – s} \, dx\Big) ds\). L’intégrale intérieure vaut \(e^{-s}(e^{\min(s,1)} – 1)\). Donc \(S\) a pour densité \(1 – e^{-s}\) sur \([0, 1]\) et \((e – 1)e^{-s}\) sur \(]1, +\infty[\).
- La fonction est positive. De plus, \(\int_0^1 (1 – e^{-s}) \, ds = e^{-1}\) et \(\int_1^{+\infty} (e-1)e^{-s} \, ds = 1 – e^{-1}\). La somme vaut 1 : c’est une densité.
- Le calcul précédent donne directement \(P(S \leq 1) = e^{-1}\). Ensuite, \(P(S > 2) = (e – 1)\int_2^{+\infty} e^{-s} \, ds\). Donc \(P(S \leq 1) = e^{-1}\) et \(P(S > 2) = (e-1)e^{-2} \approx 0{,}233\).
- Par linéarité, \(E[S] = \frac{1}{2} + 1 = \frac{3}{2}\). Avec la densité, \(\int_0^1 s(1 – e^{-s}) \, ds = \frac{1}{2} – (1 – 2e^{-1})\) et \((e-1)\int_1^{+\infty} se^{-s} \, ds = (e-1) \cdot 2e^{-1}\). La somme vaut \(\frac{2}{e} – \frac{1}{2} + 2 – \frac{2}{e} = \frac{3}{2}\).
La figure montre la densité de \(S\) : elle croît sur \([0, 1]\), où l’uniforme « remplit » le début, puis décroît comme une exponentielle.
Corrigé de l’exercice 17 – Variable indépendante d’elle-même
Idée clé : appliquer la définition de l’indépendance au couple \((A, A)\) donne l’équation \(p = p^2\).
- Pour \(A \in \mathcal{A}\), l’indépendance appliquée à \(A\) et \(A\) donne \(P(A) = P(A \cap A) = P(A)^2\). Donc \(P(A) \in \{0, 1\}\).
- Les événements \(\{X \leq t\}\) appartiennent à \(\sigma(X)\), tribu indépendante d’elle-même. Par la question 1, \(F_X(t) \in \{0, 1\}\) pour tout réel \(t\).
- La fonction \(F_X\) est croissante, continue à droite, de limites 0 en \(-\infty\) et 1 en \(+\infty\). Posons \(c = \inf\{t \mid F_X(t) = 1\}\), qui est un réel. Alors \(F_X = \mathbf{1}_{[c, +\infty[}\). Ainsi \(P(X = c) = F_X(c) – \lim_{t \to c^-} F_X(t) = 1\). Donc \(X = c\) presque sûrement.
- On a \(\sigma(\varphi(Y)) \subset \sigma(Y)\). Comme \(\sigma(\varphi(Y))\) est indépendante de \(\sigma(Y)\), elle est indépendante d’elle-même. La question 3 montre que \(\varphi(Y)\) est presque sûrement constante.
Cet exercice explique un réflexe utile : une variable qui est fonction d’une autre ne peut pas en être indépendante, sauf si elle est constante. C’est donc une façon rapide de réfuter une indépendance. Par exemple, \(X\) et \(X^2\) ne sont jamais indépendantes lorsque \(X^2\) n’est pas presque sûrement constante.
Corrigé de l’exercice 18 – Espérance conditionnelle et moindres carrés
Idée clé : l’erreur \(X – \psi(Y)\) est orthogonale à toutes les fonctions de \(Y\), ce qui donne un théorème de Pythagore.
- On décompose selon les valeurs de \(Y\) : \(E[(X – \psi(Y))g(Y)] = \sum_{y \in D} g(y)\big(E[X\mathbf{1}_{\{Y = y\}}] – \psi(y)P(Y = y)\big)\). Chaque terme est nul par définition de \(\psi\).
- On écrit \(X – g(Y) = (X – \psi(Y)) + (\psi(Y) – g(Y))\) et l’on développe le carré. Le double produit vaut \(2E[(X – \psi(Y))(\psi – g)(Y)]\). Il est nul d’après la question 1, appliquée à la fonction \(\psi – g\). On obtient l’égalité annoncée.
- Le second terme du membre de droite est positif. Donc \(E[(X – g(Y))^2] \geq E[(X – \psi(Y))^2]\), avec égalité si et seulement si \(g(Y) = \psi(Y)\) presque sûrement.
- Sachant \(Y = 0\), \(X\) est uniforme sur \(\{1, 3, 5\}\), de moyenne 3. Sachant \(Y = 1\), elle est uniforme sur \(\{2, 4, 6\}\), de moyenne 4. Donc \(E[X \mid Y] = 3 + Y\). Dans chaque groupe, l’écart quadratique moyen vaut \(\frac{4 + 0 + 4}{3} = \frac{8}{3}\). L’erreur minimale vaut \(\frac{8}{3}\), inférieure à \(\mathrm{Var}(X) = \frac{35}{12}\), qui est l’erreur de la meilleure constante.
Géométriquement, \(\psi(Y)\) est la projection orthogonale de \(X\) sur le sous-espace de \(L^2\) formé des variables \(g(Y)\). La question 2 est le théorème de Pythagore dans cet espace. Ce point de vue permet de définir l’espérance conditionnelle dans le cas général, au-delà de ce chapitre.
Corrigé de l’exercice 19 – Problème : une pièce au biais aléatoire
Idée clé : tout se ramène à des intégrales sur le cube \([0, 1]^4\), où la loi de \((U, V_1, V_2, V_3)\) a pour densité 1.
- Par indépendance, \((U, V_1)\) a pour densité 1 sur \([0, 1]^2\). Par Fubini, \(E[h(U)X_1] = \int_0^1 h(u)\Big(\int_0^1 \mathbf{1}_{\{v \leq u\}} \, dv\Big) du = \int_0^1 h(u)\,u \, du\). Avec \(h = 1\), on obtient \(P(X_1 = 1) = \frac{1}{2}\).
- De même, \(E[h(U)X_1X_2] = \int_0^1 h(u)\,u^2 \, du\). Donc \(P(X_1 = 1, X_2 = 1) = \frac{1}{3}\), qui diffère de \(\frac{1}{4}\). Les variables \(X_1\) et \(X_2\) ne sont pas indépendantes, et \(\mathrm{Cov}(X_1, X_2) = \frac{1}{3} – \frac{1}{4} = \frac{1}{12}\).
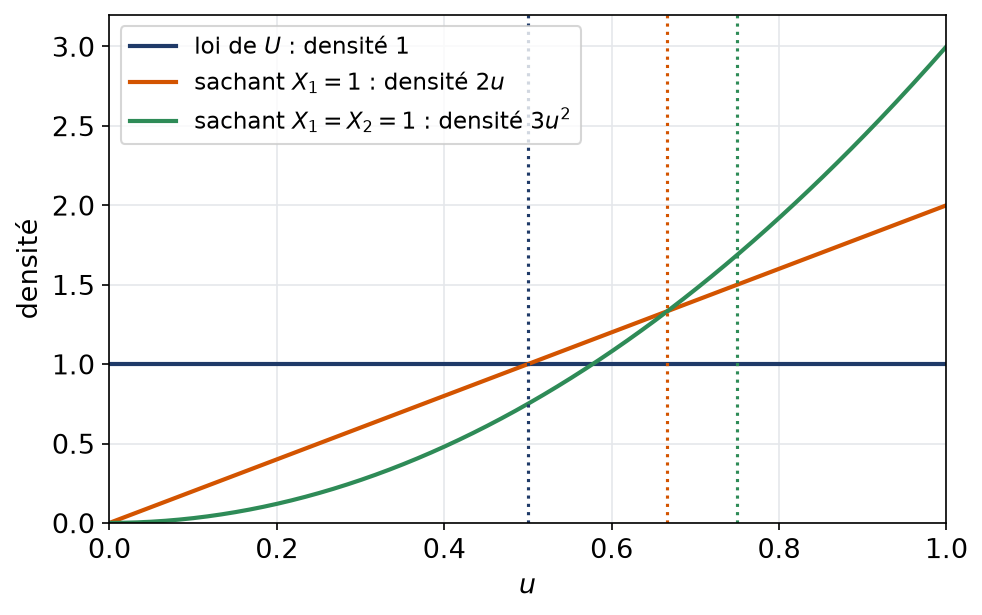
- Pour \(B\) borélien, \(P(U \in B \mid X_1 = 1) = \frac{E[\mathbf{1}_B(U)X_1]}{1/2} = \int_B 2u \, du\). De même, \(E[h(U)(1 – X_1)] = \int_0^1 h(u)(1-u) \, du\). Sachant \(X_1 = 1\), \(U\) a pour densité \(2u\) ; sachant \(X_1 = 0\), elle a pour densité \(2(1-u)\). Les moyennes valent \(\frac{2}{3}\) et \(\frac{1}{3}\). Donc \(E[U \mid X_1] = \frac{1 + X_1}{3}\).
- On a \(P(U \in B \mid X_1 = X_2 = 1) = 3\int_B u^2 \, du\). Sachant \(X_1 = X_2 = 1\), \(U\) a pour densité \(3u^2\) et pour espérance \(\int_0^1 3u^3 \, du = \frac{3}{4}\).
- De même, \(P(X_1 = X_2 = X_3 = 1) = \int_0^1 u^3 \, du = \frac{1}{4}\). Donc \(P(X_3 = 1 \mid X_1 = X_2 = 1) = \frac{1/4}{1/3} = \frac{3}{4}\). Cette probabilité dépasse \(P(X_3 = 1) = \frac{1}{2}\) : deux piles observés rendent plus probable un biais élevé.
Ce problème contient deux leçons. D’abord, des variables peuvent être indépendantes conditionnellement à \(U\) sans l’être globalement : le biais inconnu crée une corrélation positive entre les lancers. Ensuite, la valeur \(\frac{3}{4}\) est un cas de la règle de succession : après \(n\) piles sur \(n\) lancers, la probabilité d’un nouveau pile vaut \(\frac{n+1}{n+2}\). En effet, le rapport \(\int_0^1 u^{n+1}\,du \big/ \int_0^1 u^n\,du\) vaut exactement \(\frac{n+1}{n+2}\).
La figure montre comment la loi de \(U\) se déplace vers la droite à chaque pile observé. Les pointillés marquent les moyennes \(\frac{1}{2}\), \(\frac{2}{3}\) et \(\frac{3}{4}\).
Pour aller plus loin
- Revoir la leçon : cours de L3 de maths sur espérance et indépendance
- S’exercer : exercices corrigés de L3 de maths sur espérance et indépendance
- Bases utiles : Beppo Levi, Fatou et convergence dominée, Tonelli, Fubini et changement de variables
- Chapitre d’avant : Bases hilbertiennes, L^2 et transformée de Fourier
- Chapitre d’après : Fonction caractéristique, convergences et TCL
- Vérifier ses acquis : QCM de L3 de maths sur espérance et indépendance
- Contrôle corrigé en temps limité : Fonction muette et espérance conditionnelle : contrôle de maths en L3
- Un autre sujet noté sur 20 : Examen final de probabilités : contrôle de maths en L3
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «corrigé des exercices : Espérance et indépendance en L3 de maths» au format PDF afin de pouvoir travailler en totale autonomie.