Convergence en loi et TCL en L3 de maths : cours et méthodes
Ce cours de TCL L3 clôt le parcours de probabilités fondé sur la mesure. Il prolonge directement le chapitre sur l’espérance et l’indépendance. D’abord, nous introduisons la fonction caractéristique, qui transforme une loi en une fonction continue et bornée. Ensuite, nous l’utilisons pour décrire les vecteurs gaussiens et leurs critères d’indépendance.
Le cœur du chapitre compare quatre modes de convergence : presque sûre, en probabilité, dans L^p et en loi. Chaque implication est démontrée, et chaque implication fausse reçoit son contre-exemple. Par ailleurs, le lemme de Borel-Cantelli sert d’outil pour passer des probabilités aux événements presque sûrs. Enfin, nous prouvons les lois des grands nombres, le théorème de Lévy et le théorème central limite. Ces résultats sont le socle de la statistique et des processus aléatoires étudiés en master.
Ce que vous saurez faire
- Calculer la fonction caractéristique d’une loi usuelle et en tirer les moments.
- Reconnaître un vecteur gaussien et décider de l’indépendance de ses composantes.
- Comparer les convergences presque sûre, en probabilité, dans \(L^p\) et en loi, avec un contre-exemple pour chaque implication fausse.
- Appliquer les deux lemmes de Borel-Cantelli pour obtenir un résultat presque sûr.
- Démontrer et utiliser les lois des grands nombres et le théorème central limite.
- Prouver une convergence en loi par le théorème de Lévy.
1. Fonction caractéristique
Nous travaillons sur un espace probabilisé \((\Omega, \mathcal{F}, \mathbb{P})\) fixé. Sauf mention contraire, les variables considérées sont réelles. L’idée centrale est simple : on remplace une loi par sa transformée de Fourier. Les produits de convolution deviennent alors de simples produits.
1.1 Définition et premières propriétés
La fonction caractéristique d’une variable aléatoire \(X\) est la fonction \(\varphi_X : \mathbb{R} \to \mathbb{C}\) définie par \(\varphi_X(t) = \mathbb{E}[e^{itX}]\). Pour un vecteur aléatoire \(X\) de \(\mathbb{R}^d\), on pose \(\varphi_X(u) = \mathbb{E}[e^{i\langle u, X\rangle}]\).
L’espérance existe toujours, car \(|e^{itX}| = 1\). Ainsi, contrairement à la fonction génératrice des moments, la fonction caractéristique est définie pour toute loi.
Pour toute variable \(X\) : \(\varphi_X(0) = 1\) ; \(|\varphi_X(t)| \leq 1\) ; \(\varphi_X\) est uniformément continue ; \(\varphi_{aX + b}(t) = e^{ibt}\varphi_X(at)\). De plus, si \(X\) et \(Y\) sont indépendantes, alors \(\varphi_{X + Y} = \varphi_X\,\varphi_Y\).
Les deux premiers points sont immédiats. Pour la continuité uniforme, on écrit \(|\varphi_X(t + h) – \varphi_X(t)| \leq \mathbb{E}[|e^{ihX} – 1|]\). Le majorant ne dépend pas de \(t\). Ensuite, \(|e^{ihX} – 1| \leq 2\) et tend vers \(0\) quand \(h \to 0\), donc la convergence dominée donne la limite nulle. Enfin, l’indépendance entraîne \(\mathbb{E}[e^{itX}e^{itY}] = \mathbb{E}[e^{itX}]\,\mathbb{E}[e^{itY}]\), car les fonctions \(e^{itx}\) sont mesurables et bornées.
1.2 Calculs fondamentaux
Soit \(X\) de loi exponentielle de paramètre \(\lambda > 0\), de densité \(\lambda e^{-\lambda x}\) sur \(\mathbb{R}_+\). On calcule directement :
\[\varphi_X(t) = \int_0^{+\infty} \lambda e^{(it – \lambda)x}\,dx = \frac{\lambda}{\lambda – it}.\]
En effet, \(|e^{(it – \lambda)x}| = e^{-\lambda x}\) tend vers \(0\) à l’infini. Par exemple, pour \(\lambda = 2\), on obtient \(\varphi_X(t) = 2/(2 – it)\), dont le module vaut \(2/\sqrt{4 + t^2}\).
Le cas gaussien demande une autre technique, car la primitive de \(e^{-x^2/2}\) n’est pas explicite. Soit \(G\) de loi \(\mathcal{N}(0, 1)\). On dérive sous l’intégrale, ce qui est permis car \(|x|e^{-x^2/2}\) est intégrable. Une intégration par parties donne ensuite \(\varphi_G^{\prime}(t) = -t\,\varphi_G(t)\). Comme \(\varphi_G(0) = 1\), on en déduit :
\[\varphi_G(t) = e^{-t^2/2}, \qquad \varphi_{m + \sigma G}(t) = e^{imt – \sigma^2t^2/2}.\]
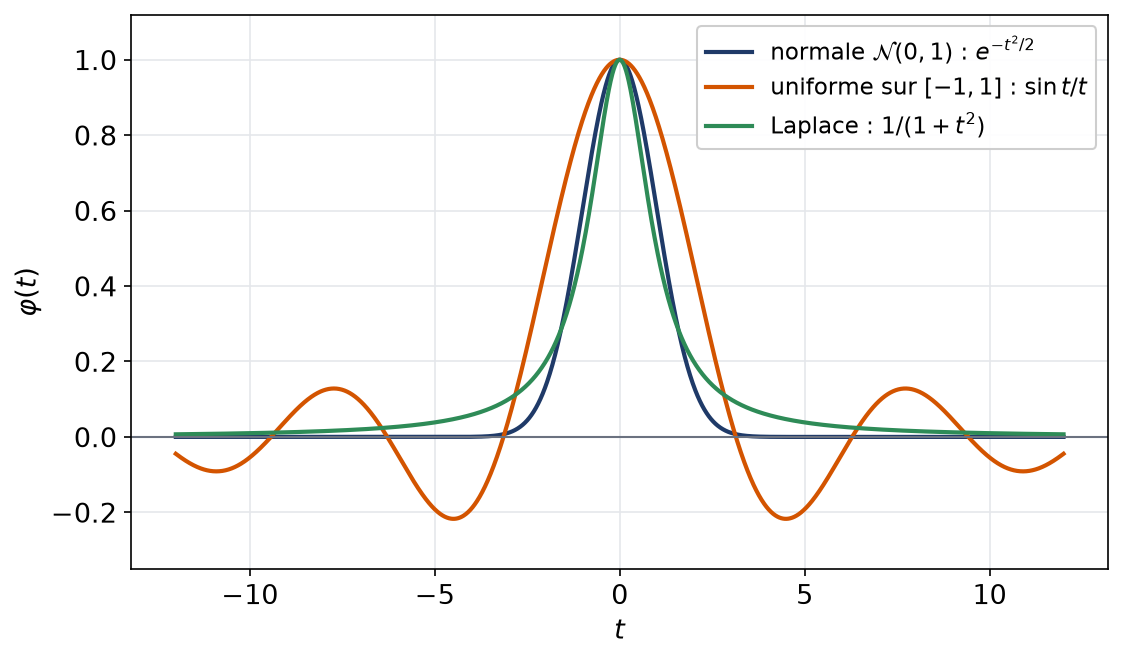
La figure compare trois fonctions caractéristiques réelles. On y voit que la régularité de la loi se traduit par la décroissance à l’infini.
1.3 Moments et unicité
Si \(\mathbb{E}[|X|^n] < +\infty\), alors \(\varphi_X\) est de classe \(C^n\) et \(\varphi_X^{(k)}(0) = i^k\,\mathbb{E}[X^k]\) pour \(0 \leq k \leq n\). En particulier, si \(X\) admet une variance, \(\varphi_X(t) = 1 + it\,\mathbb{E}[X] – \frac{t^2}{2}\mathbb{E}[X^2] + o(t^2)\).
La preuve consiste à dériver \(k\) fois sous l’espérance, la domination étant assurée par \(|X|^k\). Par ailleurs, la fonction caractéristique détermine la loi.
Théorème d’unicité : si \(\varphi_X = \varphi_Y\), alors \(X\) et \(Y\) ont la même loi. Le résultat vaut aussi pour les vecteurs aléatoires.
Nous admettons ce résultat, qui repose sur une formule d’inversion de Fourier. En pratique, il permet d’identifier une loi : si l’on reconnaît la fonction caractéristique, on reconnaît la loi.
Piège à éviter :
La relation \(\varphi_{X + Y} = \varphi_X\varphi_Y\) ne caractérise pas l’indépendance. Par exemple, si \(X\) suit une loi de Cauchy, de fonction caractéristique \(e^{-|t|}\), alors \(\varphi_{2X}(t) = e^{-2|t|} = \varphi_X(t)^2\). Pourtant, \(X\) n’est évidemment pas indépendante d’elle-même.
2. Vecteurs gaussiens
Un vecteur dont chaque composante est gaussienne n’a aucune raison d’avoir une structure simple. La bonne définition porte donc sur toutes les combinaisons linéaires.
Un vecteur aléatoire \(X\) de \(\mathbb{R}^d\) est gaussien si, pour tout \(u \in \mathbb{R}^d\), la variable réelle \(\langle u, X\rangle\) suit une loi normale, éventuellement dégénérée (une constante est vue comme une gaussienne de variance nulle).
Soit \(m = \mathbb{E}[X]\) et \(\Gamma\) la matrice de covariance. Alors \(\langle u, X\rangle\) suit la loi \(\mathcal{N}(\langle u, m\rangle, u^{\top}\Gamma u)\). En évaluant sa fonction caractéristique en \(1\), on obtient le résultat suivant.
Un vecteur \(X\) est gaussien si et seulement si \(\varphi_X(u) = \exp\left(i\langle u, m\rangle – \tfrac{1}{2}u^{\top}\Gamma u\right)\) pour tout \(u\). Sa loi est donc déterminée par \(m\) et \(\Gamma\), et l’on note \(X \sim \mathcal{N}_d(m, \Gamma)\). Si \(\Gamma\) est inversible, \(X\) admet la densité \(x \mapsto (2\pi)^{-d/2}(\det \Gamma)^{-1/2}\exp\left(-\tfrac{1}{2}(x – m)^{\top}\Gamma^{-1}(x – m)\right)\).
De plus, si \(A\) est une matrice de taille \(k \times d\), alors \(AX\) est encore gaussien, de loi \(\mathcal{N}_k(Am, A\Gamma A^{\top})\). C’est la propriété la plus utilisée en pratique.
Les composantes d’un vecteur gaussien sont indépendantes si et seulement si sa matrice de covariance est diagonale.
Si \(\Gamma\) est diagonale, la forme quadratique \(u^{\top}\Gamma u\) se sépare en \(\sum_k \Gamma_{kk}u_k^2\). Par conséquent, \(\varphi_X(u)\) est le produit des fonctions caractéristiques des composantes. Par unicité, la loi de \(X\) est la loi produit, ce qui est l’indépendance. La réciproque vient de ce que des variables indépendantes de carré intégrable ont une covariance nulle.
Soit \(X, Y\) indépendantes de loi \(\mathcal{N}(0, 1)\), puis \(U = 3X + 4Y\) et \(V = 4X – 3Y\). Le couple \((U, V)\) est l’image du vecteur gaussien \((X, Y)\) par une application linéaire, donc il est gaussien. Ensuite, \(\operatorname{Var}(U) = 9 + 16 = 25\), \(\operatorname{Var}(V) = 16 + 9 = 25\) et \(\operatorname{Cov}(U, V) = 12 – 12 = 0\). Par conséquent, \(U\) et \(V\) sont indépendantes, toutes deux de loi \(\mathcal{N}(0, 25)\).
Deux variables gaussiennes non corrélées ne sont pas forcément indépendantes. Soit \(X \sim \mathcal{N}(0, 1)\) et \(\varepsilon\) indépendante de \(X\), uniforme sur \(\{-1, 1\}\). On pose \(Y = \varepsilon X\). Par symétrie, \(Y\) suit aussi la loi \(\mathcal{N}(0, 1)\), et \(\operatorname{Cov}(X, Y) = \mathbb{E}[\varepsilon]\,\mathbb{E}[X^2] = 0\). Pourtant, \(|X| = |Y|\), ce qui interdit l’indépendance. Le couple \((X, Y)\) n’est donc pas gaussien : d’ailleurs, \(X + Y\) vaut \(0\) avec probabilité \(1/2\).
3. Les quatre modes de convergence
Soit \((X_n)\) une suite de variables aléatoires et \(X\) une variable aléatoire. Les trois premiers modes exigent que toutes les variables soient définies sur le même espace. Le quatrième ne fait intervenir que les lois.
3.1 Définitions
- \(X_n \to X\) presque sûrement si \(\mathbb{P}(\{\omega : X_n(\omega) \to X(\omega)\}) = 1\).
- \(X_n \to X\) en probabilité si, pour tout \(\varepsilon > 0\), \(\mathbb{P}(|X_n – X| > \varepsilon) \to 0\).
- \(X_n \to X\) dans \(L^p\), pour \(p \geq 1\), si \(\mathbb{E}[|X_n – X|^p] \to 0\).
- \(X_n \to X\) en loi si \(\mathbb{E}[f(X_n)] \to \mathbb{E}[f(X)]\) pour toute fonction \(f\) continue et bornée.
La convergence en loi équivaut à la convergence \(F_{X_n}(x) \to F_X(x)\) en tout point \(x\) où la fonction de répartition \(F_X\) est continue.
Nous admettons cette équivalence. Elle explique pourquoi on exclut les points de discontinuité. Par exemple, la suite constante \(X_n = 1/n\) converge en loi vers \(0\), alors que \(F_{X_n}(0) = 0\) ne tend pas vers \(F_0(0) = 1\).
3.2 Liens entre les convergences
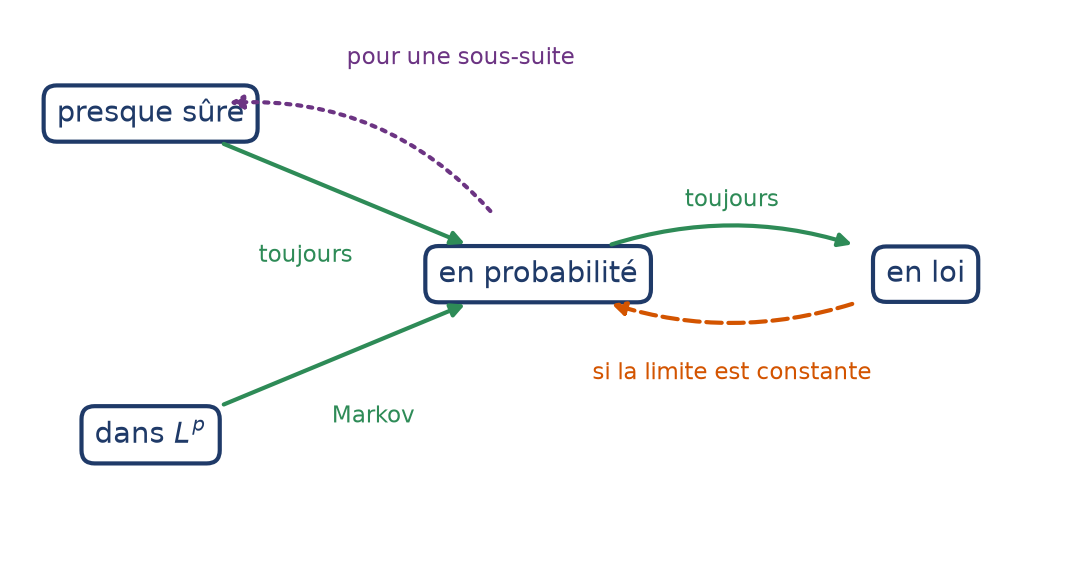
Le schéma suivant résume les implications démontrées dans cette partie. Les flèches pleines sont toujours valables, tandis que les flèches en pointillés demandent une hypothèse ou un passage à une sous-suite.
Soit \((X_n)\) et \(X\) définies sur un même espace.
- Si \(X_n\) tend vers \(X\) presque sûrement, elle y tend aussi en probabilité.
- Une limite dans \(L^p\) est aussi une limite en probabilité.
- Toute limite en probabilité est encore une limite en loi.
- Si \(X_n \to X\) en probabilité, on peut extraire une sous-suite qui tend vers \(X\) presque sûrement.
- Lorsque la limite en loi est une constante \(c\), la suite tend vers \(c\) en probabilité.
Pour le point 1, la variable \(\mathbf{1}_{\{|X_n – X| > \varepsilon\}}\) tend vers \(0\) presque sûrement et reste bornée par \(1\). La convergence dominée donne donc la limite de sa probabilité. Le point 2 découle de l’inégalité de Markov : \(\mathbb{P}(|X_n – X| > \varepsilon) \leq \varepsilon^{-p}\,\mathbb{E}[|X_n – X|^p]\). Pour le point 3, soit \(f\) continue bornée et \(\eta > 0\). On choisit un compact \([-K, K]\) tel que \(\mathbb{P}(|X| > K) < \eta\), sur lequel \(f\) est uniformément continue. On découpe alors \(\mathbb{E}[|f(X_n) – f(X)|]\) selon que \(|X_n – X|\) est petit ou non, et selon que \(|X| \leq K\) ou non. Chaque morceau est inférieur à un multiple de \(\eta\) pour \(n\) grand.
Le point 4 se démontre avec le premier lemme de Borel-Cantelli, présenté en partie 4. On choisit \(n_k\) tel que \(\mathbb{P}(|X_{n_k} – X| > 2^{-k}) \leq 2^{-k}\). La série de ces probabilités converge, donc presque sûrement \(|X_{n_k} – X| \leq 2^{-k}\) à partir d’un certain rang. Le point 5 est traité en exercice.
3.3 Contre-exemples
Aucune autre implication n’est vraie en général. Les trois exemples suivants servent de référence.
Presque sûre sans \(L^1\). Sur \(]0, 1]\) muni de la mesure de Lebesgue, on pose \(X_n = n^2\,\mathbf{1}_{]0, 1/n]}\). Pour tout \(\omega\), on a \(X_n(\omega) = 0\) dès que \(n > 1/\omega\), donc \(X_n \to 0\) partout. Cependant, \(\mathbb{E}[X_n] = n\) tend vers l’infini.
En probabilité sans presque sûre. Soit \(X_n\) indépendantes de loi de Bernoulli de paramètre \(1/n\). D’abord, \(\mathbb{P}(|X_n| > \varepsilon) \leq 1/n\), donc \(X_n \to 0\) en probabilité et même dans \(L^p\). Ensuite, la série \(\sum 1/n\) diverge et les événements \(\{X_n = 1\}\) sont indépendants. Le second lemme de Borel-Cantelli montre alors que \(X_n = 1\) pour une infinité de \(n\), presque sûrement. Ainsi, \(X_n\) ne converge presque sûrement pas vers \(0\).
En loi sans probabilité. Soit \(U\) uniforme sur \([-1, 1]\) et \(X_n = (-1)^nU\). Toutes les \(X_n\) ont la loi de \(U\), donc \(X_n \to U\) en loi. Pourtant, \(|X_{2n+1} – U| = 2|U|\), et \(\mathbb{P}(2|U| > 1) = 1/2\) ne tend pas vers \(0\).
Piège à éviter :
Dire « \(X_n\) converge en loi vers \(X\) » ne dit rien des valeurs prises par \(X_n\) et \(X\) sur un même \(\omega\). Par conséquent, la convergence en loi de \(X_n\) vers \(X\) et de \(Y_n\) vers \(Y\) n’entraîne pas celle de \(X_n + Y_n\) vers \(X + Y\). Il faut une information sur la loi du couple.
4. Le lemme de Borel-Cantelli
Pour une suite d’événements \((A_n)\), on note \(\limsup A_n = \bigcap_{n} \bigcup_{k \geq n} A_k\). C’est l’événement « une infinité des \(A_n\) se réalisent ».
Premier lemme : si \(\sum \mathbb{P}(A_n) < +\infty\), alors \(\mathbb{P}(\limsup A_n) = 0\). Second lemme : si les \(A_n\) sont indépendants et si \(\sum \mathbb{P}(A_n) = +\infty\), alors \(\mathbb{P}(\limsup A_n) = 1\).
Pour le premier lemme, on a \(\mathbb{P}(\limsup A_n) \leq \mathbb{P}\left(\bigcup_{k \geq n} A_k\right) \leq \sum_{k \geq n}\mathbb{P}(A_k)\) pour tout \(n\). Ce reste de série convergente tend vers \(0\). Pour le second, on passe au complémentaire. Par indépendance et grâce à l’inégalité \(1 – x \leq e^{-x}\), on obtient pour \(N \geq n\) :
\[\mathbb{P}\left(\bigcap_{k = n}^{N} A_k^c\right) = \prod_{k = n}^{N}\left(1 – \mathbb{P}(A_k)\right) \leq \exp\left(-\sum_{k = n}^{N}\mathbb{P}(A_k)\right).\]
Le majorant tend vers \(0\) quand \(N \to +\infty\). Ainsi, chaque \(\bigcap_{k \geq n} A_k^c\) est négligeable, et leur réunion, qui est le complémentaire de \(\limsup A_n\), l’est aussi.
Pour établir un résultat presque sûr avec Borel-Cantelli :
- traduire l’énoncé en « l’événement \(A_n\) ne se produit qu’un nombre fini de fois » ou « se produit une infinité de fois » ;
- calculer ou majorer \(\mathbb{P}(A_n)\), souvent par Markov ou par une queue de loi explicite ;
- étudier la série \(\sum \mathbb{P}(A_n)\) ;
- si elle diverge, vérifier soigneusement l’indépendance avant d’invoquer le second lemme ;
- pour un paramètre réel, conclure sur une suite dénombrable de valeurs, puis passer à la limite.
Soit \((U_n)\) indépendantes de loi uniforme sur \([0, 1]\). D’une part, \(\mathbb{P}(U_n < 1/n^2) = 1/n^2\), série convergente. Donc presque sûrement \(U_n \geq 1/n^2\) à partir d’un certain rang. D’autre part, \(\mathbb{P}(U_n < 1/n) = 1/n\), série divergente, et les événements sont indépendants. Par conséquent, presque sûrement, \(U_n < 1/n\) pour une infinité d’indices. Les petites valeurs de \(U_n\) descendent donc sous \(1/n\), mais pas sous \(1/n^2\) de façon répétée.
5. Lois des grands nombres
Considérons des variables \(X_1, X_2, \dots\) mutuellement indépendantes et toutes de même loi ; on dit qu’elles sont i.i.d. Leur somme partielle est \(S_n = X_1 + \dots + X_n\), et \(\bar{X}_n = S_n/n\) désigne leur moyenne empirique. D’après les deux théorèmes qui suivent, \(\bar{X}_n\) se rapproche de l’espérance commune \(m\), en des sens différents.
Cette idée formalise une intuition très ancienne : la fréquence d’un événement dans une longue série d’essais indépendants se stabilise autour de sa probabilité. Cependant, le mot « se rapproche » doit être précisé, et c’est tout l’intérêt des modes de convergence vus plus haut. La version faible parle d’une probabilité d’écart, la version forte parle de chaque trajectoire.
5.1 Loi faible
Si les \(X_n\) sont i.i.d. et de carré intégrable, de variance \(\sigma^2\), alors \(\bar{X}_n \to m\) dans \(L^2\), donc en probabilité. Plus précisément, \(\mathbb{P}(|\bar{X}_n – m| \geq \varepsilon) \leq \dfrac{\sigma^2}{n\varepsilon^2}\).
Par indépendance, les covariances croisées sont nulles. Ainsi, \(\operatorname{Var}(S_n) = n\sigma^2\), puis \(\mathbb{E}[(\bar{X}_n – m)^2] = \sigma^2/n\), qui tend vers \(0\). L’inégalité de Bienaymé-Tchebychev donne ensuite la majoration annoncée.
Cette borne est grossière mais explicite. Elle permet par exemple de dimensionner un échantillon sans connaître la loi exacte.
5.2 Loi forte
Loi forte des grands nombres : si les \(X_n\) sont i.i.d. et intégrables, alors \(\bar{X}_n \to \mathbb{E}[X_1]\) presque sûrement.
Nous démontrons ce théorème sous l’hypothèse plus forte \(\mathbb{E}[X_1^4] < +\infty\). Le cas intégrable général est admis : sa preuve utilise une troncature plus technique.
Quitte à remplacer \(X_n\) par \(X_n – m\), on suppose \(m = 0\). On développe \(S_n^4\) : par indépendance, tout terme contenant un \(X_k\) à la puissance \(1\) est d’espérance nulle. Il reste les \(n\) termes \(X_k^4\) et les \(3n(n – 1)\) termes \(X_k^2X_l^2\) avec \(k \neq l\). Ainsi, \(\mathbb{E}[S_n^4] \leq C n^2\) pour une constante \(C\). L’inégalité de Markov donne alors \(\mathbb{P}(|\bar{X}_n| > \varepsilon) \leq \frac{Cn^2}{n^4\varepsilon^4} = \frac{C}{n^2\varepsilon^4}\). Cette série converge. Par le premier lemme de Borel-Cantelli, presque sûrement \(|\bar{X}_n| \leq \varepsilon\) à partir d’un certain rang. Enfin, on prend \(\varepsilon = 1/q\) pour tout entier \(q \geq 1\), ce qui donne une intersection dénombrable d’événements presque sûrs.
Remarque :
L’hypothèse d’intégrabilité ne peut pas être supprimée. Par exemple, la moyenne de variables de Cauchy indépendantes suit encore une loi de Cauchy : elle ne se concentre pas. Nous le vérifions en exercice avec la fonction caractéristique.
6. Théorème de Lévy et théorème central limite
La loi des grands nombres donne la limite de \(\bar{X}_n\). Le théorème central limite précise la taille des fluctuations : elles sont d’ordre \(1/\sqrt{n}\) et ont une forme gaussienne universelle.
6.1 Le théorème de Lévy
Théorème de Lévy : \(X_n \to X\) en loi si et seulement si \(\varphi_{X_n}(t) \to \varphi_X(t)\) pour tout réel \(t\).
Le sens direct est immédiat : pour \(t\) fixé, les fonctions \(x \mapsto \cos(tx)\) et \(x \mapsto \sin(tx)\) sont continues et bornées. Pour la réciproque, on procède en deux étapes, dont nous donnons les grandes lignes. D’abord, la continuité de \(\varphi_X\) en \(0\) et l’inégalité \(\mathbb{P}(|Y| > 2/\delta) \leq \frac{1}{\delta}\int_{-\delta}^{\delta}(1 – \varphi_Y(t))\,dt\) montrent que la masse des \(X_n\) ne s’échappe pas à l’infini. Ensuite, on approche une fonction continue bornée par des combinaisons de fonctions \(e^{itx}\) sur un grand compact, ce qui ramène le problème à la convergence des \(\varphi_{X_n}\).
Il existe une version plus forte du même théorème : si \(\varphi_{X_n}\) converge simplement vers une fonction \(\psi\) continue en \(0\), alors \(\psi\) est la fonction caractéristique d’une loi limite. Elle est utile lorsqu’on ne connaît pas la limite à l’avance.
6.2 Le théorème central limite
Soit \((X_n)\) i.i.d. de carré intégrable, d’espérance \(m\) et de variance \(\sigma^2 > 0\). Alors :
\[\frac{S_n – nm}{\sigma\sqrt{n}} = \sqrt{n}\,\frac{\bar{X}_n – m}{\sigma} \longrightarrow \mathcal{N}(0, 1) \text{ en loi.}\]
On pose \(Y_k = (X_k – m)/\sigma\), centrées réduites, et \(T_n = (Y_1 + \dots + Y_n)/\sqrt{n}\). Par indépendance, \(\varphi_{T_n}(t) = \varphi_Y(t/\sqrt{n})^n\). Le théorème sur les moments donne \(\varphi_Y(s) = 1 – s^2/2 + o(s^2)\). Ensuite, on utilise le lemme élémentaire \(|a^n – b^n| \leq n|a – b|\), valable pour \(|a|, |b| \leq 1\), avec \(a = \varphi_Y(t/\sqrt{n})\) et \(b = 1 – t^2/(2n)\). On obtient \(|a^n – b^n| \leq n \cdot o(1/n)\), qui tend vers \(0\). Or \(b^n = (1 – t^2/(2n))^n \to e^{-t^2/2}\). Ainsi, \(\varphi_{T_n}(t) \to e^{-t^2/2}\), et le théorème de Lévy conclut.
Piège à éviter :
Il ne faut pas écrire \(\varphi_Y(t/\sqrt{n})^n = \exp(n \ln \varphi_Y(t/\sqrt{n}))\) sans précaution, car le logarithme complexe n’est pas défini de façon continue partout. Le lemme sur \(|a^n – b^n|\) évite entièrement cette difficulté.
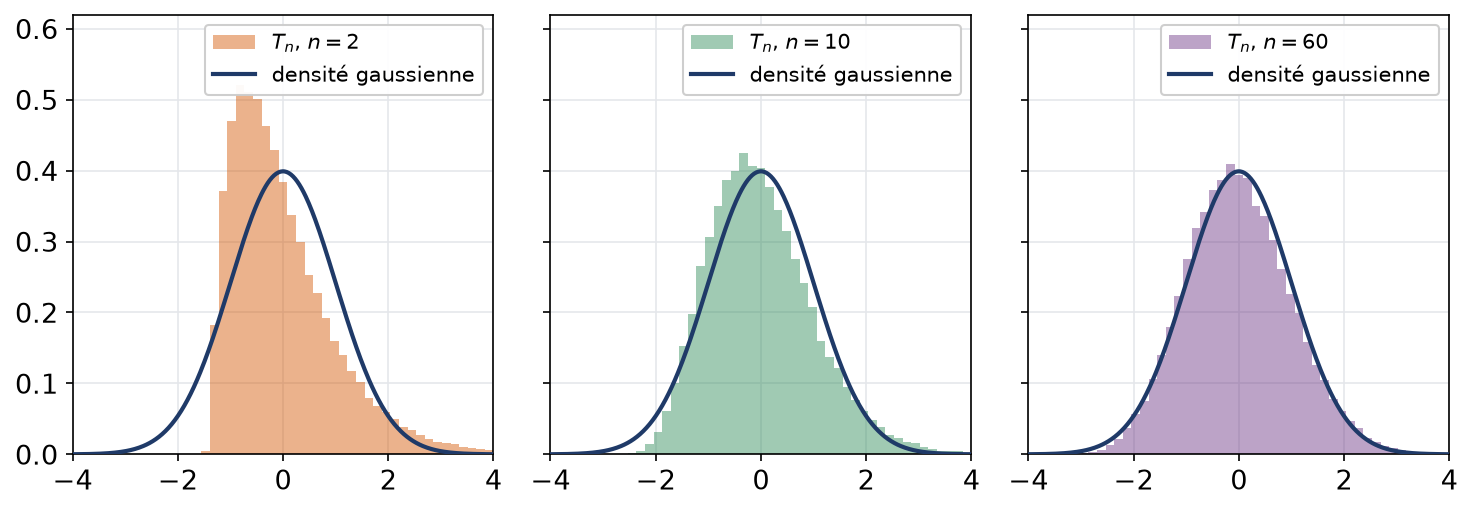
La figure montre l’histogramme de \(T_n\) pour des variables exponentielles, comparé à la densité gaussienne. L’asymétrie de départ s’efface peu à peu quand \(n\) grandit.
Pour approcher une probabilité par le théorème central limite :
- écrire la variable étudiée comme une somme \(S_n\) de variables i.i.d. ;
- calculer \(\mathbb{E}[S_n] = nm\) et \(\operatorname{Var}(S_n) = n\sigma^2\) ;
- centrer et réduire l’événement, puis remplacer la loi de \(T_n\) par \(\mathcal{N}(0, 1)\) ;
- lire la valeur dans la table de la fonction de répartition \(\Phi\) et annoncer clairement qu’il s’agit d’une approximation.
On lance \(720\) fois un dé équilibré et l’on note \(N\) le nombre de six. Alors \(N\) est une somme de \(720\) variables de Bernoulli de paramètre \(1/6\). Ainsi, \(\mathbb{E}[N] = 120\) et \(\operatorname{Var}(N) = 720 \times \frac{1}{6} \times \frac{5}{6} = 100\). On cherche \(\mathbb{P}(N \geq 140)\). Le théorème central limite donne \(\mathbb{P}(N \geq 140) = \mathbb{P}\left(\frac{N – 120}{10} \geq 2\right) \approx 1 – \Phi(2) \approx 0{,}023\). Avoir au moins \(140\) six est donc peu probable, sans être exceptionnel.
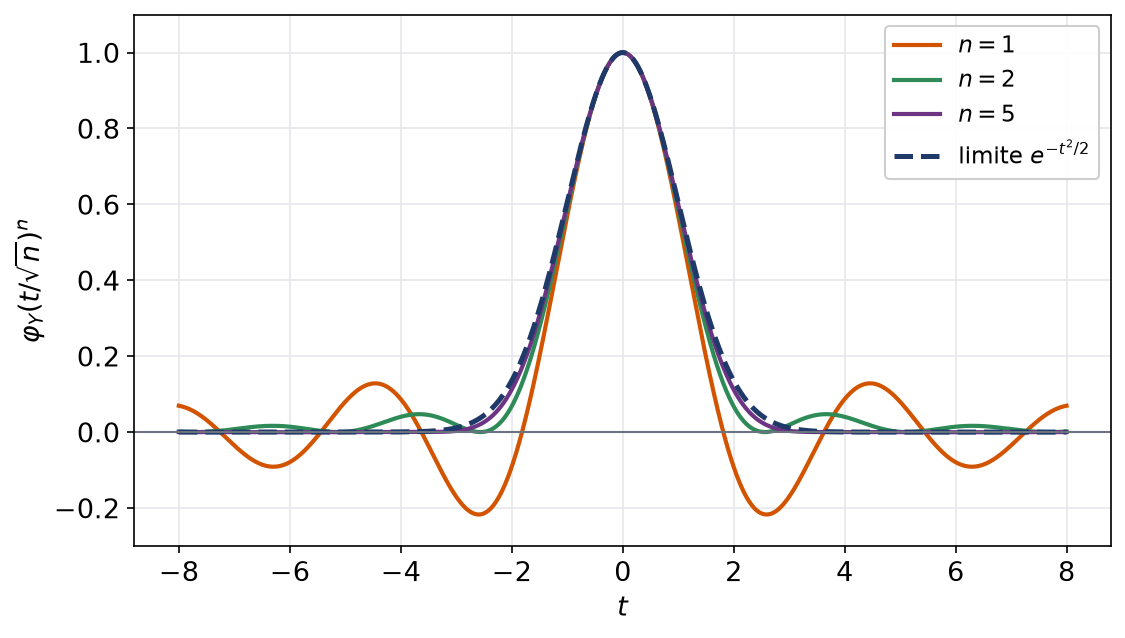
Pour conclure, la figure suivante illustre le mécanisme de la preuve. Elle compare \(\varphi_Y(t/\sqrt{n})^n\) à la limite \(e^{-t^2/2}\) pour une loi uniforme.
Les erreurs fréquentes
- Déduire l’indépendance de deux gaussiennes de leur covariance nulle, sans savoir que le couple est gaussien.
- Invoquer le second lemme de Borel-Cantelli pour des événements qui ne sont pas indépendants.
- Additionner des convergences en loi comme des convergences en probabilité.
- Oublier l’hypothèse de variance finie dans le théorème central limite, ou celle d’intégrabilité dans la loi forte.
- Confondre \(\sqrt{n}(\bar{X}_n – m)\), qui converge en loi, et \(\bar{X}_n – m\), qui tend vers \(0\).
Fiche mémo
- \(\varphi_X(t) = \mathbb{E}[e^{itX}]\) ; indépendance : \(\varphi_{X+Y} = \varphi_X\varphi_Y\) ; \(\varphi_X^{(k)}(0) = i^k\mathbb{E}[X^k]\).
- Lois usuelles : \(\mathcal{N}(m, \sigma^2)\) donne \(e^{imt – \sigma^2t^2/2}\) ; exponentielle \(\lambda/(\lambda – it)\) ; Cauchy \(e^{-|t|}\).
- Vecteur gaussien : toute combinaison linéaire est gaussienne ; loi fixée par \((m, \Gamma)\) ; \(AX \sim \mathcal{N}(Am, A\Gamma A^{\top})\).
- Pour un vecteur gaussien : composantes indépendantes \(\iff\) covariance diagonale.
- Presque sûre \(\Rightarrow\) probabilité \(\Rightarrow\) loi ; \(L^p \Rightarrow\) probabilité ; en loi vers une constante \(\Rightarrow\) en probabilité.
- En probabilité : une sous-suite converge presque sûrement.
- Borel-Cantelli : série convergente \(\Rightarrow\) un nombre fini ; série divergente et indépendance \(\Rightarrow\) une infinité.
- Loi faible : \(\mathbb{P}(|\bar{X}_n – m| \geq \varepsilon) \leq \sigma^2/(n\varepsilon^2)\) ; loi forte : \(\bar{X}_n \to m\) presque sûrement si \(X_1\) est intégrable.
- Lévy : convergence en loi \(\iff\) convergence simple des fonctions caractéristiques.
- TCL : \(\sqrt{n}(\bar{X}_n – m)/\sigma \to \mathcal{N}(0, 1)\) en loi, si la variance est finie et non nulle.
Questions fréquentes
Quelle différence entre convergence en probabilité et convergence en loi ?
La convergence en probabilité compare les variables elles-mêmes, définies sur un même espace. La convergence en loi ne compare que leurs lois : les variables peuvent même vivre sur des espaces différents. C’est pourquoi la seconde est plus faible, sauf lorsque la limite est une constante.
Pourquoi utiliser la fonction caractéristique plutôt que la fonction de répartition ?
La fonction caractéristique d’une somme de variables indépendantes est le produit des fonctions caractéristiques. De plus, elle existe pour toute loi, même sans moment. Le théorème de Lévy permet alors de lire la convergence en loi sur une simple limite de fonctions.
Le théorème central limite s'applique-t-il sans variance finie ?
Non, l’hypothèse de variance finie est indispensable dans la version du cours. Par exemple, la moyenne de variables de Cauchy indépendantes suit encore une loi de Cauchy, sans se rapprocher d’une gaussienne. D’autres théorèmes limites existent alors, avec des lois stables.
Quand faut-il utiliser le second lemme de Borel-Cantelli ?
On l’utilise pour montrer qu’un événement se produit une infinité de fois presque sûrement. Il exige l’indépendance des événements et une série de probabilités divergente. Sans indépendance, la divergence de la série ne suffit pas.
Pour aller plus loin
- S’exercer : exercices corrigés de L3 de maths sur convergence en loi et TCL
- Bases utiles : Loi, espérance et indépendance en théorie de la mesure
- Chapitre d’avant : Loi, espérance et indépendance en théorie de la mesure
- Vérifier ses acquis : QCM de L3 de maths sur convergence en loi et TCL
- Contrôle corrigé en temps limité : Examen final de probabilités : contrôle de maths en L3
- Tous les chapitres : le sommaire de la L3 de maths
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «convergence en loi et TCL en L3 de maths : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.