Matrices symétriques réelles en maths spé (MP) : cours et méthodes

Ce chapitre sur les matrices symétriques MP réunit trois outils qui reviennent à chaque session de concours : l’adjoint d’un endomorphisme, le théorème spectral et les matrices positives. Il arrive au second semestre, juste après les espaces préhilbertiens et les isométries. Vous y trouverez les preuves essentielles, mais surtout les gestes qui font gagner du temps devant un examinateur.
Le parcours s’ouvre sur l’adjoint et sur le transfert d’un sous-espace invariant à son orthogonal. Ensuite, nous caractérisons les projecteurs orthogonaux, puis nous démontrons le théorème spectral avec une méthode de diagonalisation en base orthonormée. Enfin, la positivité et le quotient de Rayleigh ferment le chapitre. Ces notions préparent directement le calcul différentiel, en particulier l’étude des points critiques par la hessienne, ainsi que de nombreux problèmes d’écrit.
Ce que vous saurez faire
- Calculer l’adjoint d’un endomorphisme et écrire sa matrice dans une base orthonormée.
- Transférer une stabilité d’un endomorphisme à son adjoint par passage à l’orthogonal.
- Reconnaître un projecteur orthogonal grâce au caractère autoadjoint.
- Construire rapidement une matrice de passage orthogonale qui rend diagonale une matrice symétrique.
- Prouver qu’une matrice symétrique est positive ou définie positive par plusieurs voies.
- Encadrer un quotient de Rayleigh par les valeurs propres extrêmes.
1. L’adjoint d’un endomorphisme
Ici, \(E\) est toujours un \(\mathbf{R}\)-espace vectoriel de dimension \(n \geqslant 1\), équipé d’un produit scalaire noté avec des crochets. L’idée de l’adjoint est simple. On cherche à déplacer un endomorphisme de la gauche vers la droite du crochet. Ce geste revient sans cesse à l’oral, et il évite beaucoup de calculs en coordonnées.
1.1 Existence et unicité
Le point de départ est le théorème de représentation : toute forme linéaire \(\varphi\) sur \(E\) s’écrit \(\varphi = \langle a, \cdot \rangle\) pour un unique vecteur \(a\). Nous l’appliquons à une forme linéaire bien choisie.
À chaque \(u \in \mathcal{L}(E)\) correspond un seul \(u^{*} \in \mathcal{L}(E)\), nommé adjoint de \(u\), qui vérifie \[\langle u(x), y \rangle = \langle x, u^{*}(y) \rangle \quad \text{pour tous } x, y \text{ de } E.\]
Fixons \(y \in E\). La forme \(\ell_y : x \mapsto \langle u(x), y \rangle\) est linéaire. Par le théorème de représentation, elle s’écrit \(\langle \cdot, z \rangle\) pour un unique \(z\), que nous notons \(u^{*}(y)\). Ensuite, la linéarité de \(u^{*}\) découle de l’unicité. En effet, \(\lambda u^{*}(y) + u^{*}(y^{\prime})\) convient pour représenter la forme associée à \(\lambda y + y^{\prime}\). Enfin, deux endomorphismes vérifiant la relation coïncident, car un vecteur orthogonal à tout \(E\) est nul.
Les règles de calcul suivent directement de l’unicité. On les utilise sans les redémontrer.
Pour \(u, v \in \mathcal{L}(E)\) et \(\lambda \in \mathbf{R}\) : \((u+\lambda v)^{*} = u^{*} + \lambda v^{*}\), \((u \circ v)^{*} = v^{*} \circ u^{*}\), \((u^{*})^{*} = u\) et l’identité est son propre adjoint. Enfin, l’adjoint d’un automorphisme \(u\) est encore un automorphisme, d’inverse l’adjoint de \(u^{-1}\).
Dans \(\mathbf{R}^n\) muni du produit scalaire canonique, fixons deux vecteurs \(a\) et \(b\). Posons \(u(x) = \langle a, x \rangle \, b\), un endomorphisme de rang au plus 1. Pour tous \(x, y\), on obtient \[\langle u(x), y \rangle = \langle a, x \rangle \langle b, y \rangle = \langle x, \langle b, y \rangle a \rangle.\] Par conséquent, \(u^{*}(y) = \langle b, y \rangle \, a\). Autrement dit, l’adjoint échange simplement les rôles de \(a\) et \(b\). Ainsi, \(u\) est égal à son adjoint dès que \(b\) est colinéaire à \(a\).
1.2 Matrice de l’adjoint en base orthonormée
Le calcul pratique passe par les matrices. Cependant, une hypothèse sur la base est indispensable.
Fixons une base \(\mathcal{B}\) orthonormée. Si \(u\) y est représenté par \(A\), son adjoint y est représenté par la transposée \(A^{T}\).
Notons \(X\) et \(Y\) les colonnes de coordonnées de \(x\) et \(y\), et \(B\) la matrice de \(u^{*}\). Comme la base est orthonormée, \(\langle x, y \rangle = X^{T} Y\). La relation d’adjonction devient \((AX)^{T} Y = X^{T} B Y\), soit \(X^{T} A^{T} Y = X^{T} B Y\) pour toutes colonnes. En prenant pour \(X\) et \(Y\) les colonnes de la base canonique, on lit coefficient par coefficient que \(B = A^{T}\).
Piège à éviter :
Sans base orthonormée, la transposée ne convient plus. Lorsque \(G\) désigne la matrice de Gram du produit scalaire, le même calcul fournit \(B = G^{-1} A^{T} G\). En colle, l’examinateur choisit souvent un produit scalaire non canonique pour tester ce réflexe. Avant d’écrire une transposée, on vérifie donc toujours que la base est orthonormée.
Le cas des matrices carrées mérite un mot. Sur \(\mathcal{M}_n(\mathbf{R})\), le produit scalaire usuel est \(\langle A, B \rangle = \mathrm{tr}(A^{T} B)\). Les adjoints s’y calculent par la trace, sans coordonnées. Nous laissons ce point à l’entraînement, car il donne un excellent exercice.
1.3 Orthogonal d’un sous-espace stable
Voici le résultat le plus utilisé à l’oral sur l’adjoint. Il transforme un problème de stabilité en un autre, souvent plus facile.
Pour \(u \in \mathcal{L}(E)\) et \(F\) sous-espace de \(E\) : la stabilité de \(F\) sous \(u\) entraîne celle de \(F^{\perp}\) sous \(u^{*}\). En appliquant ce résultat à \(u^{*}\) et à \(F^{\perp}\), on obtient même une équivalence.
Soit \(y \in F^{\perp}\) et \(x \in F\). D’abord, \(u(x) \in F\) par stabilité. Ensuite, \(\langle x, u^{*}(y) \rangle = \langle u(x), y \rangle = 0\). Donc \(u^{*}(y)\) est orthogonal à tout vecteur de \(F\), c’est-à-dire \(u^{*}(y) \in F^{\perp}\).
Pour trouver les hyperplans stables par \(u\), on procède ainsi :
- on écrit l’hyperplan \(H = a^{\perp}\) avec \(a \neq 0\) ;
- par la proposition, l’invariance de \(H\) sous \(u\) revient à celle de la droite \(\mathbf{R} a\) sous \(u^{*}\) ;
- on cherche donc les vecteurs propres de \(A^{T}\), où \(A\) est la matrice de \(u\) en base orthonormée ;
- chaque droite propre de \(A^{T}\) fournit un hyperplan stable, d’équation \(a^{T} X = 0\).
Cette méthode remplace la recherche d’un plan stable en dimension 3 par une simple recherche de vecteurs propres. C’est pourquoi elle fait gagner un temps précieux.
2. Endomorphismes autoadjoints et projecteurs orthogonaux
Parmi tous les endomorphismes, ceux qui coïncident avec leur adjoint jouent un rôle central. Ils correspondent exactement aux matrices symétriques, à condition de travailler en base orthonormée.
2.1 Définition et traduction matricielle
On appelle autoadjoint, ou symétrique, tout \(u \in \mathcal{L}(E)\) égal à son adjoint. Concrètement, \(u\) peut alors changer de côté dans le crochet : \[\langle u(x), y \rangle = \langle x, u(y) \rangle \quad \text{quels que soient } x \text{ et } y.\] Leur ensemble est noté \(\mathcal{S}(E)\).
Dans n’importe quelle base orthonormée, \(u\) est autoadjoint exactement quand sa matrice est symétrique. Par suite, \(\mathcal{S}(E)\) est un sous-espace vectoriel de dimension \(\frac{n(n+1)}{2}\).
Par exemple, l’homothétie de rapport \(\lambda\) est autoadjointe. En revanche, une rotation d’angle \(\theta \notin \pi\mathbf{Z}\) du plan ne l’est pas, puisque sa matrice n’est pas symétrique. De plus, la composée demande de la prudence. Pour deux endomorphismes autoadjoints, l’adjoint de \(u \circ v\) est \(v \circ u\). La composée n’est donc autoadjointe que lorsque les deux facteurs commutent.
2.2 Projecteurs orthogonaux
Un projecteur \(p\) vérifie \(p \circ p = p\). Son image et son noyau sont alors supplémentaires dans \(E\). On parle de projecteur orthogonal lorsque, en plus, ils sont orthogonaux. La figure suivante compare les deux situations pour un même vecteur \(x\).
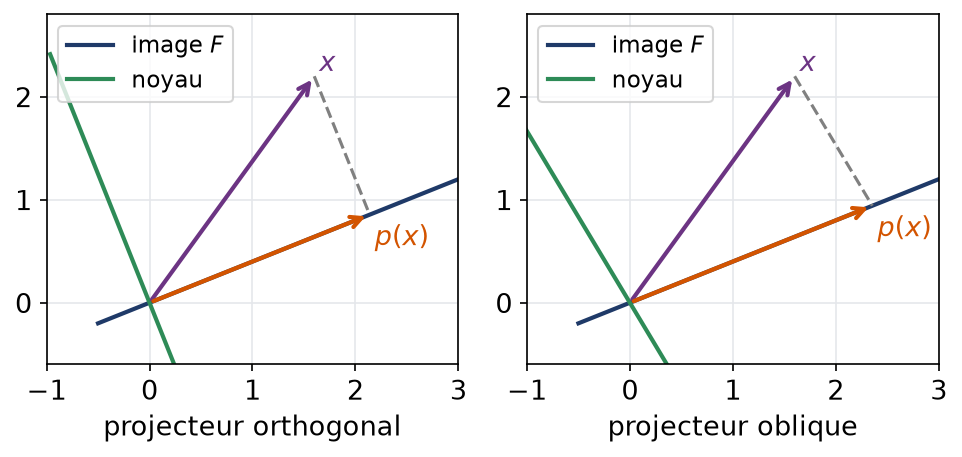
Pour un projecteur \(p\) de \(E\), les deux propriétés « \(\ker p \perp \mathrm{Im}\, p\) » et « \(p^{*} = p\) » sont équivalentes.
Supposons d’abord \(\ker p \perp \mathrm{Im}\, p\). Prenons \(x, y \in E\). Le vecteur \(x – p(x)\) appartient au noyau, donc il est orthogonal à \(p(y)\). Il reste \(\langle x, p(y) \rangle = \langle p(x) + x – p(x), p(y) \rangle\), qui se réduit au produit scalaire de \(p(x)\) et \(p(y)\). En échangeant \(x\) et \(y\), on trouve la même valeur pour \(\langle p(x), y \rangle\). Ainsi, \(p\) est autoadjoint.
Réciproquement, supposons \(p^{*} = p\). Soit \(a \in \mathrm{Im}\, p\) et \(b \in \ker p\). Comme \(a = p(a)\), on obtient \(\langle a, b \rangle = \langle p(a), b \rangle = \langle a, p(b) \rangle = 0\). Par conséquent, le noyau et l’image sont orthogonaux.
Si \((e_1, \dots, e_r)\) est une base orthonormée de \(F\), le projecteur orthogonal sur \(F\) s’écrit \(p_F(x) = \sum_{k=1}^{r} \langle e_k, x \rangle e_k\). Matriciellement, pour une droite dirigée par un vecteur unitaire \(e\), on obtient \(P = e\,e^{T}\). Pour l’hyperplan \(e^{\perp}\), on obtient \(I_n – e\,e^{T}\).
Le même critère vaut pour les symétries. On écrit \(s = 2p – \mathrm{id}_E\), où \(p\) est un projecteur. Or \(s^{*} = s\) équivaut à \(p^{*} = p\). Une symétrie est donc orthogonale exactement quand elle coïncide avec son adjointe.
Piège à éviter :
Une matrice symétrique n’est pas forcément un projecteur, et un projecteur n’est pas forcément symétrique. Par exemple, \(\begin{pmatrix} 1 & 1 \\ 0 & 0 \end{pmatrix}\) vérifie \(P^2 = P\) sans être symétrique. Il s’agit donc d’une projection oblique. Pour conclure à un projecteur orthogonal, on vérifie toujours les deux conditions \(P^2 = P\) et \(P^{T} = P\).
3. Le théorème spectral pour les matrices symétriques réelles
Nous arrivons au résultat phare du chapitre. Il affirme qu’un endomorphisme autoadjoint se diagonalise, et même dans une base orthonormée. La démonstration repose sur trois lemmes courts.
3.1 Trois lemmes préparatoires
Le polynôme caractéristique d’une matrice symétrique réelle n’a que des racines réelles. Il est donc scindé sur \(\mathbf{R}\).
Prenons une racine complexe \(\lambda\) du polynôme caractéristique et une colonne complexe \(Z \neq 0\) avec \(SZ = \lambda Z\). Le nombre \(c = \overline{Z}^{T} S Z\) se calcule en regroupant à droite : \(c = \lambda \, \overline{Z}^{T} Z\). On peut aussi regrouper à gauche. Puisque \(S^{T} = S = \overline{S}\), la ligne \(\overline{Z}^{T} S\) est la conjuguée transposée de \(SZ\), soit \(\overline{\lambda} \, \overline{Z}^{T}\). Ainsi, \(c = \overline{\lambda} \, \overline{Z}^{T} Z\). Le facteur \(\overline{Z}^{T} Z\), somme des carrés des modules des \(z_k\), ne s’annule pas. On conclut que \(\lambda\) est égal à son conjugué.
Pour \(u\) autoadjoint, des vecteurs propres rattachés à deux valeurs propres différentes sont toujours orthogonaux.
Supposons \(u(x) = \lambda x\) et \(u(y) = \mu y\), où \(\lambda \neq \mu\). Le nombre \(\langle u(x), y \rangle\) vaut \(\lambda\) fois \(\langle x, y \rangle\). Comme \(u\) est autoadjoint, il vaut aussi \(\langle x, u(y) \rangle\), c’est-à-dire \(\mu\) fois \(\langle x, y \rangle\). Les deux coefficients étant différents, le produit scalaire de \(x\) et \(y\) est forcément nul.
Soit \(u\) autoadjoint et \(F\) un sous-espace que \(u\) laisse invariant. Alors \(u\) laisse aussi \(F^{\perp}\) invariant, et sa restriction à \(F^{\perp}\) reste autoadjointe.
Ce dernier lemme découle du paragraphe 1.3, appliqué avec \(u^{*} = u\). Quant à la restriction, elle hérite de l’égalité \(\langle u(x), y \rangle = \langle x, u(y) \rangle\), puisque celle-ci vaut déjà pour tous les vecteurs de \(E\).
3.2 Le résultat central et sa preuve
(Théorème spectral.) Tout endomorphisme autoadjoint \(u\) de \(E\) se diagonalise dans une base orthonormée. De façon équivalente, les sous-espaces propres de \(u\) sont deux à deux orthogonaux et leur somme remplit \(E\).
Lecture matricielle : une matrice symétrique réelle \(S\) s’écrit \(P D P^{T}\), avec \(P\) orthogonale et \(D\) diagonale à coefficients réels.
On procède par récurrence sur la dimension. En dimension 1, un vecteur de norme 1 suffit. Passons de \(n – 1\) à \(n\). La matrice de \(u\) dans une base orthonormée est symétrique réelle, donc le premier lemme fournit une racine réelle \(\lambda\) de \(\chi_u\). On choisit alors \(e_1\), vecteur propre de norme 1 pour \(\lambda\). Puisque \(\mathbf{R} e_1\) est invariante, le troisième lemme s’applique à l’hyperplan \(H = e_1^{\perp}\) : il est invariant et \(u\) y induit un endomorphisme autoadjoint. Dans \(H\), de dimension \(n – 1\), on dispose par hypothèse d’une base orthonormée \((e_2, \dots, e_n)\) qui diagonalise cet induit. En ajoutant \(e_1\), on obtient la base cherchée pour \(E\).
La réciproque est immédiate. Si \(S = P D P^{T}\) avec \(P\) orthogonale, alors \(S^{T} = P D^{T} P^{T} = S\). Ainsi, parmi les matrices réelles, les matrices orthogonalement diagonalisables sont exactement les matrices symétriques.
Remarque :
Le théorème est propre au cas réel. Par exemple, la matrice complexe \(\begin{pmatrix} 1 & \mathrm{i} \\ \mathrm{i} & -1 \end{pmatrix}\) est symétrique, mais son carré est nul. Elle est donc nilpotente non nulle, et pas diagonalisable. À l’oral, citer ce contre-exemple montre que l’on a compris où sert l’hypothèse « réelle ».
3.3 Diagonaliser en base orthonormée
Le théorème garantit l’existence. En pratique, on construit la matrice de passage avec une méthode fiable, qui évite de calculer un inverse.
- On calcule le spectre de \(S\), en cherchant d’abord une structure (matrice de rang 1, somme \(aI_n + bJ\), lignes de même somme).
- Pour chaque valeur propre, on détermine une base du sous-espace propre.
- Dans chaque sous-espace propre de dimension au moins 2, on orthonormalise par Gram-Schmidt.
- Pour les valeurs propres simples, il suffit de normer : l’orthogonalité entre sous-espaces distincts est automatique.
- On range les vecteurs en colonnes dans \(P\), qui est orthogonale. Ainsi, \(P^{-1} = P^{T}\) et \(S = P D P^{T}\).
Diagonalisons \(S = \begin{pmatrix} 5 & -2 & -2 \\ -2 & 5 & -2 \\ -2 & -2 & 5 \end{pmatrix}\). Notons \(J\) la matrice d’ordre 3 remplie de 1 ; alors \(S = 7 I_3 – 2J\). Le noyau de \(J\) est un plan, et \(J\) multiplie \((1,1,1)\) par 3. Le spectre de \(J\) se réduit donc à 0, double, et 3, simple. Par conséquent, \(S\) admet la valeur propre \(7 – 6 = 1\), simple, et la valeur propre 7, double.
Le sous-espace propre pour 1 est la droite dirigée par \((1,1,1)\). Celui pour 7 est le plan \(x + y + z = 0\), qui en est l’orthogonal. Dans ce plan, on choisit \((1,-1,0)\), puis un vecteur orthogonal, par exemple \((1,1,-2)\). Après normalisation, on obtient \[P = \begin{pmatrix} \frac{1}{\sqrt{3}} & \frac{1}{\sqrt{2}} & \frac{1}{\sqrt{6}} \\ \frac{1}{\sqrt{3}} & -\frac{1}{\sqrt{2}} & \frac{1}{\sqrt{6}} \\ \frac{1}{\sqrt{3}} & 0 & -\frac{2}{\sqrt{6}} \end{pmatrix}, \qquad D = \mathrm{diag}(1, 7, 7).\] On conclut que \(S = P D P^{T}\), avec \(P\) orthogonale.
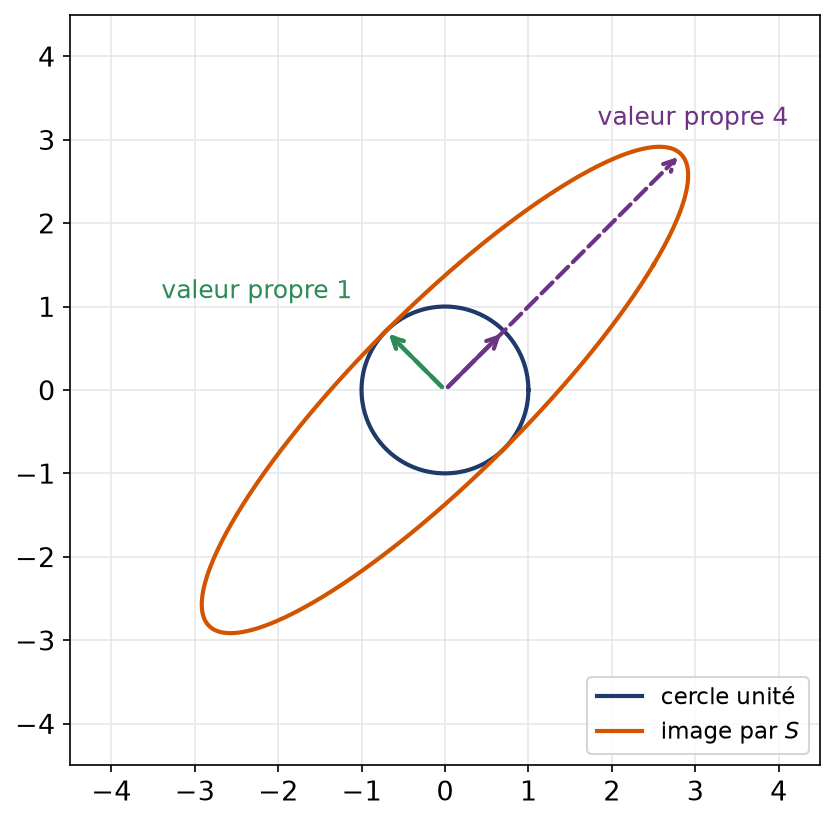
Le théorème a aussi une lecture géométrique. Sous l’action d’une matrice symétrique inversible du plan, le cercle unité devient une ellipse. De plus, ses axes suivent les directions propres, et les demi-axes valent les valeurs propres en valeur absolue. La figure montre le cas de \(\begin{pmatrix} 5/2 & 3/2 \\ 3/2 & 5/2 \end{pmatrix}\), de valeurs propres 4 et 1.
Piège à éviter :
Dans un sous-espace propre de dimension 2, deux vecteurs propres pris au hasard ne sont pas orthogonaux. Par exemple, \((1,-1,0)\) et \((1,0,-1)\) sont tous deux dans le plan \(x+y+z=0\), mais leur produit scalaire vaut 1. Il faut donc orthonormaliser à l’intérieur de chaque sous-espace propre.
4. Matrices positives et définies positives
La positivité est le second grand thème des sujets. Elle relie la forme quadratique \(X \mapsto X^{T} S X\) au signe des valeurs propres.
4.1 Définitions
Une matrice symétrique réelle \(S\) est positive lorsque le nombre \(X^{T} S X\) est toujours positif ou nul. Elle est définie positive lorsque, en outre, ce nombre ne s’annule qu’en \(X = 0\). Ces deux familles forment \(\mathcal{S}_n^{+}(\mathbf{R})\) et \(\mathcal{S}_n^{++}(\mathbf{R})\).
De même, \(u \in \mathcal{S}(E)\) est positif si \(\langle u(x), x \rangle \geqslant 0\) pour tout \(x\), et défini positif si l’inégalité est stricte pour \(x \neq 0\).
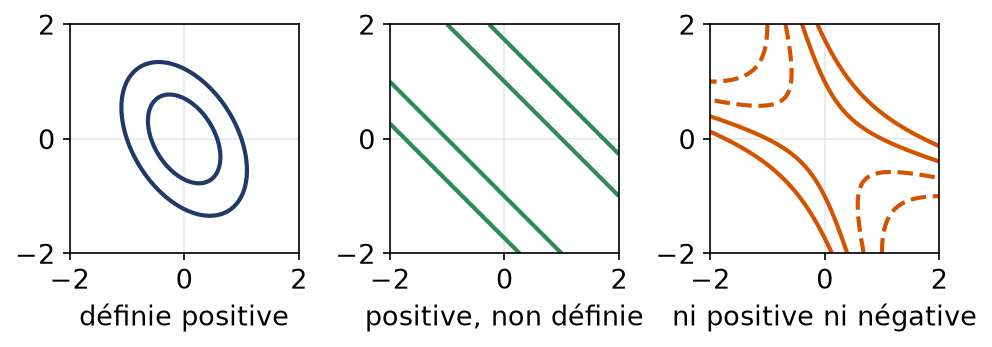
Trois formes quadratiques du plan sont comparées ci-après, à travers leurs courbes de niveau. Pour une matrice définie positive, on obtient des ellipses. Dans le cas positif non défini, ce sont des droites parallèles. Enfin, sans signe constant, apparaissent des hyperboles.
4.2 Le signe se lit sur le spectre
Une matrice symétrique réelle est positive exactement quand toutes ses valeurs propres sont positives ou nulles. Elle est définie positive exactement quand elles sont toutes strictement positives.
Écrivons \(S = P D P^{T}\) avec \(P\) orthogonale et \(D = \mathrm{diag}(\lambda_1, \dots, \lambda_n)\). Pour \(X \in \mathbf{R}^n\), posons \(Y = P^{T} X\). Alors \[X^{T} S X = Y^{T} D Y = \sum_{k=1}^{n} \lambda_k y_k^2.\] Des \(\lambda_k\) tous positifs rendent cette somme positive. Pour la réciproque, on teste la forme sur la \(k\)-ième colonne de \(P\), qui est de norme 1 : elle renvoie exactement \(\lambda_k\). Pour la version stricte, il suffit d’ajouter que \(Y\) est nul seulement quand \(X\) l’est.
On en déduit des conséquences rapides. Une matrice de \(\mathcal{S}_n^{++}(\mathbf{R})\) est inversible, de déterminant et de trace strictement positifs. De plus, ses coefficients diagonaux sont strictement positifs, puisque \(s_{ii} = E_i^{T} S E_i\).
Quelle que soit la matrice carrée réelle \(A\), le produit \(A^{T} A\) est symétrique positif. Il est même défini positif exactement lorsque \(A\) est inversible.
La symétrie vient de la règle de transposition d’un produit. Ensuite, le nombre \(X^{T} A^{T} A X\) n’est autre que le carré de la norme de \(AX\). Il est donc positif, et il ne s’annule que lorsque \(X\) appartient au noyau de \(A\). Ce noyau est réduit à zéro précisément quand \(A\) est inversible.
4.3 Prouver qu’une matrice est définie positive
Face à une matrice symétrique dont on veut prouver le caractère défini positif, trois pistes s’offrent à nous :
- calculer le spectre et vérifier qu’il est dans \(\mathbf{R}_{+}^{*}\), ce qui convient en petite taille ;
- décomposer \(X^{T} S X\) par la méthode de Gauss, en carrés de \(n\) expressions linéaires libres ;
- écrire \(S = B^{T} B\) avec \(B\) inversible, ou reconnaître \(X^{T} S X\) comme une intégrale ou une norme d’un objet qui n’est nul que si \(X = 0\).
Soit \(S = \begin{pmatrix} 4 & 2 & 0 \\ 2 & 3 & 1 \\ 0 & 1 & 2 \end{pmatrix}\). Pour \(X = (x, y, z)\), on a \(X^{T} S X = 4x^2 + 3y^2 + 2z^2 + 4xy + 2yz\). Regroupons d’abord les termes en \(x\) : \(4x^2 + 4xy = (2x + y)^2 – y^2\). Il reste ensuite \(2y^2 + 2yz + 2z^2 = 2\left(y + \frac{z}{2}\right)^2 + \frac{3}{2} z^2\). Ainsi, \[X^{T} S X = (2x + y)^2 + 2\left(y + \frac{z}{2}\right)^2 + \frac{3}{2} z^2.\] Cette somme est positive. De plus, elle est nulle seulement si \(z = 0\), puis \(y = 0\), puis \(x = 0\). Donc \(S \in \mathcal{S}_3^{++}(\mathbf{R})\), sans aucun calcul de valeur propre.
Des coefficients tous strictement positifs ne suffisent pas. La matrice \(\begin{pmatrix} 1 & 2 \\ 2 & 1 \end{pmatrix}\) a ses quatre coefficients positifs. Pourtant, avec \(X = (1, -1)\), on trouve \(X^{T} S X = 1 – 4 + 1 = -2\). En effet, ses valeurs propres sont 3 et \(-1\).
5. Le quotient de Rayleigh
Le dernier outil du chapitre sert à encadrer une forme quadratique. Il intervient dans les questions d’optimisation, d’inégalités et de normes de matrices.
5.1 Encadrement par les valeurs propres extrêmes
Soit \(S \in \mathcal{S}_n(\mathbf{R})\). Pour \(X \neq 0\), le quotient de Rayleigh de \(S\) en \(X\) est \[R_S(X) = \frac{X^{T} S X}{X^{T} X}.\] Il ne change pas si l’on remplace \(X\) par \(tX\) avec \(t \neq 0\). On peut donc se limiter à la sphère unité.
Appelons \(\lambda_{\min}\) et \(\lambda_{\max}\) les valeurs propres extrêmes de \(S\). Pour toute colonne non nulle \(X\), \[\lambda_{\min} \leqslant R_S(X) \leqslant \lambda_{\max}.\] La borne supérieure est atteinte précisément sur les vecteurs propres associés à \(\lambda_{\max}\). La borne inférieure se comporte de façon analogue. En particulier, \(\lambda_{\max} = \max_{\|X\| = 1} X^{T} S X\).
Reprenons \(Y = P^{T} X\), qui vérifie \(\|Y\| = \|X\|\) car \(P\) est orthogonale. Alors \(X^{T} S X = \sum \lambda_k y_k^2\). Comme \(\lambda_{\min} \leqslant \lambda_k \leqslant \lambda_{\max}\), on obtient \(\lambda_{\min} \|Y\|^2 \leqslant X^{T} S X \leqslant \lambda_{\max} \|Y\|^2\). Pour le cas d’égalité, \(\sum (\lambda_{\max} – \lambda_k) y_k^2 = 0\) impose \(y_k = 0\) dès que \(\lambda_k \neq \lambda_{\max}\). Autrement dit, \(X\) appartient au sous-espace propre de \(\lambda_{\max}\).
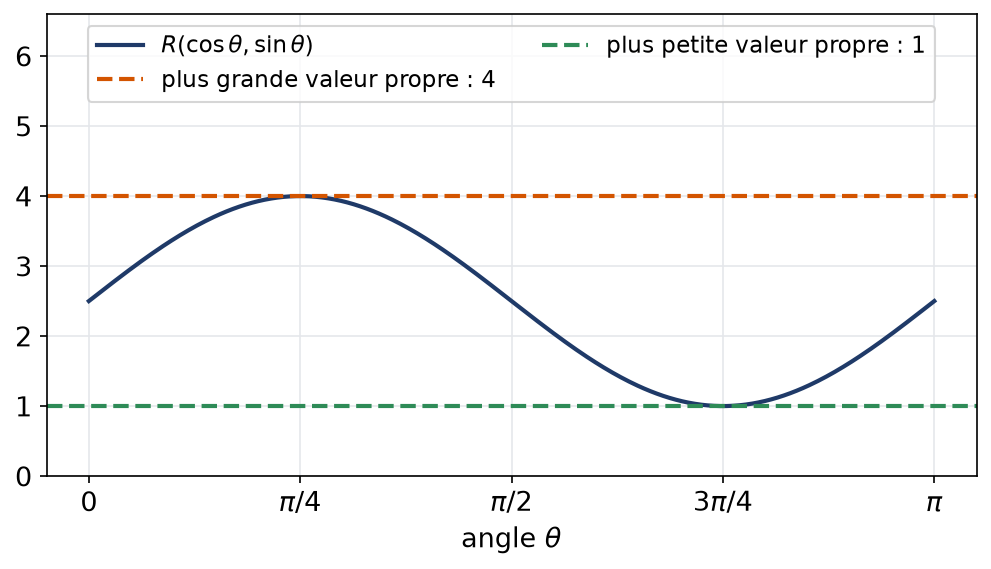
Prenons \(S = \begin{pmatrix} 5/2 & 3/2 \\ 3/2 & 5/2 \end{pmatrix}\) et \(X = (\cos \theta, \sin \theta)\). Un calcul direct donne \[R_S(X) = \frac{5}{2} + 3 \cos \theta \sin \theta = \frac{5}{2} + \frac{3}{2} \sin(2\theta).\] Ce quotient varie donc entre 1 et 4. Le maximum est atteint en \(\theta = \frac{\pi}{4}\), c’est-à-dire sur la direction de \((1,1)\). De même, le minimum est atteint sur la direction de \((1,-1)\). On retrouve bien les valeurs propres 4 et 1, avec leurs vecteurs propres.
5.2 Deux applications classiques
D’abord, l’encadrement fournit un critère de définie positivité : \(S \in \mathcal{S}_n^{++}(\mathbf{R})\) si et seulement si \(\lambda_{\min} > 0\). Ensuite, il donne une inégalité uniforme. Par exemple, avec la matrice \(S\) du paragraphe 3.3, de valeurs propres 1 et 7, on obtient pour tous réels \(x, y, z\) : \[x^2 + y^2 + z^2 \leqslant 5(x^2 + y^2 + z^2) – 4(xy + yz + zx) \leqslant 7(x^2 + y^2 + z^2).\] Ce type d’inégalité serait pénible à établir à la main.
Pour majorer \(\|AX\|\) avec \(A\) quelconque, on écrit \(\|AX\|^2 = X^{T} (A^{T} A) X\). La matrice \(A^{T} A\) est symétrique positive. Par conséquent, \(\|AX\| \leqslant \sqrt{\lambda_{\max}(A^{T} A)} \, \|X\|\), et cette borne est atteinte. On obtient ainsi la norme subordonnée de \(A\) pour la norme euclidienne.
Remarque :
Le quotient de Rayleigh ne fait intervenir que la forme quadratique. C’est pourquoi on l’utilise aussi pour comparer deux matrices : si \(X^{T} S X \leqslant X^{T} T X\) pour tout \(X\), alors \(\lambda_{\max}(S) \leqslant \lambda_{\max}(T)\). Il suffit en effet d’évaluer en un vecteur propre unitaire de \(S\) associé à \(\lambda_{\max}(S)\).
Les erreurs fréquentes
- Écrire que la matrice de \(u^{*}\) est \(A^{T}\) alors que la base n’est pas orthonormée.
- Conclure qu’une matrice est un projecteur orthogonal en vérifiant seulement \(P^{T} = P\), ou seulement \(P^2 = P\).
- Prendre des vecteurs propres non orthogonaux dans un même sous-espace propre de dimension au moins 2.
- Croire qu’une matrice à coefficients positifs est positive au sens des formes quadratiques.
- Invoquer le théorème spectral hors de son cadre : coefficients complexes, ou matrice réelle non symétrique.
- Conclure trop vite après une réduction de Gauss, sans contrôler que les expressions linéaires sont libres.
Fiche mémo
- Adjoint : \(\langle u(x), y \rangle = \langle x, u^{*}(y) \rangle\) ; en base orthonormée, la matrice de \(u^{*}\) est \(A^{T}\).
- \((u \circ v)^{*} = v^{*} \circ u^{*}\) et \((u^{*})^{*} = u\).
- \(F\) stable par \(u\) si et seulement si \(F^{\perp}\) stable par \(u^{*}\).
- Autoadjoint : \(u^{*} = u\), soit une matrice symétrique en base orthonormée.
- Projecteur orthogonal = projecteur autoadjoint ; en matrices, \(P^2 = P = P^{T}\).
- Théorème spectral : \(S \in \mathcal{S}_n(\mathbf{R})\) s’écrit \(P D P^{T}\) avec \(P\) orthogonale et \(D\) diagonale réelle.
- Sous-espaces propres d’une matrice symétrique : deux à deux orthogonaux.
- Positive : spectre dans \(\mathbf{R}_{+}\) ; définie positive : spectre dans \(\mathbf{R}_{+}^{*}\).
- \(A^{T} A\) : toujours positive, définie positive dès que \(A\) est inversible (et seulement alors).
- Rayleigh : \(\lambda_{\min} \|X\|^2 \leqslant X^{T} S X \leqslant \lambda_{\max} \|X\|^2\), avec égalité sur les vecteurs propres.
Questions fréquentes
L'adjoint a-t-il toujours pour matrice la transposée ?
Seulement dans une base orthonormée, car le calcul utilise l’écriture du produit scalaire comme X transposé fois Y. Dans une autre base, la matrice de Gram G intervient. La matrice de l’adjoint vaut alors G inverse fois A transposée fois G.
Le théorème spectral marche-t-il avec des coefficients complexes ?
Pas pour les matrices symétriques complexes. La preuve repose sur le fait que les coefficients sont réels. Ainsi, la matrice 2 x 2 de première ligne (1, i) et de seconde ligne (i, -1) est symétrique mais de carré nul, donc impossible à diagonaliser.
Quelle méthode choisir pour montrer qu'une matrice est définie positive ?
En dimension 2 ou 3, le calcul du spectre ou une réduction de Gauss suffisent souvent. Pour une matrice de taille n, on cherche plutôt à écrire la forme quadratique comme une norme au carré ou une intégrale. Cette écriture montre en même temps la positivité et le cas d’annulation.
À quoi sert le quotient de Rayleigh en pratique ?
Il exprime les valeurs propres extrêmes comme les bornes atteintes de X transposé S X lorsque X parcourt les vecteurs de norme 1. On l’utilise pour établir des inégalités uniformes, pour calculer la norme subordonnée euclidienne d’une matrice et pour comparer les spectres de deux matrices symétriques.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur matrices symétriques réelles
- Bases utiles : Isométries vectorielles et matrices orthogonales, Polynôme caractéristique, diagonalisation, trigonalisation
- Chapitre d’avant : Isométries vectorielles et matrices orthogonales
- Chapitre d’après : Théorème de Cauchy linéaire et wronskien
- Vérifier ses acquis : QCM de maths spé (MP) sur matrices symétriques réelles
- Contrôle corrigé en temps limité : Diagonalisation orthogonale et Rayleigh : contrôle de maths en MP
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «matrices symétriques réelles en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir
Exercices corrigés
Tout voir
Contrôles
Tout voir
QCM
Tout voir