Différentielle et règle de la chaîne en maths spé (MP) : cours et méthodes

Ce cours de différentielle MP ouvre le calcul différentiel du second semestre. Il fixe le vocabulaire de base : dérivée selon un vecteur, dérivées partielles, application différentiable, matrice jacobienne et gradient. Il s’appuie sur la topologie des espaces normés et sur la dérivation des fonctions vectorielles vues au premier semestre.
Nous insistons sur les savoir-faire qui tombent à l’écrit comme à l’oral : calculer une différentielle par développement, traiter les fonctions matricielles comme la différentielle du déterminant et celle de l’inverse, puis dériver une composée grâce à la règle de la chaîne. Le chapitre se termine par l’intégrale de la différentielle le long d’un arc et par le critère des fonctions constantes sur un ouvert connexe par arcs. Ces outils préparent directement l’étude des extremums et de l’optimisation sous contrainte.
Ce que vous saurez faire
- Calculer une dérivée selon un vecteur et des dérivées partielles, puis reconnaître une fonction qui n’est pas différentiable.
- Obtenir une différentielle par un développement à l’ordre 1, y compris sur un espace de matrices.
- Écrire une matrice jacobienne et un gradient, puis les interpréter géométriquement.
- Différentier une application bilinéaire ou multilinéaire, en particulier le déterminant, ainsi que l’inverse d’une matrice.
- Dériver une composée grâce à la règle de la chaîne, notamment le long d’un arc ou en coordonnées polaires.
- Prouver qu’une fonction est constante sur un ouvert connexe par arcs.
1. Dériver dans une direction : le point de départ
Ici, \(E\) et \(F\) désignent deux espaces vectoriels normés de dimension finie. Ainsi, toutes les normes y sont équivalentes et les notions étudiées ne dépendent pas du choix de la norme. On note \(U\) un ouvert de \(E\), \(a\) un point de \(U\) et \(f : U \to F\) une application. Comme \(U\) est ouvert, le point \(a + tv\) reste dans \(U\) pour \(t\) assez petit.
1.1 Dérivée selon un vecteur
Soit \(v \in E\). On dit que \(f\) admet une dérivée en \(a\) selon \(v\) si la fonction d’une variable réelle \(t \mapsto f(a + tv)\) est dérivable en \(0\). On note alors
\[ D_v f(a) = \lim_{t \to 0} \frac{f(a + tv) – f(a)}{t}. \]
Autrement dit, on restreint \(f\) à une droite passant par \(a\) et on dérive une fonction d’une seule variable. Cette idée est simple, mais elle ne regarde qu’une direction à la fois. C’est pourquoi elle se révèle insuffisante pour décrire le comportement global de \(f\) autour de \(a\).
1.2 Dérivées partielles
Fixons \(\mathcal{B} = (e_1, \dots, e_n)\), base de \(E\). Lorsque la dérivée de \(f\) en \(a\) selon le vecteur \(e_j\) existe, on l’appelle \(j\)-ième dérivée partielle : \(\partial_j f(a) = D_{e_j} f(a)\). Lorsque \(E = \mathbb{R}^n\) muni de sa base canonique, on la note aussi \(\dfrac{\partial f}{\partial x_j}(a)\).
En pratique, on calcule \(\partial_j f(a)\) en dérivant par rapport à la \(j\)-ième variable, les autres étant figées. Par exemple, pour \(g(x,y) = x^2 \sin y + e^{3y}\), on obtient \(\partial_1 g(x,y) = 2x \sin y\) et \(\partial_2 g(x,y) = x^2 \cos y + 3 e^{3y}\).
On considère \(f\) définie sur \(\mathbb{R}^2\) par \(f(0,0) = 0\) et, sinon,
\[ f(x,y) = \frac{x y^2}{x^2 + 3 y^4}. \]
Soit \(v = (h,k)\) non nul. D’abord, pour \(t \neq 0\), on a \(\dfrac{f(th, tk)}{t} = \dfrac{h k^2}{h^2 + 3 t^2 k^4}\). Ensuite, si \(h \neq 0\), ce quotient tend vers \(\dfrac{k^2}{h}\). Enfin, si \(h = 0\), il est nul. Ainsi, \(f\) admet une dérivée en \((0,0)\) selon tout vecteur. Cependant, l’application \(v \mapsto D_v f(0,0)\) n’est pas linéaire. De plus, sur la parabole \(x = y^2\), on trouve \(f(y^2, y) = \dfrac{1}{4}\) pour \(y \neq 0\). Par conséquent, \(f\) n’est même pas continue en l’origine.
Piège à éviter :
Une fonction peut posséder une dérivée dans chaque direction et rester discontinue. En colle, il faut donc toujours revenir à la définition de la différentiabilité avant de conclure.
2. Différentielle, matrice jacobienne et gradient
Pour une fonction d’une variable, être dérivable revient à admettre un développement limité à l’ordre 1. Nous gardons cette idée et nous demandons une approximation affine valable dans toutes les directions à la fois.
2.1 Application différentiable
L’application \(f\) est différentiable au point \(a\) lorsqu’un élément \(L\) de \(\mathcal{L}(E,F)\) vérifie, pour \(h\) voisin de \(0\),
\[ f(a + h) – f(a) – L(h) = o(\|h\|). \]
Un tel \(L\), s’il existe, est forcément unique : c’est la différentielle de \(f\) au point \(a\), notée \(df(a)\). Lorsque cette propriété a lieu en chaque point de \(U\), \(f\) est différentiable sur \(U\).
L’unicité vient de la linéarité. En effet, si \(L_1\) et \(L_2\) conviennent, alors \((L_1 – L_2)(tv) = o(t)\) pour tout \(v\). Donc \(t(L_1 – L_2)(v) = o(t)\), ce qui force \(L_1(v) = L_2(v)\).
Si \(f\) est différentiable en \(a\), alors :
- \(f\) est continue en \(a\) ;
- \(f\) admet une dérivée en \(a\) selon tout vecteur \(v\), et \(D_v f(a) = df(a)(v)\) ;
- dans une base \((e_1, \dots, e_n)\), on a \(df(a)(h) = \sum_{j=1}^{n} h_j \, \partial_j f(a)\) pour \(h = \sum h_j e_j\).
Comme \(df(a)\) est linéaire en dimension finie, elle est continue. Ainsi, \(f(a+h) – f(a) = df(a)(h) + o(\|h\|)\) tend vers \(0\). Ensuite, on remplace \(h\) par \(tv\) : on obtient \(f(a + tv) = f(a) + t \, df(a)(v) + o(t)\), d’où la deuxième propriété. Enfin, la troisième découle de la linéarité de \(df(a)\) appliquée à \(h = \sum h_j e_j\).
Cette proposition fournit un test de non-différentiabilité très efficace. Si \(v \mapsto D_v f(a)\) n’est pas linéaire, alors \(f\) n’est pas différentiable en \(a\). C’est exactement le cas de l’exemple guidé de la partie 1.
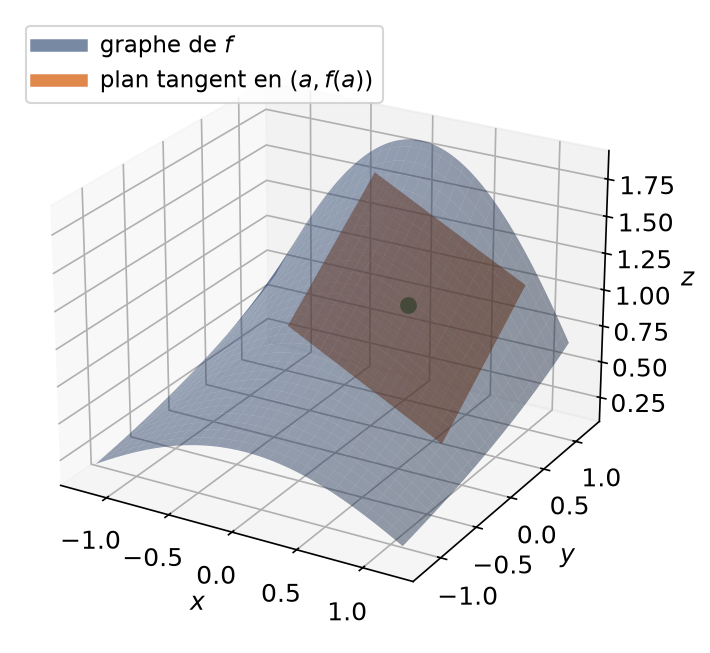
Géométriquement, pour \(f : \mathbb{R}^2 \to \mathbb{R}\), la différentiabilité signifie que le graphe admet un plan tangent. Près du point \((a, f(a))\), ce plan approche la surface à l’ordre 1, comme le montre la figure suivante.
Pour calculer une différentielle par développement :
- écrire \(f(a + h)\) en développant toutes les expressions ;
- regrouper le terme constant \(f(a)\), les termes linéaires en \(h\) et les termes d’ordre supérieur ;
- vérifier que le reste est négligeable devant \(\|h\|\), souvent par une majoration du type \(\|R(h)\| \leqslant C \|h\|^2\) ;
- conclure : la partie linéaire est \(df(a)(h)\).
Sur \(\mathcal{M}_n(\mathbb{R})\), on pose \(f(M) = M^{\top} A M\), où \(A\) est une matrice fixée. Pour toute matrice \(H\), on développe :
\[ f(M + H) = M^{\top} A M + \left( H^{\top} A M + M^{\top} A H \right) + H^{\top} A H. \]
Le terme central est linéaire en \(H\). Pour une norme sous-multiplicative, le dernier vérifie de plus \(\|H^{\top} A H\| \leqslant \|A\| \, \|H^{\top}\| \, \|H\| = O(\|H\|^2)\), car la transposition est une application linéaire continue. Par conséquent, \(df(M)(H) = H^{\top} A M + M^{\top} A H\).
2.2 Matrice jacobienne
Soit \(f : U \subset \mathbb{R}^n \to \mathbb{R}^p\), de composantes \(f_1, \dots, f_p\), différentiable en \(a\). Sa matrice jacobienne en \(a\) est la matrice de \(df(a)\) dans les bases canoniques :
\[ J_f(a) = \left( \frac{\partial f_i}{\partial x_j}(a) \right)_{1 \leqslant i \leqslant p, \ 1 \leqslant j \leqslant n} \in \mathcal{M}_{p,n}(\mathbb{R}). \]
Chaque ligne correspond à une composante et chaque colonne à une variable. Par exemple, pour \(\Phi(u,v) = (u e^{v}, u + v^3)\), on trouve
\[ J_{\Phi}(u,v) = \begin{pmatrix} e^{v} & u e^{v} \\ 1 & 3 v^2 \end{pmatrix}. \]
2.3 Gradient d’une fonction numérique
On suppose désormais \(E\) euclidien, de produit scalaire \(\langle \cdot , \cdot \rangle\), et \(f\) à valeurs réelles. Alors \(df(a)\) est une forme linéaire. Or toute forme linéaire sur un espace euclidien se représente par un unique vecteur.
Si \(f : U \to \mathbb{R}\) est différentiable en \(a\), le gradient de \(f\) en \(a\) est l’unique vecteur \(\nabla f(a)\) de \(E\) tel que
\[ \forall h \in E, \quad df(a)(h) = \langle \nabla f(a), h \rangle. \]
Dans une base orthonormée, ses coordonnées sont les dérivées partielles \(\partial_1 f(a), \dots, \partial_n f(a)\).
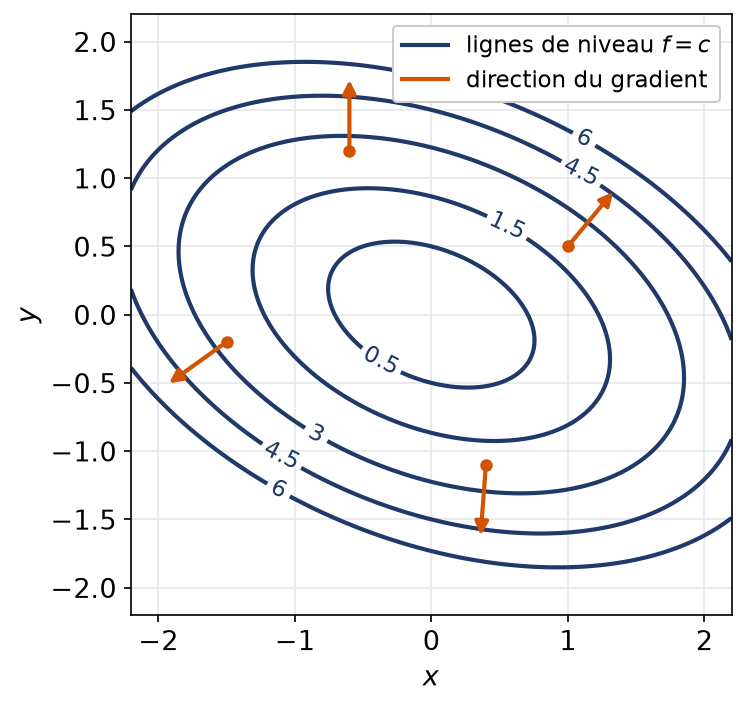
D’après l’inégalité de Cauchy-Schwarz, parmi les vecteurs unitaires \(v\), la dérivée \(D_v f(a)\) est maximale quand \(v\) est dirigé comme \(\nabla f(a)\). Ainsi, lorsqu’il est non nul, le gradient indique la direction de plus forte croissance. De plus, nous verrons qu’il est orthogonal aux lignes de niveau.
Soit \(u\) un endomorphisme symétrique de \(E\) et \(q(x) = \langle u(x), x \rangle\). On développe : \(q(x + h) = q(x) + \langle u(x), h \rangle + \langle u(h), x \rangle + q(h)\). Or \(\langle u(h), x \rangle = \langle h, u(x) \rangle\) par symétrie. De plus, \(|q(h)| \leqslant \|u\| \, \|h\|^2\). Donc \(dq(x)(h) = 2 \langle u(x), h \rangle\), c’est-à-dire \(\nabla q(x) = 2 u(x)\). Pour \(q(x,y) = x^2 + xy + 2y^2\), cela donne \(\nabla q(x,y) = (2x + y, \, x + 4y)\).
3. Différentielle des applications multilinéaires, du déterminant et de l’inverse
Les applications linéaires et multilinéaires forment la boîte à outils de base. En effet, de nombreuses fonctions matricielles s’écrivent à partir d’elles.
3.1 Cas linéaire et bilinéaire
Une application linéaire \(\ell : E \to F\) est différentiable en tout point et \(d\ell(a) = \ell\). Autrement dit, la différentielle d’une application linéaire est elle-même, quel que soit le point.
Soit \(B : E_1 \times E_2 \to F\) bilinéaire. Alors \(B\) est différentiable en tout point \((a,b)\) et
\[ dB(a,b)(h,k) = B(h, b) + B(a, k). \]
Par bilinéarité, \(B(a + h, b + k) = B(a,b) + B(h,b) + B(a,k) + B(h,k)\). Le terme \(B(h,b) + B(a,k)\) est linéaire en \((h,k)\). Ensuite, en dimension finie, il existe \(C\) tel que \(\|B(h,k)\| \leqslant C \|h\| \, \|k\|\). Donc ce reste est un \(O(\|(h,k)\|^2)\), ce qui conclut.
Plus généralement, pour \(\varphi\) multilinéaire de \(E_1 \times \dots \times E_p\) dans \(F\), on obtient une somme de \(p\) termes. Dans chacun d’eux, on remplace un seul argument par son accroissement :
\[ d\varphi(a_1, \dots, a_p)(h_1, \dots, h_p) = \sum_{i=1}^{p} \varphi(a_1, \dots, a_{i-1}, h_i, a_{i+1}, \dots, a_p). \]
Remarque :
Ces formules rappellent la dérivée d’un produit. Par exemple, le produit matriciel \((M,N) \mapsto MN\) est bilinéaire, donc sa différentielle vaut \((H,K) \mapsto HN + MK\). Il faut cependant garder l’ordre des facteurs, car le produit n’est pas commutatif.
3.2 Différentielle du déterminant
Le déterminant est une fonction polynomiale des coefficients, donc il est de classe \(C^1\) sur \(\mathcal{M}_n(\mathbb{R})\). Nous déterminons sa différentielle de deux façons complémentaires.
Pour toutes matrices \(M\) et \(H\) de \(\mathcal{M}_n(\mathbb{R})\), on a
\[ d(\det)(M)(H) = \operatorname{tr}\left( \operatorname{com}(M)^{\top} H \right). \]
En particulier, \(d(\det)(I_n)(H) = \operatorname{tr}(H)\) et, si \(M\) est inversible, \(d(\det)(M)(H) = \det(M) \operatorname{tr}(M^{-1} H)\).
On développe \(\det M\) selon la colonne \(j\) : \(\det M = \sum_{i} m_{ij} \, c_{ij}\), où \(c_{ij}\) est le cofacteur d’indice \((i,j)\). Or \(c_{ij}\) ne dépend d’aucun coefficient de la ligne \(i\) ni de la colonne \(j\). Par conséquent, \(\dfrac{\partial \det}{\partial m_{ij}}(M) = c_{ij}\). On en déduit
\[ d(\det)(M)(H) = \sum_{i,j} c_{ij} \, h_{ij} = \operatorname{tr}\left( \operatorname{com}(M)^{\top} H \right). \]
Si \(M\) est inversible, la relation \(\operatorname{com}(M)^{\top} = \det(M) \, M^{-1}\) donne la seconde forme.
On peut aussi retrouver \(d(\det)(I_n)\) très vite. En effet, le déterminant est multilinéaire en les colonnes. La formule de la partie 3.1 donne donc une somme de \(n\) déterminants, où une seule colonne de \(I_n\) est remplacée par la colonne correspondante de \(H\). Le \(j\)-ième vaut \(h_{jj}\), et la somme vaut \(\operatorname{tr}(H)\).
3.3 Différentielle de l’inversion
D’abord, \(GL_n(\mathbb{R}) = \det^{-1}(\mathbb{R}^*)\) est un ouvert de \(\mathcal{M}_n(\mathbb{R})\), car le déterminant est continu. Ensuite, l’application \(\iota : M \mapsto M^{-1}\) est continue sur cet ouvert, grâce à la formule de la comatrice.
L’application \(\iota\) est différentiable sur \(GL_n(\mathbb{R})\) et, pour toute matrice \(H\),
\[ d\iota(M)(H) = – M^{-1} H M^{-1}. \]
Soit \(H\) assez petite pour que \(M + H\) soit inversible. D’abord, \((M + H)^{-1} – M^{-1} = -(M+H)^{-1} H M^{-1}\), ce qu’on vérifie en multipliant à gauche par \(M + H\). Ensuite, on réinjecte cette identité :
\[ (M+H)^{-1} – M^{-1} + M^{-1} H M^{-1} = (M+H)^{-1} H M^{-1} H M^{-1}. \]
Pour une norme sous-multiplicative, le membre de droite est majoré par \(\|(M+H)^{-1}\| \, \|M^{-1}\|^2 \, \|H\|^2\). Or \(\|(M+H)^{-1}\|\) reste borné près de \(H = 0\) par continuité de \(\iota\). Le reste est donc un \(O(\|H\|^2)\).
Piège à éviter :
On n’écrit jamais \(d\iota(M)(H) = -H M^{-2}\) ni \(-M^{-2} H\). Ces formules ne valent que si \(H\) commute avec \(M\). La position de \(H\) entre les deux facteurs \(M^{-1}\) est essentielle.
4. Règle de la chaîne et dérivée le long d’un arc
La règle de la chaîne permet de différentier une composée sans repartir de la définition. Elle est l’outil central de tout calcul de dérivées partielles après un changement de variables.
4.1 Différentielle d’une composée
Soit \(f : U \to F\) différentiable en \(a\), et \(g : V \to G\) avec \(V\) ouvert de \(F\) contenant \(f(U)\). Si \(g\) est différentiable en \(f(a)\), alors \(g \circ f\) est différentiable en \(a\) et
\[ d(g \circ f)(a) = dg\big(f(a)\big) \circ df(a). \]
Matriciellement, \(J_{g \circ f}(a) = J_g\big(f(a)\big) \, J_f(a)\).
Posons \(b = f(a)\) et \(k = f(a+h) – b\). D’abord, \(k = df(a)(h) + o(\|h\|)\), donc \(k = O(\|h\|)\). Ensuite, \(g(b + k) = g(b) + dg(b)(k) + o(\|k\|)\). Or \(o(\|k\|)\) est aussi un \(o(\|h\|)\). Enfin, par linéarité et continuité de \(dg(b)\), on a \(dg(b)(k) = dg(b)\big(df(a)(h)\big) + o(\|h\|)\), ce qui donne le résultat.
En coordonnées, la règle prend une forme très utilisée. Si \(g\) est une fonction numérique de \(p\) variables et \(f = (f_1, \dots, f_p)\), alors
\[ \frac{\partial (g \circ f)}{\partial x_j}(a) = \sum_{i=1}^{p} \frac{\partial g}{\partial y_i}\big(f(a)\big) \, \frac{\partial f_i}{\partial x_j}(a). \]
4.2 Dérivée le long d’un arc
Soit \(\gamma : I \to U\) un arc dérivable sur un intervalle \(I\) et \(f\) différentiable sur \(U\). Alors \(f \circ \gamma\) est dérivable sur \(I\) et
\[ (f \circ \gamma)^{\prime}(t) = df\big(\gamma(t)\big)\big(\gamma^{\prime}(t)\big). \]
Si \(f\) est numérique et \(E\) euclidien, cela s’écrit \((f \circ \gamma)^{\prime}(t) = \langle \nabla f(\gamma(t)), \gamma^{\prime}(t) \rangle\).
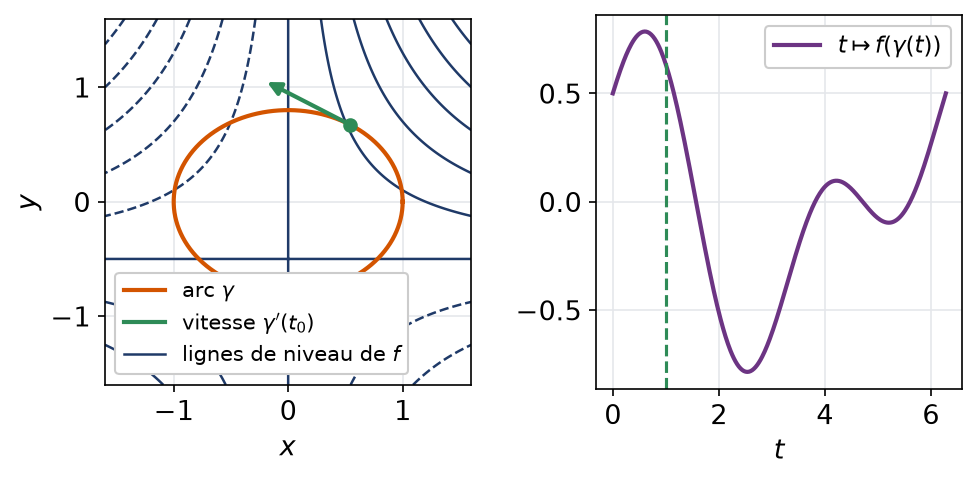
Cette formule a une conséquence géométrique importante. Si \(\gamma\) reste dans une ligne de niveau \(\{f = c\}\), alors \(f \circ \gamma\) est constante. Donc \(\nabla f(\gamma(t))\) est orthogonal à la vitesse \(\gamma^{\prime}(t)\). Le gradient est ainsi orthogonal aux lignes de niveau. La figure ci-dessous montre au contraire un arc qui traverse les lignes de niveau : la valeur de \(f\) varie le long du parcours.
Soit \(A \in \mathcal{M}_n(\mathbb{R})\) et \(\psi(t) = \det(I_n + tA)\). L’arc \(t \mapsto I_n + tA\) a pour vitesse \(A\). D’après le corollaire et la partie 3.2, on obtient \(\psi^{\prime}(0) = d(\det)(I_n)(A) = \operatorname{tr}(A)\). Ainsi, \(\det(I_n + tA) = 1 + t \operatorname{tr}(A) + o(t)\). Pour \(A = \begin{pmatrix} 2 & 5 \\ -1 & 4 \end{pmatrix}\), un calcul direct donne \(\det(I_2 + tA) = 1 + 6t + 13t^2\), ce qui confirme \(\psi^{\prime}(0) = 6\).
4.3 Changement de variables en coordonnées polaires
Pour dériver \(g(r, \theta) = f(r \cos \theta, r \sin \theta)\), avec \(f\) de classe \(C^1\) :
- nommer l’application intermédiaire \(P(r,\theta) = (r\cos\theta, r\sin\theta)\) et calculer ses dérivées partielles ;
- appliquer la formule en coordonnées de la règle de la chaîne ;
- évaluer les dérivées de \(f\) au point \(P(r,\theta)\) et non en \((r,\theta)\).
On obtient alors
\[ \frac{\partial g}{\partial r} = \cos\theta \, \partial_1 f + \sin\theta \, \partial_2 f, \qquad \frac{\partial g}{\partial \theta} = – r \sin\theta \, \partial_1 f + r \cos\theta \, \partial_2 f. \]
Piège à éviter :
Écrire \(\partial_1 f(r, \theta)\) au lieu de \(\partial_1 f(r\cos\theta, r\sin\theta)\) est une faute fréquente. Elle coûte cher en concours, car elle rend tout le calcul faux.
5. Classe C1, intégrale de df et fonctions constantes
5.1 Applications de classe C1
L’application \(f\) est de classe \(C^1\) sur \(U\) lorsque, d’une part, elle y est différentiable et, d’autre part, \(x \mapsto df(x)\) est continue de \(U\) dans \(\mathcal{L}(E,F)\).
On fixe une base \((e_1, \dots, e_n)\) de \(E\). Pour que \(f\) soit \(C^1\) sur \(U\), il faut et il suffit que les \(n\) fonctions \(\partial_1 f, \dots, \partial_n f\) soient définies partout sur \(U\) et y soient continues.
Ce théorème est admis. Il donne le critère le plus pratique. En effet, les fonctions construites par sommes, produits, quotients et compositions de fonctions usuelles ont des dérivées partielles continues là où elles sont définies. Elles sont donc de classe \(C^1\), et l’on peut appliquer la règle de la chaîne sans justification supplémentaire. En revanche, en un point « à problème » comme l’origine d’une fraction rationnelle, il faut étudier séparément l’existence et la continuité des dérivées partielles.
5.2 Retrouver f à partir de df le long d’un chemin
On suppose \(f : U \to F\) de classe \(C^1\). Pour tout chemin \(\gamma : [0,1] \to U\) lui-même de classe \(C^1\), on dispose de l’égalité
\[ f\big(\gamma(1)\big) – f\big(\gamma(0)\big) = \int_0^1 df\big(\gamma(t)\big)\big(\gamma^{\prime}(t)\big) \, dt. \]
La fonction \(\varphi = f \circ \gamma\) est dérivable, de dérivée \(t \mapsto df(\gamma(t))(\gamma^{\prime}(t))\) d’après le corollaire 4.2. Cette dérivée est continue, car \(df\), \(\gamma\) et \(\gamma^{\prime}\) le sont. Le théorème fondamental de l’analyse donne alors \(\varphi(1) – \varphi(0) = \int_0^1 \varphi^{\prime}(t) \, dt\).
Le cas du segment \(\gamma(t) = a + t(b – a)\) est le plus utile. Si le segment \([a,b]\) est inclus dans \(U\) et si \(\|df(x)\| \leqslant K\) sur ce segment, on en déduit l’inégalité \(\|f(b) – f(a)\| \leqslant K \|b – a\|\). Sur un ouvert convexe, on obtient ainsi une fonction \(K\)-lipschitzienne.
5.3 Fonctions constantes sur un ouvert connexe par arcs
Soit \(U\) un ouvert connexe par arcs et \(f : U \to F\) différentiable sur \(U\), telle que \(df(x) = 0\) pour tout \(x \in U\). Alors \(f\) est constante sur \(U\).
Fixons \(a \in U\) et posons \(A = \{x \in U \mid f(x) = f(a)\}\). D’abord, \(A\) est non vide. Ensuite, \(A\) est ouvert : si \(x \in A\), une boule \(B(x, r)\) incluse dans \(U\) est convexe, et pour \(y\) dans cette boule, \(\varphi(t) = f(x + t(y – x))\) a une dérivée nulle sur \([0,1]\). Donc \(f(y) = f(x) = f(a)\). De plus, \(A\) est fermé dans \(U\) par continuité de \(f\). Enfin, un ouvert connexe par arcs est connexe, donc \(A = U\).
On a seulement supposé \(f\) différentiable, et non de classe \(C^1\). Cela suffit, car on utilise la dérivée d’une fonction d’une variable sur un segment, sans intégrer.
L’hypothèse de connexité est indispensable. Sur la réunion de deux disques ouverts disjoints, la fonction égale à \(2\) sur le premier et à \(-1\) sur le second a une différentielle nulle. Pourtant, elle n’est pas constante.
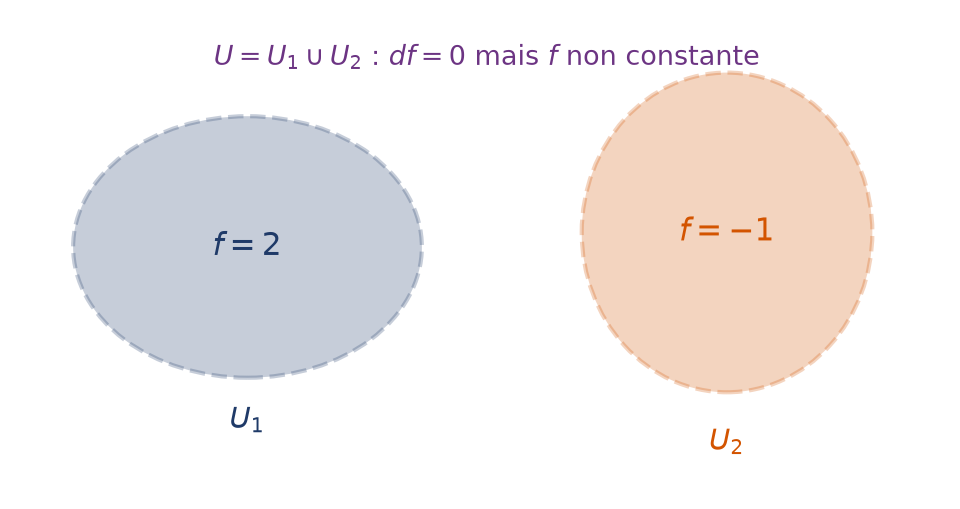
Pour prouver qu’une fonction est constante :
- vérifier que l’ensemble de définition est un ouvert connexe par arcs, par exemple convexe ou étoilé ;
- montrer que toutes les dérivées partielles sont nulles, ou que l’accroissement est un \(o(\|h\|)\) ;
- conclure par le théorème, puis calculer la constante en un point simple.
Soit \(U = \{(x,y) \in \mathbb{R}^2 \mid xy < 1\}\). C’est un ouvert, image réciproque de \(]-\infty, 1[\) par une application continue. De plus, il est étoilé par rapport à l’origine : si \(xy < 1\) et \(t \in [0,1]\), alors \(t^2 xy < 1\). Il est donc connexe par arcs. On pose, sur \(U\),
\[ f(x,y) = \arctan\left( \frac{x + y}{1 – xy} \right) – \arctan x – \arctan y. \]
Notons \(u = \dfrac{x+y}{1-xy}\). D’une part, \(\partial_1 u = \dfrac{1 + y^2}{(1 – xy)^2}\). D’autre part, \(1 + u^2 = \dfrac{(1+x^2)(1+y^2)}{(1-xy)^2}\). Par conséquent, \(\partial_1 f = \dfrac{1}{1+x^2} – \dfrac{1}{1+x^2} = 0\). Par symétrie, \(\partial_2 f = 0\) aussi. Donc \(f\) est constante sur \(U\), égale à \(f(0,0) = 0\). On obtient ainsi la formule d’addition des arctangentes dès que \(xy < 1\).
Les erreurs fréquentes
- Conclure à la différentiabilité parce que les dérivées partielles existent : il faut un développement à l’ordre 1, ou bien des dérivées partielles continues.
- Oublier de justifier que le reste est un \(o(\|h\|)\) : une majoration en \(\|h\|^2\) suffit, mais elle doit être écrite.
- Inverser l’ordre des facteurs dans une différentielle matricielle, par exemple écrire \(2MH\) pour la différentielle de \(M \mapsto M^2\) au lieu de \(MH + HM\).
- Évaluer les dérivées partielles au mauvais point dans la règle de la chaîne.
- Affirmer qu’une fonction de différentielle nulle est constante sans vérifier la connexité par arcs de l’ouvert.
Fiche mémo
- \(D_v f(a) = \lim_{t \to 0} \frac{1}{t}\big(f(a+tv) – f(a)\big)\) et \(\partial_j f(a) = D_{e_j} f(a)\).
- Différentiable en \(a\) : \(f(a+h) = f(a) + df(a)(h) + o(\|h\|)\), avec \(df(a)\) linéaire.
- Différentiable implique continue et \(D_v f(a) = df(a)(v) = \sum v_j \, \partial_j f(a)\).
- Jacobienne : \(J_f(a) = \big(\partial_j f_i(a)\big)\) ; gradient : \(df(a)(h) = \langle \nabla f(a), h \rangle\).
- Bilinéaire : \(dB(a,b)(h,k) = B(h,b) + B(a,k)\).
- Déterminant : \(d(\det)(M)(H) = \operatorname{tr}(\operatorname{com}(M)^{\top} H)\), et \(\operatorname{tr}(H)\) en \(I_n\).
- Inverse : \(d\iota(M)(H) = -M^{-1} H M^{-1}\).
- Règle de la chaîne : \(d(g \circ f)(a) = dg(f(a)) \circ df(a)\) et \(J_{g \circ f} = J_g J_f\).
- Le long d’un arc : \((f \circ \gamma)^{\prime}(t) = df(\gamma(t))(\gamma^{\prime}(t))\), puis intégrale de \(df\) pour une fonction \(C^1\).
- \(df = 0\) sur un ouvert connexe par arcs implique \(f\) constante.
Questions fréquentes
Quelle différence entre dérivées partielles et différentielle ?
Les dérivées partielles ne regardent la fonction que le long des axes, une direction à la fois. La différentielle demande une approximation linéaire valable dans toutes les directions simultanément. Ainsi, l’existence des deux dérivées partielles à l’origine laisse ouverte la question de la différentiabilité, et parfois même la fonction y est discontinue.
Comment montrer rapidement qu'une fonction n'est pas différentiable en un point ?
Le plus efficace consiste à calculer les dérivées directionnelles en ce point. Si l’application qui à v associe la dérivée selon v n’est pas linéaire, ou si une dérivée directionnelle manque, la fonction n’est pas différentiable. On peut aussi exhiber une discontinuité le long d’une courbe bien choisie.
Faut-il connaître par cœur la différentielle du déterminant ?
Oui, c’est un résultat classique des concours. Il faut retenir que la différentielle en l’identité est la trace, et savoir retrouver la formule générale avec la comatrice. Pour une matrice inversible, la forme det(M) tr(M⁻¹H) est souvent la plus commode.
Pourquoi l'hypothèse de connexité par arcs est-elle nécessaire ?
Sans elle, une fonction peut être constante sur chaque morceau de l’ouvert avec des valeurs différentes. Sa différentielle est alors nulle partout, mais la fonction n’est pas constante. La connexité par arcs permet de relier deux points quelconques et de propager l’égalité des valeurs.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur différentielle et règle de la chaîne
- Bases utiles : Compacité, connexité et applications linéaires continues, Dérivation et intégration des fonctions vectorielles
- Chapitre d’avant : Exponentielle de matrice et systèmes X' = AX
- Chapitre d’après : Extremums, hessienne et optimisation sous contrainte
- Vérifier ses acquis : QCM de maths spé (MP) sur différentielle et règle de la chaîne
- Contrôle corrigé en temps limité : Différentielles, gradient et extremums liés : contrôle de maths en MP
- Le même thème en L2 de maths : Dérivées partielles, différentielle et jacobienne
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «différentielle et règle de la chaîne en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir Sous-espaces stables et spectre en maths spé (MP)
- Fonctions à valeurs vectorielles en maths spé (MP)
- Intégrabilité sur un intervalle en maths spé (MP)
- Développements en série entière en maths spé (MP)
- Polynôme minimal et lemme des noyaux en maths spé (MP)
- Rayon et somme d’une série entière en maths spé (MP)

Exercices corrigés
Tout voir

Contrôles
Tout voir
QCM
Tout voir