Fonctions à valeurs vectorielles en maths spé (MP) : cours et méthodes

Ce chapitre sur les fonctions vectorielles MP rassemble les outils de calcul pour dériver et intégrer une fonction à valeurs dans \(\mathbb{R}^n\) ou dans un espace de matrices. Il prolonge la topologie des espaces normés et précède les équations différentielles linéaires et le calcul différentiel.
Vous y trouverez les règles de dérivation présentées comme des outils : image linéaire, produit scalaire, produit matriciel, dérivée d’un déterminant, composition avec un changement de paramètre. Viennent ensuite l’intégrale sur un segment et les sommes de Riemann, l’inégalité des accroissements finis et les trois formules de Taylor.
Chaque partie signale les erreurs de dérivation de produits qui coûtent des points, comme l’oubli de l’ordre des facteurs pour les matrices.
Ce que vous saurez faire
- Dériver une fonction à valeurs dans \(\mathbb{R}^n\) ou dans un espace de matrices, coordonnée par coordonnée.
- Dériver un produit scalaire, un produit de matrices ou un déterminant de fonctions sans oublier de terme.
- Dériver une expression bilinéaire dans laquelle une composée apparaît.
- Intégrer une fonction vectorielle sur un segment et reconnaître une somme de Riemann.
- Majorer \(\|f(b) – f(a)\|\) grâce à l’inégalité des accroissements finis.
- Écrire et exploiter les formules de Taylor pour une fonction vectorielle.
1. Dériver une fonction à valeurs vectorielles
Nous notons \(I\) un intervalle de \(\mathbb{R}\) non réduit à un point, et \(E\) un \(\mathbb{R}\)-espace vectoriel normé de dimension finie \(n\). Les exemples typiques sont \(\mathbb{R}^2\), \(\mathbb{R}^3\), \(\mathbb{C}\) ou \(\mathcal{M}_p(\mathbb{R})\). Comme \(E\) est de dimension finie, ses normes sont deux à deux équivalentes. Limites et dérivées s’y définissent donc sans avoir à préciser la norme.
Une fonction \(f : I \to E\) décrit par exemple le mouvement d’un point, ou bien une famille de matrices qui dépend d’un paramètre. On transpose alors la définition du taux d’accroissement.
Soit \(a \in I\). La fonction \(f\) est dérivable en \(a\) lorsque le vecteur \(\frac{1}{h}\big(f(a + h) – f(a)\big)\) admet une limite dans \(E\) quand \(h\) tend vers \(0\) avec \(a + h \in I\). Cette limite est notée \(f^{\prime}(a)\) : c’est le vecteur dérivé de \(f\) en \(a\).
Autre formulation : la dérivabilité en \(a\) revient à trouver un vecteur \(\ell\) pour lequel \(f(a + h) = f(a) + h\,\ell + o(h)\). On a alors \(\ell = f^{\prime}(a)\). Cette écriture, appelée développement limité d’ordre 1, sert dans presque toutes les preuves du chapitre.
En cinématique, si \(f(t)\) est la position d’un point à l’instant \(t\), alors \(f^{\prime}(t)\) est son vecteur vitesse. Lorsqu’il est non nul, il dirige la tangente à la trajectoire. De plus, sa norme mesure la vitesse scalaire, c’est-à-dire la distance parcourue par unité de temps.
1.1 La dérivée par coordonnées
Soit \((e_1, \ldots, e_n)\) une base de \(E\), et \(f = \sum_{i=1}^{n} f_i\, e_i\) avec des fonctions réelles \(f_i\). La dérivabilité de \(f\) en \(a\) équivaut à celle de toutes les fonctions \(f_i\) en ce point. Dans ce cas, \(f^{\prime}(a) = \sum_{i=1}^{n} f_i^{\prime}(a)\, e_i\).
Munissons \(E\) de la norme \(\|x\|_\infty = \max_i |x_i|\), ce qui est permis puisque les normes sont équivalentes. Un vecteur tend vers une limite pour cette norme exactement lorsque chacune de ses coordonnées tend vers la coordonnée correspondante. Il suffit donc d’appliquer ce principe au taux d’accroissement, dont les coordonnées sont les taux d’accroissement des \(f_i\).
En pratique, on dérive donc chaque coordonnée comme une fonction réelle. Pour une fonction à valeurs matricielles, on dérive chaque coefficient.
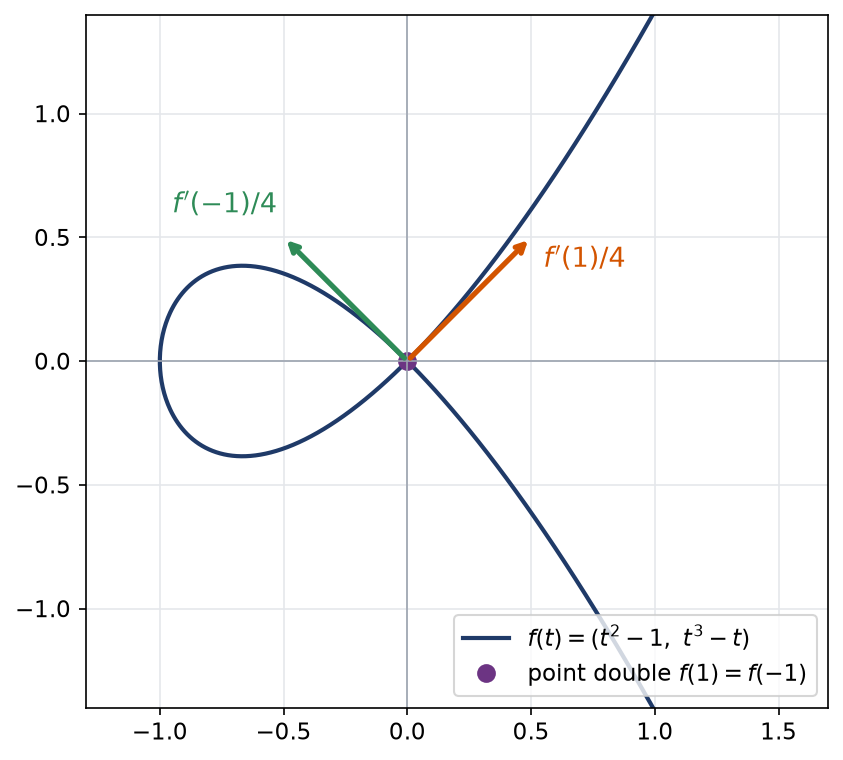
Considérons \(f(t) = (t^2 – 1, t^3 – t)\) dans \(\mathbb{R}^2\). Ses coordonnées sont polynomiales, donc \(f\) est dérivable sur \(\mathbb{R}\), avec \(f^{\prime}(t) = (2t, 3t^2 – 1)\).
Remarquons ensuite que \(f(1) = f(-1) = (0, 0)\) : la courbe passe deux fois par l’origine. Les vecteurs dérivés en ces deux instants valent \(f^{\prime}(1) = (2, 2)\) et \(f^{\prime}(-1) = (-2, 2)\). Ils ne sont pas colinéaires : la courbe se croise elle-même en formant une boucle, avec deux tangentes orthogonales.
Le même principe s’applique aux matrices. Par exemple, la rotation \(R(t) = \begin{pmatrix} \cos t & -\sin t \\ \sin t & \cos t \end{pmatrix}\) se dérive coefficient par coefficient. On obtient \(R^{\prime}(t) = \begin{pmatrix} -\sin t & -\cos t \\ \cos t & -\sin t \end{pmatrix}\). Ce résultat s’écrit aussi \(R^{\prime}(t) = R(t) J\), où \(J = R(\pi/2)\) est le quart de tour. Ainsi, dériver une rotation revient à tourner encore d’un angle droit.
1.2 Fonctions de classe \(\mathcal{C}^k\)
Les dérivées successives \(f^{(k)}\) se construisent de proche en proche, en dérivant la précédente. On dit que \(f\) est \(\mathcal{C}^k\) sur \(I\) lorsque \(f^{(k)}\) existe et reste continue sur \(I\), et qu’elle est \(\mathcal{C}^\infty\) lorsque cela vaut quel que soit l’entier \(k\).
D’après la propriété précédente, \(f\) est de classe \(\mathcal{C}^k\) si et seulement si toutes ses coordonnées le sont dans une base fixée. Par conséquent, les combinaisons linéaires de fonctions de classe \(\mathcal{C}^k\) restent de classe \(\mathcal{C}^k\).
Piège à éviter :
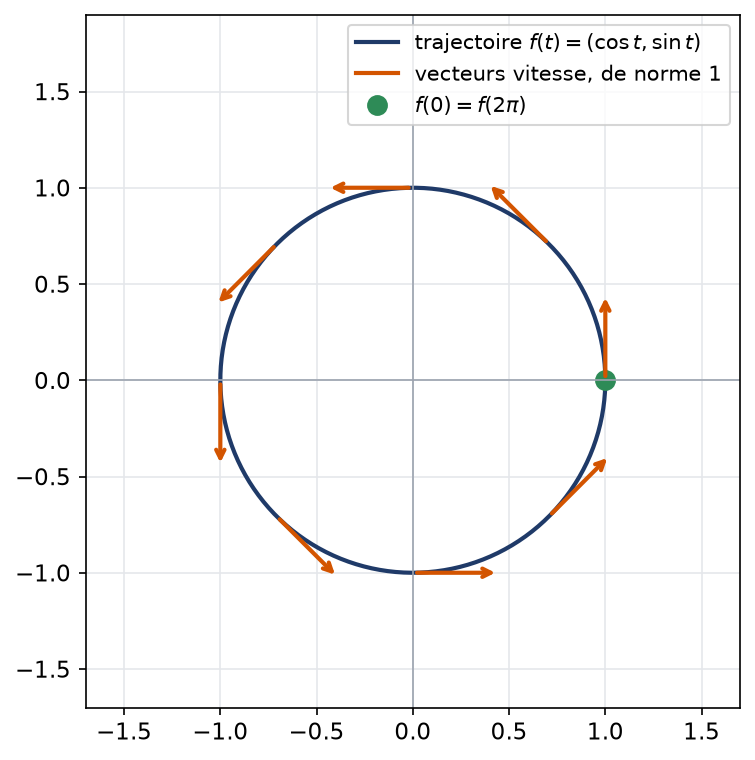
Pour une fonction vectorielle, Rolle tombe en défaut. Prenons \(f(t) = (\cos t, \sin t)\) sur \([0, 2\pi]\). On a bien \(f(0) = f(2\pi)\). Pourtant, \(f^{\prime}(t) = (-\sin t, \cos t)\) est de norme 1 pour tout \(t\) : il ne s’annule jamais. Un point qui revient à son départ n’a donc aucune raison de s’arrêter en chemin.
2. Les règles de dérivation vectorielle
Les fonctions vectorielles se combinent par des applications linéaires, bilinéaires ou multilinéaires : produit scalaire, produit de matrices, déterminant. Chaque type d’opération possède sa règle de dérivation. Toutes découlent du développement limité d’ordre 1.
2.1 Image par une application linéaire
Prenons une application linéaire \(L\) de \(E\) vers un espace \(F\), lui aussi de dimension finie. Dès que \(f\) admet une dérivée en \(a\), la composée \(L \circ f\) en admet une, et \((L \circ f)^{\prime}(a) = L\big(f^{\prime}(a)\big)\).
Par linéarité, \(\frac{1}{h}\big(L(f(a + h)) – L(f(a))\big) = L\Big(\frac{1}{h}\big(f(a + h) – f(a)\big)\Big)\). Or \(L\) est continue, puisque \(E\) est de dimension finie. On passe donc à la limite à l’intérieur de \(L\).
Par exemple, la trace est linéaire : \(\big(\mathrm{tr}\, A(t)\big)^{\prime} = \mathrm{tr}\big(A^{\prime}(t)\big)\). De même, la transposée vérifie \(\big(A(t)^{T}\big)^{\prime} = A^{\prime}(t)^{T}\).
2.2 Fonctions bilinéaires : produit scalaire, produit matriciel
Soit \(E_1\), \(E_2\), \(F\) trois espaces de dimension finie et \(B : E_1 \times E_2 \to F\) bilinéaire. Si \(f : I \to E_1\) et \(g : I \to E_2\) sont dérivables, alors \(t \mapsto B(f(t), g(t))\) est dérivable et
\[\big(B(f, g)\big)^{\prime} = B(f^{\prime}, g) + B(f, g^{\prime}).\]
Écrivons \(f(a + h) = f(a) + h f^{\prime}(a) + h\varepsilon_1(h)\) et \(g(a + h) = g(a) + h g^{\prime}(a) + h\varepsilon_2(h)\), où \(\varepsilon_1\) et \(\varepsilon_2\) tendent vers 0. En développant par bilinéarité, on obtient \(B(f(a), g(a))\), puis le terme \(h\big(B(f^{\prime}(a), g(a)) + B(f(a), g^{\prime}(a))\big)\), et enfin des termes en \(h^2\) ou en \(h\varepsilon_i(h)\).
En dimension finie, toute application bilinéaire vérifie \(\|B(x, y)\| \leq C \|x\|\,\|y\|\) pour une constante \(C\). Ainsi, ces derniers termes sont des \(o(h)\), ce qui donne le résultat.
Trois cas reviennent sans cesse. D’abord, pour un produit scalaire, \((f \mid g)^{\prime} = (f^{\prime} \mid g) + (f \mid g^{\prime})\). Ensuite, pour des fonctions matricielles, \((AB)^{\prime} = A^{\prime} B + A B^{\prime}\). Enfin, pour une fonction réelle \(\lambda\), on a \((\lambda f)^{\prime} = \lambda^{\prime} f + \lambda f^{\prime}\).
Si \(E\) est euclidien et \(f\) dérivable, alors \(\big(\|f\|^2\big)^{\prime} = 2 (f \mid f^{\prime})\). En particulier, la norme de \(f\) reste fixe sur \(I\) exactement lorsque \(f(t) \perp f^{\prime}(t)\) à chaque instant \(t\).
Soit \(f : \mathbb{R} \to \mathbb{R}^3\) de classe \(\mathcal{C}^2\) telle que \(f^{\prime\prime} = -f\). Nous montrons que la quantité \(\mathcal{E} = \|f\|^2 + \|f^{\prime}\|^2\) est constante, comme une énergie conservée.
D’abord, le corollaire donne \(\big(\|f\|^2\big)^{\prime} = 2(f \mid f^{\prime})\). Ensuite, de même, \(\big(\|f^{\prime}\|^2\big)^{\prime} = 2(f^{\prime} \mid f^{\prime\prime}) = -2(f^{\prime} \mid f)\). En additionnant, \(\mathcal{E}^{\prime} = 0\) sur l’intervalle \(\mathbb{R}\). Par conséquent, \(\mathcal{E}\) est constante. Par exemple, pour \(f(t) = (\cos t, 2\sin t, 0)\), on trouve \(\mathcal{E} = 5\) à chaque instant.
Piège à éviter :
Le produit matriciel n’est pas commutatif, donc l’ordre des facteurs doit être conservé. Ainsi, \((A^2)^{\prime} = A^{\prime} A + A A^{\prime}\), qui diffère en général de \(2 A A^{\prime}\). Par exemple, avec \(A(t) = \begin{pmatrix} t & \mathrm{e}^t \\ 1 & t^2 \end{pmatrix}\), on trouve en \(0\) : \(A^{\prime} A + A A^{\prime} = \begin{pmatrix} 1 & 1 \\ 1 & 1 \end{pmatrix}\), alors que \(2 A A^{\prime} = \begin{pmatrix} 0 & 0 \\ 2 & 2 \end{pmatrix}\).
2.3 Fonctions multilinéaires et déterminant
Soit \(M : E_1 \times \cdots \times E_p \to F\) multilinéaire, les espaces étant de dimension finie. Si \(f_1, \ldots, f_p\) sont dérivables, alors \(M(f_1, \ldots, f_p)\) est dérivable, et sa dérivée est la somme des \(p\) termes obtenus en dérivant un seul facteur à la fois :
\[\big(M(f_1, \ldots, f_p)\big)^{\prime} = \sum_{i=1}^{p} M(f_1, \ldots, f_{i-1}, f_i^{\prime}, f_{i+1}, \ldots, f_p).\]
La preuve reprend celle du cas bilinéaire, avec \(p\) facteurs au lieu de deux. L’application la plus importante concerne le déterminant, qui est multilinéaire par rapport aux colonnes.
- Écrire \(\Delta(t) = \det\big(C_1(t), \ldots, C_n(t)\big)\), où les \(C_j\) sont des colonnes dérivables.
- Former les \(n\) déterminants obtenus en remplaçant une seule colonne \(C_j\) par sa dérivée \(C_j^{\prime}\).
- Additionner : \(\Delta^{\prime} = \sum_{j=1}^{n} \det(C_1, \ldots, C_j^{\prime}, \ldots, C_n)\). La même formule vaut en dérivant les lignes une à une.
- Repérer les déterminants nuls : deux colonnes égales ou proportionnelles annulent un terme.
Soit \(A \in \mathcal{M}_n(\mathbb{R})\) et \(\varphi(t) = \det(I_n + tA)\). Nous calculons \(\varphi^{\prime}(0)\). La \(j\)-ième colonne de \(I_n + tA\) vaut \(e_j + t A_j\), où \(A_j\) est la \(j\)-ième colonne de \(A\). Sa dérivée est \(A_j\).
En \(t = 0\), le \(j\)-ième terme de la somme est \(\det(e_1, \ldots, A_j, \ldots, e_n)\). En développant suivant la colonne \(j\), ce déterminant vaut \(a_{jj}\). Par conséquent, \(\varphi^{\prime}(0) = a_{11} + \cdots + a_{nn} = \mathrm{tr}(A)\). Autrement dit, \(\det(I_n + tA) = 1 + t\, \mathrm{tr}(A) + o(t)\).
2.4 Composée avec un changement de paramètre
Soit \(\varphi : J \to I\) une fonction réelle dérivable et \(f : I \to E\) dérivable. Alors \(f \circ \varphi\) est dérivable sur \(J\), et \((f \circ \varphi)^{\prime} = \varphi^{\prime} \cdot (f^{\prime} \circ \varphi)\).
En effet, chaque coordonnée \(f_i \circ \varphi\) se dérive par la règle réelle de dérivation des composées. Notons que le facteur \(\varphi^{\prime}\) est un scalaire, placé devant un vecteur.
- Identifier l’application bilinéaire \(B\) et les deux fonctions qu’elle reçoit, par exemple \(f \circ \varphi\) et \(g \circ \psi\).
- Appliquer la règle bilinéaire : \(B(f \circ \varphi, g \circ \psi)^{\prime} = B\big((f \circ \varphi)^{\prime}, g \circ \psi\big) + B\big(f \circ \varphi, (g \circ \psi)^{\prime}\big)\).
- Remplacer chaque dérivée de composée, puis sortir les scalaires par bilinéarité : on obtient \(\varphi^{\prime}\, B(f^{\prime} \circ \varphi, g \circ \psi) + \psi^{\prime}\, B(f \circ \varphi, g^{\prime} \circ \psi)\).
Soit \(\gamma(t) = (\cos t, \sin t)\) et \(u(t) = \det\big(\gamma(t), \gamma(2t)\big)\), le déterminant étant bilinéaire sur \(\mathbb{R}^2\). La méthode donne \(u^{\prime}(t) = \det\big(\gamma^{\prime}(t), \gamma(2t)\big) + 2\det\big(\gamma(t), \gamma^{\prime}(2t)\big)\).
Le premier terme vaut \(-\sin t \sin 2t – \cos t \cos 2t = -\cos t\). Le second vaut \(2(\cos t \cos 2t + \sin t \sin 2t) = 2\cos t\). Ainsi, \(u^{\prime}(t) = \cos t\). On contrôle directement : \(u(t) = \cos t \sin 2t – \sin t \cos 2t = \sin t\), dont la dérivée est bien \(\cos t\).
3. Intégrer une fonction vectorielle sur un segment
Nous intégrons maintenant une fonction \(f : [a, b] \to E\) continue par morceaux. L’idée est encore de travailler coordonnée par coordonnée, puis de vérifier que le résultat ne dépend pas de la base.
Soit \((e_1, \ldots, e_n)\) une base de \(E\) et \(f = \sum f_i e_i\). On pose \(\int_a^b f = \sum_{i=1}^{n} \Big(\int_a^b f_i\Big) e_i\). Changer de base donne le même vecteur.
Cette invariance provient de la linéarité de l’intégrale réelle : un changement de base exprime les nouvelles coordonnées comme combinaisons linéaires fixes des anciennes. On retrouve ensuite toutes les propriétés usuelles.
- Linéarité, et relation de Chasles pour \(c \in [a, b]\).
- Pour \(L\) linéaire de \(E\) vers \(F\), on a \(L\Big(\int_a^b f\Big) = \int_a^b L(f)\).
- Inégalité triangulaire : \(\Big\|\int_a^b f\Big\| \leq \int_a^b \|f\|\) lorsque \(a \leq b\).
- Sommes de Riemann : \(\frac{b – a}{N}\sum_{k=0}^{N-1} f\big(a + k\frac{b – a}{N}\big)\) tend vers \(\int_a^b f\) quand \(N\) tend vers l’infini.
Les points 1, 2 et 4 se lisent sur les coordonnées, puisqu’ils sont vrais pour chaque \(f_i\). Pour le point 3, nous partons d’une somme de Riemann \(S_N\). L’inégalité triangulaire donne \(\|S_N\| \leq \frac{b – a}{N} \sum \|f(x_k)\|\). Le membre de droite est une somme de Riemann de la fonction réelle \(\|f\|\). Enfin, on fait tendre \(N\) vers l’infini, en utilisant la continuité de la norme.
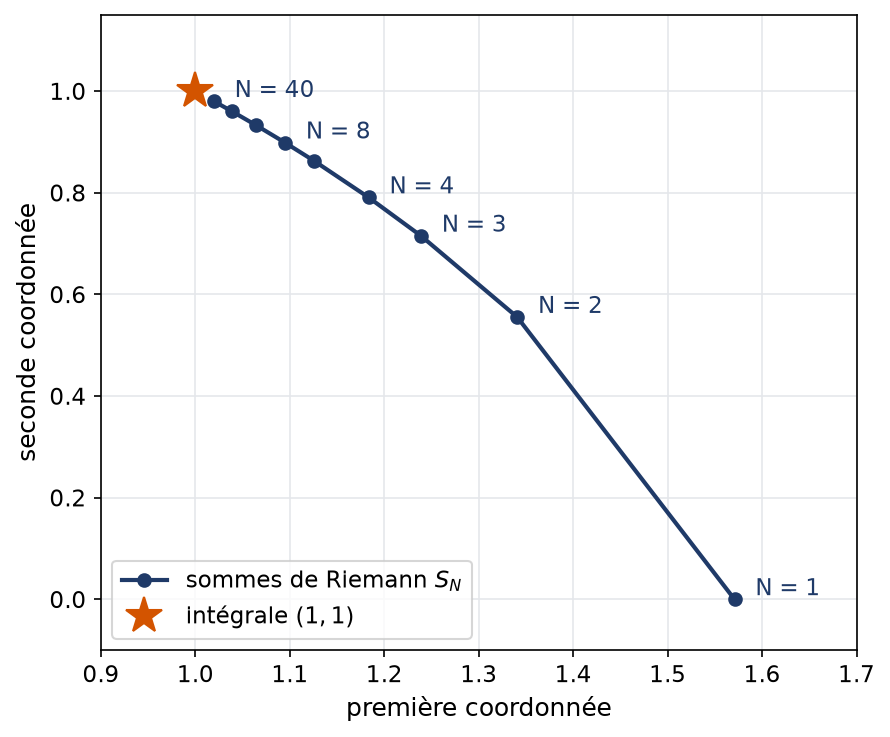
Prenons \(f(t) = (\cos t, \sin t)\) sur \([0, \pi/2]\). Coordonnée par coordonnée, \(\int_0^{\pi/2} f = (1, 1)\), de norme \(\sqrt{2} \approx 1{,}414\). Par ailleurs, \(\|f\| = 1\), donc \(\int_0^{\pi/2} \|f\| = \pi/2 \approx 1{,}571\). L’inégalité triangulaire est vérifiée, et elle est stricte : les vecteurs \(f(t)\) changent de direction, donc leurs contributions se compensent en partie.
Les sommes de Riemann \(S_N\) forment des points du plan qui s’approchent de \((1, 1)\). Pour \(N = 1\), on obtient \((\pi/2, 0)\) ; pour \(N = 2\), on obtient environ \((1{,}34 ; 0{,}56)\).
Si \(f : I \to E\) est continue et \(a \in I\), alors \(F : x \mapsto \int_a^x f\) est l’unique primitive de \(f\) qui s’annule en \(a\). En conséquence, si \(g\) est de classe \(\mathcal{C}^1\) sur \([a, b]\), alors \(g(b) – g(a) = \int_a^b g^{\prime}\).
Pour une fonction matricielle, on intègre chaque coefficient. Par exemple, \(\int_0^{\pi/2} R(s)\,\mathrm{d}s = \begin{pmatrix} 1 & -1 \\ 1 & 1 \end{pmatrix}\) pour la rotation \(R\) de la partie 1. Ce résultat se retrouve sans calcul de coefficient : comme \(R^{\prime} = R J\), on a \(R = R^{\prime} J^{-1}\), donc l’intégrale vaut \(\big(R(\pi/2) – I_2\big) J^{-1}\).
Ce théorème fondamental se démontre encore par coordonnées. Il relie la dérivée et l’intégrale, ce qui ouvre la voie à l’inégalité des accroissements finis.
4. L’inégalité des accroissements finis
Pour une fonction réelle, l’égalité des accroissements finis fournit un point \(c\) tel que \(f(b) – f(a) = (b – a) f^{\prime}(c)\). Pour une fonction vectorielle, cette égalité disparaît, mais une inégalité subsiste, et c’est elle qui sert.
Reprenons \(f(t) = (\cos t, \sin t)\) sur \([0, 2\pi]\). D’une part, \(f(2\pi) – f(0) = 0\). D’autre part, \(f^{\prime}(c)\) n’est jamais nul. Aucun réel \(c\) ne vérifie donc \(f(2\pi) – f(0) = 2\pi f^{\prime}(c)\).
Soit \(f : [a, b] \to E\) de classe \(\mathcal{C}^1\), et \(K \geq 0\) tel que \(\|f^{\prime}(t)\| \leq K\) pour tout \(t \in [a, b]\). Alors
\[\|f(b) – f(a)\| \leq \int_a^b \|f^{\prime}(t)\|\,\mathrm{d}t \leq K (b – a).\]
D’après le théorème fondamental, \(f(b) – f(a) = \int_a^b f^{\prime}\). L’inégalité triangulaire pour les intégrales donne la première inégalité. Ensuite, on majore \(\|f^{\prime}\|\) par \(K\) et on intègre.
Si \(f\) est de classe \(\mathcal{C}^1\) sur un intervalle \(I\) et si \(f^{\prime}\) est nulle sur \(I\), alors \(f\) est constante. Si \(\|f^{\prime}\|\) est majorée par \(K\) sur \(I\), alors \(f\) est \(K\)-lipschitzienne.
Piège à éviter :
Le corollaire exige un intervalle. Sur \(\mathbb{R}^{*}\), la fonction qui vaut \((1, 0)\) pour \(t < 0\) et \((0, 1)\) pour \(t > 0\) a une dérivée nulle partout. Pourtant, elle n’est pas constante. On peut seulement conclure qu’elle est constante sur chacun des deux intervalles \(]-\infty, 0[\) et \(]0, +\infty[\).
- Vérifier que \(f\) est de classe \(\mathcal{C}^1\) sur le segment considéré.
- Calculer \(\|f^{\prime}(t)\|\) avec une norme commode, souvent euclidienne.
- Soit majorer \(\|f^{\prime}\|\) par une constante \(K\), soit intégrer directement \(\|f^{\prime}\|\), ce qui donne une borne plus fine.
- Conclure en précisant la norme utilisée.
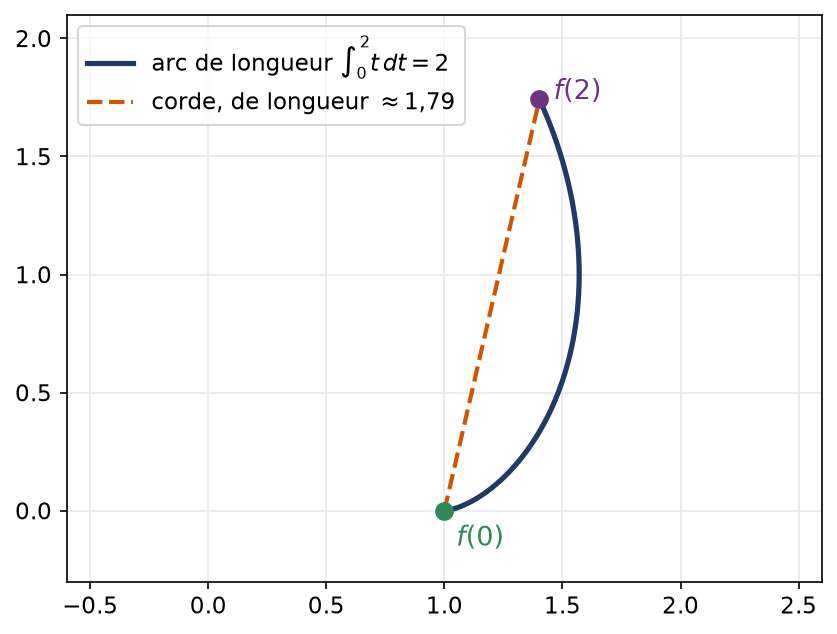
Soit \(f(t) = (\cos t + t \sin t, \sin t – t \cos t)\) sur \([0, 2]\). On calcule \(f^{\prime}(t) = (t \cos t, t \sin t)\), d’où \(\|f^{\prime}(t)\| = t\) pour \(t \geq 0\).
La majoration grossière \(\|f^{\prime}\| \leq 2\) donne \(\|f(2) – f(0)\| \leq 4\). En revanche, l’intégrale donne mieux : \(\|f(2) – f(0)\| \leq \int_0^2 t\,\mathrm{d}t = 2\). La valeur exacte vaut environ \(1{,}79\), ce qui confirme les deux bornes.
Géométriquement, \(\int_a^b \|f^{\prime}\|\) est la longueur de l’arc parcouru entre les instants \(a\) et \(b\). L’inégalité dit donc qu’une corde est toujours plus courte que l’arc qu’elle sous-tend, comme le montre la figure.
5. Les formules de Taylor vectorielles
Les trois formules de Taylor du cas réel se transposent. Deux d’entre elles s’obtiennent coordonnée par coordonnée ; la troisième, qui est une inégalité, passe par la norme d’une intégrale.
5.1 Reste intégral et inégalité de Taylor-Lagrange
Soit \(f : I \to E\) de classe \(\mathcal{C}^{n+1}\), et \(a, b \in I\). Alors on a la formule de Taylor avec reste intégral :
\[f(b) = \sum_{k=0}^{n} \frac{(b – a)^k}{k!} f^{(k)}(a) + \int_a^b \frac{(b – t)^n}{n!} f^{(n+1)}(t)\,\mathrm{d}t.\]
De plus, si \(\|f^{(n+1)}\|\) est majorée par \(K_{n+1}\) entre \(a\) et \(b\), le reste vérifie l’inégalité de Taylor-Lagrange :
\[\Big\|f(b) – \sum_{k=0}^{n} \frac{(b – a)^k}{k!} f^{(k)}(a)\Big\| \leq K_{n+1} \frac{|b – a|^{n+1}}{(n+1)!}.\]
La formule avec reste intégral est vraie pour chaque coordonnée \(f_i\), d’après le cas réel. Elle l’est donc pour \(f\), car l’intégrale vectorielle se calcule coordonnée par coordonnée. Ensuite, supposons \(a \leq b\). L’inégalité triangulaire donne une majoration du reste par \(\int_a^b \frac{(b – t)^n}{n!} K_{n+1}\,\mathrm{d}t\), qui vaut \(K_{n+1}\frac{(b – a)^{n+1}}{(n+1)!}\). Le cas \(b < a\) se traite de même.
5.2 La formule de Taylor-Young
Si \(f : I \to E\) est de classe \(\mathcal{C}^n\) et \(a \in I\), alors, quand \(h\) tend vers 0,
\[f(a + h) = \sum_{k=0}^{n} \frac{h^k}{k!} f^{(k)}(a) + o(h^n).\]
Ici encore, on applique la formule réelle à chaque coordonnée, puis on recompose. Le symbole \(o(h^n)\) désigne un vecteur dont la norme, divisée par \(|h|^n\), tend vers 0.
Soit \(f(t) = (\cos t, \sin t, t)\), qui décrit une hélice de \(\mathbb{R}^3\). On a \(f(0) = (1, 0, 0)\), \(f^{\prime}(0) = (0, 1, 1)\) et \(f^{\prime\prime}(0) = (-1, 0, 0)\). Le développement d’ordre 2 en découle :
\[f(h) = \Big(1 – \frac{h^2}{2},\; h,\; h\Big) + o(h^2).\]
Ensuite, \(\|f^{\prime\prime\prime}(t)\| = \|(\sin t, -\cos t, 0)\| = 1\). L’inégalité de Taylor-Lagrange donne alors un contrôle quantitatif : l’écart entre \(f(h)\) et ce polynôme est au plus \(|h|^3 / 6\) en norme euclidienne.
- Choisir la formule selon le but : Taylor-Young pour une limite ou un équivalent, Taylor-Lagrange pour une majoration explicite, le reste intégral pour une égalité exacte.
- Calculer les dérivées successives en \(a\), coordonnée par coordonnée, ou bien développer chaque coordonnée avec les développements limités usuels.
- Pour Taylor-Lagrange, majorer la norme de \(f^{(n+1)}\) sur tout le segment, et pas seulement au point \(a\).
- Regrouper les termes sous forme vectorielle, puis interpréter : direction limite, position relative, ordre de l’erreur.
Revenons à la boucle \(f(t) = (t^2 – 1, t^3 – t)\), au voisinage de \(t = 1\). Ici, le développement est exact, car les coordonnées sont polynomiales. En effet, \((1 + h)^2 – 1 = 2h + h^2\) et \((1 + h)^3 – (1 + h) = 2h + 3h^2 + h^3\). Donc
\[f(1 + h) = h\,(2, 2) + h^2\,(1, 3) + h^3\,(0, 1).\]
Le premier terme dirige la tangente, de vecteur \((2, 2)\). Ensuite, le déterminant de \((2, 2)\) et \((1, 3)\) vaut \(4\), qui est non nul. Par conséquent, le terme en \(h^2\) écarte la courbe de sa tangente, toujours du même côté, puisque \(h^2 \geq 0\). Près de l’origine, la branche correspondant à \(t\) voisin de 1 reste donc d’un seul côté de sa tangente.
Remarque :
Taylor-Young est une information locale, sans constante explicite. En revanche, Taylor-Lagrange fournit une majoration valable sur tout un segment. Pour estimer une erreur numérique, on choisit donc la seconde.
Les erreurs fréquentes
- Appliquer le théorème de Rolle ou l’égalité des accroissements finis à une fonction vectorielle.
- Écrire \((A^2)^{\prime} = 2 A A^{\prime}\) pour une fonction matricielle, alors que l’ordre des facteurs compte.
- Oublier un terme en dérivant un déterminant : il y en a autant que de colonnes.
- Oublier le facteur \(\varphi^{\prime}\) en dérivant \(f \circ \varphi\), ou le placer à l’intérieur d’une application bilinéaire sans justification.
- Majorer \(\|f(b) – f(a)\|\) sans vérifier que \(f\) est de classe \(\mathcal{C}^1\) sur tout le segment.
Fiche mémo
- En dimension finie, on dérive et on intègre coordonnée par coordonnée, dans n’importe quelle base.
- \((L \circ f)^{\prime} = L(f^{\prime})\) pour \(L\) linéaire.
- \(B(f, g)^{\prime} = B(f^{\prime}, g) + B(f, g^{\prime})\) pour \(B\) bilinéaire.
- Dérivée d’un déterminant : somme des déterminants où une seule colonne est dérivée.
- \((f \circ \varphi)^{\prime} = \varphi^{\prime} \cdot (f^{\prime} \circ \varphi)\).
- \(\|f\|\) constante si et seulement si \(f \perp f^{\prime}\), en euclidien.
- \(\big\|\int_a^b f\big\| \leq \int_a^b \|f\|\), et \(\|f(b) – f(a)\| \leq \int_a^b \|f^{\prime}\|\).
- Pas de Rolle ni d’égalité des accroissements finis pour les fonctions vectorielles.
- Taylor avec reste intégral et Taylor-Young : par coordonnées ; Taylor-Lagrange : par la norme.
Questions fréquentes
Peut-on appliquer le théorème de Rolle à une fonction à valeurs dans le plan ?
Non. Le mouvement uniforme sur un cercle revient à son point de départ sans que sa vitesse s’annule jamais. Pour les fonctions vectorielles, on dispose seulement de l’inégalité des accroissements finis, qui majore la norme de f(b) – f(a).
Comment dériver le carré d'une fonction matricielle ?
On applique la règle du produit en respectant l’ordre : la dérivée de A au carré vaut A’A + AA’. Ce n’est égal à 2AA’ que si A et A’ commutent, ce qui est rare. Sous une trace, en revanche, les deux termes ont la même trace.
Combien de termes contient la dérivée d'un déterminant de taille n ?
Elle contient n déterminants : dans chacun, une seule colonne (ou une seule ligne) est remplacée par sa dérivée. Avant de calculer, repérez ceux qui sont nuls parce que deux colonnes y sont égales ou proportionnelles.
Quelle formule de Taylor choisir pour une fonction vectorielle ?
Taylor-Young suffit pour une limite, un équivalent ou l’allure locale d’une courbe. Pour majorer une erreur sur tout un segment, utilisez l’inégalité de Taylor-Lagrange. Le reste intégral donne une égalité exacte, utile pour démontrer une inégalité fine.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur fonctions à valeurs vectorielles
- Bases utiles : Normes, boules et suites dans un espace normé
- Chapitre d’avant : Fonctions développables en série entière
- Chapitre d’après : Intégrabilité sur un intervalle quelconque
- Vérifier ses acquis : QCM de maths spé (MP) sur fonctions à valeurs vectorielles
- Contrôle corrigé en temps limité : Dérivée d'un déterminant de fonctions : contrôle de maths en MP
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «fonctions à valeurs vectorielles en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir Rayon et somme d’une série entière en maths spé (MP)
- Polynôme minimal et lemme des noyaux en maths spé (MP)
- Intégrabilité sur un intervalle en maths spé (MP)
- Z/nZ, idéaux et théorème chinois en maths spé (MP)
- Lois géométrique et de Poisson en maths spé (MP)
- Sous-espaces stables et spectre en maths spé (MP)

Exercices corrigés
Tout voir
Contrôles
Tout voir
QCM
Tout voir