Corrigé des exercices : Variables aléatoires finies en maths sup (MPSI)
Ce corrigé variables MPSI rédige les 18 exercices comme une copie de concours. Chaque solution s’ouvre sur une idée clé, qui indique par où commencer. Ensuite, les lois sont justifiées point par point : épreuves, probabilité de succès, indépendance.
Tous les calculs intermédiaires sont écrits, et les résultats sont souvent contrôlés par une seconde méthode. Soyez attentif aux hypothèses d’indépendance, au carré du coefficient dans une variance et au signe des covariances. De plus, chaque usage de Markov ou de Bienaymé-Tchebychev précise la variable à laquelle l’inégalité s’applique. Plusieurs figures illustrent enfin les lois obtenues. Pour progresser, cherchez d’abord seul, puis lisez la solution et reprenez votre rédaction là où elle manquait de précision.
Pour démarrer
Corrigé de l’exercice 1 – Loi et espérance de X au carré moins X
Idée clé : on calcule l’image de chaque valeur de \(X\), puis on regroupe les valeurs qui ont la même image.
- Par définition, \(E(X)=-2\times0{,}1-1\times0{,}2+0\times0{,}3+1\times0{,}25+2\times0{,}15\). Ainsi, \(E(X)=-0{,}2-0{,}2+0{,}25+0{,}3\). Donc \(E(X)=0{,}15\).
- La fonction \(x\mapsto x^2-x\) envoie \(-2\) sur \(6\), \(-1\) sur \(2\), \(0\) et \(1\) sur \(0\), et \(2\) sur \(2\). Par conséquent, \(Y(\Omega)=\{0,2,6\}\). En regroupant, \(P(Y=0)=0{,}3+0{,}25=0{,}55\), \(P(Y=2)=0{,}2+0{,}15=0{,}35\) et \(P(Y=6)=0{,}1\). La somme vaut bien \(1\). Ensuite, \(E(Y)=2\times0{,}35+6\times0{,}1\). Donc \(E(Y)=1{,}3\).
- La formule de transfert donne \(E(Y)=\sum_x(x^2-x)P(X=x)\). On obtient \(6\times0{,}1+2\times0{,}2+0+0+2\times0{,}15=0{,}6+0{,}4+0{,}3\). On retrouve \(E(Y)=1{,}3\), sans avoir eu besoin de la loi de \(Y\).
Remarque : la formule de transfert est presque toujours plus rapide. En effet, elle évite de regrouper les antécédents. Cependant, la loi de \(Y\) reste utile dès que l’on veut une probabilité, par exemple \(P(Y\geqslant2)=0{,}45\).
Corrigé de l’exercice 2 – Un questionnaire rempli au hasard
Idée clé : chaque question est une épreuve de Bernoulli, et les réponses sont indépendantes.
- Pour chaque question, il y a deux issues : réponse juste, de probabilité \(\frac{1}{3}\), ou fausse. De plus, les 8 réponses sont données indépendamment. Enfin, \(X\) compte les succès. Donc \(X\) suit la loi \(\mathcal{B}\big(8,\frac{1}{3}\big)\).
- On passe par l’événement contraire : \(P(X\geqslant2)=1-P(X=0)-P(X=1)\). Or \(P(X=0)=\left(\frac{2}{3}\right)^8=\frac{256}{6561}\) et \(P(X=1)=8\cdot\frac{1}{3}\cdot\left(\frac{2}{3}\right)^7=\frac{1024}{6561}\). Ainsi, \(P(X\geqslant2)=\frac{5281}{6561}\approx0{,}805\).
- Le candidat a \(X\) bonnes réponses et \(8-X\) mauvaises. Donc \(S=3X-(8-X)=4X-8\). Ensuite, \(E(X)=\frac{8}{3}\) et \(V(X)=8\cdot\frac{1}{3}\cdot\frac{2}{3}=\frac{16}{9}\). Par linéarité, \(E(S)=\frac{32}{3}-8\), et \(V(S)=16\,V(X)\). Ainsi, \(E(S)=\frac{8}{3}\) et \(V(S)=\frac{256}{9}\).
Remarque : l’espérance de la note est positive, mais faible. En moyenne, répondre au hasard rapporte donc \(\frac{8}{3}\) points sur 24. De plus, l’écart type de la note vaut \(\frac{16}{3}\approx5{,}3\) : le hasard produit des notes très dispersées.
Corrigé de l’exercice 3 – König-Huygens sur une loi à trois valeurs
Idée clé : on calcule les deux premiers moments, puis on applique \(V(Z)=E(Z^2)-E(Z)^2\).
- D’abord, \(E(Z)=\frac{1}{2}+\frac{2}{3}+\frac{5}{6}=\frac{3+4+5}{6}=2\). Ensuite, par transfert, \(E(Z^2)=\frac{1}{2}+\frac{4}{3}+\frac{25}{6}=\frac{3+8+25}{6}=6\). Par conséquent, \(V(Z)=6-4=2\) et \(\sigma(Z)=\sqrt{2}\).
- Par linéarité, \(E(3-2Z)=3-2E(Z)=-1\). De plus, \(V(3-2Z)=(-2)^2V(Z)\). Donc \(E(3-2Z)=-1\) et \(V(3-2Z)=8\). On note que la constante \(3\) n’intervient pas dans la variance.
Corrigé de l’exercice 4 – Lire une loi conjointe et tester l’indépendance
Idée clé : les marginales s’obtiennent en sommant les lignes et les colonnes ; l’indépendance se vérifie case par case.
- En sommant sur \(Y\), on trouve \(P(X=0)=0{,}2\), \(P(X=1)=0{,}5\) et \(P(X=2)=0{,}3\). De même, en sommant sur \(X\), \(P(Y=-1)=0{,}08+0{,}2+0{,}12=0{,}4\) et \(P(Y=1)=0{,}6\). Ce sont les lois marginales.
- On vérifie les six produits : \(0{,}2\times0{,}4=0{,}08\), \(0{,}2\times0{,}6=0{,}12\), \(0{,}5\times0{,}4=0{,}2\), \(0{,}5\times0{,}6=0{,}3\), \(0{,}3\times0{,}4=0{,}12\) et \(0{,}3\times0{,}6=0{,}18\). Chaque case de la loi conjointe est le produit des marges. Donc \(X\) et \(Y\) sont indépendantes.
- D’une part, par indépendance, \(E(XY)=E(X)E(Y)\), avec \(E(X)=0{,}5+0{,}6=1{,}1\) et \(E(Y)=-0{,}4+0{,}6=0{,}2\). D’autre part, par transfert, \(E(XY)=1\times(-0{,}2+0{,}3)+2\times(-0{,}12+0{,}18)=0{,}1+0{,}12\). Les deux méthodes donnent \(E(XY)=0{,}22\).
Remarque : ce test d’indépendance doit porter sur toutes les cases. Ici, il suffirait d’en vérifier deux, bien choisies, grâce aux sommes de lignes et de colonnes. Toutefois, en copie, on conseille de les écrire toutes : la vérification ne coûte que quelques secondes.
Corrigé de l’exercice 5 – L’inégalité de Markov peut être une égalité
Idée clé : l’inégalité de Markov est atteinte quand la variable ne prend que les valeurs \(0\) et \(a\).
- La variable \(X\) est positive, donc l’inégalité de Markov s’applique. Ainsi, \(P(X\geqslant10)\leqslant\frac{3}{10}\).
- Soit \(X\) valant \(10\) avec probabilité \(0{,}3\) et \(0\) sinon. Alors \(X\geqslant0\) et \(E(X)=10\times0{,}3=3\). De plus, \(P(X\geqslant10)=0{,}3\). La majoration est donc optimale.
- La variable constante égale à \(3\) vérifie \(P(X\geqslant2)=1\) : c’est possible. En revanche, Markov impose \(P(X\geqslant4)\leqslant\frac{3}{4}=0{,}75<0{,}8\). Donc \(P(X\geqslant4)=0{,}8\) est impossible.
Corrigé de l’exercice 6 – Covariance de deux indicatrices
Idée clé : le produit de deux indicatrices est l’indicatrice de l’intersection.
- On a \(\mathbf{1}_A\mathbf{1}_B=\mathbf{1}_{A\cap B}\), donc \(E(\mathbf{1}_A\mathbf{1}_B)=P(A\cap B)\). De plus, \(E(\mathbf{1}_A)=P(A)\) et \(E(\mathbf{1}_B)=P(B)\). Ainsi, \(\operatorname{Cov}(\mathbf{1}_A,\mathbf{1}_B)=P(A\cap B)-P(A)P(B)\).
- Si les indicatrices sont indépendantes, leur covariance est nulle. Réciproquement, si elle est nulle, \(A\) et \(B\) sont indépendants. Alors \(A\) et \(\overline{B}\), \(\overline{A}\) et \(B\), \(\overline{A}\) et \(\overline{B}\) le sont aussi. Or ces quatre égalités donnent exactement \(P(\mathbf{1}_A=i,\mathbf{1}_B=j)=P(\mathbf{1}_A=i)P(\mathbf{1}_B=j)\). Donc l’indépendance équivaut à une covariance nulle.
- Ici, \(A=\{2,4,6\}\), \(B=\{4,5,6\}\) et \(A\cap B=\{4,6\}\). Donc \(P(A\cap B)=\frac{1}{3}\) et \(P(A)P(B)=\frac{1}{4}\). La covariance vaut \(\frac{1}{12}\) : les deux événements ne sont pas indépendants.
Pour s’entraîner
Remarque : une covariance positive traduit ici une tendance commune. En effet, savoir que le résultat est pair augmente la probabilité qu’il soit grand, puisque deux des trois faces paires sont au moins égales à 4. Autrement dit, \(P(B\mid A)=\frac{2}{3}>P(B)=\frac{1}{2}\).
Corrigé de l’exercice 7 – Somme et maximum de deux dés à quatre faces
Idée clé : la loi de la somme se lit sur les diagonales du tableau des 16 issues ; celle du maximum s’obtient par \(P(M\leqslant k)\).
- La variable \(D_1\) est uniforme sur \([\![1,4]\!]\). Ainsi, \(E(D_1)=\frac{1+2+3+4}{4}=\frac{5}{2}\) et \(E(D_1^2)=\frac{1+4+9+16}{4}=\frac{15}{2}\). Donc \(E(D_1)=\frac{5}{2}\) et \(V(D_1)=\frac{15}{2}-\frac{25}{4}=\frac{5}{4}\).
- Les 16 couples sont équiprobables. En comptant les couples de somme \(s\), on obtient \(P(S=s)=\frac{4-|s-5|}{16}\) pour \(s\in[\![2,8]\!]\), soit \(\frac{1}{16},\frac{2}{16},\frac{3}{16},\frac{4}{16},\frac{3}{16},\frac{2}{16},\frac{1}{16}\). D’abord, la loi est symétrique par rapport à \(5\), donc \(E(S)=5\). Ensuite, par transfert, \(E(S^2)=\frac{4+18+48+100+108+98+64}{16}=\frac{440}{16}\), d’où \(V(S)=27{,}5-25\). Autre méthode : linéarité pour l’espérance, et indépendance pour la variance. Dans les deux cas, \(E(S)=5\) et \(V(S)=2\times\frac{5}{4}=\frac{5}{2}\).
- L’événement \((M\leqslant k)\) est \((D_1\leqslant k)\cap(D_2\leqslant k)\). Par indépendance, \(P(M\leqslant k)=\frac{k^2}{16}\). Ensuite, \(P(M=k)=P(M\leqslant k)-P(M\leqslant k-1)=\frac{2k-1}{16}\). On obtient \(\frac{1}{16},\frac{3}{16},\frac{5}{16},\frac{7}{16}\). Enfin, \(E(M)=\frac{1+6+15+28}{16}=\frac{25}{8}\).
La figure présente la loi de \(S\), en forme de triangle centré sur l’espérance.
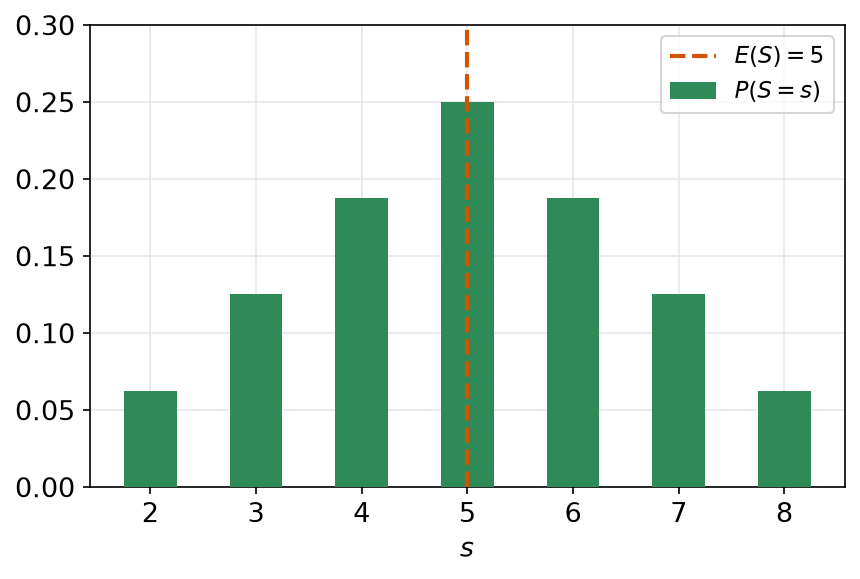
Remarque : la seconde méthode est bien plus courte. D’abord, la linéarité donne \(E(S)=2E(D_1)\). Ensuite, l’indépendance de \(D_1\) et \(D_2\) permet d’additionner les variances. Enfin, on note que \(E(M)=\frac{25}{8}\) dépasse \(E(D_1)=\frac{5}{2}\), ce qui est cohérent : le maximum est plus grand que chacun des deux dés.
Corrigé de l’exercice 8 – Variance du nombre de boîtes vides
Idée clé : on développe le carré d’une somme d’indicatrices ; les produits deviennent des intersections.
- D’après le cours, \(N\) est la somme des \(n\) indicatrices \(\mathbf{1}_{A_i}\), et \(P(A_i)=\left(1-\frac{1}{n}\right)^k\). Donc \(E(N)=n\left(1-\frac{1}{n}\right)^k\).
- L’événement \(A_i\cap A_j\) signifie que chaque boule évite les deux boîtes \(i\) et \(j\). Chaque boule le fait avec probabilité \(1-\frac{2}{n}\), indépendamment des autres. Donc \(P(A_i\cap A_j)=\left(1-\frac{2}{n}\right)^k\).
- On développe : \(N^2=\sum_i\mathbf{1}_{A_i}+\sum_{i\neq j}\mathbf{1}_{A_i\cap A_j}\), car \(\mathbf{1}_{A_i}^2=\mathbf{1}_{A_i}\). Ainsi, \(E(N^2)=n\left(1-\frac{1}{n}\right)^k+n(n-1)\left(1-\frac{2}{n}\right)^k\). König-Huygens donne alors :
\[V(N)=n\Big(1-\frac{1}{n}\Big)^k+n(n-1)\Big(1-\frac{2}{n}\Big)^k-n^2\Big(1-\frac{1}{n}\Big)^{2k}.\] - Pour \(n=3\) et \(k=4\), on a \(E(N)=3\times\frac{16}{81}=\frac{16}{27}\). Ensuite, \(E(N^2)=\frac{16}{27}+6\times\frac{1}{81}=\frac{54}{81}=\frac{2}{3}\). Donc \(V(N)=\frac{2}{3}-\frac{256}{729}=\frac{230}{729}\approx0{,}32\).
Remarque : on peut contrôler la formule de \(V(N)\) sur un cas évident. Avec \(k=1\) boule et \(n\) boîtes, il y a toujours \(n-1\) boîtes vides. La formule donne alors \((n-1)+(n-1)(n-2)-(n-1)^2=0\), ce qui est bien la variance d’une constante.
Corrigé de l’exercice 9 – Tirages sans remise et indicatrices
Idée clé : par symétrie, la \(i\)-ème boule tirée suit la même loi que la première ; seules les covariances changent par rapport au cas avec remise.
- Numérotons les 12 boules. Tous les tirages ordonnés de 4 boules distinctes sont équiprobables. Or la \(i\)-ème boule est rouge dans \(5\times11\times10\times9\) d’entre eux, sur \(12\times11\times10\times9\). Donc \(P(R_i)=\frac{5}{12}\). Ensuite, \(X=\sum_{i=1}^{4}\mathbf{1}_{R_i}\), et la linéarité donne \(E(X)=4\times\frac{5}{12}=\frac{5}{3}\).
- De même, pour \(i\neq j\), on compte \(5\times4\times10\times9\) tirages favorables. Ainsi, \(P(R_i\cap R_j)=\frac{5\times4}{12\times11}=\frac{5}{33}\). Par l’exercice 6, \(\operatorname{Cov}(\mathbf{1}_{R_i},\mathbf{1}_{R_j})=\frac{5}{33}-\frac{25}{144}=-\frac{35}{1584}\).
- Chaque indicatrice a pour variance \(\frac{5}{12}\cdot\frac{7}{12}=\frac{35}{144}\). Il y a \(6\) paires \(i<j\). Donc \(V(X)=4\times\frac{35}{144}-2\times6\times\frac{35}{1584}=\frac{35}{36}-\frac{35}{132}\). Ainsi, \(V(X)=\frac{70}{99}\approx0{,}71\). Avec remise, \(X\) suivrait \(\mathcal{B}\big(4,\frac{5}{12}\big)\), de variance \(\frac{35}{36}\approx0{,}97\). Le tirage sans remise réduit donc la dispersion, car les covariances sont négatives.
Remarque : le résultat \(P(R_i)=\frac{5}{12}\) surprend souvent. Pourtant, il exprime simplement que l’ordre des tirages ne favorise aucune position. En revanche, les événements \(R_i\) ne sont pas indépendants, ce que montre la covariance négative : une boule rouge tirée rend la suivante un peu moins probable.
Corrigé de l’exercice 10 – Covariance et variance d’une somme sur un tableau
Idée clé : on calcule les moments marginaux, puis \(E(XY)\) par transfert sur les seules cases où \(xy\neq0\).
- On trouve \(P(X=1)=0{,}6\) et \(P(X=0)=0{,}4\). De plus, \(P(Y=0)=0{,}15\), \(P(Y=1)=0{,}35\) et \(P(Y=2)=0{,}5\). Donc \(E(X)=0{,}6\) et \(V(X)=0{,}6\times0{,}4=0{,}24\). Ensuite, \(E(Y)=0{,}35+1=1{,}35\) et \(E(Y^2)=0{,}35+2=2{,}35\). Ainsi, \(V(Y)=2{,}35-1{,}8225=0{,}5275\).
- Par transfert, \(E(XY)=1\times1\times0{,}15+1\times2\times0{,}4=0{,}95\). Donc \(\operatorname{Cov}(X,Y)=0{,}95-0{,}6\times1{,}35=0{,}14\). La covariance est non nulle, donc \(X\) et \(Y\) ne sont pas indépendantes.
- On applique la formule de la variance d’une somme. D’une part, \(V(X+Y)=0{,}24+0{,}5275+2\times0{,}14=1{,}0475\). D’autre part, \(V(X-Y)=0{,}7675-0{,}28=0{,}4875\).
Corrigé de l’exercice 11 – Combien de lancers pour estimer la fréquence du six
Idée clé : \(nF_n\) suit une loi binomiale, ce qui donne les deux moments de \(F_n\).
- Le nombre de six \(nF_n\) suit la loi \(\mathcal{B}\big(n,\frac{1}{6}\big)\), car les lancers sont indépendants. Donc \(E(nF_n)=\frac{n}{6}\) et \(V(nF_n)=\frac{5n}{36}\). Par conséquent, \(E(F_n)=\frac{1}{6}\) et \(V(F_n)=\frac{5}{36n}\).
- L’inégalité de Bienaymé-Tchebychev avec \(\varepsilon=0{,}05\) donne \(P\big(|F_n-\frac{1}{6}|\geqslant0{,}05\big)\leqslant\frac{5}{36n\times0{,}0025}\). Le majorant vaut \(\frac{500}{9n}\).
- Par passage au contraire, \(P\big(|F_n-\frac{1}{6}|<0{,}05\big)\geqslant1-\frac{500}{9n}\). Il suffit donc que \(\frac{500}{9n}\leqslant0{,}1\), c’est-à-dire \(n\geqslant\frac{5000}{9}\approx555{,}6\). Ainsi, \(n=556\) lancers suffisent.
Remarque : la valeur \(556\) n’est qu’une valeur suffisante. En pratique, beaucoup moins de lancers suffisent, car l’inégalité de Bienaymé-Tchebychev est très pessimiste. Néanmoins, elle fournit une garantie rigoureuse, valable sans aucune approximation.
Corrigé de l’exercice 12 – Coalitions de variables de Bernoulli
Idée clé : \(U\) dépend de \((X_1,X_2)\) et \(W\) de \((X_3,X_4)\), deux paquets disjoints.
- Les variables sont mutuellement indépendantes. Par le lemme des coalitions, \(U=f(X_1,X_2)\) et \(W=g(X_3,X_4)\) sont indépendantes. Ensuite, \(U\) compte les succès de deux épreuves indépendantes : \(U\) suit \(\mathcal{B}(2,p)\). Enfin, \(W\) vaut \(1\) si et seulement si \(X_3=X_4=1\). Donc \(W\) suit \(\mathcal{B}(p^2)\).
- Par indépendance, \(P(U=1,W=1)=P(U=1)P(W=1)\). Donc \(P(U=1,W=1)=2p(1-p)\cdot p^2=2p^3(1-p)\).
- Par bilinéarité, \(\operatorname{Cov}(X_1+X_2,X_2+X_3)\) est la somme de quatre covariances. Trois d’entre elles portent sur des variables indépendantes, donc sont nulles. Il reste \(\operatorname{Cov}(X_2,X_2)=V(X_2)\). La covariance vaut \(p(1-p)\neq0\), donc les deux sommes ne sont pas indépendantes.
Remarque : le lemme des coalitions s’applique ici sans calcul. Cependant, il faut toujours vérifier que les deux paquets sont disjoints. Au dernier point, la variable \(X_2\) appartient aux deux paquets, et l’indépendance tombe en défaut.
Corrigé de l’exercice 13 – Covariance nulle et indépendance
Idée clé : pour des variables à deux valeurs, tout se ramène à des indicatrices, pour lesquelles l’exercice 6 conclut.
- On a \(E(X)=0\). De plus, \(XY=X\mathbf{1}_{(X=0)}\) est la variable nulle, donc \(E(XY)=0\). Ainsi, \(\operatorname{Cov}(X,Y)=0\). Pourtant, \(P(X=0,Y=0)=0\), alors que \(P(X=0)P(Y=0)=\frac{1}{3}\times\frac{2}{3}\neq0\). Les variables sont décorrélées sans être indépendantes.
- Posons \(A=(U=1)\) et \(B=(W=1)\). Alors \(U=\mathbf{1}_A\) et \(W=\mathbf{1}_B\). D’après l’exercice 6, \(U\) et \(W\) sont indépendantes si et seulement si \(\operatorname{Cov}(U,W)=0\).
- Posons \(U^{\prime}=\frac{U-a}{b-a}\) et \(W^{\prime}=\frac{W-c}{d-c}\), à valeurs dans \(\{0,1\}\). Ces transformations sont bijectives, donc \(U,W\) sont indépendantes si et seulement si \(U^{\prime},W^{\prime}\) le sont. Ensuite, par bilinéarité, \(\operatorname{Cov}(U,W)=(b-a)(d-c)\operatorname{Cov}(U^{\prime},W^{\prime})\), avec \((b-a)(d-c)\neq0\). Le résultat s’étend donc à toutes les variables à deux valeurs.
Corrigé de l’exercice 14 – Variance nulle et meilleure approximation constante
Idée clé : on fait apparaître \(E(X)\) dans le carré, comme dans une mise sous forme canonique.
- Posons \(m=E(X)\). Par linéarité, \(g(a)=E(X^2)-2am+a^2\). Ainsi, \(g(a)=E(X^2)-m^2+(a-m)^2=V(X)+(a-m)^2\). Donc \(g\) est minimale en \(a=m\), et son minimum vaut \(V(X)\).
- Par transfert, \(V(X)=\sum_{x}(x-m)^2P(X=x)\). Tous les termes étant positifs, cette quantité s’annule exactement lorsque chacun d’eux s’annule, c’est-à-dire si \(P(X=x)=0\) pour tout \(x\neq m\). Ainsi, \(V(X)=0\) équivaut à \(P(X=m)=1\).
- König-Huygens donne \(E(X^2)-E(X)^2=V(X)\geqslant0\). Donc \(E(X)^2\leqslant E(X^2)\), avec égalité si et seulement si \(V(X)=0\). D’après le point précédent, cela signifie que \(X\) est presque sûrement constante.
Corrigé de l’exercice 15 – Somme de deux binomiales indépendantes
Idée clé : on découpe \((X+Y=k)\) selon la valeur de \(X\), puis on reconnaît la formule de Vandermonde.
- L’événement \((X+Y=k)\) est la réunion disjointe des \((X=i)\cap(Y=k-i)\). Par indépendance, \(P(X+Y=k)=\sum_{i}P(X=i)P(Y=k-i)\), la somme portant sur les \(i\) tels que \(0\leqslant i\leqslant m\) et \(0\leqslant k-i\leqslant n\).
- Chaque terme vaut \(\binom{m}{i}p^i(1-p)^{m-i}\binom{n}{k-i}p^{k-i}(1-p)^{n-k+i}\), soit \(\binom{m}{i}\binom{n}{k-i}p^k(1-p)^{m+n-k}\). Ensuite, la formule de Vandermonde donne \(\sum_i\binom{m}{i}\binom{n}{k-i}=\binom{m+n}{k}\). Donc \(X+Y\) suit la loi \(\mathcal{B}(m+n,p)\).
- Par linéarité, \(E(X+Y)=mp+np\). Par indépendance, les variances s’ajoutent. Ainsi, \(E(X+Y)=(m+n)p\) et \(V(X+Y)=(m+n)p(1-p)\), conformément à la loi trouvée.
- Prenons \(X\) de loi \(\mathcal{B}(1,0)\) et \(Y\) de loi \(\mathcal{B}(1,1)\). Alors \(X+Y=1\) presque sûrement. Si \(X+Y\) suivait \(\mathcal{B}(2,s)\), la condition \(P(X+Y=0)=(1-s)^2=0\) imposerait \(s=1\). Mais alors \(P(X+Y=2)=1\), ce qui est faux. Le résultat exige donc le même paramètre \(p\).
Pour approfondir
Remarque : la formule de Vandermonde se démontre elle-même par un argument probabiliste. En effet, on peut compter les parties à \(k\) éléments d’un ensemble de \(m+n\) éléments selon le nombre d’éléments pris dans les \(m\) premiers. C’est exactement le découpage utilisé au premier point.
Corrigé de l’exercice 16 – Doublets consécutifs dans une suite de lancers
Idée clé : les indicatrices de doublets sont deux à deux indépendantes, ce qui suffit pour additionner les variances.
- Pour chaque \(i\), on a \(P(R_i=R_{i+1})=\sum_{a=1}^{6}P(R_i=a)P(R_{i+1}=a)=\frac{6}{36}=\frac{1}{6}\). Par linéarité, \(E(D)=\frac{n-1}{6}\).
- L’événement \((I_i=1)\cap(I_{i+1}=1)\) signifie \(R_i=R_{i+1}=R_{i+2}\), de probabilité \(\frac{6}{216}=\frac{1}{36}=\frac{1}{6}\times\frac{1}{6}\). Les événements \((I_i=1)\) et \((I_{i+1}=1)\) sont donc indépendants, et l’exercice 6 montre que \(I_i\) et \(I_{i+1}\) le sont. Ensuite, si \(|i-j|\geqslant2\), \(I_i\) dépend de \((R_i,R_{i+1})\) et \(I_j\) de \((R_j,R_{j+1})\). Ces paquets sont disjoints, donc le lemme des coalitions conclut.
- Les \(I_i\) sont deux à deux indépendantes, donc toutes les covariances sont nulles. Chaque \(I_i\) suit \(\mathcal{B}\big(\frac{1}{6}\big)\), de variance \(\frac{5}{36}\). Donc \(V(D)=\frac{5(n-1)}{36}\).
- Posons \(J=\mathbf{1}_{(R_1=R_3)}\). Le même calcul qu’au point 2 montre que \(P(I_1=1,J=1)=P(R_1=R_2=R_3)=\frac{1}{36}\), et de même pour \((I_2,J)\). Les trois variables sont donc deux à deux indépendantes. En revanche, \(P(I_1=1,I_2=1,J=1)=\frac{1}{36}\neq\frac{1}{216}\). Elles ne sont pas mutuellement indépendantes : deux doublets consécutifs forcent \(R_1=R_3\).
- Pour \(n=1001\), on a \(E(D)=\frac{1000}{6}\) et \(V(D)=\frac{5000}{36}=\frac{1250}{9}\). Bienaymé-Tchebychev donne \(P\big(|D-E(D)|\geqslant50\big)\leqslant\frac{1250}{9\times2500}\). La probabilité est donc au plus \(\frac{1}{18}\approx0{,}056\).
Remarque : ce problème montre que l’indépendance deux à deux suffit pour additionner les variances. En revanche, elle ne suffit pas pour multiplier trois probabilités. C’est pourquoi la rédaction doit préciser quel type d’indépendance chaque calcul utilise.
Corrigé de l’exercice 17 – Problème sur une marche aléatoire de n pas
Idée clé : le changement de variable \(B_i=\frac{\varepsilon_i+1}{2}\) transforme les pas en épreuves de Bernoulli, et la position en loi binomiale translatée.
- La variable \(B_i\) vaut \(1\) si le pas est \(+1\) et \(0\) sinon. Donc \(B_i\) suit \(\mathcal{B}(p)\). Ensuite, les \(B_i\) sont mutuellement indépendantes, comme fonctions respectives des pas indépendants \(\varepsilon_i\). Ainsi, \(T_n\) suit \(\mathcal{B}(n,p)\). Enfin, \(\varepsilon_i=2B_i-1\), d’où \(S_n=2T_n-n\).
- Comme \(T_n\) prend les valeurs \(0,\dots,n\), la position \(S_n\) prend les valeurs \(-n,-n+2,\dots,n-2,n\), qui ont la parité de \(n\). Pour un tel \(k\), on a \((S_n=k)=\big(T_n=\frac{n+k}{2}\big)\). Donc \(P(S_n=k)=\binom{n}{(n+k)/2}p^{(n+k)/2}(1-p)^{(n-k)/2}\).
- Par linéarité, \(E(S_n)=2np-n\). Ensuite, \(V(S_n)=4V(T_n)\). Ainsi, \(E(S_n)=n(2p-1)\) et \(V(S_n)=4np(1-p)\).
- Pour \(n=4\) et \(p=\frac{1}{2}\), \(P(S_4=k)=\binom{4}{(4+k)/2}\frac{1}{16}\). Les valeurs \(-4,-2,0,2,4\) ont pour probabilités \(\frac{1}{16},\ \frac{1}{4},\ \frac{3}{8},\ \frac{1}{4},\ \frac{1}{16}\). Le retour en \(0\) a donc pour probabilité \(\frac{3}{8}\).
- Pour \(p=\frac{1}{2}\), on a \(E(S_n)=0\) et \(V(S_n)=n\), donc \(E(S_n^2)=V(S_n)+E(S_n)^2=n\). Ensuite, \((|S_n|\geqslant a)=(S_n^2\geqslant a^2)\), et l’inégalité de Markov appliquée à la variable positive \(S_n^2\) donne \(P(|S_n|\geqslant a)\leqslant\frac{n}{a^2}\). Pour \(n=100\) et \(a=30\), on obtient \(P(|S_{100}|\geqslant30)\leqslant\frac{1}{9}\).
La figure montre la loi de \(S_4\) : elle est symétrique et ne charge que les positions paires.
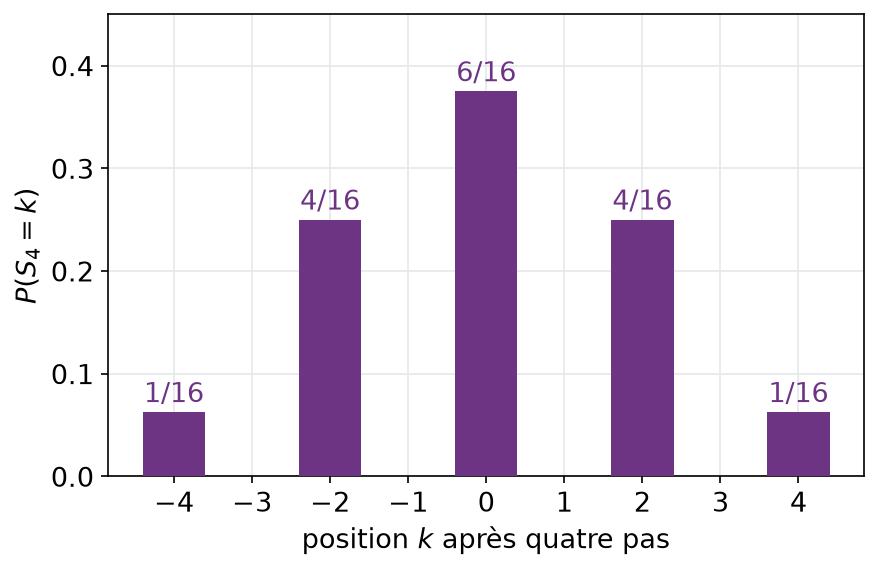
Remarque : la majoration \(\frac{1}{9}\) est grossière. Cependant, elle montre déjà qu’après 100 pas, le pion s’éloigne rarement de plus de 30 cases. Plus généralement, la distance typique à l’origine est de l’ordre de \(\sqrt{n}\), qui est l’écart type de \(S_n\).
Corrigé de l’exercice 18 – Problème sur les tests groupés
Idée clé : le nombre de tests ne dépend que du nombre de groupes positifs, qui suit une loi binomiale grâce au lemme des coalitions.
- Un groupe est négatif si et seulement si ses \(k\) membres sont sains. Par indépendance, cet événement a pour probabilité \(q^k\). Donc le groupe est positif avec probabilité \(r=1-q^k\).
- Notons \(Z_j\) l’indicatrice « le groupe \(j\) est positif ». Elle est fonction des seuls états des membres du groupe \(j\). Or les groupes sont disjoints, et les états sont mutuellement indépendants. Le lemme des coalitions, étendu à \(n\) paquets, montre que \(Z_1,\dots,Z_n\) sont mutuellement indépendantes. Ainsi, \(G=Z_1+\dots+Z_n\) suit la loi \(\mathcal{B}(n,r)\).
- Chaque groupe demande un test, plus \(k\) tests s’il est positif. Donc \(T=n+kG\). Par conséquent, \(E(T)=n+knr\) et \(V(T)=k^2V(G)\). Ainsi, \(E(T)=n+nk(1-q^k)\) et \(V(T)=nk^2q^k(1-q^k)\).
- On divise par \(N=nk\) : \(\frac{E(T)}{N}=\frac{1}{k}+1-q^k\). Pour \(p=0{,}01\), on trouve \(c(5)\approx0{,}249\), \(c(10)\approx0{,}1956\), \(c(11)\approx0{,}1956\) et \(c(12)\approx0{,}1969\). Plus précisément, \(c(11)\approx0{,}19557\) est légèrement inférieur à \(c(10)\approx0{,}19562\). Avec des groupes de 10 ou 11, on fait environ 5 fois moins de tests qu’en testant chacun.
- Ici \(n=100\) et \(r=1-0{,}99^{10}\approx0{,}0956\). Donc \(E(T)=100+1000r\approx195{,}6\). Ensuite, \(V(T)=100\times100\times r(1-r)\approx864{,}8\). L’événement \((T\geqslant300)\) est inclus dans \(\big(|T-E(T)|\geqslant104{,}38\big)\). Bienaymé-Tchebychev donne alors \(P(T\geqslant300)\leqslant\frac{864{,}8}{104{,}38^2}\). Ainsi, \(P(T\geqslant300)\leqslant0{,}08\) environ.
La figure trace le coût moyen par personne en fonction de la taille des groupes. Le minimum est atteint vers \(k=11\).
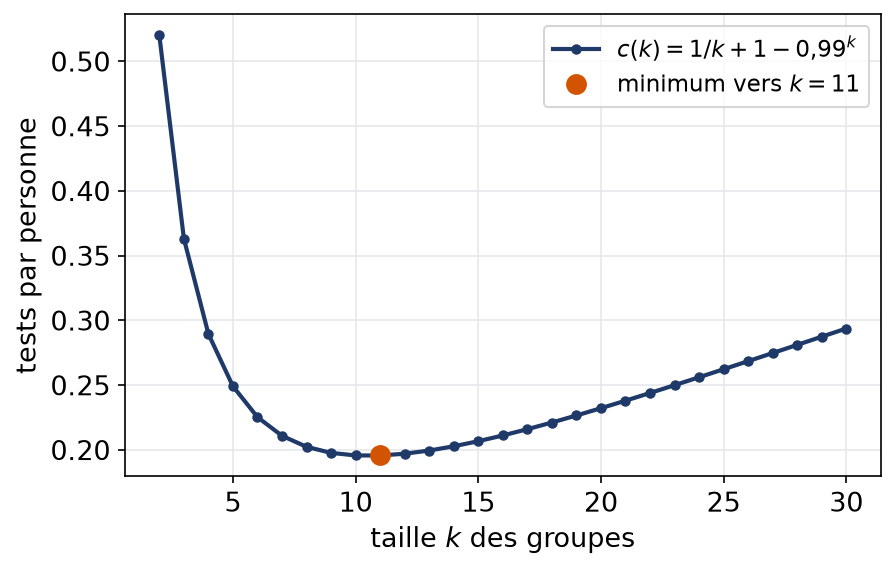
Remarque : le gain est d’autant plus grand que l’infection est rare. Par exemple, si \(p\) devenait égal à \(0{,}2\), le coût \(c(k)\) resterait au-dessus de \(0{,}8\) pour toute taille \(k\). Ainsi, le dépistage groupé n’a d’intérêt que pour une prévalence faible.
Pour aller plus loin
- Revoir la leçon : cours de maths sup (MPSI) sur variables aléatoires finies
- S’exercer : exercices corrigés de maths sup (MPSI) sur variables aléatoires finies
- Bases utiles : Dénombrer et calculer des probabilités conditionnelles
- Chapitre d’avant : Dénombrer et calculer des probabilités conditionnelles
- Chapitre d’après : Produit scalaire, orthogonalité et Gram-Schmidt
- Vérifier ses acquis : QCM de maths sup (MPSI) sur variables aléatoires finies
- Contrôle corrigé en temps limité : Indicatrices et variance d'une somme : contrôle de maths en MPSI
- Le même thème en L2 de maths : Lois discrètes, espérance et variance
- Le même thème en maths spé (MP) : Espérance, variance et covariance d'une variable discrète
- Tous les chapitres : le sommaire de maths sup (MPSI)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «corrigé des exercices : Variables aléatoires finies en maths sup (MPSI)» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths sup (MPSI)
Cours
Tout voir Changement de base et trace en maths sup (MPSI)
- Projecteurs, symétries et hyperplans en maths sup (MPSI)
- IPP et changement de variable en maths sup (MPSI)
- Sommes, produits et binôme en maths sup (MPSI)
- Continuité et valeurs intermédiaires en maths sup (MPSI)
- Borne supérieure et densité en maths sup (MPSI)
Exercices corrigés
Tout voir- IPP et changement de variable en maths sup (MPSI)
- Sous-espaces et supplémentaires en maths sup (MPSI)
- Injections, surjections et relations en maths sup (MPSI)
- Calcul de développements limités en maths sup (MPSI)
- EDL du premier et du second ordre en maths sup (MPSI)
- Racines d’un polynôme et Viète en maths sup (MPSI)
Contrôles
Tout voir
QCM
Tout voir