Changement de base et trace en maths sup (MPSI) : cours et méthodes
Ce chapitre relie deux mondes : les applications linéaires et les matrices. Une fois des bases choisies, chaque application se lit dans un tableau, et chaque calcul devient un produit. Ce cours de changement de base et trace MPSI arrive au second semestre, juste après la dimension finie. Il prépare directement les déterminants, puis la réduction des endomorphismes en spé.
Vous apprendrez d’abord à écrire une matrice colonne par colonne, puis à changer de base sans inverser l’ordre des facteurs. Ensuite, nous calculons des rangs par opérations élémentaires et reconnaissons les systèmes de Cramer. Enfin, les matrices équivalentes, les matrices semblables et la trace fournissent des invariants. Chaque notion est accompagnée d’une méthode rédigée, d’un exemple guidé et des pièges qui coûtent des points en colle.
Ce que vous saurez faire
- Écrire la matrice d’une application linéaire dans des bases données, colonne par colonne.
- Choisir une base adaptée qui rend la matrice d’un endomorphisme presque diagonale.
- Passer d’une base à une autre sans inverser l’ordre des matrices de passage.
- Calculer le rang d’une matrice par opérations élémentaires et reconnaître un système de Cramer.
- Utiliser les matrices équivalentes, la matrice \(J_r\), la transposée et les matrices extraites.
- Exploiter la trace et l’égalité \(\mathrm{tr}(AB)=\mathrm{tr}(BA)\) pour prouver qu’une égalité est impossible.
1. Représenter une application linéaire par une matrice
Le corps de base \(\mathbb{K}\) est \(\mathbb{R}\) ou \(\mathbb{C}\). Nous travaillons avec deux espaces \(E\) et \(F\) de dimensions respectives \(p\) et \(n\), toutes deux finies. D’abord, nous fixons une base \(\mathcal{B}=(e_1,\dots,e_p)\) de \(E\) et une base \(\mathcal{C}=(f_1,\dots,f_n)\) de \(F\). Ensuite, une application linéaire est entièrement déterminée par les images des \(e_j\). Ainsi, il suffit de ranger ces images dans un tableau.
Soit \(u\in\mathcal{L}(E,F)\). La matrice de \(u\) dans les bases \(\mathcal{B}\) et \(\mathcal{C}\) est la matrice \(\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\in\mathcal{M}_{n,p}(\mathbb{K})\) dont la \(j\)-ième colonne contient les coordonnées de \(u(e_j)\) dans \(\mathcal{C}\). Autrement dit, son coefficient \(a_{ij}\) vérifie \(u(e_j)=\sum_{i=1}^{n}a_{ij}f_i\). Pour un endomorphisme, on prend la même base au départ et à l’arrivée, et on note \(\mathrm{Mat}_{\mathcal{B}}(u)\).
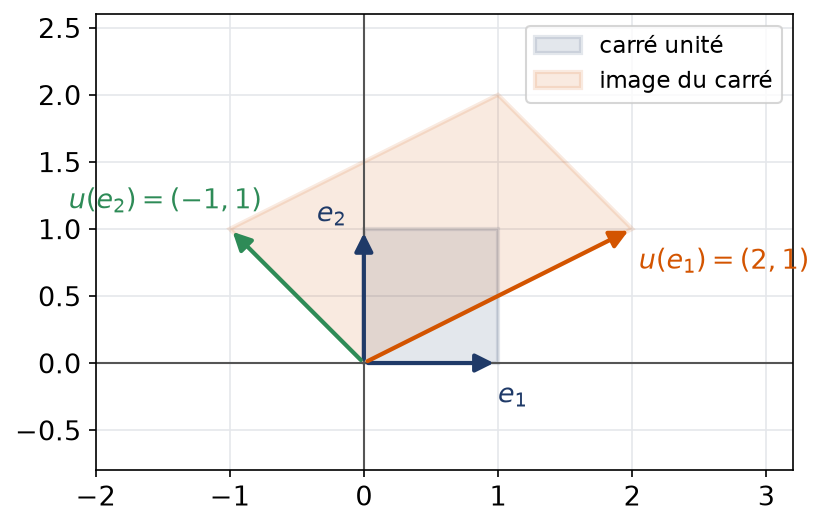
La figure suivante montre ce que lisent les colonnes. Pour la matrice \(\begin{pmatrix}2&-1\\1&1\end{pmatrix}\), la première colonne est l’image de \(e_1\), la seconde celle de \(e_2\). Par conséquent, le carré unité devient un parallélogramme.
Piège à éviter :
On range les images en colonnes, jamais en lignes. En effet, écrire \(u(e_j)\) sur la ligne \(j\) donne la transposée. Une vérification rapide consiste à multiplier la matrice par le vecteur colonne \((1,0,\dots,0)\) : on doit retrouver \(u(e_1)\).
Sur \(\mathbb{R}_2[X]\), muni de la base canonique \((1,X,X^2)\), considérons \(T(P)=P(X+1)-P^{\prime}\). D’abord, \(T(1)=1\). Ensuite, \(T(X)=X+1-1=X\). Enfin, \(T(X^2)=(X+1)^2-2X=X^2+1\). On place ces coordonnées en colonnes :
\[\mathrm{Mat}(T)=\begin{pmatrix}1&0&1\\0&1&0\\0&0&1\end{pmatrix}.\]
Cette matrice est triangulaire à diagonale non nulle. Donc \(T\) est un automorphisme de \(\mathbb{R}_2[X]\).
1.1 Un isomorphisme fondamental
L’application qui associe à \(u\) sa matrice est compatible avec les opérations. De plus, elle ne perd aucune information. Nous obtenons ainsi le résultat central du chapitre.
L’application \(\Phi:\mathcal{L}(E,F)\to\mathcal{M}_{n,p}(\mathbb{K})\), \(u\mapsto\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\), est un isomorphisme d’espaces vectoriels. En particulier, \(\dim\mathcal{L}(E,F)=np=\dim E\times\dim F\).
La linéarité vient de l’unicité des coordonnées : la colonne \(j\) de \(\lambda u+v\) est \(\lambda\) fois celle de \(u\) plus celle de \(v\). Ensuite, \(\Phi\) est bijective. En effet, une matrice \(A\) étant donnée, il existe une unique application linéaire qui envoie chaque \(e_j\) sur le vecteur de coordonnées la colonne \(j\) de \(A\). C’est le théorème de prolongement des applications linéaires définies sur une base. Enfin, \(\dim\mathcal{M}_{n,p}(\mathbb{K})=np\).
Le calcul de l’image d’un vecteur se traduit lui aussi matriciellement. Si \(x\) a pour colonne de coordonnées \(X\) dans \(\mathcal{B}\), alors \(u(x)\) a pour colonne \(Y=AX\) dans \(\mathcal{C}\), où \(A=\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\).
1.2 Composée et inverse
Le produit matriciel a été défini précisément pour traduire la composition. C’est pourquoi la formule suivante est naturelle, à condition de respecter les bases intermédiaires.
Soit \(G\) un troisième espace muni d’une base \(\mathcal{D}\), \(u\in\mathcal{L}(E,F)\) et \(v\in\mathcal{L}(F,G)\). Alors \(\mathrm{Mat}_{\mathcal{B},\mathcal{D}}(v\circ u)=\mathrm{Mat}_{\mathcal{C},\mathcal{D}}(v)\,\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\). De plus, si \(\dim E=\dim F\), \(u\) est un isomorphisme si et seulement si sa matrice est inversible, et alors \(\mathrm{Mat}_{\mathcal{C},\mathcal{B}}(u^{-1})=\left(\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\right)^{-1}\).
Remarque :
La base \(\mathcal{C}\) de l’espace intermédiaire doit être la même dans les deux matrices. Sinon, le produit n’a aucun sens géométrique, même s’il est défini.
2. Noyau, image et rang d’une matrice
Toute matrice \(A\in\mathcal{M}_{n,p}(\mathbb{K})\) définit une application linéaire canoniquement associée, \(X\mapsto AX\), de \(\mathbb{K}^p\) dans \(\mathbb{K}^n\). Nous transportons donc à \(A\) le vocabulaire des applications linéaires.
Le noyau de \(A\) est \(\operatorname{Ker}A=\{X\in\mathbb{K}^p,\ AX=0\}\). Son image \(\operatorname{Im}A=\{AX,\ X\in\mathbb{K}^p\}\) est le sous-espace de \(\mathbb{K}^n\) engendré par les colonnes de \(A\). Le rang de \(A\) est \(\operatorname{rg}A=\dim\operatorname{Im}A\), c’est-à-dire le rang de la famille de ses colonnes.
Le lien avec \(u\) est immédiat. Si \(A=\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\), alors \(\operatorname{rg}u=\operatorname{rg}A\). En effet, l’application coordonnées dans \(\mathcal{C}\) est un isomorphisme, et un isomorphisme conserve le rang d’une famille. Par conséquent, le théorème du rang s’écrit \(p=\dim\operatorname{Ker}A+\operatorname{rg}A\).
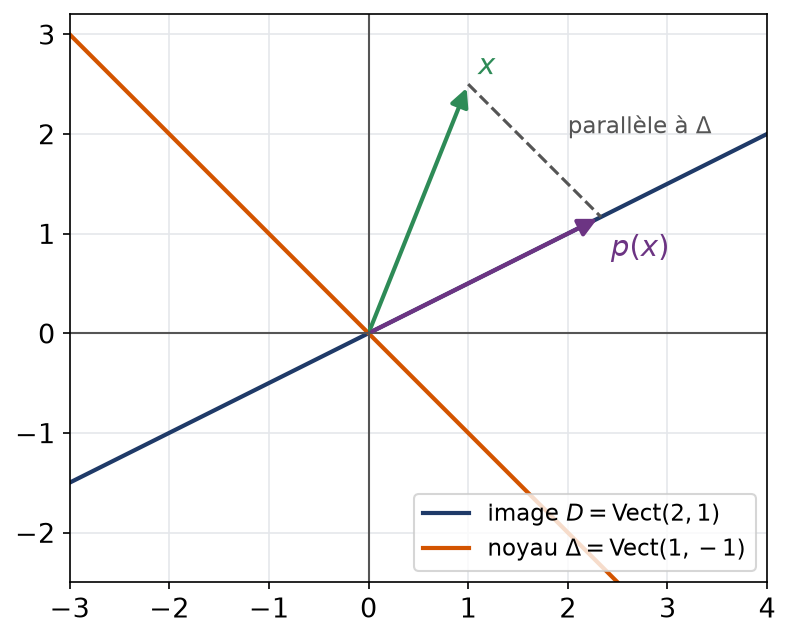
Sur la figure ci-dessous, la projection sur la droite \(D\) parallèlement à la droite \(\Delta\) a pour image \(D\) et pour noyau \(\Delta\). Ainsi, son rang vaut 1 et son noyau est de dimension 1, conformément au théorème du rang.
2.1 Calculer un rang par opérations élémentaires
Les opérations élémentaires sur les lignes reviennent à multiplier à gauche par une matrice inversible. De même, celles sur les colonnes reviennent à multiplier à droite. Or multiplier par une matrice inversible ne change pas le rang. C’est la base de la méthode du pivot.
- Choisir un pivot non nul, si possible égal à \(1\) ou \(-1\), et l’amener en haut à gauche par échange.
- Annuler les coefficients sous le pivot avec des opérations \(L_i\leftarrow L_i-\lambda L_1\).
- Recommencer sur la sous-matrice restante, sans plus toucher à la première ligne.
- Compter les pivots non nuls de la forme échelonnée obtenue : c’est le rang.
Prenons \(M=\begin{pmatrix}1&-1&2&0\\2&1&1&3\\1&5&-4&6\end{pmatrix}\). D’abord, \(L_2\leftarrow L_2-2L_1\) et \(L_3\leftarrow L_3-L_1\) donnent les lignes \((0,3,-3,3)\) et \((0,6,-6,6)\). Ensuite, \(L_3\leftarrow L_3-2L_2\) annule la troisième ligne. Il reste deux pivots, donc \(\operatorname{rg}M=2\). Par conséquent, le noyau de \(M\) est de dimension \(4-2=2\).
Piège à éviter :
Une opération du type \(L_i\leftarrow \lambda L_i\) n’est permise que si \(\lambda\neq0\). De même, avec un paramètre \(a\), diviser par \(a-2\) suppose \(a\neq2\). On traite alors le cas \(a=2\) à part, ce qu’oublient beaucoup de copies.
2.2 Inversibilité et systèmes de Cramer
Pour une matrice carrée, le rang décide de tout. En effet, quand la dimension est finie, l’injectivité d’un endomorphisme équivaut déjà à sa surjectivité. Nous en déduisons la caractérisation suivante.
Pour \(A\in\mathcal{M}_n(\mathbb{K})\), les propriétés suivantes sont équivalentes : \(A\) est inversible ; \(\operatorname{Ker}A=\{0\}\) ; \(\operatorname{rg}A=n\) ; les colonnes de \(A\) forment une base de \(\mathbb{K}^n\).
Un système linéaire \(AX=B\) de \(n\) équations à \(n\) inconnues est dit de Cramer lorsque \(A\) est inversible. Il admet alors une unique solution, à savoir \(X=A^{-1}B\), quel que soit le second membre \(B\).
Considérons le système \(x+\lambda y=1\), \(\lambda x+4y=2\), avec \(\lambda\) réel. L’opération \(L_2\leftarrow L_2-\lambda L_1\) donne \((4-\lambda^2)y=2-\lambda\). Donc la matrice est de rang 2 si et seulement si \(\lambda^2\neq4\). Dans ce cas, le système est de Cramer et \(y=\frac{1}{2+\lambda}\), puis \(x=1-\lambda y=\frac{2}{2+\lambda}\). En revanche, pour \(\lambda=2\), il reste une infinité de solutions ; pour \(\lambda=-2\), aucune.
Remarque :
Pour résoudre un système de Cramer, on n’inverse presque jamais \(A\). En pratique, le pivot de Gauss sur la matrice augmentée est bien plus rapide.
3. Le changement de base
Un même vecteur possède des coordonnées différentes selon la base choisie. De même, un endomorphisme possède une matrice par base. Le but de cette partie est de relier ces écritures par une formule sûre. Ensuite, nous apprendrons à choisir la base qui simplifie la matrice.
Soit \(\mathcal{B}\) et \(\mathcal{B}^{\prime}\) deux bases de \(E\). On appelle matrice de passage de \(\mathcal{B}\) vers \(\mathcal{B}^{\prime}\), et l’on note \(P_{\mathcal{B}}^{\mathcal{B}^{\prime}}\), le tableau carré obtenu en écrivant en colonne \(j\) le \(j\)-ième nouveau vecteur, exprimé dans l’ancienne base \(\mathcal{B}\). Autrement dit, \(P_{\mathcal{B}}^{\mathcal{B}^{\prime}}=\mathrm{Mat}_{\mathcal{B}^{\prime},\mathcal{B}}(\operatorname{id}_E)\).
Cette dernière écriture est la clé de tout. En effet, elle permet de déduire chaque formule de la propriété de la composée. Par exemple, \(P_{\mathcal{B}}^{\mathcal{B}^{\prime}}\) est inversible, d’inverse \(P_{\mathcal{B}^{\prime}}^{\mathcal{B}}\), car \(\operatorname{id}_E\) est sa propre réciproque.
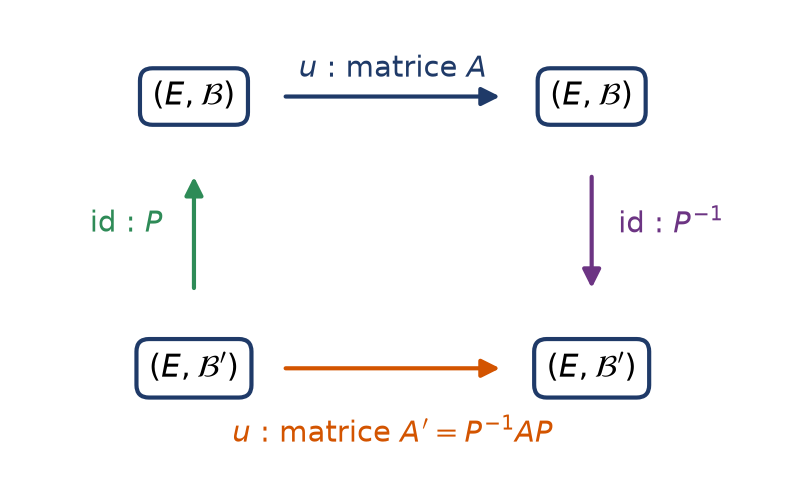
Notons \(P=P_{\mathcal{B}}^{\mathcal{B}^{\prime}}\). Si \(x\) a pour coordonnées \(X\) dans \(\mathcal{B}\) et \(X^{\prime}\) dans \(\mathcal{B}^{\prime}\), alors \(X=PX^{\prime}\). Si \(u\in\mathcal{L}(E)\) a pour matrices \(A\) dans \(\mathcal{B}\) et \(A^{\prime}\) dans \(\mathcal{B}^{\prime}\), alors
\[A^{\prime}=P^{-1}AP.\]
Plus généralement, pour \(u\in\mathcal{L}(E,F)\), avec \(Q\) la matrice de passage de \(\mathcal{C}\) à \(\mathcal{C}^{\prime}\) dans \(F\), on a \(\mathrm{Mat}_{\mathcal{B}^{\prime},\mathcal{C}^{\prime}}(u)=Q^{-1}\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\,P\).
On écrit \(u=\operatorname{id}_F\circ u\circ\operatorname{id}_E\) en lisant les bases de droite à gauche : \(\mathcal{B}^{\prime}\to\mathcal{B}\to\mathcal{C}\to\mathcal{C}^{\prime}\). La propriété de la composée donne alors \(\mathrm{Mat}_{\mathcal{C},\mathcal{C}^{\prime}}(\operatorname{id}_F)\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\mathrm{Mat}_{\mathcal{B}^{\prime},\mathcal{B}}(\operatorname{id}_E)\). Or le premier facteur vaut \(Q^{-1}\) et le dernier vaut \(P\). Enfin, la relation \(X=PX^{\prime}\) est le cas \(u=\operatorname{id}_E\) appliqué à une colonne.
Le schéma suivant résume ce chemin. On part de la nouvelle base, on revient à l’ancienne par \(P\), on applique \(A\), puis on repasse dans la nouvelle base par \(P^{-1}\).
Piège à éviter :
La formule \(X=PX^{\prime}\) exprime les anciennes coordonnées en fonction des nouvelles, et non l’inverse. Ainsi, pour obtenir \(X^{\prime}\), il faut calculer \(P^{-1}X\). Pour ne pas se tromper, on teste la formule sur le premier vecteur de \(\mathcal{B}^{\prime}\) : sa colonne \(X^{\prime}\) vaut \((1,0,\dots,0)\), et \(PX^{\prime}\) est bien la première colonne de \(P\).
3.1 Choisir une base adaptée
Une base adaptée suit la géométrie de l’endomorphisme. Par exemple, pour un projecteur ou une symétrie, on concatène une base de chacun des deux sous-espaces de la décomposition \(E=F\oplus G\). La matrice devient alors diagonale.
- Repérer les vecteurs dont l’image est simple : vecteurs fixes, vecteurs envoyés sur leur opposé, vecteurs du noyau.
- Vérifier qu’ils forment une base, par exemple en calculant le rang de la matrice qu’ils forment.
- Écrire la matrice \(A^{\prime}\) dans cette base, qui se lit directement.
- Revenir à la base de départ par \(A=PA^{\prime}P^{-1}\), en écrivant \(P\) avec les nouveaux vecteurs en colonnes.
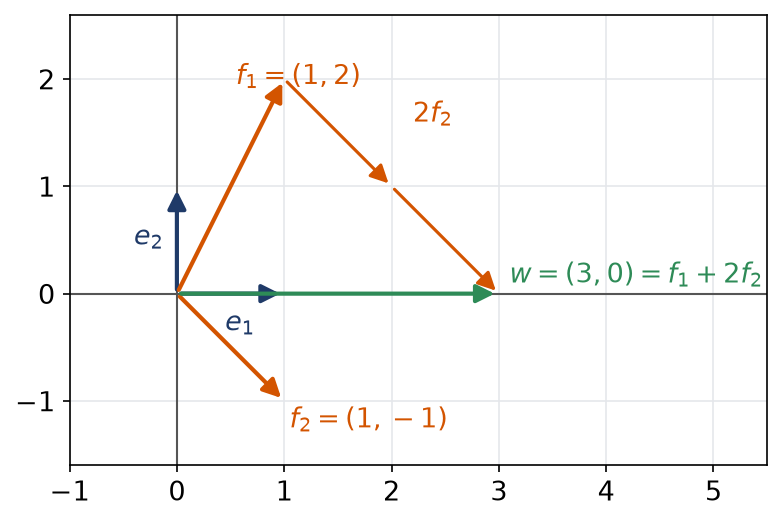
Soit \(s\) la symétrie de \(\mathbb{R}^2\) par rapport à \(D=\operatorname{Vect}(1,2)\) parallèlement à \(\Delta=\operatorname{Vect}(1,-1)\). Dans la base adaptée \(\mathcal{B}^{\prime}=((1,2),(1,-1))\), la matrice de \(s\) est \(\operatorname{diag}(1,-1)\). Ensuite, \(P=\begin{pmatrix}1&1\\2&-1\end{pmatrix}\) a pour inverse \(\frac{1}{3}P\), car \(P^2=3I_2\). Par conséquent :
\[\mathrm{Mat}(s)=P\begin{pmatrix}1&0\\0&-1\end{pmatrix}\frac{1}{3}P=\frac{1}{3}\begin{pmatrix}-1&2\\4&1\end{pmatrix}.\]
Enfin, on contrôle le résultat : cette matrice envoie \((1,2)\) sur lui-même et \((1,-1)\) sur \((-1,1)\).
La figure montre les deux bases du plan. Le vecteur \(w=(3,0)\) s’écrit \(w=(1,2)+2(1,-1)\), donc ses coordonnées dans \(\mathcal{B}^{\prime}\) sont \((1,2)\). On vérifie bien que \(P\begin{pmatrix}1\\2\end{pmatrix}=\begin{pmatrix}3\\0\end{pmatrix}\).
4. Matrices équivalentes et rang
La formule \(Q^{-1}AP\) autorise deux changements de base indépendants, un au départ et un à l’arrivée. Avec cette liberté, nous pouvons simplifier n’importe quelle matrice rectangulaire jusqu’à une forme très pauvre.
Deux matrices \(A,B\in\mathcal{M}_{n,p}(\mathbb{K})\) sont équivalentes s’il existe \(Q\in GL_n(\mathbb{K})\) et \(P\in GL_p(\mathbb{K})\) telles que \(B=QAP\). Pour un entier \(r\leqslant\min(n,p)\), la notation \(J_r\) désigne la matrice de taille \(n\times p\) qui porte des \(1\) aux places \((1,1),\dots,(r,r)\) et des zéros partout ailleurs.
Soit \(A\) une matrice de taille \(n\times p\). Elle a pour rang \(r\) exactement lorsqu’elle est équivalente à \(J_r\). Ainsi, pour des matrices de même format, l’équivalence se résume à l’égalité des rangs.
Soit \(u\) l’application canoniquement associée à \(A\), de rang \(r\). D’abord, on choisit un supplémentaire \(S\) de \(\operatorname{Ker}u\) dans \(\mathbb{K}^p\), de base \((e_1,\dots,e_r)\), que l’on complète par une base \((e_{r+1},\dots,e_p)\) du noyau. Ensuite, la restriction de \(u\) à \(S\) est injective, donc la famille \((u(e_1),\dots,u(e_r))\) est libre. On la complète en une base \(\mathcal{C}^{\prime}\) de \(\mathbb{K}^n\). Dans ces bases, la matrice de \(u\) est exactement \(J_r\). Réciproquement, multiplier par des matrices inversibles conserve le rang, et \(\operatorname{rg}J_r=r\).
4.1 Rang de la transposée et matrices extraites
Le théorème précédent a une conséquence surprenante. En effet, il relie le rang des colonnes à celui des lignes, qui semblent pourtant sans rapport.
Pour toute matrice \(A\), \(\operatorname{rg}(A^{\mathsf{T}})=\operatorname{rg}A\). Ainsi, le rang de \(A\) est aussi le rang de la famille de ses lignes.
Écrivons \(A=QJ_rP\) avec \(P\) et \(Q\) inversibles. Alors \(A^{\mathsf{T}}=P^{\mathsf{T}}J_r^{\mathsf{T}}Q^{\mathsf{T}}\). Or les transposées de matrices inversibles sont inversibles, et \(J_r^{\mathsf{T}}\) est la matrice \(J_r\) de taille \(p\times n\), de rang \(r\). Donc \(\operatorname{rg}(A^{\mathsf{T}})=r\).
Une matrice extraite de \(A\) s’obtient en ne gardant que certaines lignes et certaines colonnes. Ce point de vue donne un minorant du rang très commode en pratique.
Le rang d’une matrice extraite de \(A\) est inférieur ou égal au rang de \(A\). De plus, \(\operatorname{rg}A\) est la taille maximale d’une matrice carrée inversible extraite de \(A\).
Pour montrer que \(\operatorname{rg}A\geqslant2\), il suffit d’exhiber deux lignes et deux colonnes formant un bloc \(\begin{pmatrix}a&b\\c&d\end{pmatrix}\) avec \(ad-bc\neq0\). Ensuite, une relation entre les lignes restantes fournit souvent l’inégalité inverse.
5. Matrices semblables et trace
Pour un endomorphisme, on impose la même base au départ et à l’arrivée. Il ne reste alors qu’une seule matrice de passage. La relation obtenue est beaucoup plus rigide que l’équivalence.
On dit que \(B\) est semblable à \(A\), pour deux matrices carrées d’ordre \(n\), lorsque \(B=P^{-1}AP\) pour une certaine \(P\in GL_n(\mathbb{K})\). Concrètement, \(A\) et \(B\) représentent le même endomorphisme de \(\mathbb{K}^n\) dans deux bases.
Deux matrices semblables sont équivalentes, donc elles ont le même rang. En revanche, la réciproque est fausse. Il faut donc d’autres invariants, et la trace est le premier d’entre eux.
Pour une matrice carrée \(A=(a_{ij})\) d’ordre \(n\), on additionne les coefficients situés sur la diagonale : \(\mathrm{tr}A=\sum_{i=1}^{n}a_{ii}\). Ce nombre est la trace de \(A\), et l’application ainsi obtenue est linéaire de \(\mathcal{M}_n(\mathbb{K})\) dans \(\mathbb{K}\).
Pour \(A\in\mathcal{M}_{n,p}(\mathbb{K})\) et \(B\in\mathcal{M}_{p,n}(\mathbb{K})\), on a \(\mathrm{tr}(AB)=\mathrm{tr}(BA)\). En conséquence, deux matrices semblables ont la même trace.
Le coefficient diagonal d’indice \(i\) de \(AB\) vaut \(\sum_{k=1}^{p}a_{ik}b_{ki}\). Donc \(\mathrm{tr}(AB)=\sum_{i=1}^{n}\sum_{k=1}^{p}a_{ik}b_{ki}\). On échange les deux sommes finies et l’on reconnaît \(\sum_{k=1}^{p}(BA)_{kk}\). Ensuite, pour \(B=P^{-1}AP\), on applique l’égalité aux matrices \(P^{-1}A\) et \(P\) : \(\mathrm{tr}B=\mathrm{tr}(PP^{-1}A)=\mathrm{tr}A\).
Grâce à ce théorème, la trace d’un endomorphisme \(u\) est bien définie : c’est la trace de sa matrice dans n’importe quelle base. Elle ne dépend pas du choix de la base.
La trace ne suffit pas à reconnaître des matrices semblables. Par exemple, \(I_2\) et \(\begin{pmatrix}1&1\\0&1\end{pmatrix}\) ont la même trace et le même rang. Pourtant, la seule matrice semblable à \(I_2\) est \(P^{-1}I_2P=I_2\). De plus, l’égalité ne s’étend pas à trois facteurs permutés au hasard. Avec les matrices élémentaires, \(\mathrm{tr}(E_{12}E_{21}E_{11})=1\) alors que \(\mathrm{tr}(E_{12}E_{11}E_{21})=0\).
Calculons la trace de \(\delta:P\mapsto XP^{\prime}\) sur \(\mathbb{R}_n[X]\). D’abord, on remarque que \(\delta(X^k)=kX^k\) pour tout \(k\in\{0,\dots,n\}\). Ainsi, la matrice de \(\delta\) dans la base canonique est diagonale, de coefficients \(0,1,\dots,n\). Par conséquent, sa trace vaut \(0+1+\dots+n=\frac{n(n+1)}{2}\). De même, l’endomorphisme \(T\) de la première partie a pour trace \(1+1+1=3\). Enfin, ce résultat ne dépend d’aucun choix : dans une autre base, la matrice change, mais sa trace reste la même.
Remarque :
Pour calculer la trace d’un endomorphisme, on choisit donc la base où sa matrice est la plus simple. En pratique, il suffit de connaître les coefficients diagonaux. Autrement dit, on cherche seulement la coordonnée de \(u(e_i)\) selon \(e_i\), sans calculer les autres coordonnées.
5.1 Trace d’un projecteur
Voici une application typique d’une base adaptée. Elle relie un invariant algébrique à une dimension.
Si \(p\) est un projecteur de \(E\), alors \(\mathrm{tr}p=\operatorname{rg}p\).
Pour un projecteur, l’image et le noyau sont supplémentaires dans \(E\). On concatène une base de \(\operatorname{Im}p\), de cardinal \(r=\operatorname{rg}p\), et une base de \(\operatorname{Ker}p\). Or \(p\) fixe chaque vecteur de l’image et annule chaque vecteur du noyau. Donc sa matrice dans cette base est \(\operatorname{diag}(1,\dots,1,0,\dots,0)\) avec \(r\) fois le coefficient \(1\). Sa trace vaut \(r\), et la trace ne dépend pas de la base.
La trace sert surtout à prouver des impossibilités. Par exemple, aucune matrice ne vérifie \(AB-BA=I_n\), car le membre de gauche est de trace nulle et le membre de droite de trace \(n\).
Les erreurs fréquentes
- Ranger les images des vecteurs de base en lignes, ce qui produit la transposée de la bonne matrice.
- Écrire \(A^{\prime}=PAP^{-1}\) au lieu de \(A^{\prime}=P^{-1}AP\) : on teste toujours la formule sur un vecteur simple.
- Remplir la matrice de passage avec les anciens vecteurs exprimés dans la nouvelle base.
- Diviser par une expression contenant un paramètre sans traiter à part les valeurs qui l’annulent.
- Conclure que deux matrices sont semblables parce qu’elles ont même trace et même rang.
- Appliquer \(\mathrm{tr}(ABC)=\mathrm{tr}(ACB)\), qui est fausse : seules les permutations circulaires sont autorisées.
Fiche mémo
- Colonne \(j\) de \(\mathrm{Mat}_{\mathcal{B},\mathcal{C}}(u)\) : coordonnées de \(u(e_j)\) dans \(\mathcal{C}\).
- \(\mathcal{L}(E,F)\simeq\mathcal{M}_{n,p}(\mathbb{K})\), donc \(\dim\mathcal{L}(E,F)=np\).
- Composée : \(\mathrm{Mat}(v\circ u)=\mathrm{Mat}(v)\mathrm{Mat}(u)\), avec la même base intermédiaire.
- Matrice de passage : nouveaux vecteurs en colonnes, dans l’ancienne base ; \(X=PX^{\prime}\).
- Endomorphisme : \(A^{\prime}=P^{-1}AP\) ; application quelconque : \(A^{\prime}=Q^{-1}AP\).
- \(\operatorname{rg}A=r\) si et seulement si \(A\) est équivalente à \(J_r\).
- \(\operatorname{rg}A^{\mathsf{T}}=\operatorname{rg}A\) ; une matrice extraite a un rang au plus égal.
- Système de Cramer : matrice carrée inversible, solution unique.
- \(\mathrm{tr}(AB)=\mathrm{tr}(BA)\) ; des matrices semblables ont même trace et même rang.
- Pour un projecteur, la trace est égale au rang.
Questions fréquentes
Comment ne plus confondre P et son inverse dans un changement de base ?
La matrice de passage contient les nouveaux vecteurs écrits dans l’ancienne base. Elle donne donc les anciennes coordonnées à partir des nouvelles : X = PX’. Pour un endomorphisme, la nouvelle matrice vaut alors P^(-1)AP. En cas de doute, testez la formule sur le premier vecteur de la nouvelle base.
Deux matrices de même rang sont-elles semblables ?
Non. Deux matrices de même taille et de même rang sont équivalentes, ce qui autorise deux changements de base différents. La similitude impose la même base au départ et à l’arrivée, ce qui est bien plus exigeant. Par exemple, la matrice identité d’ordre 2 et une matrice triangulaire à diagonale de 1 non diagonale ont même rang et même trace sans être semblables.
Peut-on écrire tr(ABC) = tr(BAC) ?
Pas en général. Seules les permutations circulaires conservent la trace : tr(ABC) = tr(BCA) = tr(CAB). Un contre-exemple avec des matrices élémentaires d’ordre 2 suffit à montrer que l’échange de deux facteurs peut changer la trace.
Quelle méthode utiliser pour calculer un rang en colle ?
La méthode du pivot de Gauss est la plus sûre : on échelonne la matrice et on compte les pivots non nuls. Avec un paramètre, choisissez un pivot qui n’en dépend pas, puis traitez à part les valeurs qui annulent le dernier pivot. Une matrice extraite inversible donne aussi rapidement un minorant du rang.
Pour aller plus loin
- S’exercer : exercices corrigés de maths sup (MPSI) sur changement de base et trace
- Bases utiles : Noyau, image et théorème du rang, Produit matriciel, matrices inversibles et pivot
- Chapitre d’avant : Projecteurs, symétries, hyperplans et sous-espaces affines
- Chapitre d’après : Déterminant : calcul, développement et comatrice
- Vérifier ses acquis : QCM de maths sup (MPSI) sur changement de base et trace
- Contrôle corrigé en temps limité : Matrices semblables et trace : contrôle de maths en MPSI
- Tous les chapitres : le sommaire de maths sup (MPSI)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «changement de base et trace en maths sup (MPSI) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths sup (MPSI)
Cours
Tout voir Rolle et accroissements finis en maths sup (MPSI)
- Lois internes, groupes et anneaux en maths sup (MPSI)
- Sous-espaces et supplémentaires en maths sup (MPSI)
- Équivalents et négligeabilité en maths sup (MPSI)
- Matrices inversibles et pivot en maths sup (MPSI)
- Dimension et formule de Grassmann en maths sup (MPSI)
Exercices corrigés
Tout voir- Projecteurs, symétries et hyperplans en maths sup (MPSI)
- Produit scalaire et Gram-Schmidt en maths sup (MPSI)
- Équivalents et négligeabilité en maths sup (MPSI)
- Étude de fonctions et réciproques en maths sup (MPSI)
- Dénombrement et conditionnement en maths sup (MPSI)
- Sous-espaces et supplémentaires en maths sup (MPSI)
Contrôles
Tout voir
QCM
Tout voir