Corrigé des exercices : Différentielle et règle de la chaîne en maths spé (MP)

Ce corrigé différentielle MP détaille la solution de chacun des dix-neuf exercices. Chaque correction commence par une idée clé qui indique par où attaquer. Ensuite, la rédaction suit le standard des concours : hypothèses vérifiées, théorèmes nommés, calculs intermédiaires écrits. Nous signalons au passage les points de vigilance : justifier que le reste est négligeable, respecter l’ordre des produits matriciels, évaluer les dérivées au bon point dans la règle de la chaîne, vérifier la connexité par arcs avant de conclure qu’une fonction est constante.
Plusieurs figures illustrent les solutions. De plus, les résultats numériques sont contrôlés par un second calcul chaque fois que c’est possible, par exemple en développant directement un déterminant. Comparez votre rédaction à la nôtre ligne par ligne : c’est ainsi que l’on repère les justifications oubliées.
Pour démarrer
Corrigé de l’exercice 1 – Gradient d’une fonction de trois variables
Idée clé : on dérive par rapport à chaque variable en figeant les deux autres, puis on utilise \(D_w f(a) = \langle \nabla f(a), w \rangle\).
- Les fonctions \((x,y,z) \mapsto x\), \(yz\) et \(y^2 z\) sont polynomiales, et l’exponentielle est de classe \(C^1\). Par produits, sommes et compositions, \(f\) a des dérivées partielles continues sur \(\mathbb{R}^3\). Donc \(f\) est de classe \(C^1\) sur \(\mathbb{R}^3\).
- On obtient \(\partial_x f = e^{yz}\), puis \(\partial_y f = xz \, e^{yz} + 2yz\), et enfin \(\partial_z f = xy \, e^{yz} + y^2\).
- Au point \((1,0,2)\), on a \(e^{yz} = 1\). Ainsi, \(\partial_x f = 1\), \(\partial_y f = 1 \times 2 \times 1 + 0 = 2\) et \(\partial_z f = 0\). Donc \(\nabla f(1,0,2) = (1, 2, 0)\). Comme \(f\) est différentiable, \(D_w f(1,0,2) = 1 \times 3 + 2 \times (-1) + 0 \times 4\). On trouve \(D_w f(1,0,2) = 1\).
Corrigé de l’exercice 2 – Dérivée selon un vecteur par la définition
Idée clé : la dérivée selon \(v\) est le coefficient de \(t\) dans le développement de \(f(a + tv)\).
- On a \(a + tv = (2 + t, 1 – 2t)\). D’abord, \((2+t)^2 = 4 + 4t + t^2\). Ensuite, \(-3(2+t)(1-2t) = -6 + 9t + 6t^2\). Enfin, \((1 – 2t)^3 = 1 – 6t + 12t^2 – 8t^3\). En sommant, \(f(a + tv) = -1 + 7t + 19t^2 – 8t^3\).
- Comme \(f(a) = 4 – 6 + 1 = -1\), on obtient \(\dfrac{f(a+tv) – f(a)}{t} = 7 + 19t – 8t^2\), qui tend vers \(7\). Donc \(D_v f(a) = 7\).
- On a \(\partial_1 f = 2x – 3y\) et \(\partial_2 f = -3x + 3y^2\). En \(a\), cela donne \(1\) et \(-3\). La fonction \(f\) est polynomiale, donc de classe \(C^1\) et différentiable. Ainsi, \(D_v f(a) = 1 \times 1 + (-3) \times (-2) = 7\). On retrouve bien \(7\).
Corrigé de l’exercice 3 – Jacobienne d’une application du plan dans l’espace
Idée clé : une ligne par composante, une colonne par variable.
- Les composantes sont de classe \(C^1\). Leurs dérivées partielles donnent
\[ J_F(x,y) = \begin{pmatrix} 2xy & x^2 \\ 1 & -2y \\ e^{x-y} & -e^{x-y} \end{pmatrix}. \]
- En \((1,1)\), on a \(e^{0} = 1\). Donc \(J_F(1,1) = \begin{pmatrix} 2 & 1 \\ 1 & -2 \\ 1 & -1 \end{pmatrix}\) et \(dF(1,1)(h,k) = (2h + k, \; h – 2k, \; h – k)\).
- Le mineur formé des deux premières lignes vaut \(2 \times (-2) – 1 \times 1 = -5 \neq 0\). Par ailleurs, le rang d’une matrice à deux colonnes est au plus \(2\). Donc \(dF(1,1)\) est de rang 2, c’est-à-dire injective.
Corrigé de l’exercice 4 – Deux différentielles matricielles par développement
Idée clé : développer, isoler les termes de degré 1 en \(H\), puis majorer le reste grâce à la sous-multiplicativité.
- On a \(\varphi(M + H) = M^{\top}M + \big(M^{\top} H + H^{\top} M\big) + H^{\top} H\). Le terme entre parenthèses est linéaire en \(H\). De plus, la transposition est linéaire en dimension finie, donc il existe \(c\) tel que \(\|H^{\top}\| \leqslant c \|H\|\). Ainsi, \(\|H^{\top} H\| \leqslant c \|H\|^2\). Par conséquent, \(d\varphi(M)(H) = M^{\top} H + H^{\top} M\).
- On développe \((M+H)^3 = M^3 + \big(M^2 H + MHM + HM^2\big) + R(H)\), où \(R(H) = MH^2 + HMH + H^2 M + H^3\). Donc \(\|R(H)\| \leqslant 3\|M\| \, \|H\|^2 + \|H\|^3 = o(\|H\|)\). Ensuite, la trace est linéaire, donc continue, et \(\operatorname{tr}(R(H)) = o(\|H\|)\). Enfin, \(\operatorname{tr}(MHM) = \operatorname{tr}(M^2 H)\) et \(\operatorname{tr}(HM^2) = \operatorname{tr}(M^2 H)\) par la propriété \(\operatorname{tr}(PQ) = \operatorname{tr}(QP)\). Donc \(d\psi(M)(H) = 3 \operatorname{tr}(M^2 H)\).
- On calcule \(M^2 = \begin{pmatrix} 1 & 3 \\ 0 & 4 \end{pmatrix}\), puis \(M^2 H = \begin{pmatrix} 3 & 0 \\ 4 & 0 \end{pmatrix}\). Sa trace vaut \(3\). Donc \(d\psi(M)(H) = 9\).
Corrigé de l’exercice 5 – Gradient d’un produit scalaire par une norme au carré
Idée clé : développer le produit de deux expressions, chacune connue à l’ordre 1.
- On a \(\langle a, x+h \rangle = \langle a, x \rangle + \langle a, h \rangle\) et \(\|x+h\|^2 = \|x\|^2 + 2\langle x, h \rangle + \|h\|^2\). En multipliant, on obtient \(f(x+h) = f(x) + \langle a, h \rangle \|x\|^2 + 2 \langle a, x \rangle \langle x, h \rangle + R(h)\), avec \(R(h) = 2\langle a, h \rangle \langle x, h \rangle + \langle a, x \rangle \|h\|^2 + \langle a, h \rangle \|h\|^2\). Par Cauchy-Schwarz, \(|R(h)| \leqslant 3 \|a\| \, \|x\| \, \|h\|^2 + \|a\| \, \|h\|^3 = o(\|h\|)\). Donc \(df(x)(h) = \|x\|^2 \langle a, h \rangle + 2 \langle a, x \rangle \langle x, h \rangle\).
- On écrit ce résultat sous la forme \(\langle \|x\|^2 a + 2\langle a, x \rangle x, \, h \rangle\). Ainsi, \(\nabla f(x) = \|x\|^2 a + 2 \langle a, x \rangle \, x\).
- Le gradient est nul en \(x = 0\). Supposons ensuite \(x \neq 0\) et \(\nabla f(x) = 0\). En faisant le produit scalaire avec \(x\), on obtient \(3 \langle a, x \rangle \|x\|^2 = 0\), donc \(\langle a, x \rangle = 0\). L’égalité devient alors \(\|x\|^2 a = 0\), d’où \(a = 0\), ce qui est exclu. Le gradient s’annule seulement en \(x = 0\).
Corrigé de l’exercice 6 – Gradient de la norme euclidienne
Idée clé : écrire \(N = \sqrt{\cdot} \circ q\) avec \(q(x) = \|x\|^2\), puis appliquer la règle de la chaîne là où la racine est dérivable.
- La fonction \(q\) est différentiable, avec \(dq(x)(h) = 2 \langle x, h \rangle\), car \(q(x+h) = q(x) + 2\langle x, h \rangle + \|h\|^2\). Ensuite, la racine carrée est dérivable sur \(]0, +\infty[\) et \(q(x) > 0\) pour \(x \neq 0\). La règle de la chaîne donne \(dN(x)(h) = \dfrac{1}{2\sqrt{q(x)}} \times 2 \langle x, h \rangle = \left\langle \dfrac{x}{\|x\|}, h \right\rangle\). Donc \(\nabla N(x) = \dfrac{x}{\|x\|}\), vecteur unitaire.
- Soit \(v \neq 0\). Pour \(t \neq 0\), on a \(\dfrac{N(tv) – N(0)}{t} = \dfrac{|t|}{t} \|v\|\). Cette quantité vaut \(\|v\|\) pour \(t > 0\) et \(-\|v\|\) pour \(t < 0\). Elle n’a donc pas de limite en \(0\). Ainsi, \(N\) n’a pas de dérivée selon \(v\) en \(0\), et n’est pas différentiable en \(0\).
- On compose \(N\) avec \(s \mapsto 1/s\), dérivable sur \(]0, +\infty[\). Il vient \(d(1/N)(x)(h) = -\dfrac{dN(x)(h)}{\|x\|^2} = -\left\langle \dfrac{x}{\|x\|^3}, h \right\rangle\). Donc \(\nabla \left( \dfrac{1}{\|x\|} \right) = -\dfrac{x}{\|x\|^3}\).
Pour s’entraîner
Corrigé de l’exercice 7 – Dérivées directionnelles sans différentiabilité
Idée clé : une fonction différentiable a des dérivées directionnelles linéaires en \(v\) ; il suffit donc de trouver un défaut de linéarité.
- Sur \(\mathbb{R}^2 \setminus \{(0,0)\}\), le quotient \(f\) a un numérateur et un dénominateur polynomiaux, et \(x^2 + y^2\) y reste strictement positif : la continuité y est acquise. Notons \(\rho = \sqrt{x^2 + y^2}\). Comme \(|x| \leqslant \rho\) et \(|y| \leqslant \rho\), on a \(|x^3 – 2y^3| \leqslant 3\rho^3\). Ainsi, \(|f(x,y)| \leqslant 3\rho\), qui tend vers \(0\). Donc \(f\) est continue sur \(\mathbb{R}^2\).
- Soit \(v = (h,k) \neq (0,0)\). Pour \(t \neq 0\), on a \(\dfrac{f(th, tk)}{t} = \dfrac{t^3 (h^3 – 2k^3)}{t \cdot t^2 (h^2 + k^2)} = \dfrac{h^3 – 2k^3}{h^2 + k^2}\). Ce quotient ne dépend pas de \(t\). Donc \(D_v f(0,0) = \dfrac{h^3 – 2k^3}{h^2 + k^2}\), et \(D_0 f(0,0) = 0\).
- En particulier, \(\partial_1 f(0,0) = 1\) et \(\partial_2 f(0,0) = -2\). Si \(f\) était différentiable en \((0,0)\), on aurait \(D_v f(0,0) = h – 2k\) pour tout \(v\). Or, pour \(v = (1,1)\), on trouve \(D_v f(0,0) = -\dfrac{1}{2}\), alors que \(h – 2k = -1\). Donc \(f\) n’est pas différentiable en \((0,0)\). La figure compare les deux fonctions sur le cercle unité : elles coïncident seulement en quelques directions.
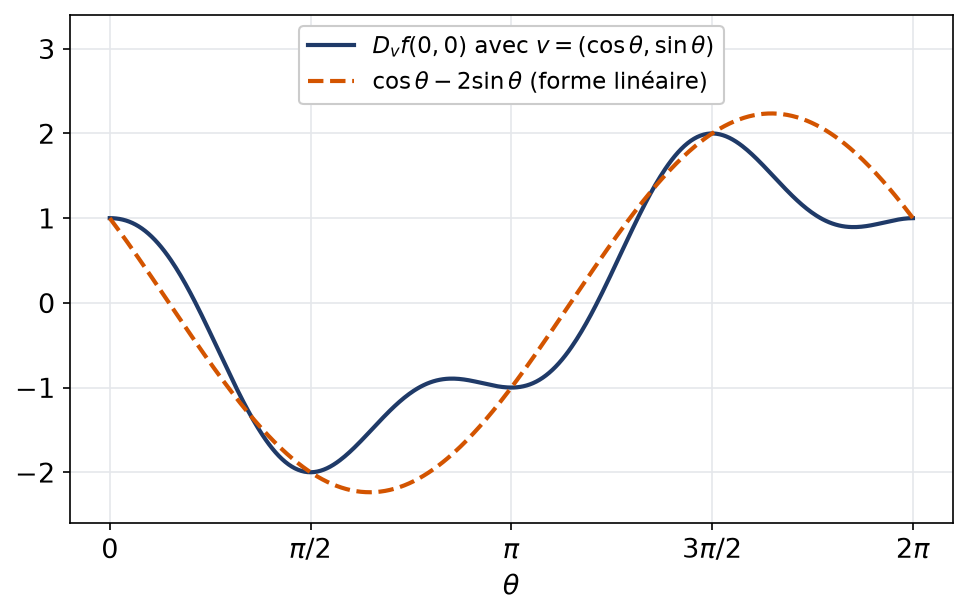
Cet exemple est instructif. En effet, la fonction est continue et possède une dérivée dans toutes les directions. Pourtant, le graphe n’a pas de plan tangent en l’origine. Il faut donc retenir que seule la linéarité de \(v \mapsto D_v f(0,0)\), complétée par un reste négligeable, garantit la différentiabilité.
Corrigé de l’exercice 8 – Une fraction rationnelle de classe C1 sur le plan
Idée clé : une majoration en \(\|h\|^2\) donne la différentiabilité à l’origine, puis des majorations des dérivées partielles donnent leur continuité.
- Pour \((x,y) \neq (0,0)\), on a \(y^2 \leqslant 2x^2 + y^2\), donc \(|g(x,y)| = x^2 \dfrac{y^2}{2x^2 + y^2} \leqslant x^2\). L’inégalité reste vraie en \((0,0)\). Ainsi, \(|g(h)| \leqslant \|h\|^2 = o(\|h\|)\) pour la norme euclidienne. Donc \(g\) est différentiable en \((0,0)\) et \(dg(0,0) = 0\) ; en particulier, ses deux dérivées partielles y sont nulles.
- Hors de l’origine, on dérive le quotient. D’abord, \(\partial_x g = \dfrac{2xy^2(2x^2 + y^2) – 4x \cdot x^2 y^2}{(2x^2+y^2)^2}\). Après simplification, \(\partial_x g(x,y) = \dfrac{2xy^4}{(2x^2+y^2)^2}\). De même, \(\partial_y g(x,y) = \dfrac{4x^4 y}{(2x^2+y^2)^2}\).
- Ces dérivées sont continues hors de l’origine. Ensuite, \((2x^2 + y^2)^2 \geqslant y^4\) donne \(|\partial_x g| \leqslant 2|x|\). De même, \((2x^2+y^2)^2 \geqslant 4x^4\) donne \(|\partial_y g| \leqslant |y|\). Ces majorations restent vraies en l’origine, où les dérivées sont nulles. Donc les deux dérivées partielles tendent vers \(0\), leur valeur en l’origine. Par le théorème de caractérisation, \(g\) est de classe \(C^1\) sur \(\mathbb{R}^2\).
Corrigé de l’exercice 9 – Fonction constante par contrôle quadratique
Idée clé : l’hypothèse dit exactement que l’accroissement est un \(o(\|h\|)\), donc que la différentielle est nulle.
- Soit \(a \in \mathbb{R}^n\). Pour tout \(h\), on a \(|f(a+h) – f(a) – 0| \leqslant \|h\|^2 = o(\|h\|)\). L’application nulle convient donc dans la définition. Ainsi, \(f\) est différentiable en tout point et \(df(a) = 0\).
- L’espace \(\mathbb{R}^n\) est convexe, donc connexe par arcs. D’après le cours, une fonction de différentielle nulle sur un ouvert connexe par arcs est constante. Donc \(f\) est constante.
- Sur un ouvert connexe par arcs, le même raisonnement s’applique. En revanche, le résultat tombe en défaut sinon. Prenons \(U = B(0,1) \cup B(5e_1, 1)\) et \(f\) nulle sur la première boule, égale à \(1\) sur la seconde. Deux points de boules différentes sont à distance au moins \(3\), donc \(|f(x) – f(y)| = 1 \leqslant 9 \leqslant \|x – y\|^2\). L’hypothèse est vérifiée mais \(f\) n’est pas constante : il faut un ouvert connexe par arcs.
Corrigé de l’exercice 10 – Somme de deux arctangentes sur quatre quadrants
Idée clé : le gradient est nul, mais l’ouvert a quatre morceaux ; la fonction est donc constante sur chacun d’eux seulement.
- Sur \(U\), les quotients \(x/y\) et \(y/x\) sont de classe \(C^1\), et l’arctangente aussi. Donc \(f\) est de classe \(C^1\) sur \(U\). D’une part, \(\partial_x \arctan\left(\dfrac{x}{y}\right) = \dfrac{1/y}{1 + x^2/y^2} = \dfrac{y}{x^2+y^2}\). D’autre part, \(\partial_x \arctan\left(\dfrac{y}{x}\right) = \dfrac{-y/x^2}{1 + y^2/x^2} = -\dfrac{y}{x^2+y^2}\). Donc \(\partial_x f = 0\), et le même calcul donne \(\partial_y f = -\dfrac{x}{x^2+y^2} + \dfrac{x}{x^2+y^2} = 0\).
- On a \(f(1,1) = \dfrac{\pi}{4} + \dfrac{\pi}{4} = \dfrac{\pi}{2}\) et \(f(1,-1) = -\dfrac{\pi}{2}\). Donc \(f\) n’est pas constante. Ce n’est pas contradictoire, car \(U\) n’est pas connexe par arcs. En effet, si un arc continu \(\gamma\) reliait \((1,1)\) à \((1,-1)\) dans \(U\), la fonction continue \(t \mapsto \gamma_1(t)\gamma_2(t)\) passerait de \(1\) à \(-1\). Par le théorème des valeurs intermédiaires, elle s’annulerait, ce qui est impossible dans \(U\).
- Chaque quadrant ouvert est convexe, donc connexe par arcs, et \(df = 0\) y est vrai. Ainsi, \(f\) est constante sur chacun. On calcule en un point de chaque quadrant : \(f(1,1) = f(-1,-1) = \dfrac{\pi}{2}\) et \(f(-1,1) = f(1,-1) = -\dfrac{\pi}{2}\). Finalement, \(f = \dfrac{\pi}{2}\) si \(xy > 0\) et \(f = -\dfrac{\pi}{2}\) si \(xy < 0\).
On retrouve ainsi une identité d’une variable bien connue. En posant \(u = x/y\), elle s’écrit \(\arctan u + \arctan(1/u) = \pm \dfrac{\pi}{2}\), avec le signe de \(u\). Le passage par deux variables montre surtout comment la topologie de l’ouvert intervient dans la conclusion.
Corrigé de l’exercice 11 – Majoration d’un logarithme par les accroissements
Idée clé : intégrer la différentielle le long du segment \([a,b]\), puis majorer l’intégrande par Cauchy-Schwarz.
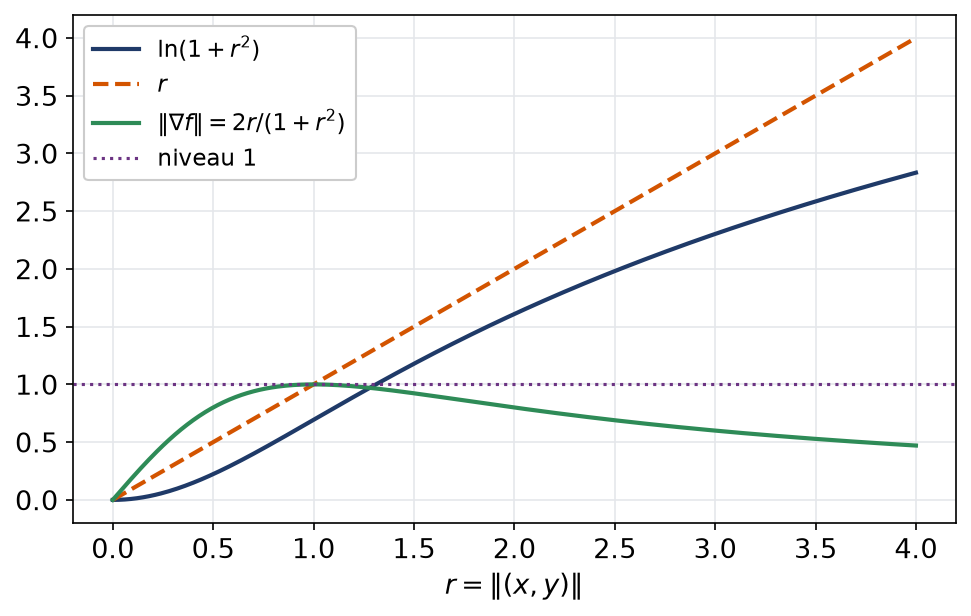
- La fonction \(f\) est de classe \(C^1\) sur \(\mathbb{R}^2\), et \(\nabla f(x,y) = \dfrac{(2x, \, 2y)}{1 + x^2 + y^2}\). Notons \(r = \sqrt{x^2+y^2}\). Alors \(\|\nabla f(x,y)\| = \dfrac{2r}{1 + r^2}\). Or \(1 + r^2 – 2r = (1 – r)^2 \geqslant 0\). Donc \(\|\nabla f(x,y)\| \leqslant 1\), avec égalité sur le cercle unité.
- Posons \(\gamma(t) = a + t(b – a)\) pour \(t \in [0,1]\). C’est un arc de classe \(C^1\) de vitesse \(b – a\). Le cours donne \(f(b) – f(a) = \int_0^1 \langle \nabla f(\gamma(t)), b – a \rangle \, dt\). Par Cauchy-Schwarz, l’intégrande est majorée en valeur absolue par \(\|\nabla f(\gamma(t))\| \, \|b – a\| \leqslant \|b – a\|\). Donc \(|f(b) – f(a)| \leqslant \|b – a\|\).
- On applique ce résultat avec \(a = (0,0)\) et \(b = (x,y)\). Comme \(f(0,0) = \ln 1 = 0\), on obtient \(\ln(1 + x^2 + y^2) \leqslant \sqrt{x^2+y^2}\). La figure confirme que la courbe du logarithme reste sous la première bissectrice.
Corrigé de l’exercice 12 – Coordonnées polaires et norme du gradient
Idée clé : les deux dérivées polaires sont, au facteur \(r\) près, les coordonnées du gradient dans la base orthonormée \((u_r, u_\theta)\).
- Posons \(P(r, \theta) = (r\cos\theta, r\sin\theta)\), de classe \(C^1\). La règle de la chaîne donne, avec les dérivées de \(f\) évaluées en \(P(r,\theta)\) : \(\partial_r g = \cos\theta \, \partial_1 f + \sin\theta \, \partial_2 f\) et \(\partial_\theta g = -r \sin\theta \, \partial_1 f + r\cos\theta \, \partial_2 f\).
- Ces formules s’écrivent \(\partial_r g = \langle \nabla f(P), u_r \rangle\) et \(\partial_\theta g = r \langle \nabla f(P), u_\theta \rangle\). Or \((u_r, u_\theta)\) est une base orthonormée de \(\mathbb{R}^2\). Par conséquent, \(\|\nabla f(P)\|^2 = \langle \nabla f(P), u_r \rangle^2 + \langle \nabla f(P), u_\theta \rangle^2\). Pour \(r > 0\), on obtient \(\|\nabla f(P)\|^2 = (\partial_r g)^2 + \dfrac{1}{r^2}(\partial_\theta g)^2\).
- On a \(g(r,\theta) = r^3 \big(\cos^3\theta – 3\cos\theta \sin^2\theta\big) = r^3 \cos(3\theta)\). Donc \(\partial_r g = 3r^2 \cos(3\theta)\) et \(\partial_\theta g = -3r^3 \sin(3\theta)\). La formule donne \(9r^4\cos^2(3\theta) + 9r^4 \sin^2(3\theta) = 9r^4\). Directement, \(\nabla f = (3x^2 – 3y^2, \, -6xy)\), d’où \(\|\nabla f\|^2 = 9(x^2 – y^2)^2 + 36x^2y^2 = 9(x^2+y^2)^2\). Les deux calculs donnent \(9r^4\).
Corrigé de l’exercice 13 – Carré complexe et règle de la chaîne
Idée clé : la jacobienne de \(P\) est une similitude, ce qui explique le facteur \(4(u^2+v^2)\).
- On dérive les composantes \(u^2 – v^2\) et \(2uv\). On obtient \(J_P(u,v) = \begin{pmatrix} 2u & -2v \\ 2v & 2u \end{pmatrix}\), de déterminant \(4(u^2 + v^2)\).
- La règle de la chaîne s’écrit \(J_g(u,v) = J_f(P(u,v)) \, J_P(u,v)\). Avec \(\partial_1 f\) et \(\partial_2 f\) évaluées en \(P(u,v)\), on trouve \(\partial_u g = 2u \, \partial_1 f + 2v \, \partial_2 f\) et \(\partial_v g = -2v \, \partial_1 f + 2u \, \partial_2 f\).
- On élève au carré et on additionne. Les doubles produits valent \(8uv \, \partial_1 f \, \partial_2 f\) et \(-8uv \, \partial_1 f \, \partial_2 f\), donc ils se compensent. Il reste \(4(u^2+v^2)(\partial_1 f)^2 + 4(u^2+v^2)(\partial_2 f)^2\). Donc \(\|\nabla g(u,v)\|^2 = 4(u^2+v^2) \, \|\nabla f(P(u,v))\|^2\).
- Pour \(f(x,y) = x\), on a \(\|\nabla f\| = 1\) et \(g(u,v) = u^2 – v^2\). Ainsi, \(\nabla g = (2u, -2v)\) et \(\|\nabla g\|^2 = 4(u^2+v^2)\). La relation est vérifiée.
Corrigé de l’exercice 14 – Différentielle de l’inverse et de sa trace
Idée clé : la trace est linéaire, donc elle « passe » à travers la différentielle ; il reste à utiliser l’invariance de la trace par permutation circulaire.
- Le déterminant est continu et \(GL_n(\mathbb{R}) = \det^{-1}(\mathbb{R}^*)\), image réciproque d’un ouvert. Donc \(GL_n(\mathbb{R})\) est ouvert et \(d\iota(M)(H) = -M^{-1} H M^{-1}\).
- On a \(T = \operatorname{tr} \circ \iota\) avec \(\operatorname{tr}\) linéaire, donc \(d(\operatorname{tr})(N) = \operatorname{tr}\) en tout point. La règle de la chaîne donne \(dT(M)(H) = \operatorname{tr}\big(-M^{-1} H M^{-1}\big)\). Comme \(\operatorname{tr}(PQ) = \operatorname{tr}(QP)\), avec \(P = M^{-1}H\) et \(Q = M^{-1}\), on obtient \(dT(M)(H) = -\operatorname{tr}(M^{-2} H)\).
- L’application \(t \mapsto I_n + tA\) est continue et vaut \(I_n \in GL_n(\mathbb{R})\) en \(0\). Comme \(GL_n(\mathbb{R})\) est ouvert, il existe \(\delta > 0\) tel que \(I_n + tA\) soit inversible pour \(|t| < \delta\). Cet arc a pour vitesse \(A\). La dérivée en \(0\) vaut donc \(dT(I_n)(A) = -\operatorname{tr}(I_n^{-2} A)\). Elle est égale à \(-\operatorname{tr}(A)\).
- Pour \(A = \operatorname{diag}(1,2,3)\), on a \(\operatorname{tr}\big((I_3 + tA)^{-1}\big) = \dfrac{1}{1+t} + \dfrac{1}{1+2t} + \dfrac{1}{1+3t}\). Sa dérivée en \(0\) vaut \(-1 – 2 – 3\). On trouve \(-6 = -\operatorname{tr}(A)\).
Le résultat se comprend aussi par un développement. Pour \(|t|\) petit, on a \((I_n + tA)^{-1} = I_n – tA + O(t^2)\). En prenant la trace, on obtient \(n – t \operatorname{tr}(A) + O(t^2)\), ce qui confirme la dérivée trouvée.
Corrigé de l’exercice 15 – Différentielle du déterminant par multilinéarité
Idée clé : appliquer la formule de différentiation des applications multilinéaires, puis développer chaque terme selon la colonne modifiée.
- L’application \((C_1, \dots, C_n) \mapsto \det(C_1 \mid \dots \mid C_n)\) est \(n\)-linéaire. En notant \(H_j\) la \(j\)-ième colonne de \(H\), le cours donne \(d(\det)(M)(H) = \sum_{j=1}^{n} \det(C_1 \mid \dots \mid C_{j-1} \mid H_j \mid C_{j+1} \mid \dots \mid C_n)\).
- Développons le \(j\)-ième déterminant selon sa colonne \(j\). Ses cofacteurs relatifs à cette colonne sont ceux de \(M\), car les autres colonnes sont inchangées. Il vaut donc \(\sum_{i} h_{ij} \, c_{ij}(M)\). En sommant sur \(j\), on obtient \(\sum_{i,j} c_{ij}(M) h_{ij}\). Or \(\operatorname{tr}\big(\operatorname{com}(M)^{\top} H\big) = \sum_{j} \sum_{i} c_{ij}(M) h_{ij}\). D’où \(d(\det)(M)(H) = \operatorname{tr}\big(\operatorname{com}(M)^{\top} H\big)\).
- Ici, \(\operatorname{com}(M) = \begin{pmatrix} 1 & -1 \\ -1 & 2 \end{pmatrix}\). Seuls \(h_{12} = 1\) et \(h_{21} = 3\) sont non nuls, donc \(d(\det)(M)(H) = (-1) \times 1 + (-1) \times 3 = -4\). Pour contrôler, \(\det(M + tH) = 2 – (1+t)(1+3t) = 1 – 4t – 3t^2\), dont la dérivée en \(0\) vaut \(-4\). On trouve \(d(\det)(M)(H) = -4\).
Corrigé de l’exercice 16 – Déterminant d’une exponentielle de matrice
Idée clé : dériver \(\det\) le long de l’arc \(t \mapsto e^{tA}\), puis résoudre une équation différentielle scalaire.
- Notons \(E(t) = e^{tA}\). La fonction \(\det\) est de classe \(C^1\) et \(E\) est dérivable, donc \(\varphi^{\prime}(t) = d(\det)(E(t))\big(A E(t)\big)\). Comme \(E(t)\) est inversible, cela vaut \(\det(E(t)) \operatorname{tr}\big(E(t)^{-1} A E(t)\big)\). Or deux matrices semblables ont la même trace. Donc \(\varphi^{\prime}(t) = \operatorname{tr}(A) \, \varphi(t)\).
- Posons \(\chi(t) = \varphi(t) e^{-t \operatorname{tr}(A)}\). Alors \(\chi^{\prime}(t) = 0\) sur l’intervalle \(\mathbb{R}\), donc \(\chi\) est constante, égale à \(\chi(0) = \det(I_n) = 1\). Ainsi, \(\varphi(t) = e^{t \operatorname{tr}(A)}\). Pour \(t = 1\), on obtient \(\det(e^{A}) = e^{\operatorname{tr}(A)}\).
- La trace de \(B\) vaut \(1 + 3 = 4\). Donc \(\det(e^{B}) = e^{4}\).
On peut contrôler ce résultat autrement. La matrice \(B\) est triangulaire supérieure, donc \(e^{B}\) l’est aussi, avec \(e^{1}\) et \(e^{3}\) sur la diagonale. Son déterminant vaut alors \(e^{1} \times e^{3} = e^{4}\). Par ailleurs, la formule montre que \(\det(e^{A}) > 0\) pour toute matrice réelle \(A\). Par conséquent, une matrice de déterminant négatif n’est jamais l’exponentielle d’une matrice réelle.
Pour approfondir
Corrigé de l’exercice 17 – Identité d’Euler pour les fonctions homogènes
Idée clé : dériver la relation d’homogénéité par rapport au paramètre \(t\), ou par rapport à la variable \(x\).
- Fixons \(x \neq 0\). L’arc \(t \mapsto tx\) reste dans \(\mathbb{R}^n \setminus \{0\}\) pour \(t > 0\), et sa vitesse est \(x\). En dérivant \(f(tx) = t^{\alpha} f(x)\) par rapport à \(t\), on obtient \(df(tx)(x) = \alpha t^{\alpha – 1} f(x)\). Pour \(t = 1\), il vient \(df(x)(x) = \alpha f(x)\).
- Posons \(\chi(t) = t^{-\alpha} f(tx)\) sur \(]0, +\infty[\). Alors \(\chi^{\prime}(t) = -\alpha t^{-\alpha-1} f(tx) + t^{-\alpha} df(tx)(x)\). Par linéarité, \(df(tx)(x) = \dfrac{1}{t} df(tx)(tx) = \dfrac{\alpha}{t} f(tx)\). Les deux termes de \(\chi^{\prime}(t)\) se compensent alors exactement. La fonction \(\chi\), de dérivée nulle sur \(]0, +\infty[\), vaut partout \(\chi(1) = f(x)\). On récupère \(f(tx) = t^{\alpha} f(x)\), c’est-à-dire l’homogénéité de degré \(\alpha\).
- Prenons \(t > 0\) quelconque. La dérivée partielle d’indice \(j\) de \(x \mapsto f(tx)\) vaut \(t \, \partial_j f(tx)\), toujours par composition. L’autre membre donne \(t^{\alpha} \partial_j f(x)\). Donc \(\partial_j f(tx) = t^{\alpha – 1} \partial_j f(x)\) : \(\partial_j f\) est homogène de degré \(\alpha – 1\).
- La fonction \(f\) est homogène de degré \(2\). On calcule \(\partial_x f = \dfrac{2x^5 + 4x^3y^2 – 2xy^4}{(x^2+y^2)^2}\) et, par symétrie, \(\partial_y f = \dfrac{2y^5 + 4x^2y^3 – 2x^4 y}{(x^2+y^2)^2}\). Ensuite, \(x \partial_x f + y \partial_y f = \dfrac{2(x^6 + x^4y^2 + x^2y^4 + y^6)}{(x^2+y^2)^2}\). Or \(x^6 + x^4y^2 + x^2y^4 + y^6 = (x^4 + y^4)(x^2+y^2)\). Donc \(x \partial_x f + y \partial_y f = 2f\), comme prévu.
Corrigé de l’exercice 18 – Fonctions à gradient radial
Idée clé : le long d’un cercle centré en l’origine, la vitesse est orthogonale au rayon, donc au gradient.
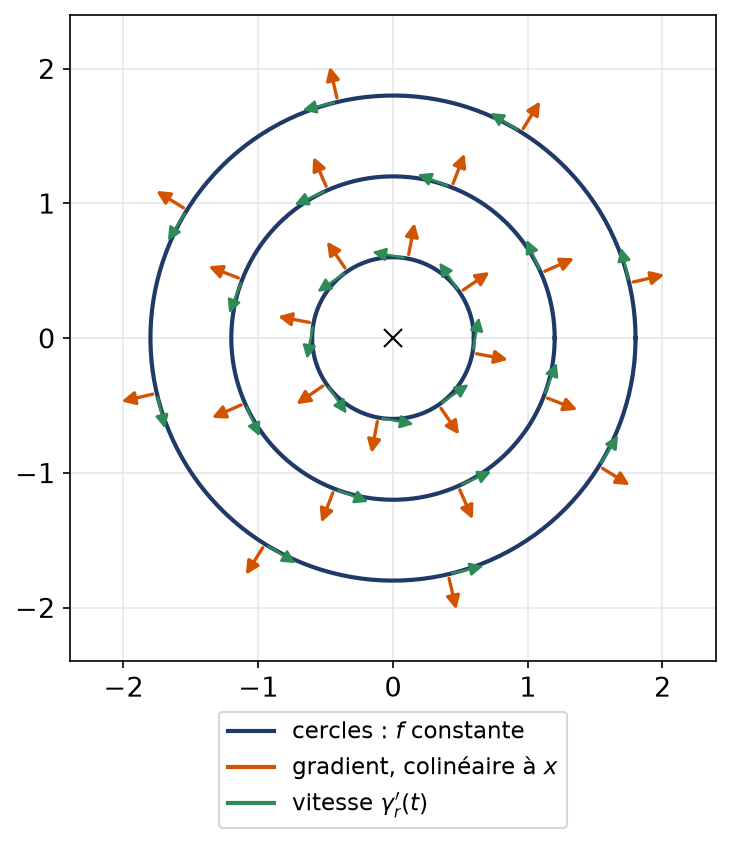
- L’arc \(\gamma_r\) est de classe \(C^1\) à valeurs dans \(U\), de vitesse \(\gamma_r^{\prime}(t) = (-r\sin t, r\cos t)\). D’après le cours, \((f \circ \gamma_r)^{\prime}(t) = \langle \nabla f(\gamma_r(t)), \gamma_r^{\prime}(t) \rangle\). Par hypothèse, \(\nabla f(\gamma_r(t)) = \lambda \, \gamma_r(t)\) pour un réel \(\lambda\). Or \(\langle \gamma_r(t), \gamma_r^{\prime}(t) \rangle = -r^2 \cos t \sin t + r^2 \sin t \cos t = 0\). Donc \((f \circ \gamma_r)^{\prime} = 0\) et \(f \circ \gamma_r\) est constante sur l’intervalle \(\mathbb{R}\).
- Posons \(\varphi(r) = f(r, 0)\) pour \(r > 0\). C’est la composée de \(r \mapsto (r,0)\) et de \(f\), donc \(\varphi\) est de classe \(C^1\). Soit \(x \in U\) et \(r = \|x\|\). Il existe \(t\) tel que \(x = \gamma_r(t)\). La question précédente donne \(f(x) = f(\gamma_r(t)) = f(\gamma_r(0)) = \varphi(r)\). Donc \(f(x) = \varphi(\|x\|)\) sur \(U\). La figure illustre la situation : la fonction est constante sur chaque cercle.
- Réciproquement, soit \(f(x) = \varphi(\|x\|)\) avec \(\varphi\) de classe \(C^1\). La norme est différentiable sur \(U\), de gradient \(x/\|x\|\) d’après l’exercice 6. La règle de la chaîne donne \(\nabla f(x) = \varphi^{\prime}(\|x\|) \, \dfrac{x}{\|x\|}\). Ce gradient est bien colinéaire à \(x\).
Corrigé de l’exercice 19 – Problème – Formule de Jacobi et wronskien
Idée clé : le développement selon une colonne donne les dérivées partielles du déterminant ; la relation \(X \operatorname{com}(X)^{\top} = \det(X) I_n\) transforme ensuite la formule de Jacobi en équation scalaire.
- La formule de Leibniz exprime \(\det M\) comme un polynôme en les \(n^2\) entrées \(m_{ij}\). Chaque dérivée partielle est encore un polynôme, en particulier continue : on en tire la classe \(C^1\). Ensuite, on développe selon la colonne \(j\) : \(\det M = \sum_{k=1}^{n} m_{kj} \, c_{kj}(M)\). Chaque \(c_{kj}(M)\) ne fait intervenir aucun coefficient de la colonne \(j\). Ainsi, \(\det M\) est une fonction affine de \(m_{ij}\), de coefficient \(c_{ij}(M)\). Donc \(\dfrac{\partial \det}{\partial m_{ij}}(M) = c_{ij}(M)\).
- Comme \(\det\) est différentiable, \(d(\det)(M)(H) = \sum_{i,j} h_{ij} \, \dfrac{\partial \det}{\partial m_{ij}}(M) = \sum_{i,j} c_{ij}(M) h_{ij}\). Cette somme vaut \(\operatorname{tr}\big(\operatorname{com}(M)^{\top} H\big)\).
- La règle de la chaîne le long de l’arc dérivable \(X\) donne \((\det X)^{\prime}(t) = d(\det)(X(t))\big(X^{\prime}(t)\big)\). Avec la question 2, on obtient \((\det X)^{\prime}(t) = \operatorname{tr}\big(\operatorname{com}(X(t))^{\top} X^{\prime}(t)\big)\).
- D’après la question 3, \(w^{\prime}(t) = \operatorname{tr}\big(\operatorname{com}(X)^{\top} A X\big)\), où l’on omet la variable \(t\). Par invariance de la trace, cela vaut \(\operatorname{tr}\big(X \operatorname{com}(X)^{\top} A\big)\). Or \(X \operatorname{com}(X)^{\top} = \det(X) I_n\). Donc \(w^{\prime}(t) = \operatorname{tr}(A(t)) \, w(t)\). Cette relation vaut même si \(X(t)\) n’est pas inversible.
- Posons \(\Lambda(t) = \int_{t_0}^{t} \operatorname{tr}(A(s)) \, ds\), qui est une primitive de la fonction continue \(\operatorname{tr} \circ A\). Alors \(\big(w e^{-\Lambda}\big)^{\prime} = (w^{\prime} – \operatorname{tr}(A) w) e^{-\Lambda} = 0\) sur l’intervalle \(I\). Comme \(\Lambda(t_0) = 0\), on obtient \(w(t) = w(t_0) \exp\big(\Lambda(t)\big)\).
- Si \(X(t_0)\) est inversible, alors \(w(t_0) \neq 0\). Comme l’exponentielle ne s’annule pas, \(w(t) \neq 0\) pour tout \(t\). Donc \(X(t)\) est inversible pour tout \(t \in I\).
- On dérive : \(X^{\prime}(t) = e^{t^2/2}\left[ t \begin{pmatrix} 1 & t \\ 0 & 1 \end{pmatrix} + \begin{pmatrix} 0 & 1 \\ 0 & 0 \end{pmatrix} \right] = e^{t^2/2} \begin{pmatrix} t & t^2 + 1 \\ 0 & t \end{pmatrix}\). Par ailleurs, \(A(t) X(t) = e^{t^2/2} \begin{pmatrix} t & t^2 + 1 \\ 0 & t \end{pmatrix}\). Enfin, \(X(0) = I_2\). Donc \(X^{\prime} = AX\) et \(X(0) = I_2\).
- Directement, \(\det X(t) = \big(e^{t^2/2}\big)^2 \times 1 = e^{t^2}\). Avec la question 5, \(\operatorname{tr}(A(s)) = 2s\), donc \(\Lambda(t) = t^2\) pour \(t_0 = 0\). Comme \(w(0) = 1\), on trouve \(w(t) = e^{t^2}\). Les deux calculs donnent \(\det X(t) = e^{t^2}\).
Ce problème contient un résultat important pour le chapitre sur les systèmes différentiels linéaires. En effet, si les colonnes de \(X\) sont des solutions du système \(Y^{\prime} = A(t) Y\), leur déterminant est le wronskien. Les questions 5 et 6 donnent alors une alternative nette : soit le wronskien ne s’annule jamais, soit il est identiquement nul. Autrement dit, des solutions indépendantes à un instant le restent à tout instant. De plus, la formule de la question 5 donne la valeur du wronskien sans résoudre le système, ce qui est souvent la clé d’un exercice d’oral.
Pour aller plus loin
- Revoir la leçon : cours de maths spé (MP) sur différentielle et règle de la chaîne
- S’exercer : exercices corrigés de maths spé (MP) sur différentielle et règle de la chaîne
- Bases utiles : Compacité, connexité et applications linéaires continues, Dérivation et intégration des fonctions vectorielles
- Chapitre d’avant : Exponentielle de matrice et systèmes X' = AX
- Chapitre d’après : Extremums, hessienne et optimisation sous contrainte
- Vérifier ses acquis : QCM de maths spé (MP) sur différentielle et règle de la chaîne
- Contrôle corrigé en temps limité : Différentielles, gradient et extremums liés : contrôle de maths en MP
- Le même thème en L2 de maths : Dérivées partielles, différentielle et jacobienne
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «corrigé des exercices : Différentielle et règle de la chaîne en maths spé (MP)» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir
Exercices corrigés
Tout voir
Contrôles
Tout voir
QCM
Tout voir