Loi faible et séries génératrices en maths spé (MP) : cours et méthodes

Ce chapitre clôt le programme de probabilités de deuxième année avec deux familles d’outils. D’abord, les inégalités de Markov et de Bienaymé-Tchebychev majorent la probabilité d’un écart, et elles mènent à la loi faible des grands nombres. Ensuite, les séries génératrices MP transforment une loi à valeurs entières en une série entière, que l’on dérive et que l’on multiplie.
Vous apprendrez à reconnaître une loi à partir de sa fonction génératrice, à obtenir espérance et variance par dérivation en 1, et à trouver la loi d’une somme de variables indépendantes sans produit de convolution. Le chapitre s’appuie sur les séries entières du premier semestre et sur le cours d’espérance et de variance. Il prépare les sujets d’écrit, où les méthodes de calcul de lois occupent souvent une partie entière.
Ce que vous saurez faire
- Majorer la probabilité qu’une variable s’écarte de sa moyenne, avec Markov ou Bienaymé-Tchebychev.
- Dimensionner un échantillon grâce à la loi faible des grands nombres et à sa majoration explicite.
- Écrire la fonction génératrice d’une variable à valeurs entières et connaître celles des lois usuelles.
- Reconnaître une loi à partir de sa fonction génératrice, en lisant les coefficients d’une série entière.
- Calculer espérance et variance par dérivation de \(G_X\) en 1.
- Obtenir la loi d’une somme de variables indépendantes par un simple produit de fonctions génératrices.
1. Les inégalités de Markov et de Bienaymé-Tchebychev
Dans tout le chapitre, \((\Omega,\mathcal{A},P)\) est un espace probabilisé et les variables sont discrètes. Les deux inégalités de cette partie demandent très peu d’information : une espérance, parfois une variance. En contrepartie, elles donnent des majorations grossières, mais toujours valables.
1.1 L’inégalité de Markov
Soit \(X\) une variable aléatoire réelle positive d’espérance finie. Pour tout réel \(a>0\), \[P(X\geqslant a)\leqslant\frac{E(X)}{a}.\]
Notons \(\mathbf{1}_A\) l’indicatrice de l’événement \(A=(X\geqslant a)\). Sur \(A\), on a \(X\geqslant a\) ; hors de \(A\), on a \(X\geqslant 0\). Dans les deux cas, \(X\geqslant a\,\mathbf{1}_A\). Par croissance de l’espérance, \(E(X)\geqslant a\,E(\mathbf{1}_A)=a\,P(A)\). Il reste à diviser par \(a>0\).
Le temps de traitement \(X\) d’un dossier, en minutes, est positif et d’espérance 12. Sans rien connaître de plus, majorons la probabilité d’attendre au moins une heure. L’inégalité de Markov avec \(a=60\) donne \(P(X\geqslant 60)\leqslant\frac{12}{60}=\frac{1}{5}\). Ainsi, au plus un dossier sur cinq dépasse une heure, quelle que soit la loi exacte.
Remarque :
On applique souvent Markov à une fonction positive et croissante de \(X\). Par exemple, pour \(s>0\), on a \(P(X\geqslant a)=P\left(e^{sX}\geqslant e^{sa}\right)\leqslant e^{-sa}E\left(e^{sX}\right)\). Ensuite, on choisit \(s\) pour rendre ce majorant le plus petit possible. Cette idée donne des majorations exponentielles bien plus fines.
1.2 L’inégalité de Bienaymé-Tchebychev
Soit \(X\) une variable aléatoire admettant un moment d’ordre 2, et \(m=E(X)\). Pour tout réel \(\varepsilon>0\), \[P\left(|X-m|\geqslant\varepsilon\right)\leqslant\frac{V(X)}{\varepsilon^2}.\]
Posons \(Y=(X-m)^2\). Cette variable est positive, et son espérance est exactement la variance de \(X\). Ensuite, un écart \(|X-m|\) au moins égal à \(\varepsilon\) équivaut à \(Y\geqslant\varepsilon^2\), puisque la fonction carré est croissante sur \(\mathbb{R}_+\). Il suffit donc d’utiliser Markov pour \(Y\), au seuil \(\varepsilon^2\).
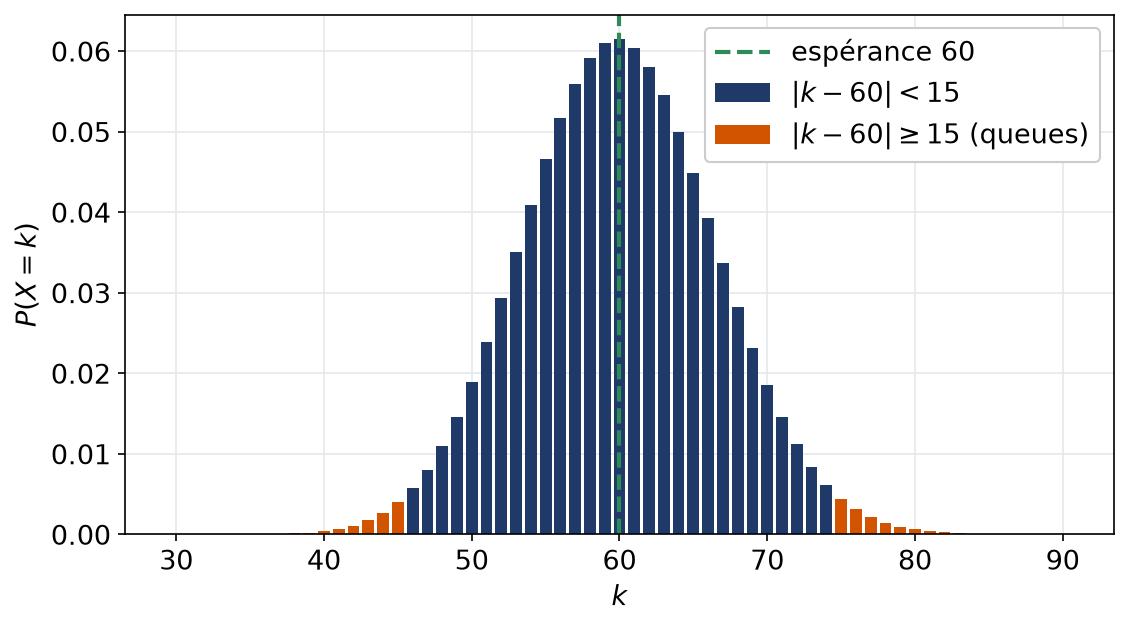
Soit \(X\) de loi binomiale \(\mathcal{B}(200\,;\,0{,}3)\). Alors \(E(X)=60\) et \(V(X)=200\times 0{,}3\times 0{,}7=42\). Pour \(\varepsilon=15\), on obtient \(P\left(|X-60|\geqslant 15\right)\leqslant\frac{42}{225}\approx 0{,}187\). Par passage au complémentaire, \(P(45<X<75)\geqslant 0{,}81\). La valeur exacte est en réalité proche de \(0{,}98\) : la majoration est sûre, mais pessimiste.
La figure représente la loi de \(X\). Les barres orange forment l’événement \(|X-60|\geqslant 15\), dont la probabilité totale est bien plus faible que \(0{,}187\).
- Calculer l’espérance et la variance de la variable étudiée, souvent une somme ou une moyenne.
- Réécrire l’événement demandé comme un écart à l’espérance, quitte à l’inclure dans un écart symétrique.
- Appliquer Bienaymé-Tchebychev avec le bon \(\varepsilon\), puis passer au complémentaire si besoin.
- Vérifier que le majorant obtenu est inférieur à 1 : sinon, il n’apprend rien.
Piège à éviter :
Un événement unilatéral comme \((X\geqslant 75)\) n’est pas un écart symétrique. Cependant, il est inclus dans \(\left(|X-60|\geqslant 15\right)\), donc sa probabilité est majorée par le même nombre. En revanche, on ne peut pas diviser ce majorant par deux sans argument de symétrie de la loi.
1.3 Choisir la bonne inégalité
On croit souvent que Bienaymé-Tchebychev bat toujours Markov, puisqu’elle utilise plus d’information. C’est faux pour des seuils proches de la moyenne, ou pour des lois très étalées. Il faut donc comparer les deux majorants avant de conclure.
Soit \(X\) uniforme sur \(\{0,1,\dots,20\}\). Alors \(E(X)=10\) et \(V(X)=\frac{20\times 22}{12}=\frac{110}{3}\). Cherchons à majorer \(P(X\geqslant 18)\). D’une part, Markov donne \(\frac{10}{18}\approx 0{,}56\). D’autre part, \((X\geqslant 18)\subset\left(|X-10|\geqslant 8\right)\), et Bienaymé-Tchebychev donne \(\frac{110/3}{64}\approx 0{,}57\). Ici, Markov est donc légèrement meilleure. Enfin, la valeur exacte vaut \(\frac{3}{21}=\frac{1}{7}\approx 0{,}14\) : les deux majorants restent très loin du vrai résultat.
Pour une queue lointaine, la majoration de Markov appliquée à \(e^{sX}\) est presque toujours la plus efficace. Lorsque la loi est à valeurs entières, \(E\left(e^{sX}\right)=G_X\left(e^s\right)\) : la fonction génératrice de la partie 3 fournit alors directement le majorant.
2. La loi faible des grands nombres
Lorsqu’on recommence un grand nombre de fois une expérience aléatoire, sans que les essais s’influencent, la valeur moyenne observée finit par peu varier. Cette constatation expérimentale devient ici un théorème. Il porte sur la probabilité qu’une moyenne empirique s’éloigne de la valeur théorique.
2.1 Énoncé et preuve
On considère des variables \(X_1,X_2,\dots\) qui ont toutes la même loi, possèdent une variance et sont indépendantes deux à deux. Leur espérance commune est notée \(m\), leur variance \(\sigma^2\), et l’on pose \(S_n=X_1+\cdots+X_n\). Pour tout \(\varepsilon>0\), \[P\left(\left|\frac{S_n}{n}-m\right|\geqslant\varepsilon\right)\leqslant\frac{\sigma^2}{n\varepsilon^2}\xrightarrow[n\to+\infty]{}0.\]
Par linéarité, \(E\left(\frac{S_n}{n}\right)=m\). Ensuite, les variables sont deux à deux indépendantes, donc leurs covariances sont nulles. Ainsi \(V(S_n)=\sum_{k=1}^{n}V(X_k)=n\sigma^2\), puis \(V\left(\frac{S_n}{n}\right)=\frac{\sigma^2}{n}\). L’inégalité de Bienaymé-Tchebychev appliquée à \(\frac{S_n}{n}\) donne alors la majoration annoncée.
La majoration explicite vaut mieux que la simple limite. En effet, elle permet de choisir \(n\) à l’avance pour une précision et un risque fixés.
2.2 Application aux fréquences
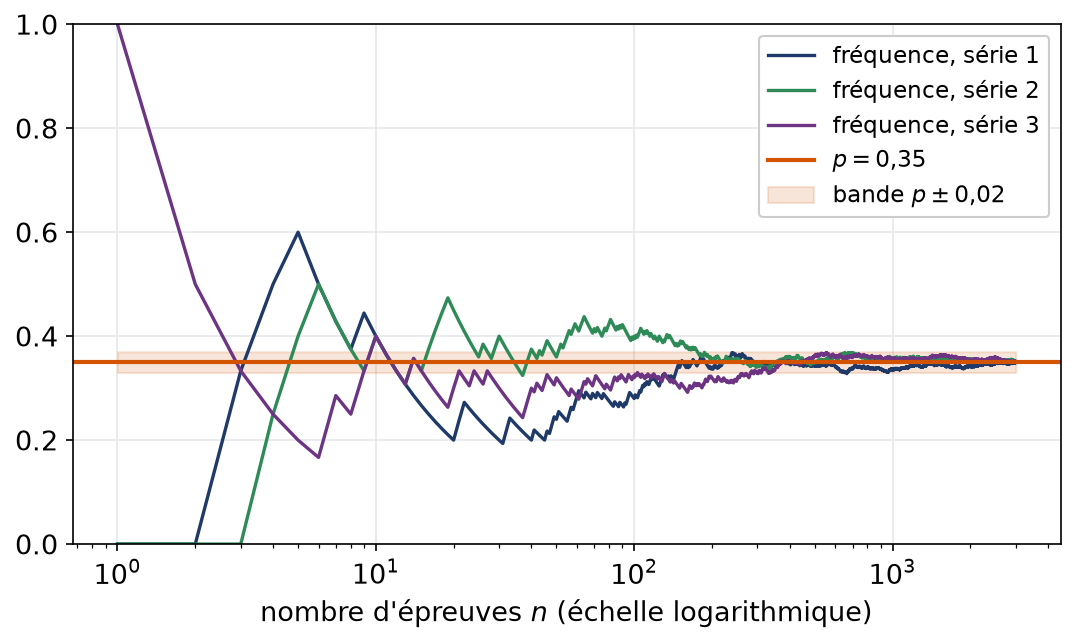
Une proportion inconnue \(p\) de pièces d’une chaîne de production présente un défaut. On contrôle \(n\) pièces de façon indépendante, et \(X_k\) vaut 1 si la \(k\)-ième pièce est défectueuse. Les \(X_k\) suivent la loi de Bernoulli \(\mathcal{B}(p)\), de variance \(p(1-p)\). Or \(p(1-p)\leqslant\frac{1}{4}\) pour tout \(p\in[0,1]\). La fréquence observée \(F_n=\frac{S_n}{n}\) vérifie donc \[P\left(|F_n-p|\geqslant 0{,}02\right)\leqslant\frac{1}{4n\times 0{,}0004}=\frac{625}{n}.\] Pour un risque inférieur à \(0{,}1\), il suffit que \(\frac{625}{n}\leqslant 0{,}1\), c’est-à-dire \(n\geqslant 6250\).
La figure suit trois séries simulées d’épreuves avec \(p=0{,}35\). Chaque fréquence oscille fortement au début, puis entre dans la bande de largeur \(0{,}04\) et n’en sort presque plus.
- Identifier les \(X_k\), vérifier qu’elles sont indépendantes (deux à deux suffit) et de même loi.
- Calculer \(m\) et \(\sigma^2\), ou majorer \(\sigma^2\) quand le paramètre est inconnu.
- Écrire la majoration \(\frac{\sigma^2}{n\varepsilon^2}\) et la comparer au risque toléré.
- En déduire la taille d’échantillon ou la limite cherchée.
Piège à éviter :
La loi faible n’affirme pas que \(\frac{S_n}{n}\) tend vers \(m\) pour chaque tirage. Elle dit seulement que la probabilité d’un écart fixé tend vers 0. Autrement dit, une trajectoire peut encore s’écarter de temps en temps : c’est un énoncé sur des probabilités, pas sur des suites de nombres.
Remarque :
L’hypothèse de même loi sert seulement à calculer la variance de \(S_n\). Par conséquent, la preuve reste valable pour des variables indépendantes de lois différentes, pourvu que leurs variances soient bornées par une même constante \(C\). On obtient alors \(P\left(\left|\frac{S_n-E(S_n)}{n}\right|\geqslant\varepsilon\right)\leqslant\frac{C}{n\varepsilon^2}\). Ce prolongement revient souvent dans les sujets, par exemple pour des épreuves de Bernoulli de paramètres variables.
3. Séries génératrices : définition et caractérisation de la loi
À partir de maintenant, \(X\) est une variable à valeurs dans \(\mathbb{N}\). Sa loi est la suite des nombres \(p_n=P(X=n)\). L’idée est de ranger cette suite dans une série entière, puis d’utiliser toute la théorie des séries entières.
3.1 Définition et convergence
La fonction génératrice de \(X\) est définie par \[G_X(t)=E\left(t^X\right)=\sum_{n=0}^{+\infty}P(X=n)\,t^n,\] pour tout \(t\) en lequel la série converge.
L’égalité entre l’espérance et la somme vient de la formule de transfert, appliquée à la fonction \(n\mapsto t^n\). Par convention, \(t^0=1\), même pour \(t=0\). Ainsi \(G_X(0)=P(X=0)\).
La série entière \(\sum P(X=n)t^n\) a un rayon de convergence au moins égal à 1. Elle converge normalement sur le disque fermé \(\{|t|\leqslant 1\}\). En particulier, \(G_X\) est continue sur \([-1,1]\) et \(G_X(1)=1\).
Pour \(|t|\leqslant 1\), on a \(\left|P(X=n)t^n\right|\leqslant P(X=n)\). Or \(\sum P(X=n)\) converge et vaut 1, puisque les événements \((X=n)\) forment un système complet. D’où la convergence normale sur le disque fermé, donc un rayon au moins égal à 1. La continuité découle de la convergence normale d’une série de fonctions continues.
Remarque :
Il arrive que le rayon soit égal à 1 et pas davantage. C’est le cas de la loi définie par \(P(X=n)=\frac{6}{\pi^2n^2}\) pour \(n\geqslant 1\) : le quotient de deux coefficients consécutifs tend vers 1. Dans ce cas, \(G_X\) n’est définie que sur le disque fermé unité.
3.2 La fonction génératrice caractérise la loi
Pour tout \(n\in\mathbb{N}\), \(P(X=n)=\dfrac{G_X^{(n)}(0)}{n!}\). Par conséquent, deux variables à valeurs dans \(\mathbb{N}\) ont la même loi si et seulement si leurs fonctions génératrices coïncident sur \(]-1,1[\).
Une série entière de rayon \(R\geqslant 1\) est de classe \(\mathcal{C}^\infty\) sur \(]-1,1[\), et ses coefficients s’obtiennent par dérivations successives en 0. Ainsi le \(n\)-ième coefficient \(P(X=n)\) vaut \(\frac{G_X^{(n)}(0)}{n!}\). Si deux fonctions génératrices coïncident sur \(]-1,1[\), leurs dérivées en 0 coïncident aussi, donc les lois sont égales.
Une variable \(X\) a pour fonction génératrice \(G_X(t)=\frac{t^2(1+t)^3}{8}\). Écrivons \(G_X(t)=t^2\left(\frac{1}{2}+\frac{1}{2}t\right)^3\). Le facteur \(\left(\frac{1}{2}+\frac{1}{2}t\right)^3\) est la fonction génératrice d’une variable \(Y\) de loi \(\mathcal{B}\left(3\,;\,\frac{1}{2}\right)\). De plus, \(t^2G_Y(t)=E\left(t^{Y+2}\right)\). Par caractérisation, \(X\) a la loi de \(Y+2\). Par exemple, \(P(X=3)=P(Y=1)=\frac{3}{8}\).
4. Les fonctions génératrices des lois usuelles
Les calculs suivants reviennent dans presque tous les sujets. Chacun se fait en une ligne, à partir d’une série connue : somme géométrique, formule du binôme ou série exponentielle.
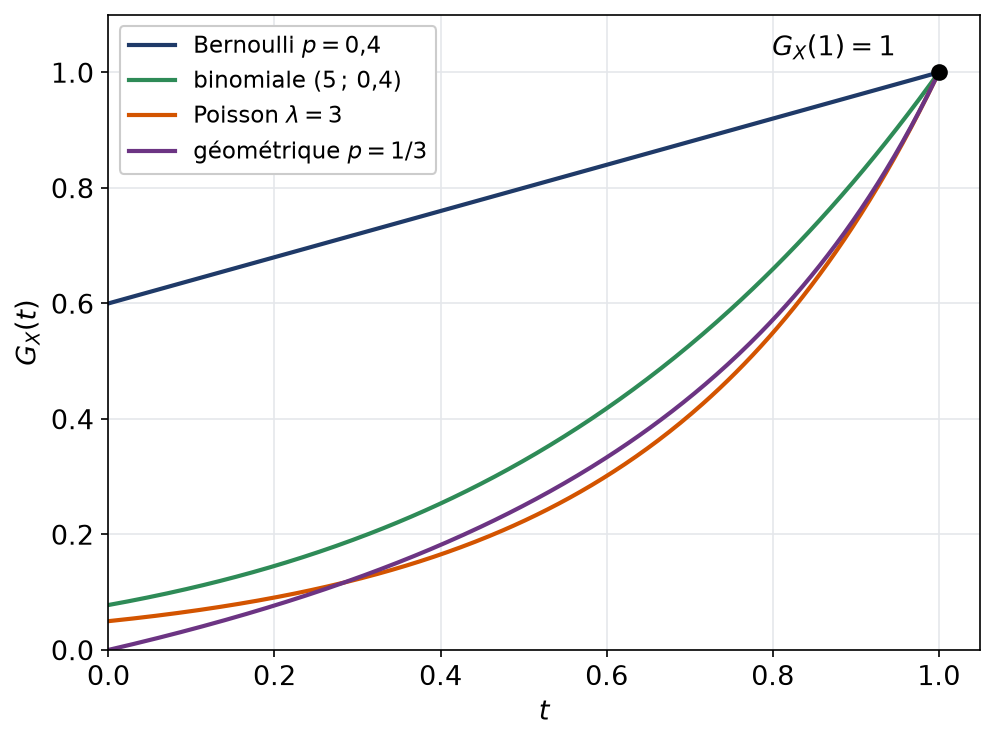
- Bernoulli \(\mathcal{B}(p)\), avec \(q=1-p\) : \(G_X(t)=q+pt\).
- Binomiale \(\mathcal{B}(n\,;\,p)\) : \(G_X(t)=\sum_{k=0}^{n}\binom{n}{k}p^kq^{n-k}t^k=(q+pt)^n\), par la formule du binôme.
- Géométrique \(\mathcal{G}(p)\) sur \(\mathbb{N}^*\) : \(G_X(t)=\sum_{k\geqslant 1}pq^{k-1}t^k=\dfrac{pt}{1-qt}\), pour \(|t|<\frac{1}{q}\).
- Poisson \(\mathcal{P}(\lambda)\) : \(G_X(t)=\sum_{k\geqslant 0}e^{-\lambda}\frac{\lambda^k}{k!}t^k=e^{\lambda(t-1)}\), pour tout réel \(t\).
- Uniforme sur \(\{1,\dots,n\}\) : \(G_X(t)=\dfrac{t+t^2+\cdots+t^n}{n}\).
La figure compare ces fonctions sur \([0,1]\). Toutes passent par le point \((1,1)\), et la valeur en 0 donne \(P(X=0)\). Par exemple, la courbe de la loi géométrique part de 0, car cette variable ne prend jamais la valeur 0.
Piège à éviter :
La loi géométrique du programme est à valeurs dans \(\mathbb{N}^*\) : elle compte le rang du premier succès. Si l’on compte plutôt le nombre d’échecs avant ce succès, la variable vaut \(X-1\) et sa fonction génératrice devient \(\frac{p}{1-qt}\). Il faut donc toujours vérifier la convention de l’énoncé.
5. Espérance et variance par la fonction génératrice
Dériver une série entière revient à multiplier chaque coefficient par son indice. Or l’espérance est justement \(\sum nP(X=n)\). C’est pourquoi les moments se lisent sur les dérivées de \(G_X\) au point 1.
5.1 Le théorème
- L’espérance de \(X\) est finie exactement lorsque \(G_X\) admet une dérivée au point 1, et cette dérivée vaut alors \(E(X)\).
- De même, \(E\left(X^2\right)\) est finie exactement lorsque \(G_X\) admet une dérivée seconde au point 1. On a alors \(G_X^{\prime\prime}(1)=E\left(X(X-1)\right)\) et \[V(X)=G_X^{\prime\prime}(1)+G_X^{\prime}(1)-G_X^{\prime}(1)^2.\]
Démontrons le sens direct du premier point. Supposons \(\sum nP(X=n)\) convergente. La série dérivée \(\sum nP(X=n)t^{n-1}\) converge alors normalement sur \([-1,1]\), car son terme est majoré par \(nP(X=n)\). Par le théorème de dérivation des séries de fonctions, \(G_X\) est de classe \(\mathcal{C}^1\) sur \([-1,1]\), et \(G_X^{\prime}(1)=\sum nP(X=n)=E(X)\). Le second point se traite de la même façon avec \(n(n-1)\). Enfin, \(V(X)=E\left(X(X-1)\right)+E(X)-E(X)^2\). La réciproque est admise.
Soit \(X\) de loi géométrique de paramètre \(\frac{1}{3}\). Sa fonction génératrice est \(G_X(t)=\frac{t/3}{1-2t/3}=\frac{t}{3-2t}\), de rayon \(\frac{3}{2}>1\). On dérive : \(G_X^{\prime}(t)=\frac{3}{(3-2t)^2}\) et \(G_X^{\prime\prime}(t)=\frac{12}{(3-2t)^3}\). Ainsi \(E(X)=G_X^{\prime}(1)=3\) et \(G_X^{\prime\prime}(1)=12\). On en déduit \(V(X)=12+3-9=6\). On retrouve bien \(\frac{q}{p^2}=\frac{2/3}{1/9}=6\).
- Écrire \(G_X\) sous forme fermée, en vérifiant son rayon de convergence.
- Si le rayon dépasse 1, dériver directement : la fonction est de classe \(\mathcal{C}^\infty\) au voisinage de 1.
- Sinon, étudier la dérivabilité en 1 à gauche, ou revenir à la série \(\sum nP(X=n)\).
- Calculer \(E(X)=G_X^{\prime}(1)\), puis \(V(X)=G_X^{\prime\prime}(1)+G_X^{\prime}(1)-G_X^{\prime}(1)^2\).
Piège à éviter :
La dérivée seconde en 1 vaut \(E\left(X(X-1)\right)\), et non \(E\left(X^2\right)\). Oublier le terme \(G_X^{\prime}(1)\) dans la variance est l’erreur la plus fréquente sur ce point. Par exemple, pour la loi géométrique précédente, on trouverait \(3\) au lieu de \(6\).
Remarque :
Le même raisonnement donne tous les moments factoriels. En effet, si la série \(\sum n^kP(X=n)\) converge, alors \(G_X^{(k)}(1)=E\left(X(X-1)\cdots(X-k+1)\right)\). Pour une loi de Poisson de paramètre \(\lambda\), on obtient ainsi \(\lambda^k\) sans aucun calcul de série. Ensuite, on retrouve \(E\left(X^3\right)\) en combinant les trois premiers moments factoriels.
5.2 Une variable sans espérance
Soit \(X\) telle que \(P(X=n)=\frac{1}{n(n+1)}\) pour \(n\geqslant 1\). Ces nombres sont positifs et leur somme télescopique vaut 1. Pourtant, \(nP(X=n)=\frac{1}{n+1}\) n’est pas sommable : \(X\) n’a pas d’espérance finie. Sur \([0,1[\), la dérivée \(G_X^{\prime}(t)=\sum_{n\geqslant 1}\frac{t^{n-1}}{n+1}\) est croissante et tend vers \(+\infty\) quand \(t\to 1^-\). Ainsi, \(G_X\) est continue en 1 mais n’y est pas dérivable.
6. Somme de variables indépendantes
La propriété la plus utile des fonctions génératrices concerne les sommes. Avec les lois seules, la loi d’une somme demande un produit de convolution. Avec les fonctions génératrices, elle se réduit à un produit ordinaire.
6.1 Le produit des fonctions génératrices
Soit \(X\) et \(Y\) à valeurs entières naturelles. Lorsque \(X\) et \(Y\) sont indépendantes, on a \[G_{X+Y}(t)=G_X(t)\,G_Y(t)\quad\text{sur }[-1,1].\] Le résultat s’étend à une famille finie \((X_k)_{1\leqslant k\leqslant n}\) indépendante : la fonction génératrice de la somme est \(\prod_{k=1}^{n}G_{X_k}\).
Fixons \(t\in[-1,1]\). Les variables \(t^X\) et \(t^Y\) sont bornées, et elles sont indépendantes comme fonctions de variables indépendantes. L’espérance d’un produit de variables indépendantes d’espérance finie est le produit des espérances. Donc \(E\left(t^{X+Y}\right)=E\left(t^X\right)E\left(t^Y\right)\). Pour une famille de \(n\) variables, on raisonne par récurrence : le lemme des coalitions garantit que \(X_1+\cdots+X_{n-1}\) est indépendante de \(X_n\).
Prenons deux variables indépendantes \(X\) et \(Y\), de lois de Poisson de paramètres respectifs \(\lambda\) et \(\mu\). Alors \(G_{X+Y}(t)=e^{\lambda(t-1)}e^{\mu(t-1)}=e^{(\lambda+\mu)(t-1)}\). On reconnaît la fonction génératrice de \(\mathcal{P}(\lambda+\mu)\). Par caractérisation, \(X+Y\) suit la loi de Poisson de paramètre \(\lambda+\mu\). De même, une somme de \(n\) variables de Bernoulli \(\mathcal{B}(p)\) indépendantes a pour fonction génératrice \((q+pt)^n\) : elle suit la loi \(\mathcal{B}(n\,;\,p)\).
6.2 Lire une loi sur un polynôme
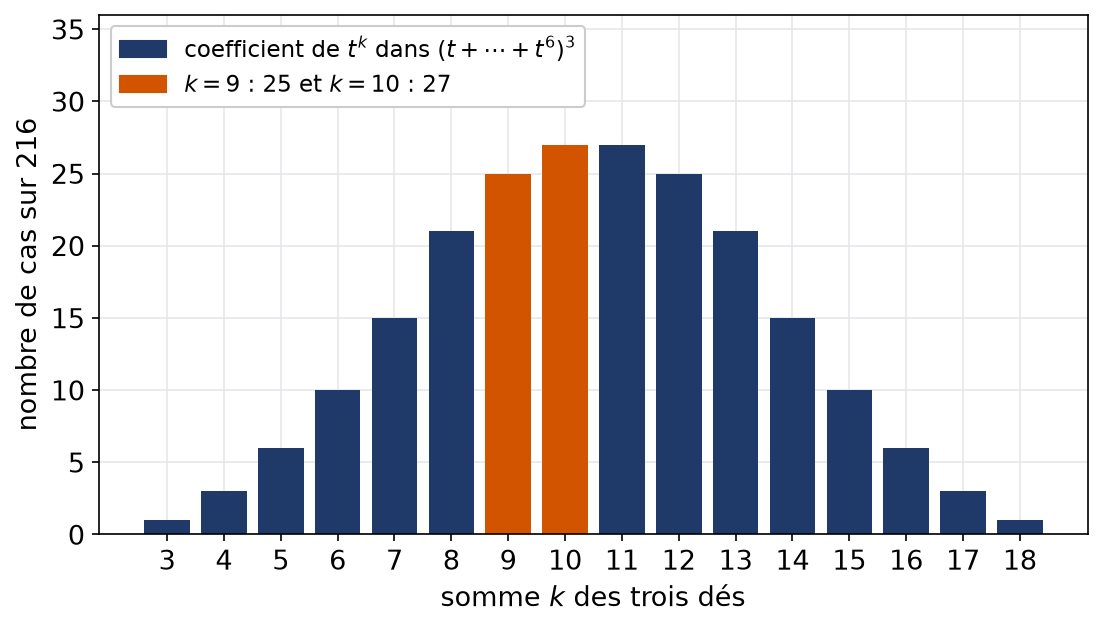
Jetons simultanément trois dés non truqués, dont les résultats sont indépendants, et appelons \(S\) le total obtenu. La fonction génératrice d’un seul dé vaut \(\frac{t+\cdots+t^6}{6}=\frac{t(1-t^6)}{6(1-t)}\). Ainsi \(G_S(t)=\frac{t^3(1-t^6)^3}{216(1-t)^3}\). Pour obtenir \(P(S=10)\), on cherche le coefficient de \(t^7\) dans \((1-3t^6+\cdots)\sum_{k\geqslant 0}\binom{k+2}{2}t^k\). Il vaut \(\binom{9}{2}-3\binom{3}{2}=36-9=27\). Donc \(P(S=10)=\frac{27}{216}=\frac{1}{8}\).
La figure donne tous les coefficients de ce polynôme. On y voit par exemple que la somme 10 est un peu plus fréquente que la somme 9, avec 27 cas contre 25.
Remarque :
Le développement utilisé vient de la série \(\frac{1}{(1-t)^3}=\sum_{k\geqslant 0}\binom{k+2}{2}t^k\), obtenue en dérivant deux fois la série géométrique. Ensuite, seuls les termes de degré au plus 7 comptent, ce qui limite le calcul à deux termes.
6.3 Le rang du deuxième succès
Les fonctions génératrices donnent aussi des lois nouvelles. Considérons une suite d’épreuves de Bernoulli indépendantes de paramètre \(p\), et notons \(T\) le rang du deuxième succès.
Le rang \(T\) est la somme de deux attentes indépendantes : \(T=T_1+T_2\), où \(T_1\) est le rang du premier succès et \(T_2\) le nombre d’épreuves supplémentaires jusqu’au suivant. Ces deux variables suivent la loi \(\mathcal{G}(p)\). Par conséquent, \(G_T(t)=\frac{p^2t^2}{(1-qt)^2}\). Or \(\frac{1}{(1-qt)^2}=\sum_{j\geqslant 0}(j+1)q^jt^j\). Le coefficient de \(t^k\), pour \(k\geqslant 2\), vaut donc \(p^2(k-1)q^{k-2}\). Ainsi \(P(T=k)=(k-1)p^2q^{k-2}\), et \(E(T)=\frac{2}{p}\) par linéarité.
- Décomposer la variable étudiée en somme de variables indépendantes de lois connues.
- Multiplier les fonctions génératrices et simplifier le produit.
- Reconnaître une forme usuelle, ou développer en série entière pour lire les coefficients.
- Conclure par la caractérisation de la loi, en le disant explicitement.
Les erreurs fréquentes
- Appliquer l’inégalité de Markov à une variable qui n’est pas positive.
- Oublier la condition d’indépendance, ou affirmer que la variance d’une somme est toujours la somme des variances.
- Confondre \(G_X^{\prime\prime}(1)\) avec \(E\left(X^2\right)\) dans le calcul de la variance.
- Utiliser la mauvaise convention pour la loi géométrique, sur \(\mathbb{N}\) au lieu de \(\mathbb{N}^*\).
- Présenter la loi faible comme une convergence de la moyenne pour chaque tirage.
Fiche mémo
- Markov : si \(X\geqslant 0\) et \(a>0\), alors \(P(X\geqslant a)\leqslant\frac{E(X)}{a}\).
- Bienaymé-Tchebychev : un écart d’au moins \(\varepsilon\) à la moyenne a une probabilité au plus \(\frac{V(X)}{\varepsilon^2}\).
- Loi faible : \(P\left(\left|\frac{S_n}{n}-m\right|\geqslant\varepsilon\right)\leqslant\frac{\sigma^2}{n\varepsilon^2}\).
- Pour une fréquence, \(\sigma^2=p(1-p)\leqslant\frac{1}{4}\).
- Définition : \(G_X(t)=E\left(t^X\right)\) ; la série converge normalement dès que \(|t|\leqslant 1\), et \(G_X(1)=1\).
- Coefficients : \(P(X=n)=\frac{G_X^{(n)}(0)}{n!}\), donc deux variables de même fonction génératrice ont même loi.
- Formules à connaître : \(q+pt\) pour une loi de Bernoulli, \((q+pt)^n\) pour une binomiale, \(\frac{pt}{1-qt}\) pour une géométrique, \(e^{\lambda(t-1)}\) pour une loi de Poisson.
- \(E(X)=G_X^{\prime}(1)\) et \(V(X)=G_X^{\prime\prime}(1)+G_X^{\prime}(1)-G_X^{\prime}(1)^2\).
- Variables indépendantes : \(G_{X+Y}=G_XG_Y\).
Questions fréquentes
Faut-il connaître la preuve de la loi faible des grands nombres ?
Oui, elle est courte et elle est souvent demandée en colle. Il suffit de calculer l’espérance et la variance de la moyenne, en utilisant l’indépendance deux à deux pour annuler les covariances. L’inégalité de Bienaymé-Tchebychev conclut ensuite immédiatement.
Pourquoi la fonction génératrice est-elle définie au moins sur [-1, 1] ?
Pour \(|t|\leqslant 1\), le terme \(P(X=n)t^n\) est majoré en valeur absolue par \(P(X=n)\), et la somme de ces probabilités vaut 1. La série converge donc normalement sur ce segment, quelle que soit la loi. Le rayon peut être plus grand, par exemple infini pour une loi de Poisson.
Comment savoir si une variable a une espérance avec sa fonction génératrice ?
La variable a une espérance finie exactement quand sa fonction génératrice est dérivable en 1, et l’espérance vaut alors \(G_X^{\prime}(1)\). Si le rayon de convergence dépasse 1, la dérivabilité est automatique. Si le rayon vaut 1, il faut étudier la limite de la dérivée à gauche en 1.
L'inégalité de Bienaymé-Tchebychev donne-t-elle une bonne approximation ?
Elle donne une majoration toujours vraie, mais souvent très pessimiste. Pour une loi binomiale, la probabilité réelle d’un grand écart est fréquemment dix fois plus petite que le majorant. Son intérêt est sa généralité : elle ne demande que la variance.
Pour aller plus loin
- S’exercer : exercices corrigés de maths spé (MP) sur loi faible et séries génératrices
- Bases utiles : Espérance, variance et covariance d'une variable discrète, Fonctions développables en série entière
- Chapitre d’avant : Espérance, variance et covariance d'une variable discrète
- Chapitre d’après : Isométries vectorielles et matrices orthogonales
- Vérifier ses acquis : QCM de maths spé (MP) sur loi faible et séries génératrices
- Contrôle corrigé en temps limité : Séries génératrices et loi faible : contrôle de maths en MP
- Un autre sujet noté sur 20 : Problème de probabilités discrètes : contrôle de maths en MP
- Le même thème en L2 de maths : Couples de variables, indépendance et grands nombres
- Tous les chapitres : le sommaire de maths spé (MP)
- Après le bac : les maths post-bac, de la MPSI à la L3
Télécharger ou imprimer cette fiche «loi faible et séries génératrices en maths spé (MP) : cours et méthodes» au format PDF afin de pouvoir travailler en totale autonomie.
Ressources de maths en Maths spé (MP)
Cours
Tout voir
Exercices corrigés
Tout voir

Contrôles
Tout voir
QCM
Tout voir